

Todos nós amamos histórias. Gostamos de nos reunir ao redor da fogueira para contar nossas vitórias passadas, lutas ou simplesmente sobre nossas experiências de trabalho.
Hoje é um dia exatamente assim. E mesmo que você não esteja ao redor de uma fogueira, temos uma história para você. Uma história sobre como começamos a trabalhar com o armazenamento no Tarantool.
Era uma vez, em nossa empresa, havia alguns 'monólitos' e um 'teto' que todos compartilhavam, para o qual esses monólitos se aproximavam lentamente, mas de forma constante, limitando o voo de nossa empresa, nosso desenvolvimento. E havia uma clara compreensão: um dia, nós iríamos bater nesse teto.
Agora, a ideologia de separação de tudo e todos reina, desde a infraestrutura até a lógica de negócios. Como resultado, por exemplo, temos dois DCs, praticamente independentes a nível de rede. Mas, naquela época, tudo era bem diferente.
Hoje em dia, existem muitas ferramentas e meios para fazer mudanças, como CI/CD, K8S, etc. Na era 'monolítica', não precisávamos de tantas palavras estrangeiras. Bastava ajustar o 'armazenamento' no banco de dados.
Mas o tempo avançou, e a quantidade de solicitações cresceu junto com ele, disparando RPS às vezes acima das nossas possibilidades. Quando entramos no mercado da CEI, a carga no processador do DB do primeiro monólito não caía abaixo de 90%, e o RPS se mantinha em torno de 2400. E não eram apenas pequenas seleções, mas grandes solicitações com muitas verificações e JOINs, que percorreram quase metade dos dados em meio a um alto IO.
Quando vendas completas começaram a aparecer na 'Black Friday' — e a Wildberries foi uma das primeiras a realizá-las na Rússia — a situação se tornou bastante triste. Pois, a carga nesses dias aumenta três vezes.
Ah, esses 'tempos monolíticos'! Tenho certeza de que você também já passou por isso e ainda não consegue entender como isso poderia acontecer com você.
O que se pode fazer - a moda também se aplica às tecnologias. Há cerca de 5 anos, tivemos que repensar uma dessas modas, que era um site em .NET e servidor MS SQL, que guardava com carinho toda a lógica do site. Guardava de tal forma que desmembrar esse monólito se tornou um prazer longo e bastante complicado.
Uma pequena digressão.
Em vários eventos, costumo dizer: "se você não desmantelou o monolito, então você não cresceu!" Estou interessado na sua opinião sobre isso, por favor, escreva-a nos comentários.
E então ouviu-se o trovão
Voltando ao nosso "fogo de chão". Para distribuir a carga da funcionalidade monolítica, decidimos dividir o sistema em microsserviços baseados em tecnologias de código aberto. Porque, no mínimo, a escalabilidade deles é mais barata. E sabíamos, com 100% de certeza, que precisaríamos escalar (e muito). Afinal, já naquele momento, conseguimos acessar os mercados dos países vizinhos, e tanto o número de registros quanto o número de pedidos começou a crescer ainda mais.
Ao analisar os primeiros candidatos para a migração do monolito para microsserviços, percebemos que em 80% os dados eram inseridos neles em 99% a partir de sistemas de back office, enquanto a leitura vinha da linha de frente. Isso se aplicava principalmente a alguns subsistemas importantes para nós — dados dos usuários e o sistema de cálculo do custo final dos produtos com base em informações sobre descontos e cupons adicionais dos clientes.
À guisa de uma observação. Agora é assustador imaginar, mas além dos subsistemas mencionados, também foram extraídos do nosso monolito catálogos de produtos, carrinho de usuários, sistema de busca de produtos, sistema de filtragem de catálogos de produtos e diversos sistemas recomendativos. Para operar cada um deles, existem classes separadas de sistemas especializados, mas antes todos eles coexistiam em uma única "casa".
Planejamos transferir os dados de nossos clientes para um sistema de sharding. A funcionalidade de cálculo do custo final dos produtos exigia boa escalabilidade em leitura, uma vez que gerava a maior carga de RPS e era a mais complicada de implementar para o banco de dados (muitos dados estão envolvidos no processo de cálculos).
Como resultado, desenvolvemos um esquema que se combina bem com Tarantool.
Na época, para o funcionamento dos microsserviços, foram escolhidos esquemas de operação com vários Data Centers em máquinas virtuais e físicas. Como mostrado nas ilustrações, foram aplicadas opções de replicação do Tarantool tanto no modo master-master quanto master-slave.
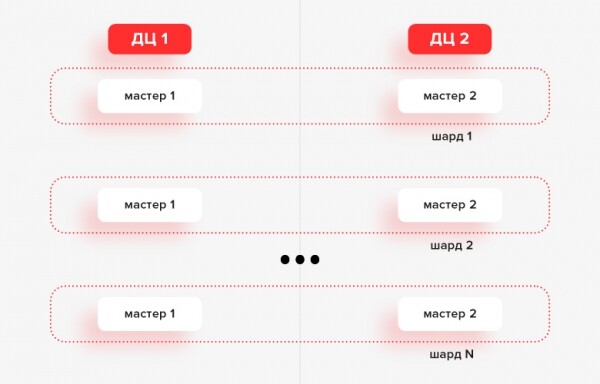
Arquitetura. Opção 1. Serviço de usuários
Atualmente, existem 24 shards, cada um com 2 instâncias (uma em cada Data Center), todas no modo master-master.
Acima do banco de dados estão os aplicativos que interagem com as réplicas do banco de dados. Os aplicativos trabalham com Tarantool através da nossa biblioteca personalizada, que implementa a interface do driver Go para Tarantool. Ela vê todas as réplicas e pode funcionar com o mestre para leitura e gravação. Na essência, ela implementa o modelo de conjunto de réplicas, ao qual foram adicionadas a lógica de seleção de réplicas, tentativas de repetição, circuito de interrupção e limite de taxa.
Além disso, há a possibilidade de configurar a política de seleção de réplicas em relação à shard. Por exemplo, usando round-robin.
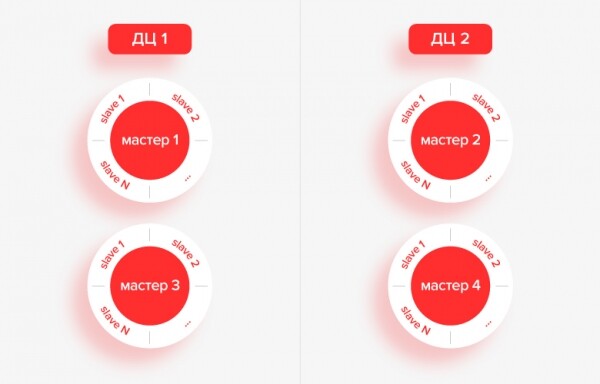
Arquitetura. Opção 2. Serviço de cálculo do custo final do produto.
Há vários meses, a maior parte das solicitações para o cálculo do custo final dos produtos foi transferida para um novo serviço, que, em princípio, funciona sem bancos de dados, mas há algum tempo atrás 100% do processamento era realizado pelo serviço com Tarantool em funcionamento.
O banco de dados do serviço consiste em 4 mestres, dos quais o sincronizador coleta dados, e cada um desses mestres distribui dados para réplicas somente de leitura através da replicação. Cada mestre tem cerca de 15 dessas réplicas.
Em ambas as esquemas, na ausência de um DC, o aplicativo pode obter dados do segundo.
Vale ressaltar que em Tarantool a replicação é bastante flexível e pode ser configurada em tempo real. Em outros sistemas, já ocorreram dificuldades. Por exemplo, ao modificar os parâmetros max_wal_senders e max_replication_slots no PostgreSQL, é necessário reiniciar o mestre, o que em vários casos pode causar interrupção nas conexões entre o aplicativo e o SGBD.
Busque e você encontrará!
Por que não fizemos "como as pessoas normais" e escolhemos uma abordagem atípica? Depende do que se considera normal. Muitos fazem um cluster com Mongo e o distribuem por três DCs geograficamente distribuídos.
Naquela época, já estávamos com dois projetos em Redis. O primeiro - cache, e o segundo era um armazenamento persistente para dados que não eram muito críticos. Com este último, tivemos algumas dificuldades, em parte por nossa culpa. Às vezes, volumes consideráveis de dados estavam armazenados na chave, e de vez em quando o site enfrentava problemas. Utilizávamos esse sistema em uma configuração master-slave. E houve muitos casos em que algo acontecia com o mestre e a replicação falhava.
Ou seja, o Redis é bom para tarefas stateless, e não para stateful. Na verdade, ele permitia resolver a maioria dos problemas, mas apenas se fossem soluções de chave-valor com alguns índices. Porém, o Redis tinha um desempenho bastante insatisfatório em termos de persistência e replicação. Além disso, havia reclamações sobre a performance.
Consideramos o MySQL e o PostgreSQL. Mas o primeiro não se firmou conosco, e o segundo por si só é um produto bastante complexo, tornando inviável construir serviços simples sobre ele.
Testamos RIAK, Cassandra, até mesmo um banco de dados gráfico. Todas essas são soluções bastante nichadas, que não se encaixavam como uma ferramenta universal para a criação de serviços.
No final, decidimos pelo Tarantool.
Entramos em contato quando ele estava na versão 1.6. O que nos atraiu foi o simpósio entre key-value e a funcionalidade de um banco de dados relacional. Possui índices secundários, transações e spaces, que são como tabelas, porém não simples, permitindo armazenar diversas colunas. Mas a killer feature do Tarantool eram os índices secundários combinados com key-value e transacionalidade.
A comunidade de língua russa, sempre pronta para ajudar no chat, também desempenhou um papel importante. Usamos isso ativamente e estávamos sempre no chat. Além disso, a persistência era decente, sem erros ou falhas evidentes. Se olharmos nossa história com o Tarantool, tivemos muitas dores e falhas com a replicação, mas nunca perdemos dados por causa dele!
A implementação começou de forma difícil.
Naquela época, nosso principal stack de desenvolvimento era .NET, para o qual não havia conector para o Tarantool. Começamos imediatamente a desenvolver em Go. Com Lua também foi razoavelmente bem. O principal problema naquele momento era a depuração: no .NET tudo era excelente, mas mergulhar no mundo do Lua embutido, onde você não tem outro debug além dos logs, era complicado. Além disso, a replicação, por algum motivo, periodicamente falhava, e precisávamos entender a estrutura do motor Tarantool. O chat ajudava nisso, a documentação em menor grau, e às vezes consultávamos o código. Naquele momento, a documentação era bem fraca.
Assim, ao longo de vários meses, conseguimos aprender e obter resultados satisfatórios no trabalho com Tarantool. Organizamos em git as práticas padrão que ajudavam na criação de novos microsserviços. Por exemplo, quando surgia a tarefa de criar um novo microsserviço, o desenvolvedor consultava o código-fonte da solução padrão no repositório, e a criação de algo novo não levava mais do que uma semana.
Foi um tempo especial. Naquele período, era comum chegar até o administrador na mesa ao lado e pedir: "Me dê uma virtual". Em cerca de trinta minutos, a máquina já estava com você. Você mesmo se conectava, instalava tudo, e eles direcionavam o tráfego para ela.
Hoje em dia isso já não é mais possível: é preciso implementar monitoramento no serviço, registrar logs, cobrir a funcionalidade com testes, solicitar uma virtual ou providenciar algo no Kubernetes, etc. No geral, isso será melhor, embora mais demorado e trabalhoso.
Dividir para conquistar. Como está a situação com Lua?
Houve um dilema sério: algumas equipes não conseguiam aplicar mudanças de forma confiável em um serviço com uma quantidade significativa de lógica em Lua. Muitas vezes, isso resultava em falhas no serviço.
Ou seja, os desenvolvedores preparam alguma mudança. O Tarantool começa a realizar a migração, enquanto a réplica ainda utiliza o código antigo; algum DDL chega através da replicação, algo mais, e o código simplesmente quebra porque isso não foi considerado. Como resultado, o procedimento de atualização para os administradores estava detalhado em uma folha A4: parar a replicação, atualizar isso, reiniciar a replicação, desligar aqui, atualizar ali. Um pesadelo!
No final das contas, agora, frequentemente tentamos não fazer nada em Lua. Simplesmente usamos iproto (um protocolo binário para interagir com o servidor), e tudo. Pode ser que faltem conhecimentos aos desenvolvedores, mas, sob essa perspectiva, o sistema é complexo.
Não seguimos cegamente esse roteiro. Hoje não temos preto ou branco: ou tudo em Lua, ou tudo em Go. Já entendemos como podemos combinar para evitar problemas com a migração mais tarde.
Onde o Tarantool está presente atualmente?
O Tarantool é utilizado no serviço de cálculo do custo final dos produtos com desconto, conhecido como "Promotaizer". Como já mencionado anteriormente, ele está sendo substituído por um novo serviço de catálogo com preços pré-calculados, mas há seis meses todos os cálculos eram feitos no "Promotaizer". Antes, metade de sua lógica foi escrita em Lua. Há dois anos, o serviço se tornou um repositório, e a lógica foi reescrita em Go, porque a mecânica do funcionamento dos descontos mudou um pouco e o serviço estava com falta de desempenho.
Um dos serviços mais críticos é o perfil de usuário. Ou seja, todos os usuários da Wildberries são armazenados no Tarantool, que conta com cerca de 50 milhões de usuários. Sistema shardizado por ID de usuário, distribuído por diversos DCs com integração em serviços Go.
No RPS, o "Promotaizer" já foi líder, atingindo até 6 mil solicitações. Em determinado momento, tivemos entre 50 e 60 instâncias. Atualmente, o líder em RPS são os perfis de usuários, com cerca de 12 mil. Este serviço utiliza sharding personalizado com divisão por intervalos de IDs de usuários. O serviço atende mais de 20 máquinas, mas isso é excessivo; planejamos reduzir os recursos alocados, pois 4 a 5 máquinas são suficientes.
O serviço de sessões é nosso primeiro serviço no vshard e no Cartridge. A configuração do vshard e a atualização do Cartridge demandaram um certo esforço, mas, no final, tudo funcionou.
O serviço para exibir diferentes banners no site e no aplicativo móvel foi um dos primeiros lançados no Tarantool. Este serviço é notável porque tem cerca de 6 a 7 anos, ainda está em operação e nunca foi reiniciado. Foi aplicada replicação master-master. Nunca houve falhas.
Há um exemplo do uso do Tarantool para a funcionalidade de catálogos rápidos em sistemas de estoque, para verificar rapidamente as informações em alguns casos. Tentamos usar o Redis para isso, mas os dados em memória ocupavam mais espaço do que no Tarantool.
Os serviços de lista de espera, assinaturas de clientes, tendências atuais de stories e produtos adiados também operam com o Tarantool. O último serviço ocupa cerca de 120 GB na memória. É o serviço mais volumoso dentre os mencionados.
Conclusão
Graças aos índices secundários, em combinação com key-value e a transacionalidade, Tarantool é uma ótima opção para arquiteturas baseadas em microsserviços. No entanto, encontramos dificuldades ao implementar mudanças em serviços com muita lógica em Lua — os serviços frequentemente paravam de funcionar. Não conseguimos superar isso e, com o tempo, chegamos a diferentes combinações de Lua e Go: sabemos onde utilizar uma linguagem e onde utilizar a outra.
O que mais ler sobre o assunto
- Criamos do zero um aplicativo de alto desempenho no Tarantool
- Escolha confiável do líder em Tarantool Cartridge
- Canal do Telegram Tarantool com notícias sobre o produto
- Discutir sobre Tarantool no chat da comunidade
Fonte: habr.com
