

Nos últimos seis meses, estive trabalhando na criação de um sistema de combate a fraudes (fraudulent activity, fraud, etc.) sem nenhuma infraestrutura inicial para isso. As ideias que encontramos e implementamos em nosso sistema nos ajudam a detectar várias atividades fraudulentas e analisá-las. Neste artigo, gostaria de compartilhar os princípios que seguimos e o que fizemos para alcançar o estado atual do nosso sistema, sem entrar em detalhes técnicos.
Princípios do nosso sistema
Quando você ouve termos como "automatic" e "fraud", provavelmente começa a pensar em machine learning, Apache Spark, Hadoop, Python, Airflow e outras tecnologias do ecossistema Apache Foundation e da área de Data Science. Acredito que há um aspecto da utilização dessas ferramentas que geralmente não é mencionado: elas requerem certas condições prévias em seu sistema corporativo antes de serem utilizadas. Em resumo, você precisa de uma plataforma corporativa de dados que inclua um lago de dados e um armazém. Mas e se você não tiver essa plataforma e ainda assim precisar desenvolver essa prática? Os princípios que descrevo a seguir nos ajudaram a chegar a um ponto em que podemos nos concentrar em melhorar nossas ideias, em vez de simplesmente encontrar uma solução funcional. No entanto, isso não é um "platô" do projeto. Há ainda muitas questões a serem resolvidas do ponto de vista tecnológico e de produto.
Princípio 1: valor para o negócio em primeiro lugar
No centro de todos os nossos esforços, colocamos o "valor para o negócio". De maneira geral, qualquer sistema de análise automática pertence a um grupo de sistemas complexos com alto nível de automação e complexidade técnica. Criar uma solução completa levará uma infinidade de tempo se você a desenvolver do zero. Decidimos priorizar o valor comercial em primeiro lugar, enquanto a completude tecnológica fica em segundo plano. Na prática, isso significa que não adotamos tecnologias avançadas como uma doutrina. Escolhemos a tecnologia que melhor funciona para nós no momento. Com o tempo, pode parecer que precisaremos reimplementá-la em alguns módulos. Esse é o compromisso que aceitamos.
Princípio 2: Inteligência aumentada (augmented intelligence)
Eu apostaria que a maioria das pessoas que não estão profundamente envolvidas no desenvolvimento de soluções de aprendizado de máquina pode pensar que substituir os humanos é o objetivo. Na verdade, as soluções de aprendizado de máquina estão longe da perfeição e a substituição só é possível em áreas específicas. Desde o início, abandonamos essa ideia por várias razões: dados desbalanceados sobre atividades fraudulentas e a impossibilidade de fornecer uma lista abrangente de recursos para os modelos de aprendizado de máquina. Em vez disso, optamos por uma abordagem de inteligência aumentada. Esta é uma alternativa ao conceito de inteligência artificial, que enfoca o papel auxiliar da IA, destacando o fato de que as tecnologias cognitivas são destinadas a melhorar a inteligência humana, e não a substituí-la. [1]
Considerando isso, o desenvolvimento de uma solução completa de aprendizado de máquina desde o início exigiria um enorme esforço, que atrasaria a criação de valor para o nosso negócio. Decidimos construir um sistema com um aspecto de aprendizado de máquina que cresce de forma iterativa sob a orientação de nossos especialistas na área. A parte complicada do desenvolvimento de tal sistema é que ele deve fornecer aos nossos analistas casos não apenas do ponto de vista da atividade fraudulenta ou não. Em geral, qualquer anomalia no comportamento dos clientes é um caso suspeito que os especialistas precisam investigar e responder de alguma forma. Apenas uma parte desses casos registrados pode realmente ser classificada como fraude.
Princípio 3: plataforma de análise de dados abrangente
A parte mais complexa do nosso sistema é a verificação contínua do fluxo de trabalho do sistema. Analistas e desenvolvedores devem ser capazes de acessar facilmente conjuntos de dados de períodos anteriores, com todas as métricas utilizadas para análise. Além disso, a plataforma de dados deve oferecer uma maneira fácil de complementar um conjunto de métricas existente com novas. Os processos que criamos, que não se limitam apenas aos processos de software, devem permitir recalcular facilmente períodos anteriores, adicionar novas métricas e alterar previsões de dados. Poderíamos alcançar isso acumulando todos os dados gerados pelo nosso sistema de produção. Nesse caso, os dados gradualmente se tornariam um incômodo. Precisaríamos armazenar um volume crescente de dados que não utilizamos e protegê-los. Nesse cenário, com o tempo, os dados se tornariam cada vez mais irrelevantes, mas ainda exigiriam nosso esforço para gerenciá-los. Para nós, a acumulação de dados não fazia sentido, e decidimos usar uma abordagem diferente. Optamos por organizar repositórios de dados em tempo real em torno de entidades-alvo que queremos classificar e armazenar somente os dados que permitem verificar os períodos mais recentes e relevantes. A complexidade desse esforço reside no fato de que nosso sistema é heterogêneo, com vários repositórios de dados e módulos de software, que requerem um planejamento cuidadoso para funcionar de maneira coesa.
Conceitos construtivos do nosso sistema
Temos quatro componentes principais em nosso sistema: sistema de recepção (ingestion system), computacional (computational), análise (BI analysis) e sistema de rastreamento (tracking system). Eles servem a objetivos isolados específicos, e mantemos eles isolados, seguindo abordagens definidas no desenvolvimento.
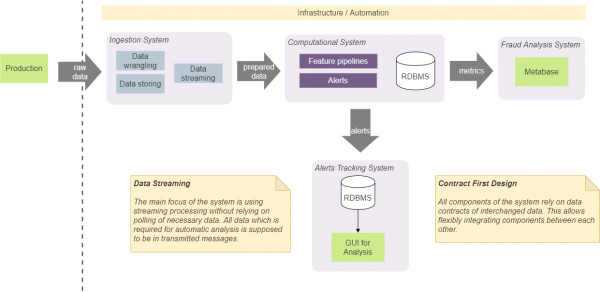
Design baseado em contratos
Acima de tudo, concordamos que os componentes devem depender apenas de certas estruturas de dados (contratos) que são passadas entre eles. Isso facilita a integração entre eles e não impõe uma composição específica (e ordem) dos componentes. Por exemplo, em alguns casos, isso nos permite integrar diretamente o sistema de recebimento com o sistema de rastreamento de alertas. Nesse caso, isso será feito de acordo com o contrato acordado para alertas. Isso significa que ambos os componentes estarão integrados usando um contrato que pode ser utilizado por qualquer outro componente. Não adicionaremos um contrato adicional para inserir alertas no sistema de rastreamento a partir do sistema de entrada. Essa abordagem requer a utilização de um número mínimo predefinido de contratos e simplifica o sistema e a comunicação. Essencialmente, estamos usando uma abordagem chamada "Contrato Primeiro", aplicando-a aos contratos de transmissão de dados. [2]
Streaming em todo lugar
A preservação e gestão do estado em um sistema inevitavelmente levará a complexidades na sua implementação. De modo geral, o estado deve ser acessível a partir de qualquer componente, deve ser consistente e fornecer o valor mais atual para todos os componentes, e deve ser confiável com valores corretos. Além disso, a presença de chamadas ao armazenamento persistente para obter o último estado aumentará o número de operações de entrada e saída e a complexidade dos algoritmos utilizados em nossos pipelines de tempo real. Por causa disso, decidimos eliminar o armazenamento de estado, sempre que possível, de nosso sistema. Essa abordagem exige que todos os dados necessários estejam incluídos no bloco de dados transmitido (mensagem). Por exemplo, se precisamos calcular a quantidade total de algumas observações (ou seja, o número de operações ou casos com características específicas), nós o calculamos na memória e geramos um fluxo desses valores. Módulos dependentes usarão a partição e o agrupamento para fragmentar o fluxo em entidades e operar os últimos valores. Essa abordagem eliminou a necessidade de um armazenamento constante em disco para esses dados. Nosso sistema utiliza o Kafka como um corretor de mensagens, e ele pode ser usado como um banco de dados com KSQL. [3] No entanto, seu uso vincularia fortemente nossa solução ao Kafka, e decidimos não usá-lo. A abordagem que escolhemos permite substituir o Kafka por outro corretor de mensagens sem mudanças internas significativas no sistema.
Esse conceito não significa que não utilizamos armazenamento em disco e bancos de dados. Para verificação e análise do desempenho do sistema, precisamos armazenar em disco uma parte significativa dos dados, que representam diferentes métricas e estados. Um ponto importante aqui é que os algoritmos em tempo real não dependem desses dados. Na maioria dos casos, usamos os dados salvos para análise autônoma, depuração e rastreamento de casos e resultados específicos que o sistema fornece.
Problemas do nosso sistema
Existem certos problemas que solucionamos até um determinado nível, mas eles exigem soluções mais elaboradas. Agora, eu gostaria apenas de mencioná-los aqui, pois cada ponto merece um artigo separado.
- Ainda precisamos definir processos e políticas que contribuam para a acumulação de dados significativos e relevantes para nossa análise automática, detecção e pesquisa de dados.
- A integração dos resultados da análise humana no processo de ajuste automático do sistema para atualizar com os dados mais recentes. Isso não se limita apenas à atualização do nosso modelo, mas também à atualização de processos e à melhoria da compreensão dos nossos dados.
- Encontrar um equilíbrio entre a abordagem determinística IF-ELSE e ML. Alguém disse: "ML é uma ferramenta para os desesperados". Isso significa que você gostaria de usar ML quando já não consegue entender como otimizar e melhorar seus algoritmos. Por outro lado, a abordagem determinística não permite a detecção de anomalias que não foram previstas.
- Precisamos de uma maneira simples de verificar nossas hipóteses ou correlações entre métricas nos dados.
- O sistema deve ter vários níveis de resultados verdadeiramente positivos. Casos de fraude são apenas uma parte de todos os casos que podem ser considerados positivos para o sistema. Por exemplo, os analistas desejam receber todos os casos suspeitos para verificação, e apenas uma pequena parte deles é fraude. O sistema deve fornecer aos analistas todos os casos de forma eficaz, independentemente de serem fraudes reais ou apenas comportamentos suspeitos.
- A plataforma de dados deve permitir a obtenção de conjuntos de dados de períodos anteriores com cálculos gerados e processados em tempo real.
- Implantação simples e automática de qualquer um dos componentes do sistema em pelo menos três ambientes diferentes: produção, experimental (beta) e para desenvolvedores.
- E, finalmente, mas não menos importante. Precisamos criar uma ampla plataforma de verificação de desempenho, na qual possamos analisar nossos modelos. [4]
Links
Fonte: habr.com
