

Vamos discutir os fundamentos da coleta de logs no Docker e Kubernetes, e em seguida, examinaremos duas ferramentas que podem ser utilizadas em produção: Grafana Loki e o stack EFK (Elasticsearch + Fluent Bit + Kibana).
O conteúdo deste artigo é um resumo de . Se houver interesse e, principalmente, necessidade de produção, é possível fazer um curso completo — inscreva-se no curso sobre .
Logging no Docker
No nível do Kubernetes, os aplicativos são executados em pods, mas no nível inferior, geralmente funcionam no Docker. Portanto, é necessário configurar a coleta de logs de modo a capturar os logs dos contêineres. Os contêineres são iniciados pelo Docker — então precisamos entender como a coleta de logs funciona no nível do Docker.
Espero que cada leitor saiba: os logs do aplicativo devem ser escritos em stdout/stderr, e não dentro do contêiner. O Docker Daemon agrega os logs e trabalha apenas com aqueles que são enviados para stdout/stderr. Além disso, gravar logs dentro do contêiner pode causar problemas: o contêiner incha com o log crescente (já que provavelmente não há nenhum Logrotate dentro do contêiner), e o Docker Daemon não está ciente desse log.
O Docker possui vários drivers de log ou plugins para coleta de logs de contêineres. Na versão gratuita Docker Community Edition (CE), há menos drivers de log do que na versão comercial Docker Enterprise Edition (EE).
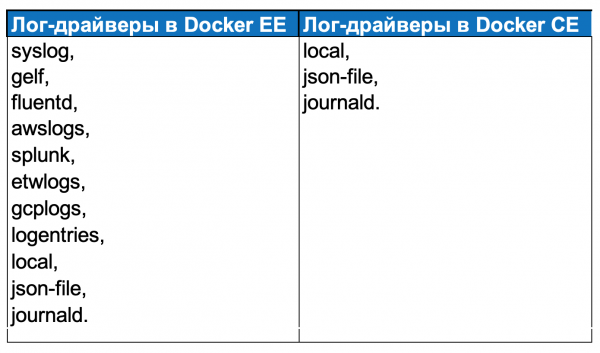
Nunca utilizei o Docker EE na prática: na Southbridge, nos esforçamos para aderir a soluções Open Source, e para a maioria dos clientes, as funcionalidades adicionais do Docker EE não são necessárias.
Drivers de log no Docker CE:
local — gravação de logs em arquivos internos do Docker Daemon;
json-file — criação de json-log na pasta de cada contêiner;
journald — envio de logs para o journald.
As configurações de logging no Docker estão no arquivo daemon.json.
No campo "log-driver", especifica-se o plugin, e no campo "log-opts" — suas configurações. No exemplo acima, o plugin "json-file" é especificado, com o limite de tamanho do log — "max-size": "10m"; limite de arquivos (configurações de rotação) — "max-file": "3"; assim como os valores que serão anexados aos logs.
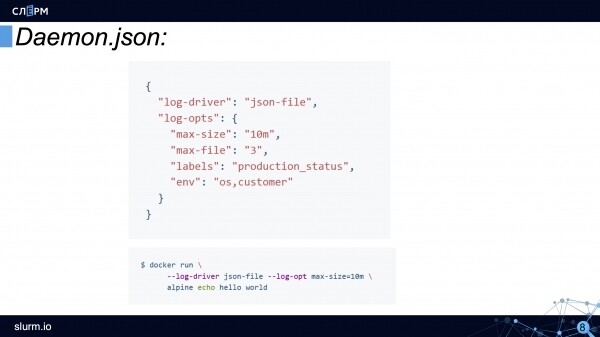
Algumas configurações do driver de log podem ser definidas através da ferramenta de linha de comando. Isso é conveniente se um contêiner específico precisa ser iniciado com um driver de log diferente.
Assim é como o esquema de logging no Docker se apresenta:
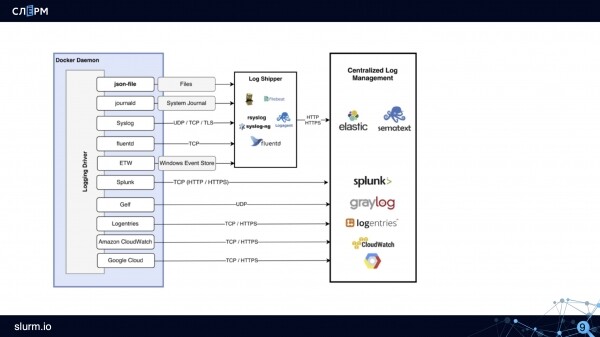
Como o esquema funciona: o driver de log, por exemplo o json-file, cria arquivos. Os coletores de logs (Rsyslog, Fluentd, Logagent e outros) reúnem esses arquivos e os enviam para armazenamento no Elastic, Sematext ou outros repositórios.
Características da coleta de logs no Kubernetes
Simplificadamente, o esquema de coleta de logs no Kubernetes parece assim: há um pod, dentro do qual um contêiner está rodando, e o contêiner envia logs para stdout/stderr. Em seguida, o Docker cria um arquivo e grava os logs, que podem ser rotacionados depois.
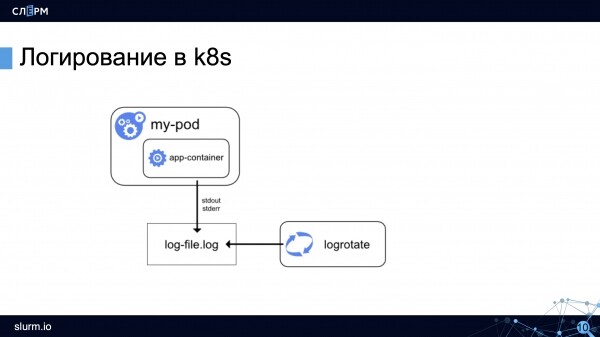
Vamos considerar as características da coleta de logs no Kubernetes.
Manter logs entre implantações. Esta é uma condição obrigatória para uma configuração correta da coleta de logs. Se os logs não forem mantidos entre implantações, ao lançar uma nova versão do aplicativo, os logs anteriores serão sobrescritos, e a reinicialização do contêiner também pode resultar na perda de logs. O Kubernetes possui uma chave —previous, que permite ver os logs do aplicativo antes da última reinicialização do Pod, mas não mais profundamente.
Agregar logs de todas as instâncias. Se os microsserviços estão hospedados em nuvens, o provedor de nuvem é responsável pelo controle do sistema. Se os microsserviços estão no seu próprio hardware, além dos logs dos contêineres, é necessário coletar também os logs do sistema.
Antes, não havia ferramentas convenientes para coletar logs tanto do sistema quanto dos microsserviços. Normalmente, uma ferramenta coletava logs do sistema (por exemplo, Rsyslog), enquanto outra coletava logs do Docker (por exemplo, journal-bit com a configuração do driver de log do Docker no journald). Tentaram usar o journal-bit para coletar logs tanto dos contêineres (indicando no driver de log do Docker que os logs deveriam ser gravados no journald) quanto do sistema (no CentOS 7 já existem systemd e journald). A solução funciona, mas não é ideal. Se houver muitos logs, o journal-bit começa a apresentar lentidão e as mensagens se perdem.
As experiências continuaram — e uma outra solução foi encontrada. No CentOS 7, os principais logs do sistema (messages, audit, secure) são duplicados no var-log na forma de arquivos. No Docker, também é possível configurar a gravação de logs em arquivos json. Portanto, esses arquivos do CentOS 7 e do Docker podem ser coletados juntos.
Com o tempo, a solução ELK Stack se tornou popular. É uma combinação de várias ferramentas: Elasticsearch, Logstash e Kibana.
O Elasticsearch armazena os logs dos contêineres, o Logstash coleta logs das instâncias, e o Kibana permite processar os logs recebidos e construir gráficos a partir deles. Durante algum tempo, o ELK Stack foi amplamente utilizado, mas, na minha opinião, seu tempo está passando. Mais adiante explicarei por quê.
Adicionar metadados. Pods, aplicativos e contêineres podem ser executados em qualquer lugar. Além disso, um único aplicativo pode ter várias instâncias. Os logs são registrados em um formato único, e precisamos entender qual réplica específica está registrando, qual Pod isso está escrevendo e em qual namespace está localizado. É por isso que os logs devem incluir metadados.
Analisar logs. Curiosamente, os custos de manutenção de um sistema de logging e monitoramento podem superar os custos do aplicativo principal. Quando você tem dezenas ou até centenas de milhares de logs por segundo, isso parece lógico, mas ainda assim é importante saber onde está o limite. Uma das formas de encontrar esse limite é através da análise de logs.
Normalmente, você não precisa coletar e armazenar todos os logs; deve enviar para armazenamento apenas uma parte — por exemplo, logs com status 'warning' ou 'error'. No caso de logs de nginx ou de controladores de ingress, é possível enviar para armazenamento apenas aqueles cujo status é diferente de 200. Mas essa não é uma orientação universal: se você estiver construindo algum tipo de análise de logs do Nginx, está claro que deve coletá-los.
Não é recomendável filtrar os logs sem pensar, pois os dados filtrados podem ser insuficientes para uma análise adequada. Por outro lado, talvez seja melhor conduzir a análise não no nível de logging, mas sim no nível de coleta de métricas. Assim, você não terá que armazenar centenas de milhares de linhas com o código 200. Uma das abordagens é obter informações sobre o tráfego e os erros a partir das métricas dos controladores de ingress.
No geral, é necessário refletir bem sobre o que você deseja armazenar e por quanto tempo, pois, caso contrário, você poderá enfrentar uma situação em que o sistema de logging consome mais recursos do que o projeto principal.
Ainda não há uma solução padrão para logging. Ao contrário do monitoramento, onde existe uma solução predominante, o Prometheus, no logging não há um padrão estabelecido.
Neste seminário, vamos abordar duas ferramentas: uma popular e a outra em ascensão. Existem outras, mas não vamos cobri-las neste artigo.
Considerando todas as características discutidas anteriormente, o logging no Kubernetes agora pode ser representado no seguinte diagrama:
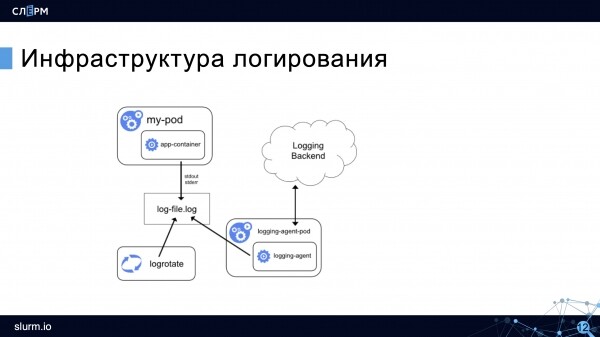
Resta o log do contêiner, a rotação, mas surge um agente-coletor que recolhe os logs e os envia para armazenamento (no diagrama — para o Logging Backend). O agente opera em cada nó e, geralmente, é executado no Kubernetes.
Agora vamos discutir as ferramentas de log.
Grafana Loki
apareceu recentemente, mas já se tornou bastante conhecido. Suas vantagens: instalação fácil, baixo consumo de recursos, não requer a instalação do Elasticsearch, pois armazena os dados em TSDB (banco de dados de séries temporais). No artigo anterior, mencionei que o Prometheus armazena dados em tal banco, e essa é uma das muitas semelhanças entre os dois produtos. Os desenvolvedores afirmam até que o Loki é o "Prometheus para o mundo da lógica".
Uma breve digressão sobre TSDB para aqueles que não leram : TSDB lida muito bem com o armazenamento de grandes quantidades de dados de séries temporais, mas não é feita para armazenamento prolongado. Se por algum motivo você precisar armazenar logs por mais de duas semanas, é melhor configurar a transmissão deles para outro banco de dados.
Outra vantagem do Loki é que a visualização dos dados é feita através do Grafana. É muito conveniente: no Grafana, visualizamos os dados de monitoramento e lá mesmo, conectando o Loki, visualizamos os logs. Gráficos podem ser construídos com base nos logs.
A arquitetura do Loki parece aproximadamente assim:
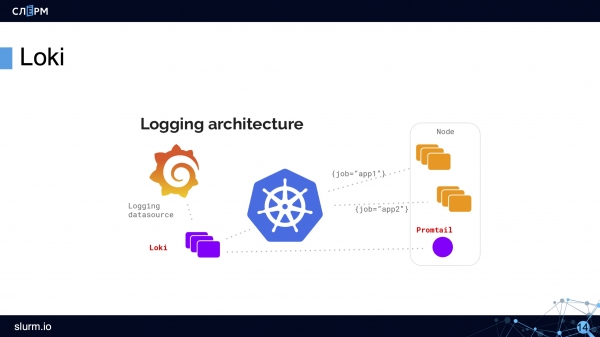
Usando DaemonSet, um agente — Promtail ou Fluent Bit — é implantado em todos os servidores do cluster. O agente coleta os logs. O Loki os busca e armazena em sua TSDB. Metadados são imediatamente adicionados aos logs, o que é conveniente: é possível filtrar por Pods, namespaces, nomes de contêineres e até mesmo rótulos.
O Loki funciona na interface familiar do Grafana. O Loki até tem sua própria linguagem de consultas, chamada LogQL — que, pelo nome e pela sintaxe, lembra o PromQL do Prometheus. Na interface do Loki, há sugestões de consultas, portanto, não é necessário memorizá-las.
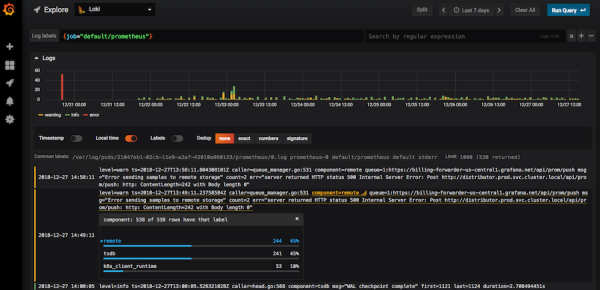
Loki na interface do Grafana
Usando filtros, é possível encontrar códigos no Loki ("400", "404" e qualquer outro); verificar logs de todo o nó; filtrar todos os logs que contêm a palavra "error". Se você clicar em um log, uma ficha com todas as informações do evento será revelada.
O Loki possui ferramentas suficientes para permitir a extração dos logs necessários, embora, sinceramente, tecnicamente poderiam haver mais. Atualmente, o Loki está em desenvolvimento ativo e ganhando popularidade.
Elastic + Fluent Bit + Kibana (Stack EFK)
O stack EFK é uma ferramenta de log mais clássica e, ao mesmo tempo, não menos popular.
No início do artigo, mencionamos o ELK (Elasticsearch + Logstash + Kibana), mas esse stack se tornou obsoleto devido ao Logstash, que consome muitos recursos e é pouco eficiente. Em vez disso, começaram a usar o mais leve e eficiente Fluentd, e depois de um tempo, ele recebeu a ajuda de — um agente de coleta ainda mais leve e ainda mais eficiente.
Se os desenvolvedores estiverem certos, o Fluent Bit é mais de 100 vezes mais eficiente do que o Fluentd: "onde o Fluentd consome 20 MB de RAM, o Fluent Bit consome 150 KB" — citação direta da documentação. Olhando para isso, o Fluent Bit passou a ser usado com mais frequência.
O Fluent Bit tem menos funcionalidades do que o Fluentd, mas atende às necessidades básicas, por isso usamos principalmente o Fluent Bit.
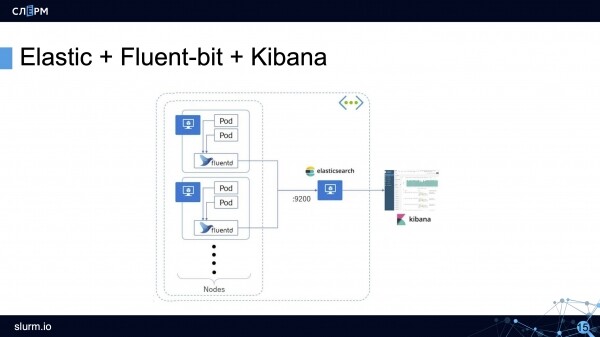
O esquema de trabalho do stack EFK: o agente coleta logs de todos os pods (geralmente, é um DaemonSet executado em todos os servidores do cluster) e os envia para o armazenamento (Elasticsearch, PostgreSQL ou Kafka). O Kibana se conecta ao armazenamento e extrai todas as informações necessárias.
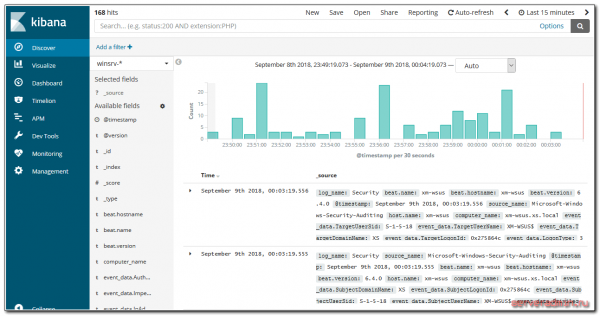
Ele apresenta as informações em uma interface web conveniente. Há gráficos, filtros e muito mais.
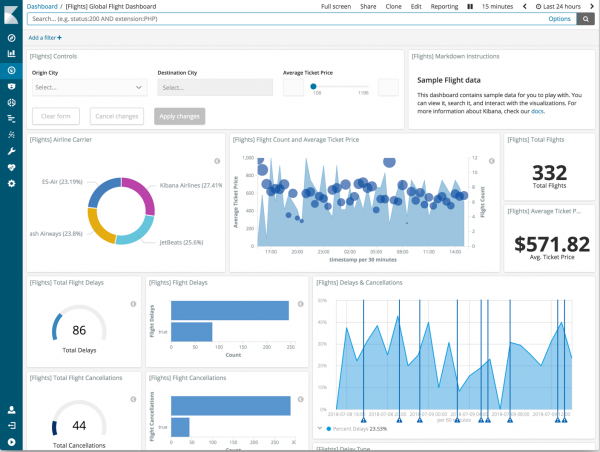
Com os logs, é possível criar painéis completos.
As funcionalidades do Fluent Bit
Como o Fluent Bit, em geral, é menos conhecido do que o Logstash, vamos analisá-lo com um pouco mais de detalhe. O Fluent Bit pode ser logicamente dividido em 6 módulos, e alguns desses módulos podem ter plugins que ampliam suas capacidades.
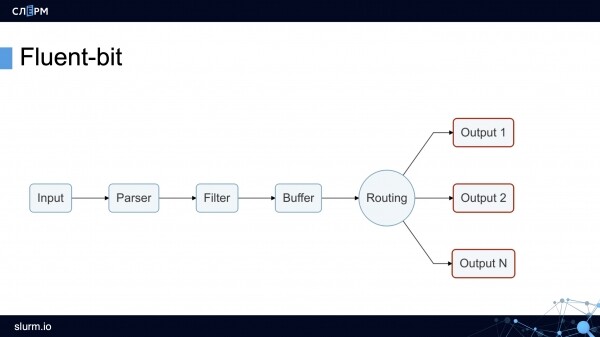
Módulo Input coleta logs de arquivos, serviços systemd e até mesmo de tcp-socket (basta indicar o endpoint, e o Fluent Bit começará a acessá-lo). Essas capacidades são suficientes para coletar logs tanto do sistema quanto dos contêineres.
Em produção, usamos com mais frequência os plugins (pode ser direcionado para uma pasta de logs) e (pode-se especificar de quais serviços coletar logs).
Módulo Parser normaliza os logs. Por padrão, os logs do Nginx são representados como uma linha. Com um plugin, é possível transformar essa linha em JSON: definir campos e seus valores. Trabalhar com JSON é muito mais fácil do que com logs em formato de string, pois oferece opções de ordenação mais flexíveis.
Módulo Filter. Nesse nível, logs desnecessários são filtrados. Por exemplo, apenas logs com o valor "warning" ou com certos rótulos são enviados para armazenamento. Os logs filtrados vão para o buffer.
Módulo Buffer. O Fluent Bit possui dois tipos de buffer: buffer de memória e buffer em disco. O buffer é um armazenamento temporário de logs, necessário em caso de erros ou falhas. Todos querem economizar em RAM, portanto, normalmente optam pelo buffer em disco. Mas é preciso considerar que, antes de ir para o disco, os logs ainda são descarregados na memória.
Módulo Routing/Output contém regras e endereços para o envio de logs. Como já foi mencionado, os logs podem ser enviados para Elasticsearch, PostgreSQL ou, por exemplo, Kafka.
Curiosamente, os logs do Fluent Bit podem ser enviados para o Fluentd. Como o primeiro é mais leve e menos funcional, é possível coletar logs e enviá-los para Fluentd, onde, com a ajuda de plugins adicionais, podem ser processados e enviados para armazenamento.
Se você planeja usar Elasticsearch…
Por fim, duas dicas para aqueles que pretendem usar Elasticsearch como armazenamento de logs em produção.
- Configure alertas usando . Este programa extrai mensagens importantes do fluxo geral de logs e gera alertas por email ou em outro canal. No entanto, recentemente saiu uma .
- Gire logs usando o aplicativo ou chamando a API do Elasticsearch. O próprio Elastic, na verdade, está tomando medidas significativas para gerenciar o ciclo de vida dos índices sem precisar de ferramentas de terceiros. No geral, não faz sentido manter logs por muito tempo: é pouco provável que algum log seja necessário após duas semanas — se for realmente crítico, em duas semanas terá sido resolvido. Como último recurso, logs antigos podem ser arquivados e enviados para um armazenamento de longo prazo. Ouvi falar de logs específicos que, por lei, devem ser mantidos por até 5 anos. Pessoalmente, nunca me deparei com isso, mas eu não classificaria essas informações como logs comuns e, possivelmente, até os armazenaria separadamente.
Continua…
Autor: Marcel Ibraev, administrador Kubernetes certificado, engenheiro prático na empresa , palestrante e desenvolvedor de cursos .
Fonte: habr.com
