

Muitos estão familiarizados com o SGBD PostgreSQL, que se destacou em instalações pequenas. No entanto, a tendência de migração para soluções Open Source se tornou cada vez mais evidente, mesmo em grandes empresas e em requisitos empresariais. Neste artigo, abordaremos como integrar o Postgres em um ambiente corporativo e compartilharemos experiências na criação de um sistema de backup (SBK) para esse banco de dados, usando como exemplo o sistema de backup Commvault.
O PostgreSQL já provou sua eficácia — o SGBD funciona perfeitamente, sendo utilizado por negócios digitais modernos como Alibaba e TripAdvisor, e a ausência de custos de licenciamento o torna uma alternativa atraente a gigantes como MS SQL ou Oracle DB. No entanto, quando começamos a considerar o PostgreSQL no cenário corporativo, imediatamente nos deparamos com requisitos rigorosos: “E quanto à resiliência da configuração? E a recuperação em desastres? Onde está a monitoração abrangente? E o backup automatizado? Qual é o uso de bibliotecas de fitas, tanto diretamente quanto como armazenamento secundário?”
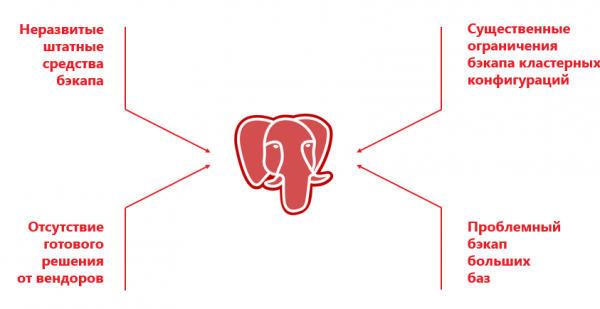
Por um lado, o PostgreSQL não possui ferramentas de backup integradas, como os ‘SGBDs maduros’ RMAN da Oracle DB ou SAP Database Backup. Por outro lado, fornecedores de sistemas de backup corporativo (Veeam, Veritas, Commvault) suportam PostgreSQL, mas na prática funcionam somente com configuracões específicas (geralmente standalone) e um conjunto de várias limitações.
Sistemas de backup projetados especificamente para PostgreSQL, como Barman, Wal-g, pg_probackup, são extremamente populares em pequenas instalações do SGBD PostgreSQL ou onde não são necessários backups pesados de outros elementos da paisagem de TI. Por exemplo, além do PostgreSQL, a infraestrutura pode incluir físicos e virtuais servidores, OpenShift, Oracle, MariaDB, Cassandra, etc. Todos esses devem preferencialmente ser respaldados por uma ferramenta comum. Implementar uma solução separada exclusivamente para o PostgreSQL é uma ideia ruim: os dados serão copiados para um disco e depois precisam ser transferidos para uma fita. Essa duplicação de backups aumenta o tempo de backup e, mais criticamente, o de restauração.
Na solução enterprise, o backup da instalação ocorre com um certo número de nós de um cluster dedicado. Por exemplo, o Commvault só consegue trabalhar com um cluster de dois nós, onde o Primary e o Secondary estão rigidamente fixados a nós específicos. E faz sentido fazer backup apenas do Primary, pois o backup do Secondary tem suas limitações. Devido às características do SGBD, o dump no Secondary não é criado, e, portanto, a única possibilidade é o backup de arquivos.
Para reduzir os riscos de inatividade, ao criar um sistema de alta disponibilidade, gera-se uma configuração de cluster "viva", e o Primary pode migrar gradualmente entre diferentes servidores. Por exemplo, o software Patroni inicia o Primary em um nó escolhido aleatoriamente do cluster. O SRM não possui uma maneira de rastrear isso "pronto para uso" e, se a configuração mudar, os processos falham. Ou seja, a implementação de um gerenciamento externo impede o SRM de funcionar de maneira eficaz, porque o servidor de gerenciamento simplesmente não entende de onde e quais dados precisam ser copiados.
Outro problema é a implementação do backup no Postgres. É possível através do dump e funciona bem em bancos pequenos. Mas em grandes bases de dados, o dump leva muito tempo, requer muitos recursos e pode causar a falha da instância do banco de dados.
O backup de arquivos corrige a situação, mas em grandes bases ele é lento, pois trabalha em modo de thread único. Além disso, os fornecedores impõem uma série de restrições adicionais. Por exemplo, não é possível usar ao mesmo tempo backup de arquivos e de dumps, ou então a deduplicação não é suportada. Existem muitos problemas, e na maioria das vezes é mais fácil escolher um SGBD caro, mas confiável, em vez do Postgres.
Não há como recuar! Atrás, estão os desenvolvedores de Moscovo!
No entanto, recentemente nossa equipe enfrentou um desafio difícil: no projeto de criação do AIS OSAGO 2.0, onde criamos a infraestrutura de TI, os desenvolvedores escolheram o PostgreSQL para o novo sistema.
Para grandes desenvolvedores de software, é muito mais simples usar soluções open-source "da moda". No mesmo time do Facebook, há especialistas suficientes para manter esse SGBD funcionando. No caso do RCA, todas as tarefas do "segundo dia" recaíam sobre nós. Era nossa responsabilidade garantir a alta disponibilidade, montar o cluster e, claro, implementar o backup. A lógica das ações era a seguinte:
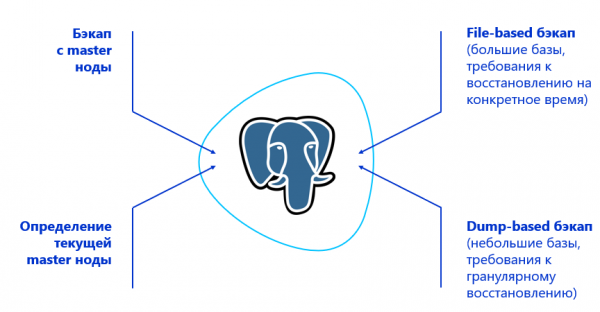
- Ensinar o SRK a fazer backup da nodo primário do cluster. Para isso, o SRK deve encontrá-la — logo, é necessária a integração com alguma solução de gerenciamento de cluster PostgreSQL. No caso do RSA, foi utilizado o software Patroni.
- Definir o tipo de backup com base nos volumes de dados e nas exigências de recuperação. Por exemplo, quando é necessário recuperar páginas de forma granular, usar um dump, e se os bancos forem grandes e a recuperação granular não for necessária — trabalhar no nível de arquivos.
- Adicionar ao sistema a capacidade de backup em bloco, para criar cópias de segurança em modo multithread.
No entanto, inicialmente nos propusemos a criar um sistema eficiente e simples, sem uma complexa estrutura de componentes adicionais. Quanto menos gambiarras, menos carga sobre a equipe e menor o risco de falhas no SRK. Abordagens que usavam Veeam e RMAN foram imediatamente excluídas, pois um pacote de duas soluções já sugere a falta de confiabilidade do sistema.
Um pouco de mágica para empresas
Então, precisávamos garantir um backup confiável para 10 clusters com 3 nós cada, enquanto um DC de backup espelha a mesma infraestrutura. Os DCs, em termos de PostgreSQL, operam sob o princípio ativo-passivo. O volume total dos bancos de dados era de 50 TB. Qualquer SRK de nível corporativo daria conta disso facilmente. Mas o detalhe é que inicialmente o Postgres não possui compatibilidade completa e profunda com sistemas de backup. Portanto, tivemos que procurar uma solução que já tivesse o máximo de funcionalidade integrada com o PostgreSQL e aprimorar o sistema.
Realizamos 3 hackathons internos — revisamos mais de cinquenta desenvolvimentos, testamos, fazemos alterações com base em nossas hipóteses e verificamos novamente. Após analisar as opções disponíveis, escolhemos o Commvault. Este produto já poderia trabalhar com a instalação clusterizada mais simples do PostgreSQL, e sua arquitetura aberta oferecia a esperança (que se concretizou) de um desenvolvimento e integração bem-sucedidos. Além disso, o Commvault consegue fazer backup dos logs do PostgreSQL. Por exemplo, o Veritas NetBackup em relação ao PostgreSQL só consegue realizar backups completos.
Mais informações sobre a arquitetura. Os servidores de gerenciamento Commvault foram instalados em cada um dos dois Data Centers na configuração CommServ HA. O sistema é espelhado, gerenciado através de um único console e, do ponto de vista de HA, atende a todos os requisitos de empresas.
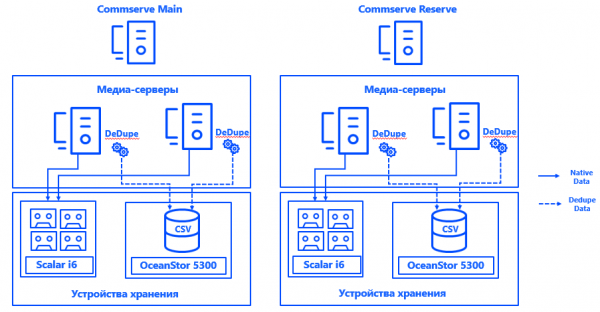
Além disso, em cada Data Center, iniciamos dois servidores de mídia físicos, aos quais foram conectados arrays de discos e bibliotecas de fitas especificamente dedicados a backups via SAN por Fibre Channel. As bases de deduplicação estendidas garantiram a resiliência dos servidores de mídia, e a conexão de cada servidor a cada CSV possibilitou a operação contínua na falha de qualquer componente. A arquitetura do sistema permite continuar o backup mesmo que um dos Data Centers falhe.
O Patroni determina o nó Primário para cada cluster. Este pode ser qualquer nó livre no Data Center — mas apenas no principal. No de reserva, todos os nós são Secundários.
Para que o Commvault compreenda qual nó do cluster é Primário, integramos o sistema (agradecemos à arquitetura aberta da solução) com o Postgres. Para isso, foi criado um script que informa sobre a localização atual do nó Primário ao controlador. servidor Commvault.
No geral, o processo é assim:
Patroni seleciona o Primário → Keepalived ativa o IP do cluster e executa o script → o agente Commvault no nó escolhido do cluster recebe a notificação de que é Primário → Commvault reconfigura automaticamente o backup dentro do pseudocliente.
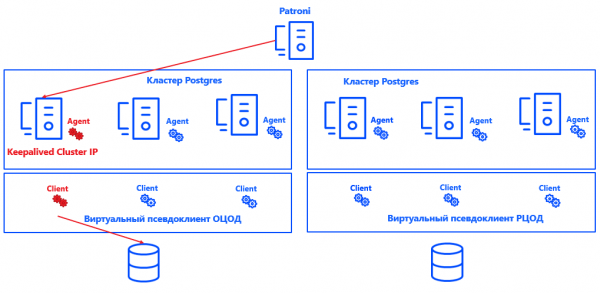
A vantagem dessa abordagem é que a solução não afeta a consistência, a correção dos logs ou a recuperação da instância do Postgres. Ela também é fácil de escalar, pois agora não é mais necessário fixar o nó Primário e os Secundários para o Commvault. É suficiente que o sistema saiba onde está o Primário, e o número de nós pode ser aumentado praticamente sem limites.
A solução não se apresenta como perfeita e possui suas nuances. O Commvault consegue fazer backup apenas da instância inteira, e não de bancos de dados individuais. Assim, para cada BD, uma instância separada foi criada. Os clientes reais são agrupados em pseudoclientes virtuais. Cada pseudocliente Commvault representa um cluster UNIX. Nele, são adicionados os nós do cluster em que o agente Commvault para Postgres está instalado. Como resultado, todos os nós virtuais do pseudocliente são feitos backup como uma única instância.
Dentro de cada pseudocliente está um nó ativo do cluster. É ele que nossa solução de integração para Commvault determina. O princípio de funcionamento é bastante simples: se um IP de cluster é ativado no nó, o script define no binário do agente Commvault o parâmetro "nó ativo" — na prática, o script coloca "1" na parte adequada da memória. O agente transmite esses dados para o CommServe, e o Commvault faz o backup do nó necessário. Além disso, a configuração é verificada no nível do script, ajudando a evitar erros ao iniciar o backup.
Nesse contexto, grandes bancos de dados são copiados em blocos em múltiplos streams, atendendo aos requisitos de RPO e janela de backup. A carga no sistema é insignificante: cópias completas acontecem com pouca frequência, e nos outros dias são coletados apenas logs, especialmente em períodos de baixa carga.
A propósito, aplicamos políticas separadas para o backup de logs arquivados do PostgreSQL — eles são armazenados sob regras diferentes, copiados em um cronograma distinto e a deduplicação não é ativada para eles, pois esses logs contêm dados únicos.
Para garantir a consistência de toda a infraestrutura de TI, clientes de arquivo Commvault estão instalados em cada nó do cluster. Eles excluem arquivos do Postgres dos backups e são destinados apenas para o backup do sistema operacional e de aplicações. Para essa parte dos dados, também existe uma política própria e um prazo de retenção específico.
Atualmente, o SRK não afeta os serviços produtivos, mas se a situação mudar, é possível ativar o sistema de limitação de carga no Commvault.
É aceitável? É aceitável!
Assim, obtemos não apenas um backup funcional, mas também totalmente automatizado para a instalação em cluster do PostgreSQL, que atende a todas as exigências de desafios empresariais.
Os parâmetros de RPO e RTO de 1 hora e 2 horas estão amplamente cobertos, o que significa que o sistema atenderá a esses requisitos mesmo com um crescimento significativo no volume de dados armazenados. Apesar de muitas dúvidas, PostgreSQL e ambientes empresariais provaram ser perfeitamente compatíveis. E agora sabemos pela nossa experiência que backups para tais SGBDs são possíveis em diversas configurações.
Certamente, nesse caminho tivemos que desgastar sete pares de botas de ferro, enfrentar uma série de dificuldades, pisar em alguns obstáculos e corrigir uma quantidade de erros. Mas agora, a abordagem já foi testada e pode ser aplicada para a implementação de Open Source em vez de SGBDs proprietários em condições severas de enterprise.
Você já tentou trabalhar com PostgreSQL em um ambiente corporativo?
Autores:
Oleg Lavrenov, engenheiro de projeto de sistemas de armazenamento de dados da "Infosystems Jet"
Dmitry Yerykin, engenheiro de projeto de complexos computacionais da "Infosystems Jet"
Fonte: habr.com
