

Vamos discutir por que ferramentas de CI e CI são coisas bem diferentes.
Qual dor o CI pretende resolver, de onde surgiu a ideia, quais as últimas evidências de que funciona, como entender se você tem uma prática real e não apenas um Jenkins instalado.
A ideia de fazer uma apresentação sobre Integração Contínua surgiu há um ano, quando estava em entrevistas em busca de emprego. Falei com 10-15 empresas, e apenas uma conseguiu explicar claramente o que é CI e como percebeu que não o tinha. As outras falavam coisas sem sentido sobre Jenkins 🙂 Bem, temos Jenkins, ele faz compilações, CI! Na apresentação, tentarei explicar o que realmente é Integração Contínua e por que Jenkins e ferramentas semelhantes têm relação muito fraca com isso.
E então, o que normalmente vem à mente ao ouvir a palavra CI? A maioria das pessoas pensará em Jenkins, Gitlab CI, Travis, etc.
Mesmo se fizermos uma busca, esses ferramentas aparecerão.
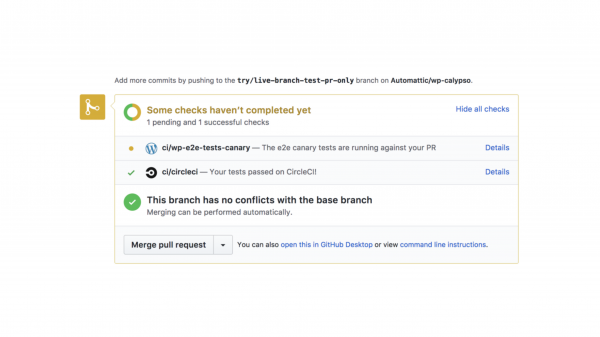
Se você perguntar a alguém, logo após listar as ferramentas, eles dirão que CI é quando sua Pull Request em um commit dispara uma compilação e a execução de testes.
Integração Contínua não é sobre ferramentas, não é sobre compilações com testes em uma branch! Integração Contínua é a prática de integrar código novo com muita frequência e para isso não é necessário criar Jenkins, GitLab, etc.
Antes de entendermos como é um CI pleno, vamos primeiro nos aprofundar no contexto das pessoas que o criaram e sentir a dor que estavam tentando resolver.
E a dor que resolveram foi a da colaboração em equipe!
Vamos olhar exemplos das dificuldades que os desenvolvedores enfrentam ao trabalhar em equipe. Aqui temos um projeto, a branch master no git e dois desenvolvedores.
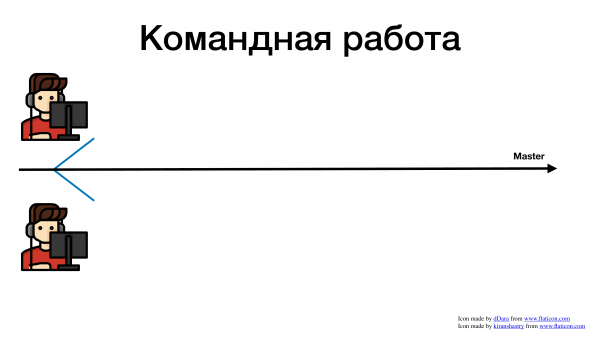
E eles começaram a trabalhar como todos já estão acostumados. Pegaram uma tarefa no Jira, criaram uma feature branch e começaram a escrever código.
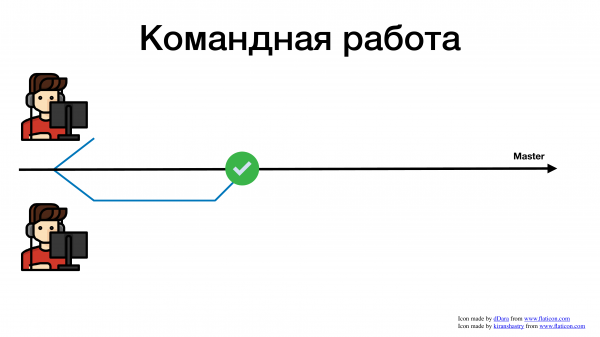
Um terminou a feature mais rápido e fez o merge na master.
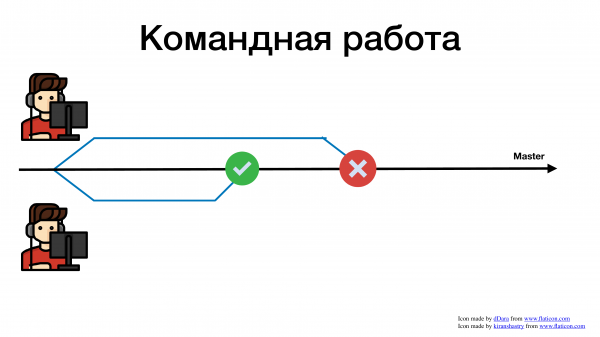
O outro levou mais tempo, fez o merge depois e encontrou um conflito. Agora, em vez de escrever as features necessárias para o negócio, o desenvolvedor gasta seu tempo e esforço resolvendo conflitos.
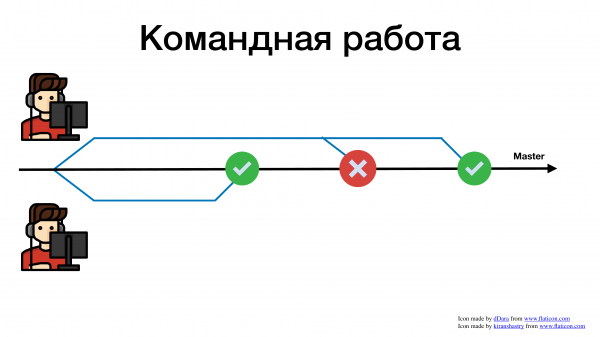
Quanto mais complicado for unir sua funcionalidade ao repositório principal, mais tempo gastaremos com isso. E este é apenas um exemplo bastante simples. Imagine se houver 10, 15 ou até 100 pessoas na empresa contribuindo para um único repositório. Você enlouqueceria tentando resolver todos esses conflitos.
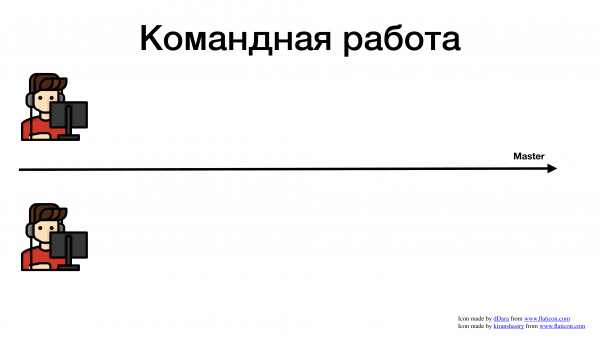
Há um caso um pouco diferente. Temos um repositório principal e vários desenvolvedores que estão fazendo algo.
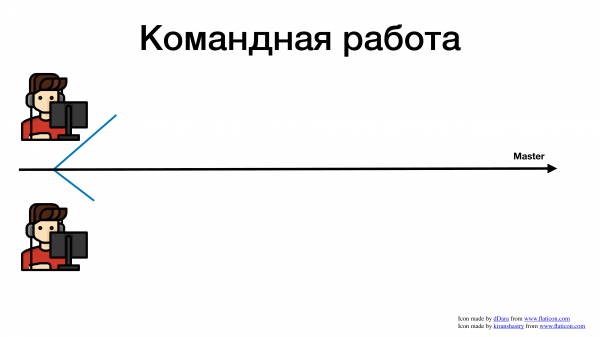
Eles criaram um branch cada um.
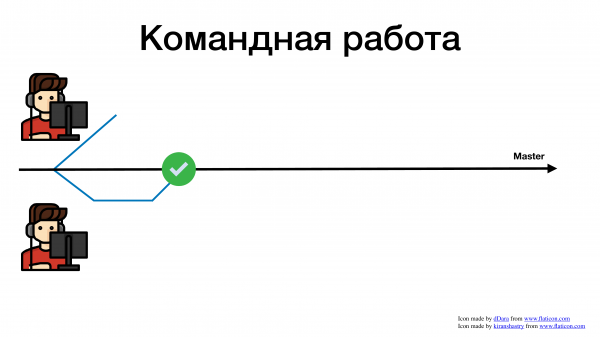
Um deles fez o merge, tudo certo, completou a tarefa.
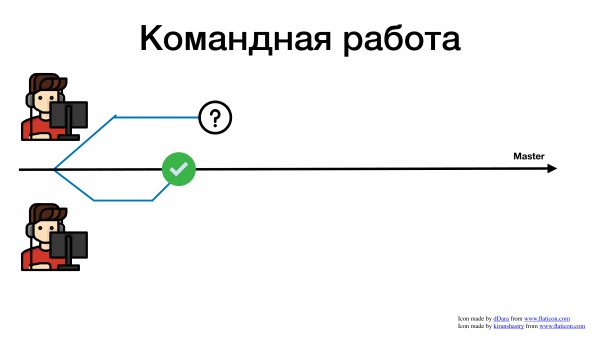
O segundo desenvolvedor, enquanto isso, completou sua tarefa. Suponha que ele a tenha enviado para revisão. Em muitas empresas, existe a prática de revisão. Por um lado, essa prática é boa e útil, mas, por outro, pode nos atrasar em muitos aspectos. Não vamos nos aprofundar nisso, mas aqui está um ótimo exemplo do que pode ocorrer com uma história problemática de revisão. Você submeteu um pull request para revisão. O desenvolvedor não tem mais nada a fazer. O que ele começa a fazer? Ele começa a pegar outras tarefas.
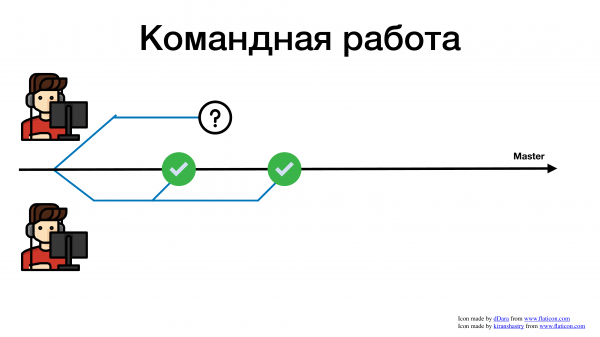
Durante esse tempo, o segundo desenvolvedor fez mais alguma coisa.
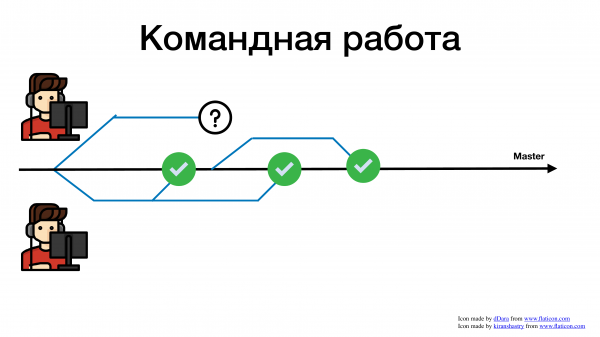
O primeiro completou a terceira tarefa.
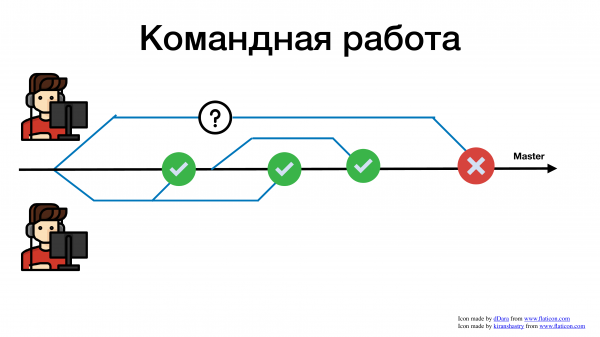
E após um tempo considerável, sua revisão foi testada, e ele tenta fazer o merge. E o que acontece? Ele encontra uma enorme quantidade de conflitos. Por quê? Porque enquanto seu pull request ficou pendente de revisão, o código já foi alterado significativamente.
Além do problema dos conflitos, há também o problema das comunicações. Enquanto você tem um branch pendente de revisão, enquanto ele está esperando, enquanto você leva um tempo considerável para finalizar a funcionalidade, você para de acompanhar o que mais está mudando na base de código do seu serviço. Pode ser que o que você está tentando resolver já tenha sido resolvido ontem, e você poderia reutilizar algum método. Mas você não verá isso, porque sempre estará trabalhando com um branch desatualizado. E esse branch desatualizado sempre resulta em você ter que resolver um conflito de merge.
Portanto, se estamos trabalhando em equipe, ou seja, não apenas uma pessoa mexendo no repositório, mas sim de 5 a 10 pessoas, quanto mais tempo demoramos para adicionar nosso código ao repositório principal, mais sofremos com a necessidade de fazer um merge no final. E quanto mais conflitos houver, e quanto mais antiga for a versão com a qual estamos trabalhando, mais problemas teremos.
Trabalhar em conjunto é doloroso! Sempre estamos atrapalhando uns aos outros.
Esse problema foi notado há mais de 20 anos. A primeira menção à prática de Integração Contínua que encontrei foi na programação extrema.
Programação extrema é o primeiro framework ágil. A página foi criada em 1996. A ideia era usar algumas práticas de programação, planejamento e outras coisas para que o desenvolvimento fosse o mais flexível possível, para que pudéssemos reagir mais rapidamente a mudanças e requisitos de nossos clientes. E há 24 anos, começaram a perceber que, se você faz algo por muito tempo à parte, gasta mais tempo com isso devido a conflitos.
Agora vamos analisar a expressão "Integração Contínua" palavra por palavra. Se traduzirmos literalmente, é integração contínua. Mas o quão contínua ela é não está muito claro, ela é, na verdade, bastante intermitente. E o quanto ela é uma integração também não é muito óbvio.
E por isso trago agora citações da programação extrema. Vamos analisar as duas palavras separadamente.
Integração — Como já mencionei, buscamos que cada engenheiro trabalhe com a versão mais atual do código, para que ele adicione seu código o mais frequentemente possível à branch principal, para que sejam pequenas branches. Porque se forem grandes, podemos facilmente ficar presos por uma semana com conflitos de merge. Especialmente se estivermos em um ciclo de desenvolvimento longo, como o waterfall, onde o desenvolvedor foi trabalhar por um mês em algum enorme recurso. E, no estágio de integração, pode ficar preso por muito tempo.
Integração — é quando pegamos nossa branch e a integramos ao master, fazemos o merge. Há uma variante suprema, quando habilitamos o desenvolvedor transbase, onde buscamos que escrevamos direto no master sem branches desnecessárias.
Em resumo, a integração é pegar seu código e levá-lo para o master.
O que se entende por "continuous" aqui, o que é continuidade? A prática implica que o desenvolvedor busca integrar seu código o mais rápido possível. Esse é seu objetivo ao executar qualquer tarefa - fazer com que seu código apareça no mestre o mais rápido possível. Em um mundo ideal, os desenvolvedores fariam isso a cada poucas horas. Ou seja, você pega uma pequena tarefa, mescla-a no mestre. Tudo ótimo. Você almeja isso. E deve fazer isso continuamente. Assim que você faz algo, você imediatamente o insere no mestre.
E o desenvolvedor que faz algo é responsável pelo que ele fez, garantindo que funcione e que nada seja quebrado. Aqui geralmente surge a questão dos testes. Queremos executar alguns testes em nosso commit, em nosso merge, para garantir que tudo funcione. E é aqui que o Jenkins pode ajudar.
Mas com as histórias: vamos fazer as mudanças pequenas, vamos fazer as tarefas pequenas, e vamos tentar fazer a tarefa e imediatamente integrá-la no mestre - aqui nenhum Jenkins vai ajudar. Porque o Jenkins vai te ajudar exclusivamente a executar os testes.
Você pode se virar sem eles. Isso não vai te atrapalhar em nada. Porque o objetivo da prática é mesclarse o mais frequentemente possível, para não gastar uma quantidade enorme de tempo em conflitos futuros.
Vamos imaginar que estamos no ano de 2020, mas por algum motivo estamos sem internet. E estamos trabalhando localmente. Não temos Jenkins. Isso é normal. Você ainda pode criar uma branch local. Você escreveu algum código nela. Fez uma tarefa em 3-4 horas. Mudou para o mestre, fez git pull, mesclou sua branch. Pronto. Se você fizer isso frequentemente – parabéns, você tem Integração Contínua!
Quais são as evidências no mundo moderno de que vale a pena investir esforço nisso? Porque, no geral, é complexo. Se você tentar trabalhar assim, vai perceber que isso envolve algum planejamento, e você precisará dedicar mais tempo à decomposição das tarefas. Porque se você for fazer man..., não conseguirá se mesclar rapidamente e, consequentemente, acabará em apuros. Você não terá mais as práticas.
E isso será caro. Não será possível trabalhar a partir de amanhã em Continuous Integration. Todos vocês vão demorar muito para se acostumar, vão levar muito tempo para aprender a decompor tarefas, e vão levar muito tempo para se acostumar a refazer a prática de revisão, se é que a têm. Porque nosso objetivo é que o merge aconteça hoje. E se vocês fazem a revisão ao longo de três dias, então vocês têm problemas e o Continuous Integration não funciona.
Mas temos algumas evidências atuais que nos dizem que vale a pena investir nessa prática?
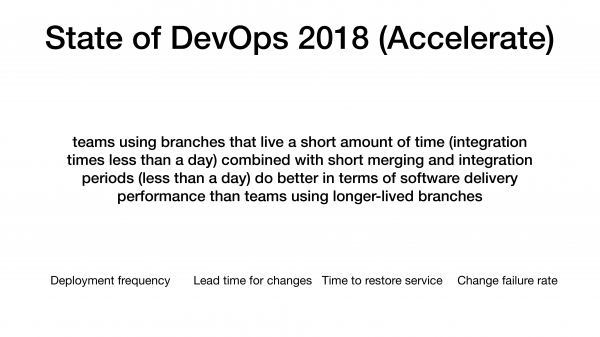
A primeira coisa que me veio à mente foi o State of DevOps. É uma pesquisa que a equipe realiza há 7 anos. Atualmente, eles fazem isso como uma organização independente, mas sob o Google.
E a pesquisa deles, em 2018, mostrou uma correlação entre empresas que tentam usar branches de curta duração, que se integram rapidamente e com frequência; elas têm indicadores de desempenho de TI muito melhores.
Quais são esses indicadores? São 4 métricas que eles coletam de todas as empresas em seus questionários: frequência de deploy, tempo para mudanças, tempo para restaurar o serviço e taxa de falhas nas mudanças.
E, em primeiro lugar, há essa correlação; sabemos que as empresas que fazem merges frequentemente têm métricas muito melhores. Eles dividem as empresas em várias categorias: empresas lentas, que produzem algo lentamente, performers medianos, high performers e a elite. A elite é composta por Netflix, Amazon, que são super ágeis, fazem tudo rapidamente, de forma bonita e com qualidade.
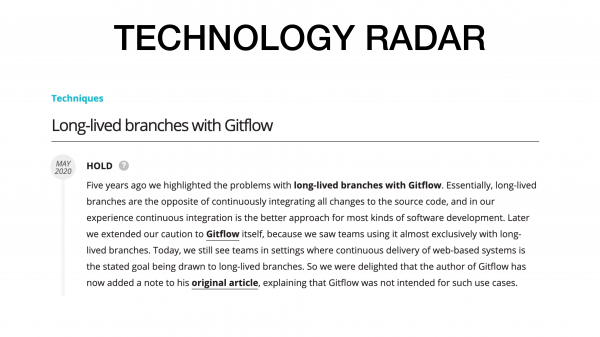
A segunda história aconteceu literalmente há um mês. No Technology Radar, surgiu uma nota maravilhosa sobre o Gitflow. O Gitflow se diferencia dos outros por ter branches que vivem por um longo tempo. Existem branches de release que duram muito, e branches de features que também vivem muito. Essa prática no Technology Radar foi movida para HOLD. Por quê? Porque as pessoas enfrentam a dor da integração.
Se você tem uma branch que vive muito tempo, ela acaba se estragando, e começamos a gastar mais tempo para fazer alguma mudança nela.
E recentemente, o autor do Gitflow disse que se você está buscando a Integração Contínua, se deseja integrar com a maior frequência possível, então o Gitflow é uma má ideia. Ele acrescentou em um artigo que se você tem um backend onde pode se esforçar para isso, o Gitflow é desnecessário, pois o Gitflow vai desacelerá-lo e criar problemas de integração.
Isso não significa que o Gitflow seja ruim e que não deva ser utilizado. Ele é para outros casos. Por exemplo, quando você precisa suportar várias versões de um serviço ou aplicativo, ou seja, quando é preciso dar suporte por um período prolongado.
Mas se você conversar com pessoas que sustentam tais serviços, ouvirá muitas queixas sobre como essa versão era 3.2, que foi lançada há 4 meses, e que essa correção não foi incluída. Agora, para integrá-la, é necessário fazer uma porção de alterações. E então eles ficam presos novamente, passando uma semana tentando mesclar uma nova funcionalidade.
Como Alexander Kovalev corretamente observou no chat, correlação não é o mesmo que causalidade. É isso mesmo. Ou seja, não há uma relação direta de que se você tem Integração Contínua, todas as métricas serão ótimas. Mas há uma correlação positiva, onde se um existe, o outro provavelmente também existe. Não é uma certeza, mas é provável. É apenas uma correlação.
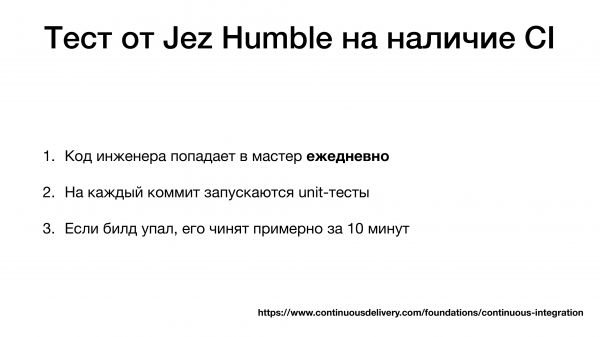
Parece que já estamos fazendo algo, parece que estamos mesclando, mas como saber se realmente temos Integração Contínua, que estamos mesclando com frequência suficiente?
Jez Humble é o autor do Handbook, Accelerate, do site Continuous Delivery e do livro "Continuous Delivery". Ele propõe o seguinte teste:
- O código do engenheiro entra no master diariamente.
- Para cada commit, você executa testes unitários.
- Se o build no master falhar, ele é corrigido em cerca de 10 minutos.
Ele sugere usar esse teste para garantir que você realmente possui a prática.
O que eu encontro um pouco controverso. Ou seja, se você pode consertar em 10 minutos, significa que você tem Integração Contínua, isso soa um pouco estranho, na minha opinião, mas faz sentido. Por quê? Porque, se você faz merges com frequência, isso significa que suas mudanças são pequenas. Se uma pequena mudança causar a quebra da build do master, você poderá encontrar o problema rapidamente, porque a alteração é pequena. Você teve um pequeno merge, onde mudaram 20-30 linhas. E, consequentemente, você pode entender rapidamente qual foi a razão, porque as mudanças são mínimas e você tem uma área de busca muito restrita para o problema.
E mesmo que após o lançamento nosso prod quebre, se tivermos a prática de Integração Contínua, será muito mais fácil agir, porque as mudanças são pequenas. Sim, isso afetará o planejamento. Isso será doloroso. E talvez o mais difícil nessa prática seja se acostumar a dividir as tarefas, ou seja, como fazer algo em algumas horas e ao mesmo tempo passar pela revisão, se você a tiver. A revisão é uma dor separada.
Os testes unitários são apenas um assistente que te ajuda a entender se a sua integração foi bem-sucedida, se nada foi quebrado. Na minha opinião, isso também não é um ponto obrigatório, porque o sentido da prática não está nisso.
Isso é um resumo sobre Integração Contínua. É tudo o que há nessa prática. Estou aberto a perguntas.
Resumindo, apenas mais uma vez:
- Integração Contínua não é Jenkins, não é Gitlab.
- Não é uma ferramenta, é uma prática de que fazemos merges do nosso código no master o mais frequentemente possível.
- Fazemos isso para evitar a imensa dor que surge com os merges no futuro, ou seja, estamos sentindo uma pequena dor agora para não sentir uma grande dor mais tarde. Esse é todo o sentido.
- Há uma comunicação através do código, mas eu raramente vejo isso, mas também foi pensado para isso.
Perguntas
O que fazer com tarefas não decompostas?
Decompor. Qual é o problema? Você pode dar um exemplo de que há uma tarefa que não pode ser decomposta?
Existem tarefas que não podem ser decompostas de forma alguma, por exemplo, aquelas que requerem uma expertise muito profunda e que realmente podem levar um mês para um resultado razoável.
Se eu entendi corretamente, há uma tarefa grande e complexa cujo resultado só será visível em um mês?
Sim, isso mesmo. O resultado só poderá ser avaliado depois de pelo menos um mês.
Certo. Em geral, isso não é um problema. Por quê? Porque, neste caso, quando falamos sobre branches, não estamos falando de uma branch com uma feature. As features podem ser grandes e complexas. Elas podem envolver muitos componentes. E, talvez, não possamos completá-las em uma única branch. Isso é normal. Precisamos apenas dividir essa história. Se a feature não estiver completamente pronta, isso não significa que algumas partes do código não podem ser merged. Você adicionou, por exemplo, uma migração e dentro da feature há algumas etapas. Você pode ter uma etapa – fazer a migração, adicionar um novo método. E você já pode fazer o merge dessas coisas diariamente.
Certo. Qual é o sentido disso?
Qual é o sentido de fazer merge de pequenas partes diariamente?
Sim.
Se algo quebrar, você perceberá imediatamente. Você tem um pequeno pedaço que causou um erro, e é mais fácil corrigir isso. O sentido é que fazer o merge de um pequeno trecho agora é muito mais simples do que fazer o merge de algo grande em algumas semanas. E o terceiro ponto é que outros engenheiros estarão trabalhando com a versão atualizada do código. Eles verão que algumas migrações foram adicionadas e que há um novo método que eles também podem querer usar. Todos poderão ver o que está acontecendo no seu código. É exatamente para essas três razões que essa prática é implementada.
Obrigado, questão encerrada!
(Oleg Soroka) Posso adicionar algo? Você falou tudo certo, quero apenas acrescentar uma frase.
Certo.
Na Integração Contínua, o código é merged na branch principal não quando a feature está completamente pronta, mas quando o build parou de falhar. E você pode fazer commits no master quantas vezes quiser por dia. O segundo aspecto – se você não consegue, por algum motivo, dividir uma tarefa de um mês em tarefas de pelo menos três dias, sem contar três horas, então você tem um grande problema. E o fato de você não ter Integração Contínua é a menor das suas preocupações. Isso significa que você tem problemas com a arquitetura e práticas de engenharia estão em zero. Porque mesmo que seja uma pesquisa, de qualquer forma, deve ser estruturada na forma de hipóteses ou ciclos.
Falamos sobre 4 métricas que diferenciam empresas bem-sucedidas das que ficam para trás. É necessário alcançar essas 4 métricas primeiro. Se você leva um mês para realizar uma tarefa média, eu começaria a me concentrar primeiramente nessa métrica. Reduziria-a inicialmente para 3 dias. Depois disso, começaria a pensar sobre Continuous.
Entendi corretamente que você acha que, se qualquer tarefa leva um mês, não faz sentido investir em práticas de engenharia?
Você tem Continuous Integration. E há um ponto em que você conserta uma correção ou reverte em 10 minutos. Imagine que você o lançou. E mais, você tem até continuous deployment, você o lançou no prod e apenas depois percebeu que algo deu errado. E você precisa reverter, mas já ocorreu a migração do banco de dados. A sua versão do esquema do banco de dados já está na próxima, além disso, um backup já foi feito e dados foram registrados.
E qual é a sua alternativa? Se você reverte o código, ele não pode mais funcionar com esse banco de dados atualizado.
O banco só avança, sim.
As pessoas que têm uma má prática de engenharia provavelmente também não leram um livro grosso sobre... O que fazer com o backup? Se você está se recuperando de um backup, significa que você está perdendo dados que foram acumulados durante esse tempo. Por exemplo, você trabalhou por três horas com a nova versão do banco de dados, e usuários se registraram lá. Você decide voltar para um backup antigo, porque com a nova versão o esquema não funciona, portanto, você perdeu esses usuários. E eles estão insatisfeitos e reclamando.
Para dominar todo o espectro de práticas que suportam Continuous Integration e Continuous Delivery, não é suficiente apenas aprender a escrever... Primeiro, pode haver um número excessivo de práticas, o que seria impraticável. Além disso, existem muitas outras práticas como a Scientific. Há uma prática que o GitHub popularizou em um determinado momento. Isso acontece quando você executa simultaneamente o código antigo e o novo. É quando você está trabalhando em uma feature incompleta, mas que pode retornar algum valor: seja como uma função ou como uma API Rest. Você executa tanto o novo quanto o antigo código e compara a diferença entre eles. E se houver uma diferença, você registra esse evento. Assim, você sabe que sua nova feature está pronta para ser liberada em cima da antiga, se não houver divergências entre os dois durante um determinado período.
Existem centenas dessas práticas. Eu recomendaria começar com o transbase development. Não é 100% baseado em Continuous Integration, mas as práticas são as mesmas, uma não vive sem a outra.
Você mencionou o transbase development como um exemplo de onde olhar as práticas ou está sugerindo que as pessoas comecem a usar o transbase development?
Olhar, pois eles não poderão usá-lo. Para utilizá-lo, é necessário ler bastante. E quando surge a pergunta para a pessoa: "O que fazer com uma feature que leva um mês?", isso significa que ela não leu sobre transbase development. Eu não recomendaria isso por enquanto. Eu recomendaria focar exclusivamente no tema de como dividir arquitetonicamente grandes tarefas em menores. Essa é a essência da decomposição.
Decomposição é uma das ferramentas do arquiteto. Primeiro fazemos a análise, depois a decomposição, depois a síntese, e por fim a integração. Assim, tudo se encaixa. E antes de chegar ao Continuous Integration, ainda precisamos passar pela decomposição. No primeiro estágio, surgem questões, e já estamos falando do quarto estágio, ou seja, quanto mais frequentemente fizermos a integração, melhor. É ainda um pouco cedo para isso; seria melhor primeiro dividir seu monólito.
É necessário desenhar algumas setas e quadrados em algum esquema. Você não pode dizer que agora vou mostrar o diagrama arquitetônico de um novo aplicativo e mostrar um quadrado, dentro do qual há um botão verde para o aplicativo. De qualquer forma, haverá mais quadrados e setas. Em qualquer diagrama que eu vi, havia mais de um. E a decomposição, mesmo no nível da representação gráfica, já está sendo feita. Portanto, os quadrados podem ser feitos independentes. Caso contrário, eu tenho grandes perguntas para o arquiteto.
Há uma pergunta no chat: "Se a revisão é obrigatória e leva muito tempo, um dia ou mais?".
Vocês têm problemas com a prática. A revisão não deve levar um dia ou mais. É a mesma questão do anterior, só que um pouco mais suave. Se uma revisão leva um dia, significa que provavelmente está revisando alguma mudança muito grande. Portanto, é preciso fazer mudanças menores. No desenvolvimento Transbase, que Oleg recomendou, existe uma abordagem que se chama revisão contínua. A ideia é que fazemos um pull request tão pequeno intencionalmente, porque buscamos fundir constantemente e aos poucos. Assim, o pull request altera uma abstração ou 10 linhas. Com isso, a revisão leva apenas alguns minutos.
Se a revisão leva um dia ou mais, significa que algo está errado. Primeiro, pode ser que vocês tenham problemas com a arquitetura. Ou é um trecho grande de código, com 1.000 linhas, por exemplo. Ou sua arquitetura é tão complexa que a pessoa não consegue entender. Este é um problema secundário, mas também terá que ser resolvido. Talvez a revisão nem seja necessária. Você também deveria pensar sobre isso. A revisão é algo que te retém. Ela traz seus benefícios de forma geral, mas é preciso entender por que vocês estão fazendo isso. Isso é uma forma de transmitir informações rapidamente para vocês, é uma forma de estabelecer alguns padrões internos ou o quê? Por que vocês precisam disso? Porque a revisão precisa ser feita de forma bem rápida ou deve ser cancelada. Isso é como o desenvolvimento Transbase – é uma história muito bonita, mas apenas para pessoas experientes.
Quanto às 4 métricas, eu ainda recomendaria coletá-las para entender a que isso leva. Olhar os números, visualizar a imagem, quão ruim tudo está.
(Dmitry) Estou pronto para discutir isso com você. Números e métricas são ótimos, práticas também são ótimas. Mas é preciso entender se isso é necessário para o negócio. Existem negócios que não precisam dessa velocidade de mudança. Conheço empresas onde não se pode fazer mudanças a cada 15 minutos. E não é porque elas são ruins. É um ciclo de vida. E para implementar recursos como branches e toggles, é necessário profundo conhecimento.
É complicado. Se você quiser ler mais sobre a história do recurso toggle, recomendo muito. . E há um ótimo artigo de Martin Fowler sobre toggles: sobre os tipos, ciclos de vida, etc. O recurso toggle é complexo.
E você ainda não respondeu à pergunta: 'Jenkins é necessário ou não?'
Jenkins não é necessário em nenhum caso, na verdade. Se formos sérios, ferramentas como Jenkins e Gitlab trazem conveniência. Você verá se a compilação foi bem-sucedida ou não. Elas podem ajudar, mas não trazem a prática. Elas podem apenas mostrar um círculo – OK, não OK. E isso se você ainda estiver escrevendo testes, porque se não houver testes, isso é quase sem sentido. Portanto, é necessário porque é mais conveniente, mas, no geral, você pode viver sem ele e não perderá muito.
Ou seja, se você tem práticas, isso significa que ele não é necessário?
Exatamente. Recomendo o teste de Jez Humble. Tenho uma relação ambivalente com o último ponto. Mas, de maneira geral, se você tem três coisas: você está fazendo merges constantemente, você executa testes em commits na master, e corrige rapidamente a build na master, então, talvez você não precise de mais nada.
Enquanto aguardamos perguntas dos participantes, eu tenho uma pergunta. Nós falamos sobre código de produto. Você usou isso para código de infraestrutura? É o mesmo código, tem os mesmos princípios e o mesmo ciclo de vida, ou existem ciclos de vida e princípios diferentes? Normalmente, quando todos falam sobre Integração e Desenvolvimento Contínuos, esquecem que também existe código de infraestrutura. E, ultimamente, isso tem crescido cada vez mais. Deveríamos aplicar todas essas regras lá?
Não é só que deveríamos, seria ótimo, porque isso definitivamente tornará a vida mais fácil. Assim que trabalhamos com código, não com scripts em bash, mas temos um código adequado.
Espere, espere, um script em bash também é código. Não mexa no meu velho amor.
Bem, não vou pisotear suas memórias. Eu tenho uma aversão pessoal ao bash. Ele quebra de forma feia e estranha o tempo todo. E quebra frequentemente de maneira imprevisível, por isso não gosto dele. Mas bem, vamos supor que você tenha um código em bash. Pode ser que eu realmente não entenda e que existam frameworks decentes para testes. Eu simplesmente não estou por dentro. E acabamos obtendo os mesmos benefícios.
Assim que começamos a trabalhar com infraestrutura como código, enfrentamos os mesmos problemas que os desenvolvedores. Há alguns meses, me deparei com uma situação em que um colega me enviou um pull request de 1.000 linhas em bash. E você fica preso na revisão por 4 horas. Os problemas são os mesmos. Ainda é código. E ainda é um trabalho colaborativo. Ficamos atolados com pull requests e lidando com os mesmos conflitos de mesclagem do bash, por exemplo.
Atualmente, estou observando muito ativamente toda essa questão do programar infraestrutura de forma bonita. Estou usando o Pulumi na infraestrutura. É programação pura. É ainda mais atraente, porque tenho todas as capacidades da linguagem de programação, ou seja, usei os mesmos ifs para criar toggles bonitos e tudo ficou bem. Ou seja, minha mudança já está no master. Todos já a veem. Outros engenheiros estão cientes disso. Já influenciou em algo. Mas, ao mesmo tempo, não foi ativado para todas as infraestruturas. Foi ativado para meus ambientes de teste, por exemplo. Portanto, respondendo sua pergunta mais uma vez, é necessário. Isso definitivamente simplifica a vida para nós, engenheiros que trabalham com código.
Alguém tem mais perguntas?
Eu tenho uma pergunta. Quero continuar a discussão com Oleg. No geral, acho que você está certo, se uma tarefa leva um mês, você tem um problema com a arquitetura, tem um problema com análise, decomposição, planejamento, etc. Mas tenho a sensação de que, se você começar a tentar viver de acordo com a Integração Contínua, começará a corrigir as dores do planejamento, porque não há como escapar disso.
(Oleg) Sim, é isso mesmo. Em termos de esforço, essa prática é comparável a qualquer outra prática séria que muda a cultura. O mais difícil de superar são os hábitos, especialmente os maus hábitos. E se para implementar essa prática for necessária uma mudança significativa nos hábitos dos outros: desenvolvedores, gerência, gerente de produção, você pode esperar surpresas.
Quais podem ser essas surpresas? Suponha que você decidiu que vai integrar mais frequentemente. E na integração, você tem algumas outras coisas ligadas, como artefatos. E na sua empresa, por exemplo, há uma política de que cada artefato deve ser de alguma forma contabilizado em algum sistema de armazenamento de artefatos. E isso leva algum tempo. A pessoa precisa marcar que, como gerente de lançamento, ela verificou esse artefato para estar pronto para ser levado à produção. Se isso leva de 5 a 10 a 15 minutos, mas você faz uma implementação uma vez por semana, perder meia hora uma vez por semana não é um grande ônus.
Se você está fazendo Continuous Integration 10 vezes por dia, então precisa multiplicar 10 por 30 minutos. E isso ultrapassa a quantidade de tempo de trabalho desse gerente de lançamento. Ele simplesmente fica cansado de fazer isso. Existem custos constantes envolvidos em certas práticas. E é isso.
E você precisa ou cancelar essa regra para parar de fazer essa imbecilidade, ou seja, você não atribui manualmente uma gradação de conformidade de algo a algo. Você confia totalmente em um conjunto automatizado de testes de prontidão.
E se você precisa de alguma prova de alguém para que o chefe assine, e você não entra na produção sem que o Vasya diga que ele permite, etc. – toda essa bobagem se interpõe nas práticas. Porque se há atividades associadas a um ônus, tudo aumenta 100 vezes. Portanto, a mudança muitas vezes não será recebida de forma positiva por todos. Porque é difícil corrigir os hábitos das pessoas.
Quando uma pessoa faz um trabalho habitual, ela o realiza praticamente sem pensar. A carga cognitiva é igual a zero. Ela apenas executa com base no que já está pronto, já tem uma lista de verificação em mente, ela já fez isso mil vezes. E assim que você chega e diz: 'Vamos cancelar essa prática e a partir de segunda-feira implementaremos uma nova', para ele isso se torna uma carga cognitiva pesada. E essa carga surge imediatamente para todos.
Portanto, a coisa mais simples, embora esta luxúria nem todos possam se permitir, é o que sempre faço. Quando um novo projeto é iniciado, geralmente todas as práticas não testadas são imediatamente incorporadas ao projeto. Enquanto o projeto é jovem, não corremos muitos riscos. Não há produção, não há nada a desmoronar. Então, podemos usar isso como uma prática. Esta abordagem funciona. No entanto, nem todas as empresas têm a oportunidade de iniciar esses projetos com frequência. Embora isso também seja um pouco estranho, porque agora é uma verdadeira transformação digital, todos devem iniciar experimentos para acompanhar a concorrência.
Aqui você se depara com o fato de que primeiro deve haver um entendimento do que é necessário fazer. O mundo não é perfeito, a produção também não é perfeita.
Sim, essas coisas estão interligadas.
Os negócios também nem sempre entendem que precisam ir por esse caminho.
Há uma situação em que nenhuma mudança é possível. É uma situação em que a equipe está sob pressão constante. A equipe já está bastante esgotada. Ela não tem nenhum tempo de sobra para experimentos. Eles estão produzoindo funcionalidades o dia todo. E a gerência quer cada vez mais funcionalidades. Às vezes, na verdade, nada muda. A equipe pode apenas ser informada de que amanhã farão da mesma forma que fizeram ontem, apenas precisam entregar um pouco mais de funcionalidades. Nesse sentido, nenhuma transição para novas práticas é possível. Esta é uma situação clássica onde não há tempo para afiar o machado, é preciso cortar árvores, por isso se usa um machado cego. Aqui não há conselhos simples.
(Dmitry) Vou ler um esclarecimento do chat: "Mas é necessário um grande cobertura de testes em diferentes níveis. Quanto tempo é dedicado aos testes? É meio caro, consome muito tempo."
(Oleg) Este é um equívoco clássico. Deve haver testes suficientes para que você mesmo tenha confiança. Continuous Integration não é algo onde primeiro 100% dos testes são realizados e, só então, você começa a aplicar essa prática. Continuous Integration reduz sua carga cognitiva, pois cada uma das mudanças que você vê é tão óbvia que você entende se vai quebrar algo ou não, mesmo sem testes. Você pode testar isso mentalmente rapidamente, porque são pequenas mudanças. Mesmo que você tenha apenas testadores manuais, é mais fácil para eles. Você lançou e disse: 'Veja, não quebrou nada?'. Eles verificaram e disseram: 'Não, não quebrou'. Porque o testador sabe onde olhar. Você tem um commit relacionado a um fragmento de código. E isso é explorado por um comportamento específico.
Aqui você, claro, embelezou.
(Dmitry) Aqui eu não concordo. Existe a prática – desenvolvimento através de testes, que justamente vai salvar disso.
(Oleg) Bem, eu ainda não cheguei a isso. A primeira ilusão é que você precisa escrever exatamente 100% dos testes ou não deve se envolver em Continuous Integration. Isso não é verdade. São duas práticas paralelas. E elas não dependem diretamente uma da outra. Sua cobertura de testes deve ser ideal. Ideal significa que você mesmo tem confiança de que a qualidade do master, na qual ficou após o commit, permite que você pressione o botão 'Deploy' com segurança na sexta-feira à noite, mesmo bêbado. Como você alcança isso? Através de revisões, cobertura e um bom monitoramento.
Um bom monitoramento é indistinguível de testes. Se você roda os testes uma vez no pre-prod, então eles verificam todos os seus cenários de usuário uma vez e só. Mas se você os executa em um ciclo infinito, então isso é o seu sistema de monitoramento que continuamente testa – caiu ou não caiu. Nesse caso, a diferença é apenas entre uma execução ou múltiplas. Um conjunto muito bom de testes …, que são executados infinitamente, é monitoramento. E o monitoramento adequado deve ser assim.
E, portanto, como exatamente você alcançará esse estado, quando você implantar na sexta-feira à noite e ir para casa, é outra questão. Pode ser que você seja apenas um verdadeiro destemido.
Vamos voltar um pouco ao Continuous Integration. Nós nos desviamos para uma prática um pouco mais complicada.
E a segunda ilusão é que o MVP, dizem, deve ser feito rapidamente, então os testes não são necessários. Não é bem assim. O fato é que quando você escreve uma user story para o MVP, você pode desenvolvê-la de forma improvisada, ou seja, ouviu que há uma user story e imediatamente começou a codificá-la, ou trabalhar com TDD. E com TDD, como a prática mostra, não leva mais tempo, ou seja, os testes são um efeito colateral. A prática de TDD não se trata de testar. Apesar de se chamar Test Driven Development, na verdade não se trata de testes. É mais uma abordagem arquitetural. É uma maneira de escrever exatamente o que é necessário e evitar escrever o que não é. Esta prática foca na próxima iteração do seu desenvolvimento de ideias em termos de criação da arquitetura da aplicação.
Portanto, não é tão fácil se livrar dessas ilusões. MVP e testes não se contradizem. Na verdade, se você fizer o MVP seguindo a prática de TDD, fará isso melhor e mais rápido do que se o fizer sem essa prática, de forma improvisada.
É uma ideia muito não óbvia e complicada. Quando você ouve que agora vai escrever mais testes e, ao mesmo tempo, vai fazer algo mais rápido, isso soa absolutamente inadequado.
(Dmitry) Aqui muitos, quando falam de MVP, é que a gente tem preguiça de escrever algo de qualidade. E essas são, de fato, coisas diferentes. Não devemos transformar o MVP em algo ruim que não funciona.
Sim, você está certo.
E então, de repente, o MVP vai para produção.
Para sempre.
E TDD soa muito estranho quando você ouve que está escrevendo testes e aparentemente está fazendo mais trabalho. Isso soa muito esquisito, mas na verdade acaba sendo mais rápido e mais bonito. Quando você escreve um teste, já está pensando muito sobre qual código e como será chamado, além de qual comportamento esperamos dele. Você não diz apenas que escreveu uma função que faz algo. Você primeiro pensa sobre quais condições ela terá, como será chamada. Você cobre isso com testes e a partir disso entende como as interfaces do seu código vão parecer. Isso impacta muito na arquitetura. Seu código se torna automaticamente mais modular, porque você primeiro tenta entender como vai testá-lo e só depois o escreve.
A minha experiência com TDD foi assim: em algum momento contratei um mentor em Ruby, quando ainda era programador Ruby. Ele disse: “Vamos fazer TDD”. Pensei: “Poxa, agora vou ter que escrever mais coisas”. E combinamos que durante duas semanas eu escreveria todo o código funcional em Python utilizando TDD. Após duas semanas percebi que não queria voltar atrás. Ao tentar aplicar isso em todos os lugares, percebi o quanto ficou mais fácil até para pensar. Mas isso não é óbvio, então recomendo a todos que, se acham que TDD é complicado, demorado e desnecessário, tentem se manter firmes nisso por apenas duas semanas. Para mim, foram suficientes.
(Dmitry) Podemos desenvolver essa ideia do ponto de vista da operação da infraestrutura. Antes de lançarmos algo novo, fazemos monitoramento e depois colocamos em prática. Nesse caso, o monitoramento se torna um teste normal. E há desenvolvimento por meio do monitoramento. Mas quase todos dizem que isso é demorado, que dá trabalho, e acabam fazendo um esboço temporário. Se fizermos um monitoramento adequado, entendemos o estado do sistema CI. E no sistema CI, há muito monitoramento. Nós compreendemos o estado do sistema e o que há dentro dele. E durante o desenvolvimento, fazemos exatamente o sistema para que ele atinja o estado desejado.
Essas práticas são conhecidas há bastante tempo. Discutimos isso há cerca de 4 anos. Mas em 4 anos, praticamente nada mudou.
Mas nesta nota, proponho encerrar a discussão oficial.
Vídeo (inserido como elemento de mídia, mas por algum motivo não funciona):
Fonte: habr.com
