

Na véspera do início do curso preparamos para você mais uma tradução útil.
Bancos de dados gráficos são uma tecnologia importante para especialistas em bancos de dados. Eu busco acompanhar inovações e novas tecnologias nesta área e, após trabalhar com bancos de dados relacionais e NoSQL, percebo que o papel dos bancos de dados gráficos está se tornando cada vez mais relevante. Em trabalhos com dados hierárquicos complexos, tanto os bancos de dados tradicionais quanto os NoSQL se mostram pouco eficientes. Muitas vezes, com o aumento do número de níveis de relações e do tamanho do banco, observa-se uma queda no desempenho. E, à medida que as interconexões se tornam mais complexas, também aumenta o número de JOINs.
Claro, na modelagem relacional existem soluções para trabalhar com hierarquias (por exemplo, usando CTEs recursivos), mas isso ainda são soluções alternativas. Nesse sentido, a funcionalidade dos bancos de dados gráficos do SQL Server permite lidar facilmente com vários níveis de hierarquia. Tanto o modelo de dados quanto as consultas se tornam mais simples, o que aumenta a eficiência. O volume de código é significativamente reduzido.
Bancos de dados gráficos são uma linguagem expressiva para representar sistemas complexos. Essa tecnologia já é bastante utilizada na indústria de TI em áreas como redes sociais, sistemas antifraude, análise de redes de TI, recomendações sociais, recomendações de produtos e de conteúdo.
A funcionalidade dos bancos de dados gráficos no SQL Server é adequada para cenários onde os dados estão fortemente interconectados e possuem relações bem definidas.
Modelo de dados gráfico
Um gráfico é um conjunto de vértices (nós, node) e arestas (relações, edge). Os vértices representam entidades, enquanto as arestas são as conexões, cujos atributos podem conter informações.
Um banco de dados gráfico modela entidades na forma de um gráfico, conforme definido na teoria dos grafos. As estruturas de dados são os vértices e as arestas. Os atributos são as propriedades dos vértices e arestas. A relação é a conexão entre os vértices.
Ao contrário de outros modelos de dados, nos bancos de dados gráficos, as interconexões entre entidades são priorizadas. Portanto, não é necessário calcular as relações usando chaves externas ou outros métodos. É possível criar modelos de dados complexos usando apenas as abstrações de vértices e arestas.
No mundo moderno, a modelagem das interconexões exige metodologias cada vez mais sofisticadas. Para modelar relacionamentos, o SQL Server 2017 oferece recursos de bancos de dados gráficos. Os nós e arestas do grafo são representados como novos tipos de tabelas: NODE e EDGE. Para consultas ao grafo, utiliza-se uma nova função T-SQL chamada MATCH(). Como essa funcionalidade está integrada ao SQL Server 2017, pode ser utilizada em suas bases de dados existentes sem a necessidade de qualquer conversão.
Benefícios do modelo gráfico
Atualmente, empresas e usuários exigem aplicativos que lidem com volumes cada vez maiores de dados, esperando alta performance e confiabilidade. A representação de dados em forma de grafo oferece ferramentas eficazes para processar relacionamentos complexos. Essa abordagem ajuda a resolver muitos problemas e contribui para alcançar resultados dentro de um determinado contexto.
Parece que, no futuro, muitos aplicativos poderão se beneficiar do uso de bancos de dados gráficos.
Modelagem de dados: da modelagem relacional ao modelo gráfico
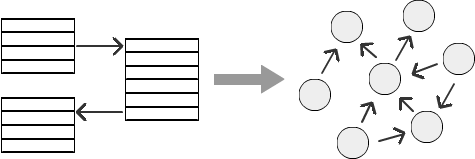
Exemplo
Vamos considerar um exemplo de estrutura organizacional com a hierarquia de funcionários: um funcionário se reporta a um gerente, o gerente se reporta a um gerente sênior e assim por diante. Dependendo da empresa específica, essa hierarquia pode ter qualquer número de níveis. Mas com o aumento do número de níveis, o cálculo das relações em um banco de dados relacional se torna cada vez mais complexo. É bastante difícil representar a hierarquia de funcionários, a hierarquia de marketing ou as conexões em redes sociais. Vamos ver como, usando o SQL Graph, podemos resolver o problema de processar diferentes níveis de hierarquia.
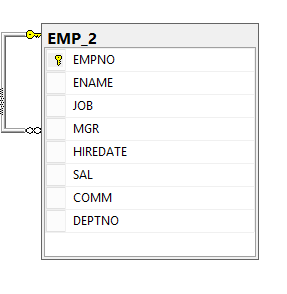
Para este exemplo, vamos criar um modelo de dados simples. Vamos criar uma tabela de funcionários. EMP com um identificador EMPNO e uma coluna MGR, que indica o identificador do supervisor (gerente) do funcionário. Todas as informações sobre a hierarquia são armazenadas nesta tabela e podem ser consultadas através das colunas. EMPNO e MGR.
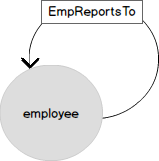
No diagrama a seguir, a mesma estrutura organizacional é representada de forma mais familiar, com quatro níveis de profundidade. Os funcionários são os nós do grafo da tabela EMP. A entidade "funcionário" está conectada a si mesma por meio da relação "reporta-se a" (ReportsTo). Em termos de grafo, a relação é uma aresta (EDGE) que conecta os nós (NODE) dos funcionários.
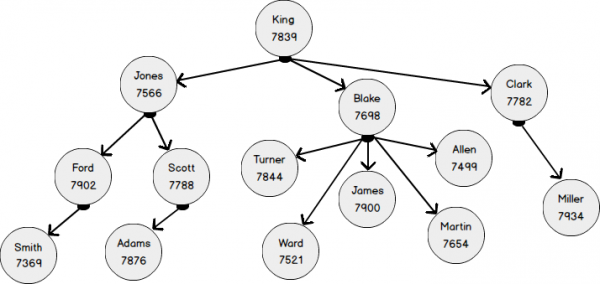
Vamos criar uma tabela simples EMP e adicionar valores de acordo com o diagrama acima.
CREATE TABLE EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

INSERT INTO EMP VALUES
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
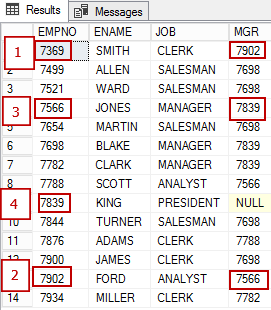
Na imagem abaixo, estão os funcionários:
- o funcionário com EMPNO 7369 reporta-se a 7902;
- o funcionário com EMPNO 7902 reporta-se a 7566
- o funcionário com EMPNO 7566 reporta-se a 7839
Agora vamos ver a representação dos mesmos dados em forma de gráfico. O vértice EMPLOYEE possui vários atributos e está ligado a si mesmo pela relação 'reporta-se a' (EmplReportsTo). EmplReportsTo é o nome da relação.
Na tabela de arestas (EDGE), também podem existir atributos.
Vamos criar a tabela de nós EmpNode
A sintaxe para criar um nó é bastante simples: ao comando CREATE TABLE adiciona-se "AS NODE".
CREATE TABLE dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) AS NODE;
Agora vamos transformar os dados da tabela simples em um gráfico. O seguinte INSERT insere os dados da tabela relacional EMP.
INSERT INTO EmpNode(EMPNO,ENAME,MGR,DNO) select empno,ename,MGR,dno from emp 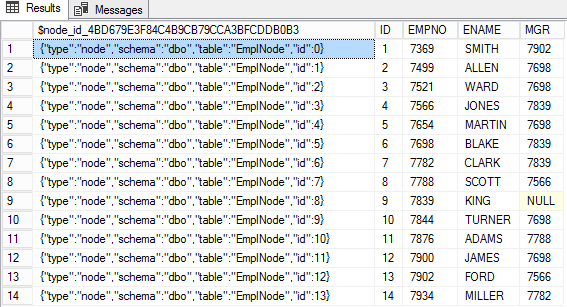
Na tabela de nós, uma coluna especial $node_id_* armazena o identificador do nó em formato JSON. As demais colunas desta tabela contêm os atributos do nó.
Criando arestas (EDGE)
A criação da tabela de arestas é muito semelhante à criação da tabela de nós, com a exceção de que usa a palavra-chave "AS EDGE".
CREATE TABLE empReportsTo(Deptno int) AS EDGE 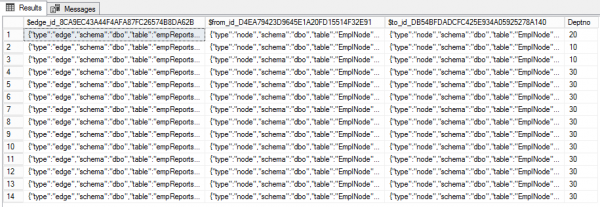
Agora vamos definir as relações entre os funcionários, utilizando as colunas EMPNO e MGR. O diagrama organizacional mostra claramente como escrever INSERT.
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 1),
   	(SELECIONE $node_id DO EmpNode ONDE id = 13),20);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 2),
   	(SELECIONE $node_id DO EmpNode ONDE id = 6),10);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 3),
   	(SELECIONE $node_id DO EmpNode ONDE id = 6),10)
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 4),
   	(SELECIONE $node_id DO EmpNode ONDE id = 9),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 5),
   	(SELECIONE $node_id DO EmpNode ONDE id = 6),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 6),
   	(SELECIONE $node_id DO EmpNode ONDE id = 9),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 7),
   	(SELECIONE $node_id DO EmpNode ONDE id = 9),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 8),
   	(SELECIONE $node_id DO EmpNode ONDE id = 4),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 9),
   	(SELECIONE $node_id DO EmpNode ONDE id = 9),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 10),
   	(SELECIONE $node_id DO EmpNode ONDE id = 6),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 11),
   	(SELECIONE $node_id DO EmpNode ONDE id = 8),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 12),
   	(SELECIONE $node_id DO EmpNode ONDE id = 6),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 13),
   	(SELECIONE $node_id DO EmpNode ONDE id = 4),30);
INSERIR NO empReportsTo VALORES ((SELECIONE $node_id DO EmpNode ONDE ID = 14),
   	(SELECIONE $node_id DO EmpNode ONDE id = 7),30);
A tabela de arestas padrão é composta por três colunas. A primeira, $edge_id — é o identificador da aresta em formato JSON. As outras duas ($from_id e $to_id) representam a conexão entre os nós. Além disso, as arestas podem ter propriedades adicionais. No nosso caso, isso é Deptno.
Visões do sistema
Na visão do sistema sys.tables duas novas colunas foram adicionadas:
- is_edge
- is_node
SELECIONE t.is_edge,t.is_node,*
DE sys.tables t
ONDE nome como 'emp%' 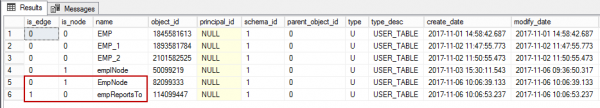
SSMS
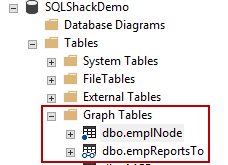
Objetos relacionados a gráficos estão localizados na pasta Tabelas de Gráficos. O ícone da tabela de nós é marcado com um ponto, enquanto as tabelas de arestas — com dois círculos conectados (semelhante a óculos).
A expressão MATCH
Expressão MATCH é extraída da CQL (Cypher Query Language). Este é um método eficiente de consulta propriedades do gráfico. A CQL começa com a expressão MATCH.
Sintaxe
MATCH (<graph_search_pattern>)

<graph_search_pattern>::=
    {<node_alias> {
                 	{ <-( <edge_alias> )- }
               	| { -( <edge_alias> )-> }
             	<node_alias>
             	}
 	}
 	[ { AND } { ( <graph_search_pattern> ) } ]
 	[ ,...n ]

<node_alias> ::=
    node_table_name | node_alias

<edge_alias> ::=
    edge_table_name | edge_alias
Exemplos
Vamos dar uma olhada em alguns exemplos.
A consulta abaixo exibe os funcionários que reportam a Smith e seu gerente.
SELECIONE
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
DE
    empnode e, empnode e1, empReportsTo m
ONDE
    MATCH(e-(m)->e1)
e e.ENAME='SMITH' 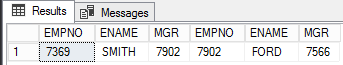
A seguinte consulta destina-se à busca de colaboradores e gerentes de segundo nível para Smith. Se remover a frase WHERE, o resultado exibirá todos os colaboradores.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 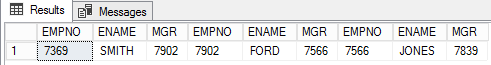
E, por fim, a consulta para colaboradores e gerentes de terceiro nível.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Agora vamos mudar a direção para obter os supervisores de Smith.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 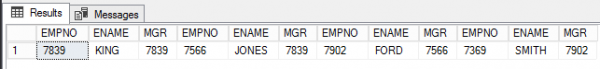
Conclusão
O SQL Server 2017 estabeleceu-se como uma solução corporativa robusta para diversas tarefas de TI nos negócios. A primeira versão do SQL Graph é muito promissora. Mesmo com algumas limitações, já existe funcionalidade suficiente para explorar as capacidades dos gráficos.
A funcionalidade do SQL Graph está completamente integrada no SQL Engine. No entanto, como mencionado, o SQL Server 2017 possui as seguintes limitações:
Não há suporte para polimorfismo.
- Apenas relacionamentos unidirecionais são suportados.
- As colunas $from_id e $to_id não podem ser atualizadas via UPDATE.
- Não há suporte para fechamento transitivo (transitive closure), mas isso pode ser obtido usando CTE.
- O suporte para objetos In-Memory OLTP é limitado.
- Não há suporte para tabelas temporais (System-Versioned Temporal Table), tabelas temporárias locais e globais.
- Os tipos de tabela e variáveis de tabela não podem ser declarados como NODE ou EDGE.
- Consultas entre bancos de dados (cross-database queries) não são suportadas.
- Não há uma forma direta ou assistente (wizard) para converter tabelas convencionais em gráficas.
- Não há GUI para visualização de gráficos, mas é possível usar o Power BI.
Leia mais:
Fonte: habr.com
