

VictoriaMetrics — um banco de dados rápido e escalável para armazenamento e processamento de dados em formato de séries temporais (os registros formam o tempo e um conjunto de valores correspondentes a esse tempo, como os obtidos por meio de sondagens periódicas do estado de sensores ou coleta de métricas).
Meu nome é Kolobaev Pavel. DevOps, SRE, LeroyMerlin, tudo como código – isso é sobre nós: sobre mim e sobre outros colaboradores da LeroyMerlin.
Existe uma nuvem baseada em OpenStack. Há um pequeno link para o radar técnico.
Construído com hardware Kubernetes, além de todos os serviços complementares ao OpenStack e de logging.
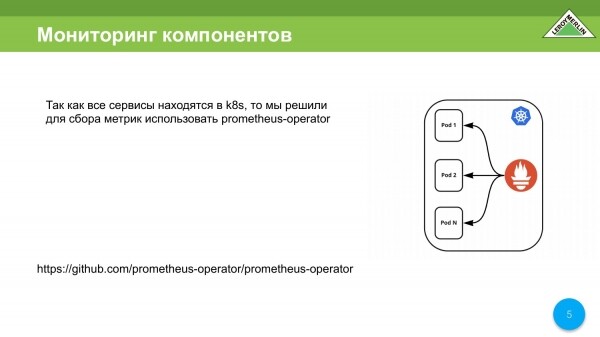
O esquema era este que tínhamos em desenvolvimento. Quando estávamos desenvolvendo tudo isso, tínhamos um operador Prometheus que armazenava dados dentro do próprio cluster K8s. Ele encontra automaticamente o que precisa ser raspado e reúne, grosso modo, no seu caminho.
Todos os dados precisarão ser extraídos do cluster Kubernetes, porque se algo acontecer, precisamos entender o que e onde.
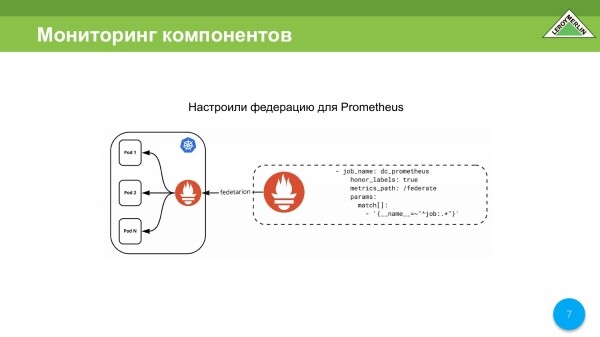
A primeira solução – usamos federation, quando há um Prometheus externo, quando acessamos o cluster Kubernetes através do mecanismo federation.
Mas surgem pequenos problemas. No nosso caso, os problemas começaram quando tínhamos 250.000 métricas, e quando chegamos a 400.000 métricas, percebemos que não podíamos trabalhar assim. Aumentamos o scrape_timeout para 25 segundos.
Por que tivemos que fazer isso? O Prometheus começa a contar o tempo de timeout a partir do início da coleta. E não importa que os dados ainda estejam fluindo. Se durante esse período especificado os dados não forem coletados e a sessão não for encerrada por http, a sessão é considerada fracassada e os dados não chegam ao próprio Prometheus.
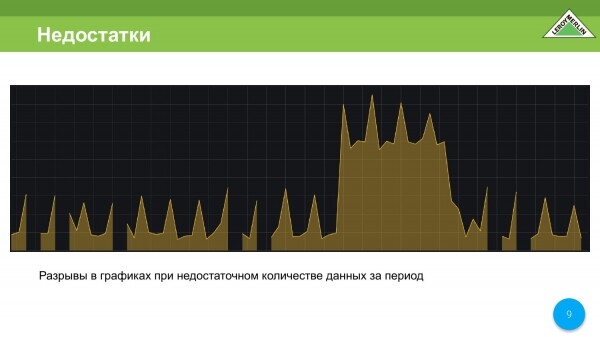
Todos conhecem os gráficos que recebemos quando parte dos dados está ausente. Os gráficos ficam fragmentados, e isso não nos satisfaz.
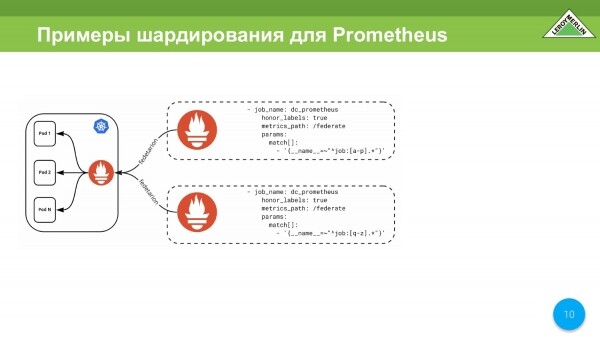
A próxima opção é o sharding baseado em dois Prometheus diferentes através do mesmo mecanismo federation.
Por exemplo, simplesmente pegar e shardear por nome. Isso também pode ser utilizado, mas decidimos seguir em frente.
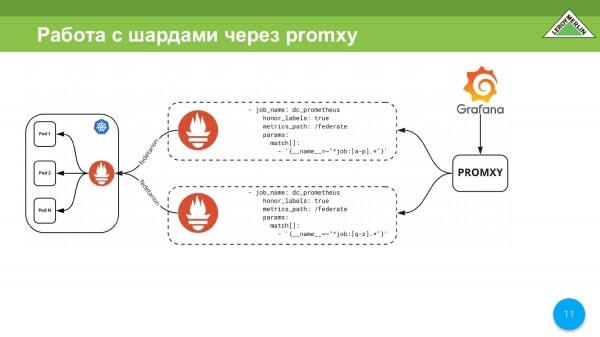
Agora teremos que processar esses shards de alguma forma. Podemos usar o promxy, que acessa a área do shard e multiplica os dados. Ele trabalha com dois shards como se fosse um único ponto de entrada. Isso pode ser realizado através do promxy, mas é complicado por enquanto.
A primeira opção – queremos desistir do mecanismo federation, porque é muito lento.
Os desenvolvedores do Prometheus claramente dizem: "Pessoal, usem outros TimescaleDB, porque não vamos suportar o armazenamento de métricas a longo prazo". Essa não é a tarefa deles. 
Anotamos que precisamos de uma exportação externa, para não armazenar tudo em um só lugar.
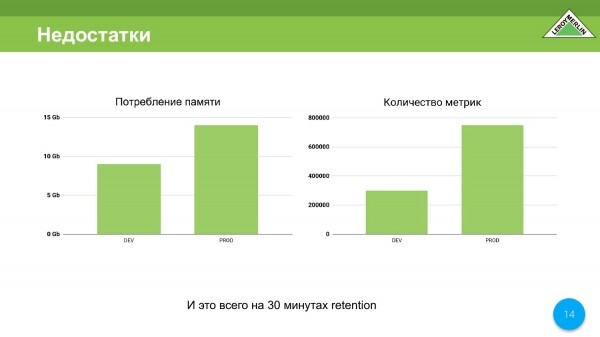
O segundo problema é o consumo de memória. Sim, eu entendo que muitos dirão que em 2020 alguns gigabytes de memória custam pouco, mas ainda assim.
Atualmente temos ambientes dev e prod. No dev, temos cerca de 9 gigabytes para 350.000 métricas. No prod, são 14 gigabytes e um pouco mais para 780.000 métricas. E o nosso tempo de retenção é de apenas 30 minutos. Isso é ruim, e agora explicarei por quê.
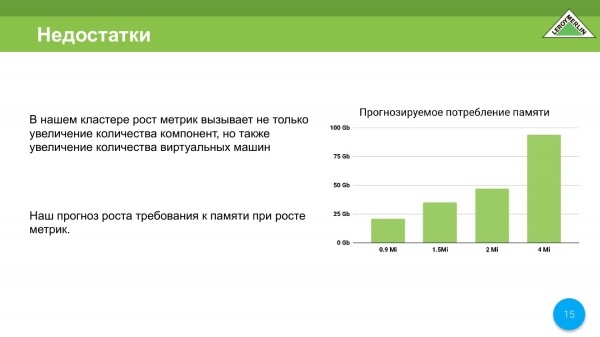
Fazemos um cálculo, ou seja, com um milhão e meio de métricas, e já estamos próximos disso, na fase de planejamento obtemos 35-37 gigabytes de memória. Mas com quatro milhões de métricas já são cerca de 90 gigabytes de memória. Isso foi calculado com a fórmula fornecida pelos desenvolvedores do Prometheus. Observamos a correlação e entendemos que não queremos pagar alguns milhões por um servidor apenas para monitoramento.
Não apenas o número de máquinas vai aumentar, mas também estamos monitorando as próprias máquinas virtuais. Portanto, quanto mais máquinas virtuais, mais métricas de vários tipos, etc. Teremos um crescimento especial do nosso cluster em termos de métricas.
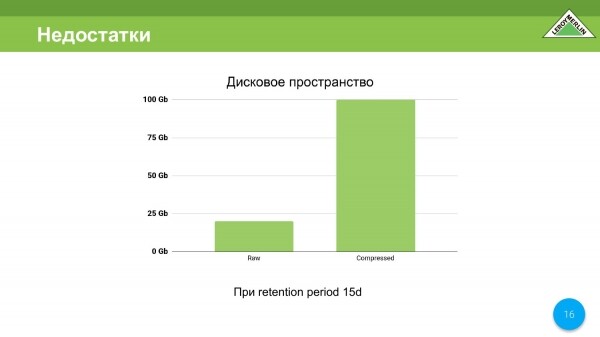
Com o espaço em disco, a situação não é tão ruim, mas gostaríamos de melhorar. Em 15 dias, obtivemos um total de 120 gigabytes, dos quais 100 são dados comprimidos e 20 são dados não comprimidos, mas sempre queremos menos.
Portanto, estamos anotando mais um ponto - o alto consumo de recursos, que queremos economizar, pois não queremos que nosso cluster de monitoramento consuma mais recursos do que nosso cluster que cuida da gestão do OpenStack.
Há mais uma desvantagem no Prometheus que identificamos: uma limitação de memória, mesmo que mínima. Com o Prometheus, isso é muito pior, pois ele não tem tais controles. Usar limites no Docker também não é uma opção. Se o seu RAF falhar e houver 20-30 gigabytes, ele levará muito tempo para reiniciar.
Esta é mais uma razão pela qual o Prometheus não nos serve; ou seja, não é possível limitar o consumo de memória.
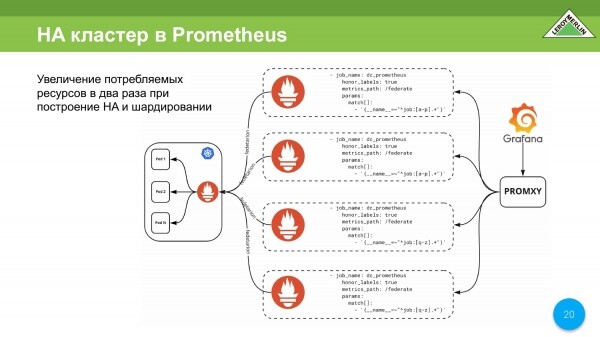
Poderíamos seguir esse esquema. Esse esquema é necessário para organizarmos um cluster de alta disponibilidade (HA). Queremos que nossas métricas estejam sempre e em qualquer lugar acessíveis, mesmo em caso de falha do servidor que armazena essas métricas. Assim, teremos que construir um esquema como este.
Este esquema indica que teremos duplicação de shards, assim como a duplicação dos recursos consumidos. É quase escalável horizontalmente, mas, mesmo assim, o consumo de recursos será intenso.
As desvantagens, na ordem em que as anotamos:
- É necessário exportar métricas para fora.
- Alto consumo de recursos.
- Não é possível limitar o consumo de memória.
- Implementação de HA complexa e exigente em recursos.
Decidimos que vamos nos afastar do Prometheus como armazenador.
Definimos também requisitos adicionais que precisamos. São eles:
- Suporte a promql, pois já foi escrito muito sob o Prometheus: consultas, alertas.
- E temos o Grafana, que também foi desenvolvido para o Prometheus como backend. Não queremos reescrever os dashboards.
- Queremos construir uma arquitetura de HA adequada.
- Queremos reduzir o consumo de quaisquer recursos.
- Há mais um pequeno detalhe. Não podemos usar diferentes sistemas de coleta de métricas na nuvem. Não sabemos o que será enviado para essas métricas. E como pode enviar qualquer coisa, somos forçados a nos limitar ao armazenamento local.
A escolha foi pequena. Reunimos tudo o que tínhamos experiência. Olhamos a página do Prometheus na seção de integrações, lemos muitos artigos, verificamos o que existe. E escolhemos o VictoriaMetrics como substituto do Prometheus.
Por que? Porque:
- Suporta promql.
- Possui uma arquitetura modular.
- Não requer alterações no Grafana.
- E o mais importante – podemos oferecer armazenamento de métricas dentro da nossa empresa como um serviço, por isso estamos antecipadamente considerando limitações diversas, para que os usuários possam usar todos os recursos do cluster de forma restrita, pois existe a chance de ser multitenancy.
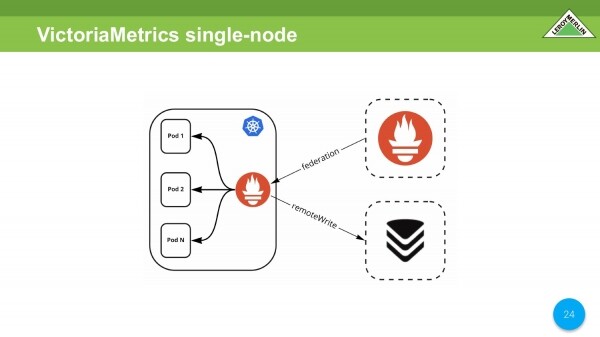
Fazemos a primeira comparação. Pegamos o mesmo Prometheus dentro do cluster, ao qual um Prometheus externo se conecta. Adicionamos o VictoriaMetrics via remoteWrite.
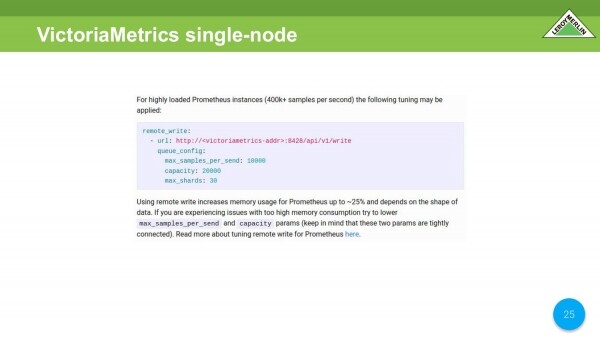
De imediato, devo mencionar que aqui notamos um pequeno aumento no consumo de CPU por parte do VictoriaMetrics. Na wiki do VictoriaMetrics, está escrito quais parâmetros são mais adequados. Nós os verificamos. Eles reduziram muito bem o consumo de CPU.
No nosso caso, o consumo de memória do Prometheus, que está no cluster Kubernetes, aumentou de forma insignificante.
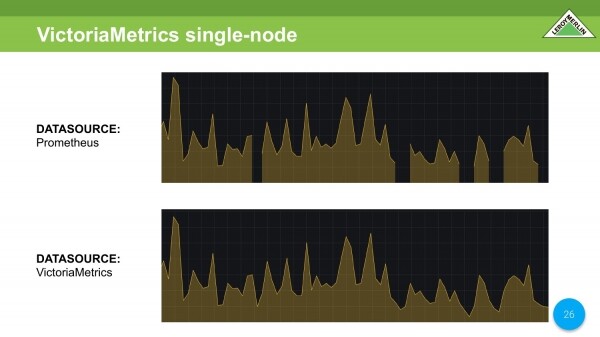
Comparando duas fontes de dados com os mesmos dados. No Prometheus, vemos todos os mesmos dados ausentes. No VictoriaMetrics, tudo está bem.
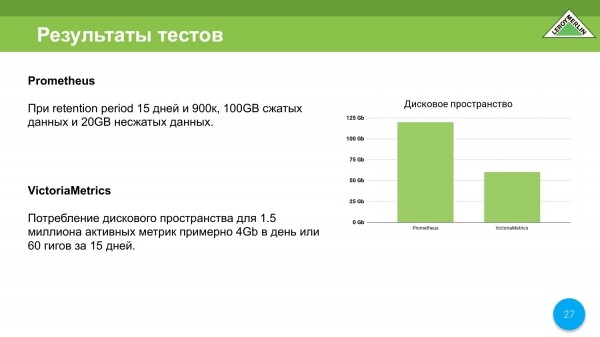
Resultados dos testes com espaço em disco. Obtivemos 120 gigabytes no total com o Prometheus. No VictoriaMetrics, já recebemos 4 gigabytes por dia. O mecanismo lá é um pouco diferente do que estamos acostumados a ver no Prometheus. Ou seja, os dados são bastante compactados em um dia, em meia hora. Eles já estão bem compactados em um dia, em meia hora, apesar de que ainda serão mesclados depois. No final, economizamos em espaço em disco.
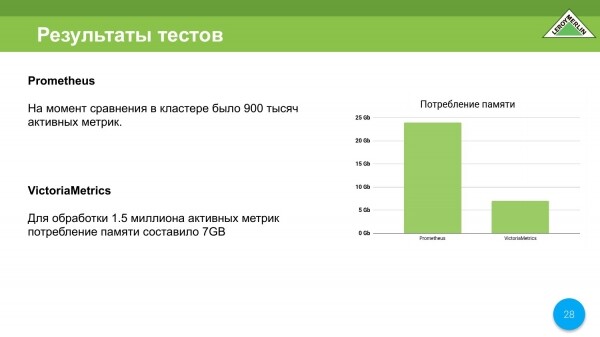
Além disso, economizamos no consumo de recursos de memória. O nosso Prometheus estava em uma máquina virtual durante os testes - 8 núcleos, 24 gigabytes. O Prometheus consome praticamente tudo. Ele caiu devido ao OOM Killer. Neste caso, ele lidava com apenas 900 000 métricas ativas. Isso é cerca de 25 000-27 000 métricas por segundo.
O VictoriaMetrics estava sendo executado em uma máquina virtual de dois núcleos com 8 gigabytes de RAM. Conseguimos fazer o VictoriaMetrics funcionar bem, ajustando algumas coisas na máquina de 8 gigabytes. No final, ficamos com 7 gigabytes. E conseguimos uma taxa de resposta de conteúdo, ou seja, de métricas, até superior à do Prometheus.
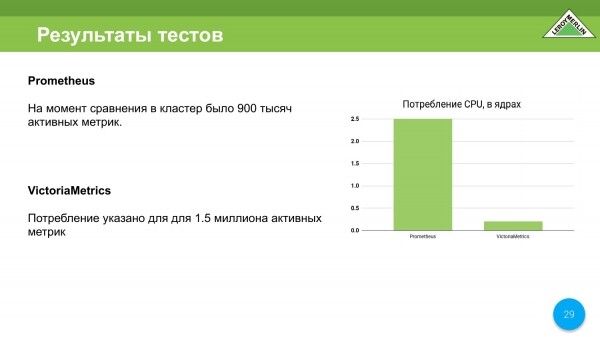
A situação com o CPU melhorou muito em relação ao Prometheus. Aqui o Prometheus consome 2,5 núcleos, enquanto o VictoriaMetrics consome apenas 0,25 núcleo. No início, eram 0,5 núcleo. À medida que a mesclagem avança, chega a um núcleo, mas isso é extremamente raro.
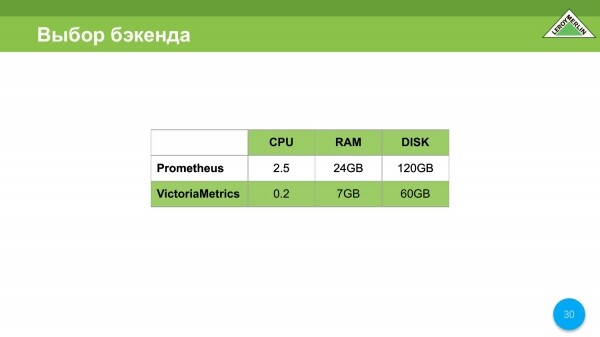
No nosso caso, a escolha recaiu sobre o VictoriaMetrics por razões claras, queríamos economizar e conseguimos.
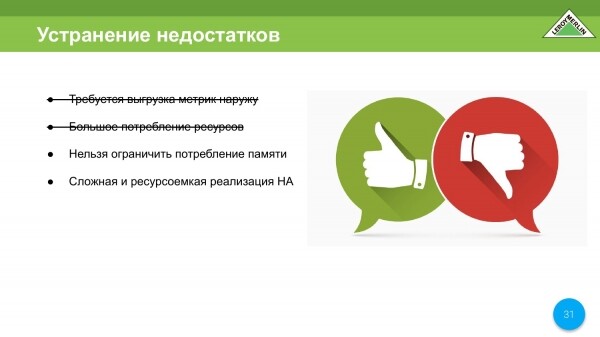
Eliminamos de imediato dois pontos - a exportação de métricas e o alto consumo de recursos. E nos resta resolver dois pontos que ainda deixamos.
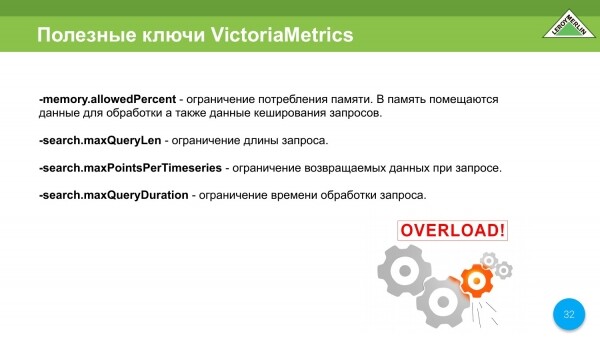
Aqui devo esclarecer que consideramos o VictoriaMetrics como um armazenamento de métricas. Mas como provavelmente iremos fornecer o VictoriaMetrics como armazenamento para todo o Leroy, precisamos limitar aqueles que usarão este cluster, para que não o sobrecarreguem.
Há uma configuração incrível que permite limitar por tempo, por volume de dados e pelo tempo de execução.
Além disso, existe uma ótima opção que permite limitar o consumo de memória, assim podemos encontrar aquele equilíbrio que nos permitirá obter uma velocidade de operação adequada e um consumo de recursos razoável.
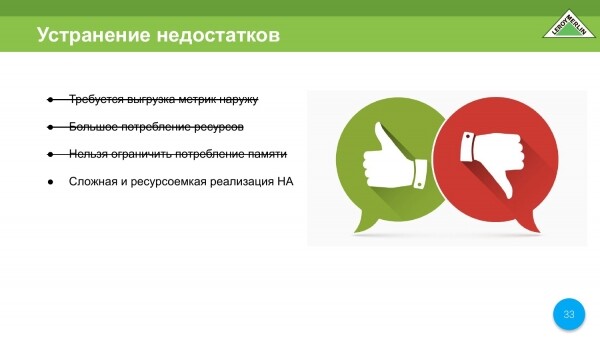
Menos um ponto, ou seja, riscamos o ponto – não é possível limitar o consumo de memória.
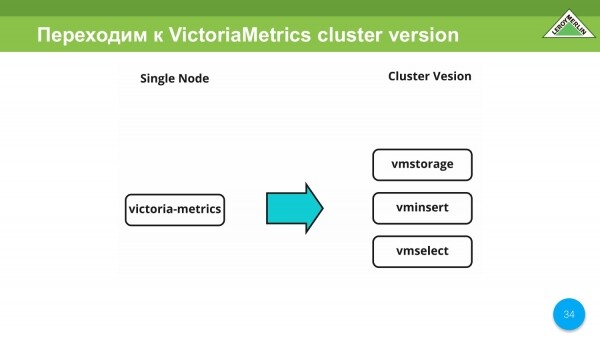
Nas primeiras iterações, testamos o VictoriaMetrics Single Node. Em seguida, passamos para a versão Cluster do VictoriaMetrics.
Aqui temos liberdade para distribuir diferentes serviços no VictoriaMetrics, dependendo do que irão rodar e quais recursos irão consumir. É uma solução muito flexível e conveniente. Nós a utilizamos.
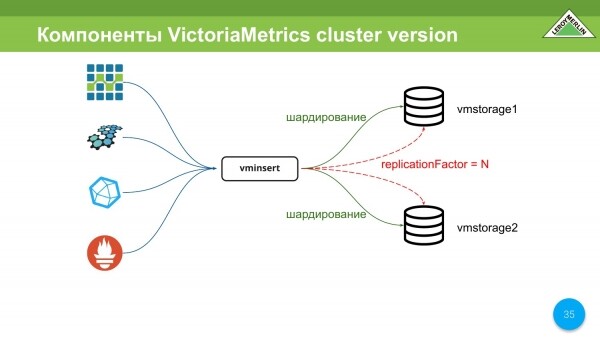
Os componentes principais da versão Cluster do VictoriaMetrics são o vmstorage. Pode haver uma quantidade N de instâncias. No nosso caso, por enquanto, são 2.
E há o vminsert. Este é um servidor proxy que nos permite: realizar o sharding entre todos os storages que informamos a ele, e também permite replicação, ou seja, você terá tanto sharding quanto replicação.
O vminsert suporta os protocolos OpenTSDB, Graphite, InfluxDB e remoteWrite do Prometheus.
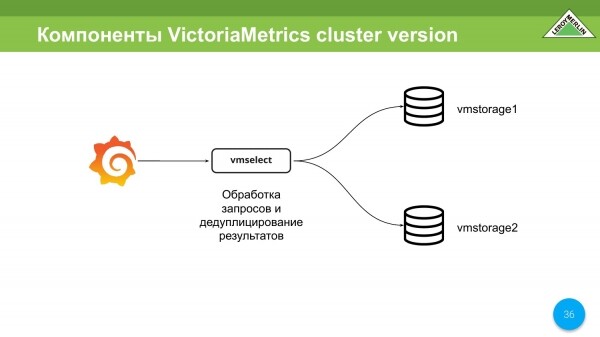
Ainda existe o vmselect. Sua principal função é acessar o vmstorage, obter dados deles, desduplicar esses dados e entregá-los ao cliente.
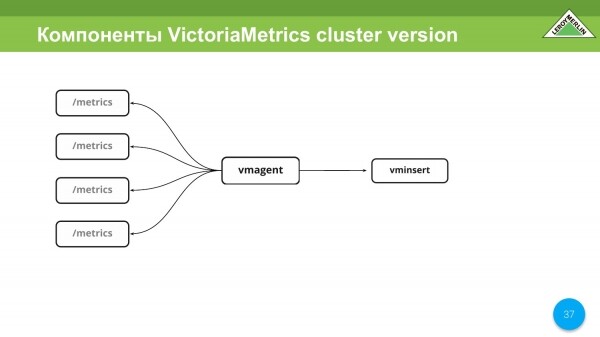
Há uma ferramenta maravilhosa chamada vmagent. Nós adoramos. Ela permite configurar exatamente como o Prometheus e ainda por cima funciona da mesma forma que o Prometheus. Ou seja, ela coleta métricas de diferentes entidades e serviços e as envia ao vminsert. A partir daí, tudo depende de você.
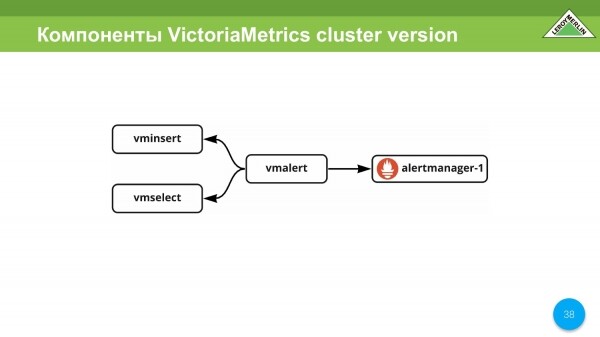
Outro serviço notável é o vmalert, que permite usar o VictoriaMetrics como backend, receber dados do vminsert e enviar dados processados ao vmselect. Ele processa os alertas e também as regras. No caso de alertas, recebemos um alerta através do alertmanager.
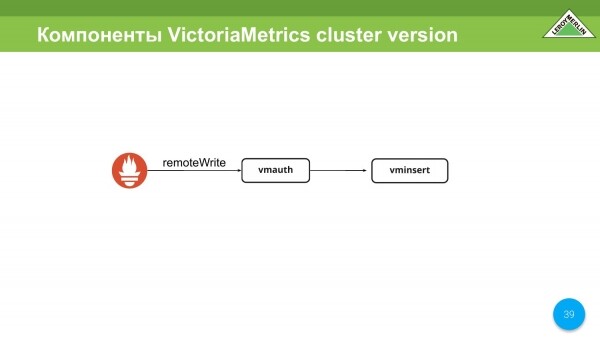
Há um componente wmauth. Ele pode ser utilizado, ou talvez não (ainda não decidimos sobre isso), como um sistema de autenticação na versão multitenancy dos clusters. Ele suporta remoteWrite para o Prometheus e pode autenticar com base na URL, mais precisamente na sua segunda parte, onde você pode ou não enviar dados.
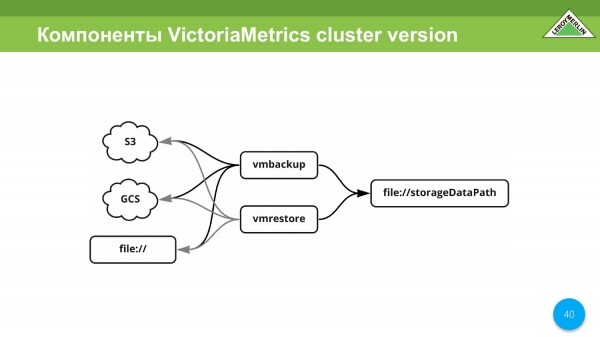
Ainda há vmbackup e vmrestore. Estes, na verdade, tratam da recuperação e do backup de todos os dados. Suporta S3, GCS, file.
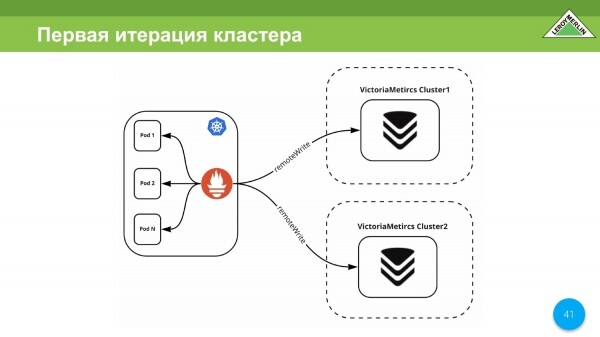
A primeira iteração do nosso cluster foi feita durante a quarentena. Naquele momento, não havia réplica, portanto, nossa iteração consistia em dois clusters distintos e independentes, dos quais recebíamos dados através do remoteWrite.
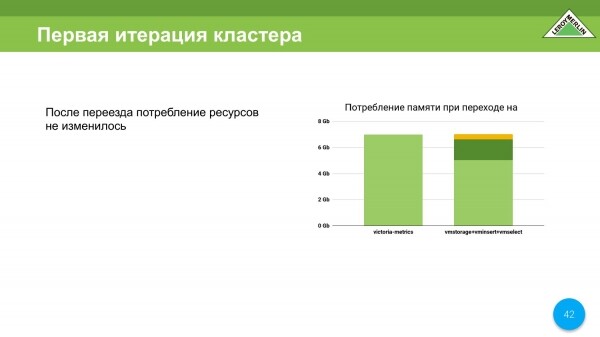
Aqui, ressalto que, quando fizemos a transição de VictoriaMetrics Single Node para a versão do cluster VictoriaMetrics, também mantivemos o mesmo consumo de recursos, ou seja, a principal é a memória. Aproximadamente assim se distribuíram nossos dados, ou seja, o consumo de recursos.
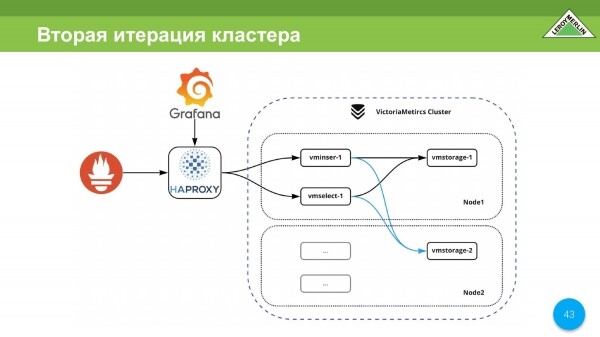
Já havia uma réplica adicionada. Nós unificamos tudo em um cluster relativamente grande. Todos os nossos dados são tanto fragmentados quanto replicados.
Todo o cluster tem N pontos de entrada, ou seja, o Prometheus pode adicionar dados através do HAPROXY. Aqui está esse ponto de entrada. E através desse ponto de entrada é possível acessar com o Grafana.
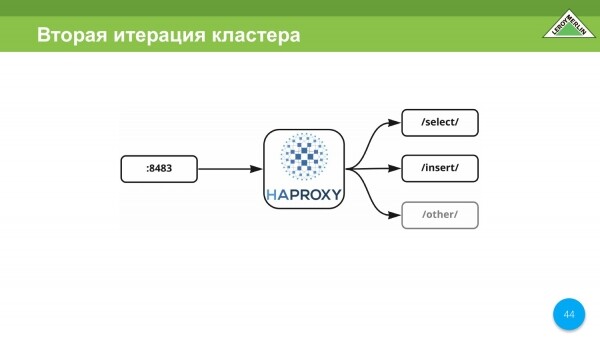
No nosso caso, o HAPROXY é a única porta que proxy select, insert e outros serviços para dentro deste cluster. Não foi possível criar um único endereço, tivemos que estabelecer vários pontos de entrada, pois as próprias máquinas virtuais onde o cluster VictoriaMetrics funciona estão em diferentes zonas de um mesmo provedor de nuvem, ou seja, não dentro da nossa nuvem, mas fora.
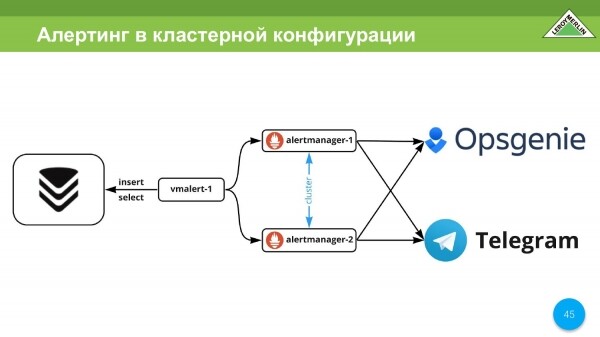
Temos alertas. Nós os utilizamos. Usamos o alertmanager do Prometheus. Como canal de entrega de alertas, utilizamos o Opsgenie e o Telegram. No Telegram, recebemos alertas do dev, possivelmente algo do prod, mas mais algo estatístico, necessário para os engenheiros. E o Opsgenie – crítico. Isso inclui chamadas, gerenciamento de incidentes.
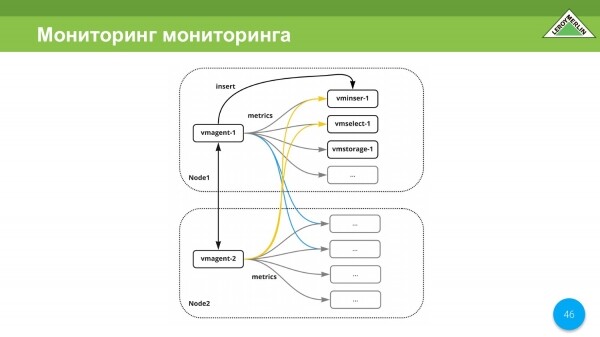
A eterna pergunta: "Quem monitora o monitoramento?". No nosso caso, o monitoramento monitoriza o próprio monitoramento, porque usamos vmagent em cada nó. E como nossos nós estão distribuídos em diferentes data centers de um mesmo provedor, temos um canal distinto para cada data center, eles são independentes e mesmo que ocorra um split brain, ainda assim receberemos alertas. Sim, haverá mais alertas, mas é melhor receber mais alertas do que nenhum.
Encerramos nossa lista com a implementação de HA.
E gostaria de ressaltar a experiência de interação com a comunidade VictoriaMetrics. Foi muito positiva. Os caras são atenciosos. Eles tentam entender cada caso apresentado.
Eu registrei problemas no GitHub. Eles foram resolvidos muito rapidamente. Há ainda alguns problemas que não estão totalmente fechados, mas já consigo ver pelo código que o trabalho nessa direção está em andamento.
A principal dor durante as iterações para mim era que, se eu desligasse um nó, nos primeiros 30 segundos, o vminsert não conseguia perceber que o backend estava offline. Isso já foi resolvido. Agora, em um ou dois segundos, os dados são coletados de todos os nós restantes, e a solicitação para de esperar aquele nó ausente.
Queríamos em algum momento que fosse um operador do VictoriaMetrics. Finalmente conseguimos. Estamos atualmente construindo ativamente uma camada sobre o operador do VictoriaMetrics para incorporar todas as regras de pré-cálculo, etc. do Prometheus, já que usamos ativamente as regras que vêm junto com o operador do Prometheus.
Há sugestões para melhorar a implementação do cluster. Eu as expus acima.
E também estamos muito interessados no downsampling. No nosso caso, o downsampling é necessário exclusivamente para visualizar tendências. Grosso modo, uma única métrica ao longo do dia é suficiente. Essas tendências são necessárias para um, três, cinco ou dez anos. E um único valor de métrica é completamente suficiente.
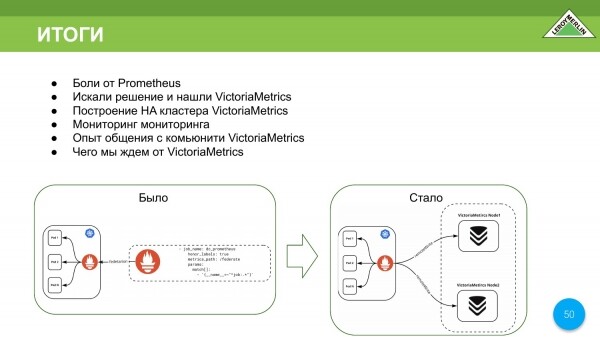
- Nós conhecemos a dor, assim como alguns de nossos colegas, ao usar o Prometheus.
- Escolhemos o VictoriaMetrics para nós.
- Ele escala muito bem, tanto vertical quanto horizontalmente.
- Podemos distribuir diferentes componentes em um número diferente de nós no cluster, limitá-los em termos de memória, adicionar mais memória, etc.
Vamos usar o VictoriaMetrics, porque gostamos muito dele. Aqui está o que era e o que se tornou.
Alguns qr codes para o chat do VictoriaMetrics, meus contatos, radar técnico do LeroyMerlin.
Fonte: habr.com
