

A configuração do armazenamento de dados para aplicações executadas em um cluster Kubernetes pode ser feita de várias maneiras. Algumas delas estão obsoletas, enquanto outras surgiram recentemente. Neste artigo, discutiremos três opções de conexão de armazenamento, incluindo a mais recente — a conexão via Container Storage Interface.
Método 1. Especificando PV no manifesto do pod
Um manifesto típico descrevendo um pod em um cluster Kubernetes:
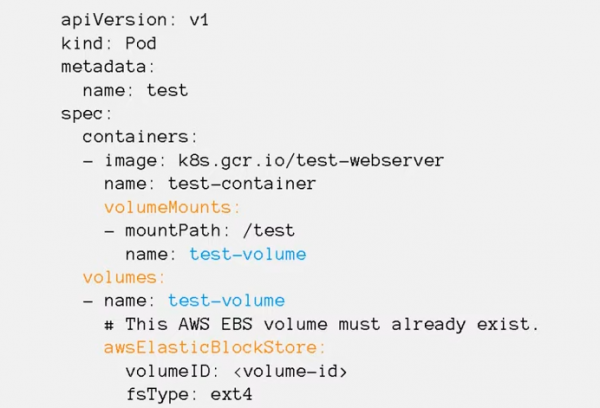
As partes do manifesto onde está descrito qual volume está sendo conectado e onde estão destacadas em cores.
Na seção volumeMounts indicam os pontos de montagem (mountPath) — qual diretório dentro do contêiner receberá o volume persistente, bem como o nome do volume.
Na seção x enumeram todos os volumes utilizados no pod. Especificam o nome de cada volume, bem como o tipo (neste caso: awsElasticBlockStore) e os parâmetros de conexão. Os parâmetros específicos listados no manifesto dependem do tipo de volume.
O mesmo volume pode ser montado simultaneamente em vários contêineres do pod. Assim, diferentes processos do aplicativo podem acessar os mesmos dados.
Esse método de conexão foi desenvolvido no início, quando o Kubernetes estava apenas começando, e hoje ele está obsoleto.
Com seu uso, surgem vários problemas:
- todos os volumes precisam ser criados manualmente, o Kubernetes não poderá criar nada por conta própria;
- os parâmetros de acesso a cada um dos volumes são únicos e precisam ser especificados nos manifestos de todos os pods que utilizam o volume;
- para mudar o sistema de armazenamento (por exemplo, migrar da AWS para o Google Cloud), é necessário alterar as configurações e o tipo dos volumes conectados em todos os manifestos.
Tudo isso é muito inconveniente, por isso, na prática, esse método é usado apenas para conectar alguns tipos especiais de volumes: configMap, secret, emptyDir, hostPath:
configMap e secret — volumes de serviço que permitem criar um volume no contêiner com arquivos dos manifestos do Kubernetes.
emptyDir — um volume temporário, criado apenas durante a vida útil do pod. É útil para testes ou armazenamento de dados temporários. Quando o pod é excluído, o volume do tipo emptyDir também é removido e todos os dados são perdidos.
hostPath — permite montar qualquer diretório do disco local do servidor dentro do contêiner do aplicativo em que o aplicativo está sendo executado, incluindo /etc/kubernetes. Essa é uma opção insegura, e por isso, geralmente, políticas de segurança proíbem o uso de volumes desse tipo. Caso contrário, um aplicativo invasor pode montar dentro de seu contêiner o diretório HTC Kubernetes e roubar todos os certificados do cluster. Normalmente, volumes hostPath são permitidos apenas para aplicativos de sistema que são executados no namespace kube-system.
estão descritos na documentação.
Método 2. Conexão a pods SC/PVC/PV
Uma alternativa para a conexão é o conceito de Storage class, PersistentVolumeClaim, PersistentVolume.
Storage class armazenam os parâmetros de conexão ao sistema de armazenamento de dados.
PersistentVolumeClaim descreve os requisitos para o volume que o aplicativo precisa.
PersistentVolume armazenam os parâmetros de acesso e o status do volume.
A essência da ideia: no manifesto do pod, deve-se especificar um volume do tipo PersistentVolumeClaim e indicar o nome dessa entidade no parâmetro claimName.
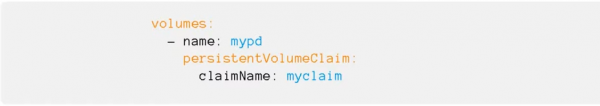
No manifesto do PersistentVolumeClaim, descrevem-se os requisitos para os dados necessários ao aplicativo, incluindo:
- tamanho do disco;
- modo de acesso: ReadWriteOnce ou ReadWriteMany;
- referência ao Storage class — em qual sistema de armazenamento de dados queremos criar o volume.
No manifesto do Storage class, são armazenados o tipo e os parâmetros de conexão ao sistema de armazenamento de dados. Eles são necessários para o kubelet montar o volume em seu nó.
Nos manifestos do PersistentVolume, são especificados o Storage class e os parâmetros de acesso a um volume específico (ID do volume, caminho etc.).
Ao criar um PVC, o Kubernetes verifica qual tamanho de volume e de qual Storage class será necessário e seleciona um PersistentVolume disponível.
Se não houver PVs disponíveis, o Kubernetes pode iniciar um programa especial — Provisioner (seu nome é especificado no Storage class). Este programa se conecta ao armazenamento e cria um volume do tamanho necessário, obtém o identificador e cria no cluster Kubernetes um manifesto PersistentVolume que se vincula ao PersistentVolumeClaim.
Essa variedade de abstrações permite remover informações sobre qual armazenamento a aplicação está usando do nível do manifesto da aplicação para o nível de administração.
Todos os parâmetros de conexão com o sistema de armazenamento de dados estão na classe Storage, da qual os administradores do cluster são responsáveis. Tudo o que é necessário ao migrar da AWS para o Google Cloud é alterar o nome da classe Storage no PVC nos manifests da aplicação. Os Volumes Persistentes para armazenamento de dados serão criados automaticamente no cluster, usando o programa Provisioner.
Método 3. Interface de Armazenamento de Container
Todo o código que interage com diferentes sistemas de armazenamento de dados é parte do núcleo do Kubernetes. O lançamento de correções de bugs ou novas funcionalidades está vinculado a novos lançamentos, sendo necessário alterar o código para todas as versões suportadas do Kubernetes. Tudo isso é difícil de manter e de adicionar novas funcionalidades.
Para resolver o problema, desenvolvedores do Cloud Foundry, Kubernetes, Mesos e Docker criaram a Interface de Armazenamento de Container (CSI) — uma interface unificada simples que descreve a interação entre o sistema de gerenciamento de containers e o driver específico (CSI Driver) que trabalha com um determinado SAN. Todo código de interação com o SAN foi removido do núcleo do Kubernetes para um sistema separado.
.
Normalmente, o CSI Driver consiste em dois componentes: Node Plugin e Controller Plugin.
O Node Plugin é executado em cada nó e é responsável por montar volumes e realizar operações sobre eles. O Controller Plugin interage com o SAN: cria ou exclui volumes, atribui permissões de acesso, etc.
Atualmente, antigos drivers ainda permanecem no núcleo do Kubernetes, mas já não são recomendados para uso e todos são aconselhados a instalar o CSI Driver especificamente para o sistema com o qual irão trabalhar.
Essa novidade pode assustar aqueles que já estão acostumados a configurar o armazenamento de dados através da classe Storage, mas na verdade, não aconteceu nada de alarmante. Para os desenvolvedores, nada muda — eles continuarão a trabalhar apenas com o nome da classe Storage. Para os administradores, houve a adição da instalação do helm chart e a estrutura das configurações mudou. Se antes as configurações eram inseridas diretamente na classe Storage, agora elas precisam ser definidas primeiro no helm chart e depois na classe Storage. Se analisarmos, nada de alarmante aconteceu.
Vamos considerar, por exemplo, quais vantagens podem ser obtidas ao migrar para a conexão do SAN Ceph usando o driver CSI.
Ao trabalhar com Ceph, o plugin CSI oferece mais opções para trabalhar com o SAN do que os drivers embutidos.
- Criação dinâmica de discos. Normalmente, os discos RBD são utilizados apenas no modo RWO, enquanto o CSI para Ceph permite que sejam usados no modo RWX. Vários pods em diferentes nós podem montar o mesmo disco RBD em seus nós e operá-los simultaneamente. Para ser justo, nem tudo é tão maravilhoso - este disco só pode ser conectado como um dispositivo de bloco, ou seja, será necessário adaptar o aplicativo para trabalhá-lo em modo de acesso múltiplo.
- Criação de snapshots. No cluster Kubernetes, é possível criar um manifesto com a solicitação de criar um snapshot. O plugin CSI o verá e fará o snapshot do disco. Com isso, será possível fazer um backup ou uma cópia do PersistentVolume.
- Aumento do tamanho do disco em armazenamento e PersistentVolume no cluster Kubernetes.
- Quotas. Os drivers CephFS embutidos no Kubernetes não suportam quotas, mas os novos plugins CSI com o novo Ceph Nautilus conseguem habilitar quotas nos volumes CephFS.
- Métricas. O plugin CSI pode fornecer ao Prometheus várias métricas sobre quais volumes estão conectados, quais interações estão ocorrendo, etc.
- Topologia ciente. Permite especificar nos manifestos como o cluster está geograficamente distribuído, evitando conexões com pods localizados em Londres para sistemas de armazenamento de dados situados em Amsterdã.
Para saber como conectar o Ceph ao cluster Kubernetes através do CSI, veja . Você também pode se inscrever em , que será iniciado em 15 de outubro.
Autor do artigo: Sergey Bondarev, arquiteto praticante da Southbridge, Administrador Certificado Kubernetes, um dos desenvolvedores do kubespray.
Um pouco de Post Scriptum não como publicidade, mas como utilidade...
P.S. Sergey Bondarev conduz duas intensivas: a atualizada de 28 a 30 de setembro e a avançada de 14 a 16 de outubro.
Fonte: habr.com
