

Olá!
Meu nome é Mikhail, sou o vice-diretor de TI da empresa "Sportmaster". Quero compartilhar uma história sobre como lidamos com as dificuldades que surgiram durante a pandemia.
Nos primeiros dias da nova realidade, o formato habitual de comércio offline da "Sportmaster" parou, e a carga sobre nosso canal online, principalmente na parte de entrega ao cliente, aumentou dez vezes. Em poucas semanas, transformamos um enorme negócio offline em online, adaptando o serviço às necessidades de nossos clientes.
Em resumo, o que antes era nossa operação secundária tornou-se o negócio principal. A importância de cada pedido online aumentou drasticamente. Precisávamos preservar cada rublo que o cliente trazia para a empresa.
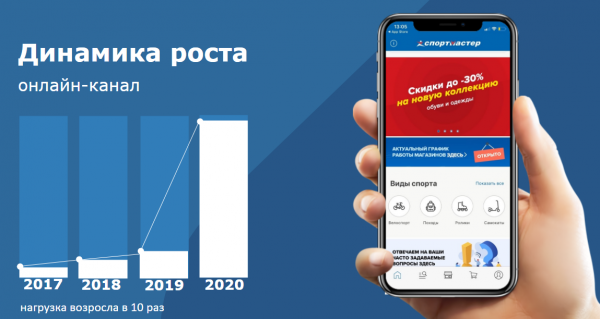
Para responder rapidamente às solicitações dos clientes, abrimos um centro de contatos adicional na sede da empresa, e agora podemos receber cerca de 285 mil chamadas por semana. Ao mesmo tempo, transferimos 270 lojas para um novo formato de operação sem contato e segura, permitindo que os clientes recebam pedidos e que os funcionários mantenham seus empregos.
Durante o processo de transformação, enfrentamos dois principais problemas. Primeiro, a carga em nossos recursos online aumentou significativamente (como lutamos contra isso, será contado por Sergey). Segundo, o fluxo de operações raras (antes da COVID) aumentou várias vezes, o que, por sua vez, exigiu um grande volume de automação rápida. Para resolver esse problema, tivemos que transferir rapidamente recursos de áreas que antes eram principais. Como conseguimos superar isso, será contado por Elena.
Operação de serviços online
Sergey Kolesnikov, responsável pela operação da loja online e microserviços
Desde o momento em que nossas lojas físicas começaram a fechar para visitantes, começamos a registrar um aumento em métricas como o número de usuários, o número de pedidos feitos em nosso aplicativo e o número de requisições para os aplicativos.
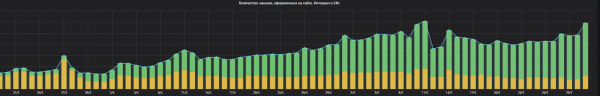 Número de pedidos de 18 a 31 de março
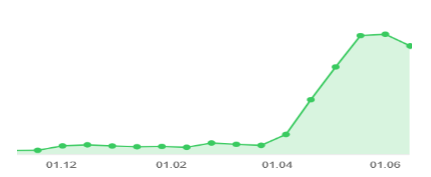 Número de solicitações aos microserviços de pagamento online
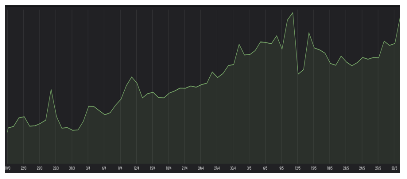 Número de pedidos realizados no site
No primeiro gráfico, vemos que o crescimento foi de aproximadamente 14 vezes, no segundo — 4 vezes. Consideramos a métrica do tempo de resposta de nossos aplicativos como a mais representativa.
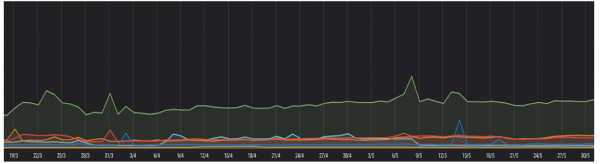
Neste gráfico, vemos a resposta de frentes e aplicativos, e determinamos que, de fato, não percebemos crescimento.
Isso se deve, em primeiro lugar, ao fato de que começamos os trabalhos preparatórios no final de 2019. Atualmente, nossos serviços estão reservados, e garantimos a resiliência em nível de servidores físicos, sistemas de virtualização, Docker e serviços neles. Nesse sentido, a capacidade de nossos recursos de servidor permite suportar cargas múltiplas.
A principal ferramenta que nos ajudou em toda essa história foi nosso sistema de monitoramento. Contudo, até bem pouco tempo atrás, não tínhamos um sistema único que permitisse coletar métricas em todos os níveis, desde o hardware físico até as métricas de negócios.
Formalmente, existia monitoramento na empresa, mas, na maioria das vezes, era disperso e estava sob a responsabilidade de departamentos específicos. De fato, quando ocorria algum incidente, quase nunca tínhamos uma compreensão unificada do que realmente acontecia, não havia comunicação, e isso frequentemente nos levava a correr em círculos na busca e localização do problema para posterior resolução.
Em determinado momento, decidimos que era hora de mudar isso — precisávamos de um sistema único para ter uma visão completa. As principais tecnologias em nossa pilha incluem Zabbix como centro de alertas e armazenamento de métricas, Prometheus para coleta e armazenamento de métricas de aplicativos, Stack ELK para registro e armazenamento de dados de todo o sistema de monitoramento, além de Grafana para visualização, Swagger, Docker e outros recursos úteis que você já conhece.
Além disso, não utilizamos apenas tecnologias disponíveis no mercado, mas também desenvolvemos algumas soluções internamente. Por exemplo, criamos serviços para integrar sistemas entre si, ou seja, uma API para coletar métricas. Também trabalhamos em nossos próprios sistemas de monitoramento — ao nível de métricas de negócios, utilizamos testes de interface. E temos um bot no Telegram para notificar as equipes.
Além disso, nos esforçamos para tornar o sistema de monitoramento acessível às equipes, para que possam armazenar suas métricas de forma independente e trabalhar com elas, incluindo a configuração de alertas em métricas específicas, que possuem uma aplicação não tão ampla.
Dentro de todo o sistema, buscamos ser proativos e localizar incidentes o mais rápido possível. Além disso, o número de nossos microsserviços e sistemas cresceu significativamente recentemente, o que, por sua vez, aumenta o número de integrações. Como parte da otimização do processo de diagnóstico de incidentes em nível de integração, estamos desenvolvendo um sistema que permite realizar verificações intersistemas e apresentar os resultados, facilitando a identificação de problemas principais relacionados a importações e à interação dos sistemas entre si.
Certamente, ainda temos muito a crescer e nos desenvolver em termos de operação dos sistemas, e estamos trabalhando ativamente nisso. Você pode ler mais sobre nosso sistema de monitoramento. .
Testes técnicos
Serguei Orlov, lidera o centro de competência em desenvolvimento web e móvel
Desde o fechamento das lojas físicas, tivemos que enfrentar diversos desafios em termos de desenvolvimento. Primeiro, o aumento da carga como um todo. É evidente que, se não forem tomadas medidas adequadas, uma alta carga no sistema pode, com um triste estalo, transformar-se em uma abóbora, ou degradar completamente seu desempenho, ou até mesmo perder a funcionalidade.
O segundo aspecto, um pouco menos óbvio, é que o sistema sob alta carga precisava ser rapidamente alterado, adaptando-se às mudanças nos processos de negócios. Às vezes, várias vezes ao dia. Em muitas empresas, há uma regra de que, durante grandes atividades de marketing, não se devem fazer alterações no sistema. Nenhuma alteração, apenas deixe-o funcionar, uma vez que está funcionando.
E nós, na verdade, tivemos uma Black Friday infinita, durante a qual precisávamos mudar o sistema. E qualquer erro, problema ou falha no sistema custaria caro para os negócios.
Antecipando-me, digo que conseguimos lidar com esses desafios, todos os sistemas suportaram a carga, escalonaram facilmente e não houve falhas técnicas globais.
Existem quatro pilares que sustentam a capacidade do sistema de suportar cargas de trabalho altas e repentinas. O primeiro deles é a monitorização, sobre a qual você leu anteriormente. Sem um sistema de monitorização estruturado, é praticamente impossível identificar os gargalos do sistema. Um bom sistema de monitorização é como um traje de casa, deve ser confortável e adaptado a você.
O segundo aspecto é o teste. Levamos essa questão muito a sério: escrevemos testes clássicos de unidade, integração, de carga e muitos outros para cada sistema. Também desenvolvemos uma estratégia de teste e nos esforçamos para elevar o nível de testes a um ponto em que as verificações manuais não sejam mais necessárias.
O terceiro pilar é o Pipeline de CI/CD. Os processos de construção, teste e implantação do aplicativo devem ser o mais automatizados possível, sem intervenções manuais. O tema do Pipeline de CI/CD é bastante profundo, e eu o abordarei apenas de forma sucinta. Vale mencionar que temos uma lista de verificação do Pipeline de CI/CD, pela qual cada equipe de produto passa com o auxílio de centros de competência.
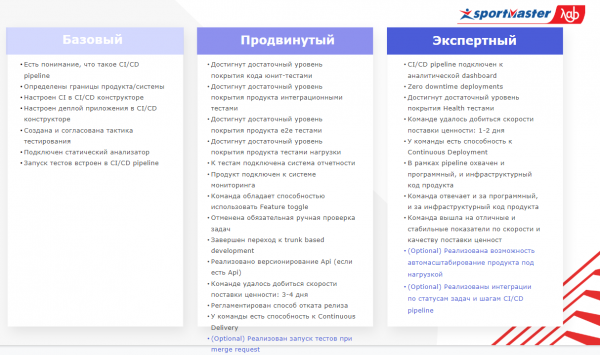 Aqui está a lista de verificação
Assim, uma série de objetivos é alcançada. Isso inclui versionamento de API, funcionalidades de controle, para evitar lançamentos desnecessários, e alcançar uma cobertura de testes de tal nível que a automação completa do teste seja possível, implantações seamless e muito mais.
O quarto pilar consiste em princípios arquitetônicos e soluções técnicas. Pode-se falar muito e por longos períodos sobre arquitetura, mas quero destacar alguns princípios nos quais gostaria de chamar a atenção.
Primeiro, é essencial escolher ferramentas especializadas para tarefas específicas. Sim, isso parece óbvio, e é claro que se deve usar um martelo para pregar e chaves específicas para desmontar um relógio. Contudo, na nossa era, muitas ferramentas buscam a universalização para atingir o maior segmento de usuários: bancos de dados, caches, frameworks e mais. Por exemplo, se considerarmos o banco de dados MongoDB, ele trabalha com transações multimencionais, enquanto o banco de dados Oracle lida com JSON. E à primeira vista, parece que tudo pode ser usado em qualquer situação. Mas, se defendemos a performance, precisamos entender claramente os pontos fortes e fracos de cada ferramenta e usar aquelas que atendem às nossas necessidades específicas.
Em segundo lugar, ao projetar sistemas, cada aumento de complexidade deve ser justificado. Devemos ter isso em mente constantemente; o princípio do baixo acoplamento é bem conhecido. Eu acredito que ele deve ser aplicado tanto no nível de um serviço específico quanto no nível de todo o sistema e na arquitetura como um todo. A capacidade de escalabilidade horizontal de cada componente do sistema sob carga também é crucial. Se tivermos essa capacidade, expandir o sistema não será um desafio.
Falando sobre soluções técnicas, pedimos às equipes de produtos que preparassem um novo conjunto de recomendações, ideias e soluções que implementaram durante a preparação para a próxima onda de carga.
Caches
É importante abordar com consciência a escolha entre caches locais e distribuídos. Às vezes, faz sentido usar ambos dentro de um mesmo sistema. Por exemplo, temos sistemas em que parte dos dados é essencialmente um cache de vitrine, ou seja, a fonte de atualizações está fora do próprio sistema, e ele não altera esses dados. Para essa abordagem, usamos o Caffeine Cache local.
Existem dados que o sistema altera ativamente durante seu funcionamento, e aqui já aplicamos um cache distribuído com Hazelcast. Essa abordagem nos permite aproveitar as vantagens do cache distribuído onde realmente são necessárias e minimizar os custos de serviço relacionados à circulação de dados no cluster Hazelcast onde podemos evitar essa necessidade. Já escrevemos bastante sobre caches. e .
Além disso, a mudança do serializador para Kryo no Hazelcast nos proporcionou um bom ganho. E a transição de ReplicatedMap para IMap + Near Cache no Hazelcast nos permitiu minimizar o tráfego de dados pelo cluster.
Uma pequena dica: ao invalidar em massa o cache, às vezes é útil aplicar a tática de pré-aquecer um segundo cache antes de mudar para ele. À primeira vista, com essa abordagem, deveríamos esperar um consumo de memória dobrado, mas na prática, em sistemas onde isso foi aplicado, o consumo de memória diminuiu.
Stack reativo
Estamos utilizando o stack reativo em um número considerável de sistemas. Em nosso caso, isso é Webflux ou Kotlin com corrotinas. Especialmente bem, o stack reativo se adapta onde esperamos operações de entrada e saída lentas. Por exemplo, chamadas a serviços lentos, interações com o sistema de arquivos ou sistemas de armazenamento.
O princípio mais importante é evitar chamadas bloqueantes. Sob o capô dos frameworks reativos, há uma pequena quantidade de threads de serviço ativas. Se formos descuidados e permitirmos uma chamada bloqueante direta, como uma chamada ao driver JDBC, o sistema simplesmente parará.
Procure converter os erros em exceções em tempo de execução próprias. O fluxo real de execução do programa se afasta dos frameworks reativos, tornando a execução do código não linear. Como consequência, é muito difícil diagnosticar problemas por meio de stack traces. A solução aqui será criar exceções em tempo de execução claras e objetivas para cada erro.
Elasticsearch
Ao usar Elasticsearch, não escolha dados não utilizados. Este é, basicamente, um conselho muito simples, mas muitas vezes é algo que esquecem. Se precisar selecionar mais de 10 mil registros de uma vez, você deve usar o Scroll. Fazendo uma analogia, isso é um pouco semelhante a um cursor em um banco de dados relacional.
Não use postfilter desnecessariamente. Com grandes conjuntos de dados na seleção principal, essa operação sobrecarrega bastante o banco de dados.
Use operações em massa onde for aplicável.
API
Ao projetar a API, inclua requisitos para minimizar os dados transmitidos. Isso é especialmente relevante na interação com o front-end: exatamente nesse ponto, saímos dos canais de nossos data centers e já estamos trabalhando na conexão com o cliente. Se houver quaisquer problemas, um tráfego muito alto causa uma experiência negativa ao usuário.
E, finalmente, não despeje toda a pilha de dados; aborde claramente o contrato entre consumidores e fornecedores.
Transformação organizacional
Elen Yeroshkina, Diretora de TI
No momento em que ocorreu o isolamento e surgiu a necessidade de aumentar drasticamente o ritmo de desenvolvimento online e implementar serviços Omnichannel, já estávamos em processo de transformação organizacional.
Parte da nossa estrutura foi adaptada para trabalhar com os princípios e práticas da abordagem de produto. Formaram-se equipes que agora são responsáveis pelo funcionamento e desenvolvimento de cada produto. Os colaboradores nessas equipes estão envolvidos 100% e organizam seu trabalho com Scrum ou Kanban, dependendo do que for mais preferível para eles, configuram o pipeline de implantação, implementam práticas técnicas, práticas de controle de qualidade e muito mais.
Por uma feliz coincidência, a maior parte dessas equipes de produto estava exatamente na área de serviços online e omnichannel. Isso nos permitiu, em um curto espaço de tempo (sério, literalmente em dois dias), mudar para o modo de trabalho remoto sem perda de eficiência. O processo ajustado nos permitiu rapidamente nos adaptar às novas condições de trabalho e manter um ritmo bastante elevado na entrega de novas funcionalidades.
Além disso, surgiu a necessidade de reforçar aquelas equipes que estão na linha de frente do negócio online. Naquele momento ficou claro que poderíamos fazer isso somente com recursos internos. Cerca de 50 pessoas mudaram sua área de atuação em duas semanas e se integraram ao trabalho em um novo produto para elas.
Para isso, não foram necessárias grandes esforços gerenciais, porque juntamente com a organização do próprio processo, o aprimoramento técnico do produto e a prática de controle de qualidade, ensinamos nossas equipes a se autoorganizarem — a gerenciar seu próprio processo produtivo sem a necessidade de recursos administrativos.
Conseguimos concentrar nosso recurso gerencial exatamente onde era necessário naquele momento, na coordenação junto ao negócio: O que é importante para nosso cliente agora, qual funcionalidade deve ser implementada em primeiro lugar, o que é necessário fazer para aumentar nossa capacidade de entrega e processamento de pedidos. Tudo isso e um modelo de papel claro nos permitiram sobrecarregar nossos fluxos de produção na criação de valor com o que realmente importa e é necessário.
É evidente que, em um trabalho remoto e em um ritmo acelerado de mudanças, onde a participação de cada um impacta os resultados do negócio, não podemos confiar apenas em intuições internas, como 'Está tudo bem? Sim, parece que está'. Precisamos de métricas objetivas do processo produtivo. Temos essas métricas disponíveis para todos que estão interessados nos dados das equipes de produto. Acima de tudo, para a equipe, o negócio, os colaboradores e a liderança.
A cada duas semanas, realizamos um status com cada equipe, onde, em 10 minutos, analisamos as métricas, identificamos os gargalos do processo produtivo e chegamos a uma solução conjunta: o que pode ser feito para eliminar esses gargalos. Aqui também é possível pedir ajuda aos líderes caso algum problema identificado esteja fora da influência das equipes, ou a expertise de colegas que, possivelmente, já enfrentaram um problema similar.
No entanto, entendemos que, para acelerar multiplicativamente (que é exatamente o objetivo que estabelecemos), ainda temos muito a aprender e implementar em nosso trabalho diário. Neste momento, continuamos expandindo a abordagem de produto para outras equipes e novos produtos. Para isso, tivemos que dominar um novo formato para nós: a escola online de metodologistas.
Os metodologistas, pessoas que ajudam as equipes a estruturar processos, estabelecer comunicações e aumentar a eficácia do trabalho, são, em essência, agentes de mudança. Neste momento, os graduados da nossa primeira turma estão trabalhando com as equipes e ajudando-as a se tornarem bem-sucedidas.
Acredito que a situação atual nos abre oportunidades e perspectivas que talvez ainda não tenhamos plenamente percebido. Mas a experiência e a prática que estamos adquirindo agora confirmam que escolhemos o caminho certo para o nosso desenvolvimento, não iremos perder essas novas oportunidades no futuro e conseguiremos responder de maneira eficaz aos desafios que surgirão para a "Sportmaster".
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Nestes tempos difíceis, formulamos os principais princípios que sustentam o desenvolvimento de software, que, acredito, serão relevantes para qualquer empresa que trabalhe nessa área.
Pessoas. É a base de tudo. Os funcionários devem desfrutar do trabalho, entender os objetivos da empresa e os objetivos dos produtos com os quais estão envolvidos. E, claro, devem ter a oportunidade de se desenvolver profissionalmente.
Tecnologia. É necessário que a empresa aborde de forma madura o trabalho com seu stack tecnológico e desenvolva competências onde realmente for necessário. Isso soa muito simples e óbvio, mas é frequentemente ignorado.
Processos. É importante estruturar corretamente o trabalho das equipes de produtos e dos centros de competência, estabelecendo interação com o negócio, para que possamos atuar como parceiros.
Em geral, foi assim que conseguimos sobreviver. A principal tese da contemporaneidade foi mais uma vez confirmada, soando como um tapa na testa.
Mesmo se você for uma grande empresa offline com várias lojas em muitas cidades, desenvolva sua presença online. Não se trata apenas de um canal adicional de vendas ou de um aplicativo bonito pelo qual também se pode comprar algo (e, além disso, porque os concorrentes também têm algo bonito). Não é uma reserva para emergências que ajudará a enfrentar a tempestade.
É uma necessidade absoluta. Para a qual devemos estar prontos não apenas em termos de capacidade técnica e infraestrutura, mas também em relação às pessoas e processos. Pois é possível adquirir rapidamente memória, espaço, implantar novas instâncias e outras coisas em poucas horas. No entanto, preparar pessoas e processos para isso deve ser feito com antecedência.
Fonte: habr.com
