

Prezados leitores, bom dia!
A construção de plataformas de TI para acumulação e análise de dados surge, mais cedo ou mais tarde, em qualquer empresa cujo modelo de negócios é baseado em serviços intensivos em inteligência ou na criação de produtos tecnicamente complexos. A construção de plataformas analíticas é uma tarefa complexa e que consome muitas horas de trabalho. No entanto, qualquer tarefa pode ser simplificada. Neste artigo, quero compartilhar a experiência de aplicação de ferramentas low-code que auxiliam na criação de soluções analíticas. Essa experiência foi adquirida na implementação de diversos projetos na área de Big Data Solutions da empresa "Neoflex". Desde 2005, a área de Big Data Solutions da Neoflex se dedica a questões relacionadas à construção de armazéns e lagos de dados, resolvendo problemas de otimização da velocidade de processamento de informações e trabalhando na metodologia de gestão da qualidade dos dados.
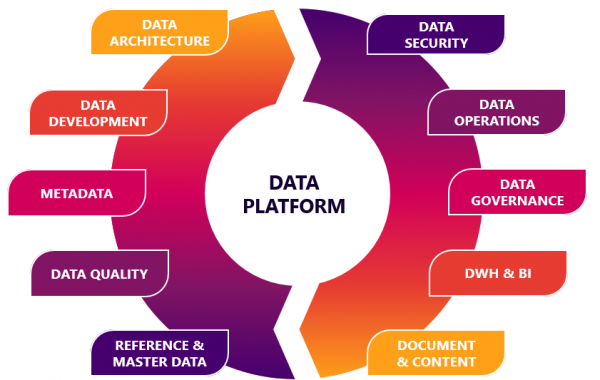
Ninguém poderá evitar acumular conscientemente dados fracos e/ou fortemente estruturados. Provavelmente, nem mesmo se estivermos falando de pequenas empresas. Afinal, ao escalar o negócio, um empreendedor promissor enfrentará questões como o desenvolvimento de um programa de fidelidade, desejará analisar a eficácia dos pontos de venda, pensar em publicidade direcionada e se preocupará com a demanda por produtos complementares. A princípio, a tarefa pode ser resolvida de maneira improvisada. Mas, conforme o negócio cresce, a transição para uma plataforma analítica se torna inevitável.
Mas em que circunstâncias as tarefas de análise de dados podem se transformar em questões do tipo "Ciência de Foguete"? Sem dúvida, no momento em que se trata de dados realmente grandes.
Para simplificar a tarefa da "Ciência de Foguete", você pode comer um elefante em partes.
Quanto maior a discretização e autonomia de suas aplicações/serviços/microserviços, mais fácil será para você, seus colegas e todo o negócio digerir o elefante.
Esse postulado foi aceito por praticamente todos os nossos clientes, que reestruturaram o cenário com base nas práticas de engenharia das equipes DevOps.
Mas mesmo com uma dieta "separada e elefantina", ainda temos boas chances de "superlotar" a paisagem de TI. Nesse momento, é hora de parar, respirar fundo e olhar na direção de plataforma de engenharia low-code.
Muitos desenvolvedores temem a perspectiva de estagnação na carreira ao se afastar da programação direta em direção ao "arrastar e soltar" em interfaces de usuário de sistemas low-code. Mas a introdução de máquinas não levou ao desaparecimento de engenheiros, mas sim elevou seu trabalho a um novo patamar!
Vamos entender o porquê.
A análise de dados nos setores de logística, telecomunicações, estudos de mídia e o setor financeiro sempre está associada às seguintes perguntas:
- Velocidade de execução da análise automatizada;
- Capacidade de realizar experimentos sem impactar o fluxo principal de produção de dados;
- Veracidade dos dados preparados;
- Monitoramento de mudanças e versionamento;
- Proveniência de dados, linha de dados, CDC;
- Rapidez na entrega de novas funcionalidades para o ambiente de produção;
- E o famoso: custo de desenvolvimento e suporte.
Ou seja, os engenheiros enfrentam uma infinidade de tarefas de alto nível, cuja execução eficaz só é possível ao limpar a mente das tarefas de baixo nível da programação.
As premissas para a transição dos desenvolvedores a um novo nível foram a evolução e digitalização dos negócios. O valor do desenvolvedor também mudou: há uma escassez significativa de desenvolvedores que conseguem mergulhar na essência dos conceitos de negócios automatizados.
Vamos traçar uma analogia entre linguagens de programação de baixo e alto nível. A transição de linguagens de baixo nível para linguagens de alto nível é uma mudança de "diretivas diretas na linguagem da máquina" para "diretivas na linguagem das pessoas". Ou seja, a adição de uma camada de abstração. Nesse caso, a transição de plataformas low-code de linguagens de programação de alto nível é uma mudança de "diretivas na linguagem das pessoas" para "diretivas na linguagem dos negócios". Se houver desenvolvedores que se sentirem tristes com esse fato, é possível que estejam tristes desde o momento em que o JavaScript surgiu, onde são usadas funções de ordenação de arrays. E essas funções, é claro, têm implementações programáticas sob o capô usando outros meios de programação de alto nível.
Portanto, o low-code é apenas o surgimento de mais um nível de abstração.
Experiência prática no uso de low-code
O tema low-code é bastante amplo, mas agora gostaria de falar sobre a aplicação prática de "conceitos de low-code" com base em um dos nossos projetos.
A divisão Big Data Solutions da empresa "Neoflex" se especializa, em grande parte, no setor financeiro, construindo repositórios e lagos de dados e automatizando diversos relatórios. Nesse nicho, a aplicação de low-code já se tornou padrão. Entre outras ferramentas de low-code, podemos mencionar soluções para organizar processos ETL: Informatica Power Center, IBM DataStage, Pentaho Data Integration. Ou ainda Oracle Apex, que atua como um ambiente de rápida desenvolvimento de interfaces de acesso e edição de dados. No entanto, o uso de ferramentas de desenvolvimento de low-code nem sempre está associado à construção de aplicativos específicos em uma pilha comercial de tecnologia com uma dependência claramente definida do fornecedor.
Com plataformas de low-code, também é possível organizar a orquestração de fluxos de dados, criar ambientes de data science ou, por exemplo, módulos de verificação da qualidade dos dados.
Um dos exemplos práticos de experiência no uso de ferramentas de desenvolvimento de low-code é a colaboração entre "Neoflex" e a empresa Mediascope, uma das líderes do mercado russo em pesquisas de mídia. Uma das tarefas dessa empresa é a produção de dados com base nos quais anunciantes, plataformas na internet, canais de televisão, estações de rádio, agências de publicidade e marcas tomam decisões de compra de publicidade e planejam suas comunicações de marketing.
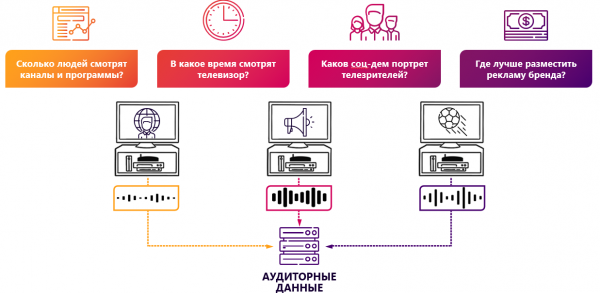
Pesquisas de mídia são um setor de negócios tecnologicamente carregado. O reconhecimento de vídeos, a coleta de dados de dispositivos que analisam visualizações, a medição da atividade em recursos da web — tudo isso implica que a empresa possui uma grande equipe de TI e uma imensa experiência na construção de soluções analíticas. Mas o crescimento exponencial da quantidade de informações, do número e da diversidade de suas fontes exige um progresso constante na indústria de TI de dados. A solução mais simples para escalar a já funcionando plataforma analítica da Mediascope poderia ser aumentar a equipe de TI. No entanto, uma solução muito mais eficaz é acelerar o processo de desenvolvimento. Um dos passos que levam a essa direção pode ser a aplicação de plataformas de low-code.
No início do projeto, a empresa já contava com uma solução de produto em funcionamento. No entanto, a implementação da solução em MSSQL não poderia atender plenamente às expectativas em relação à escalabilidade das funcionalidades, mantendo um custo razoável para as adaptações.
A tarefa que tínhamos pela frente era verdadeiramente ambiciosa – a Neoflex e a Mediascope precisariam criar uma solução industrial em menos de um ano, com o MVP sendo lançado já no primeiro trimestre a partir da data de início dos trabalhos.
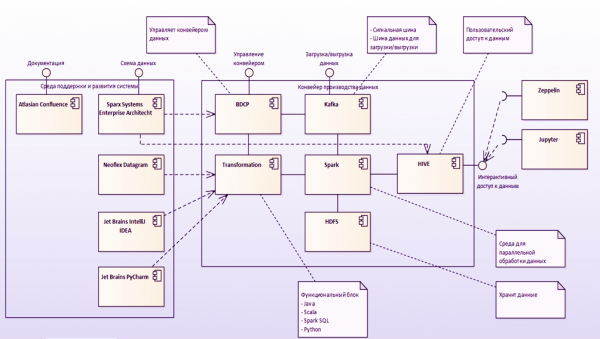
Como base para a construção da nova plataforma de dados, fundamentada em computação low-code, foi escolhido o stack de tecnologias Hadoop. O padrão de armazenamento de dados passou a ser HDFS, utilizando arquivos no formato parquet. Para o acesso aos dados na plataforma, foi utilizado o Hive, no qual todas as vitrines disponíveis são apresentadas como tabelas externas. A carga de dados para o armazenamento foi realizada com o auxílio do Kafka e Apache NiFi.
O instrumento low-code nesta concepção foi aplicado para otimizar a tarefa mais trabalhosa na construção da plataforma analítica – a tarefa de cálculo de dados.
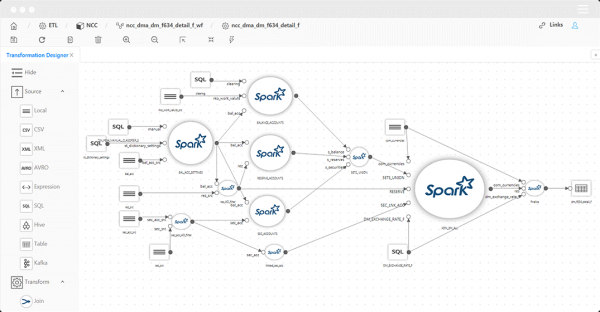
O mecanismo principal para o mapeamento de dados foi o instrumento low-code Datagram. Neoflex Datagram – é uma ferramenta para o desenvolvimento de transformações e fluxos de dados.
Usando esta ferramenta, é possível evitar a escrita de código em Scala "manual". O código Scala é gerado automaticamente utilizando a abordagem de Model Driven Architecture.
Uma vantagem óbvia dessa abordagem é a aceleração do processo de desenvolvimento. No entanto, além da velocidade, há também as seguintes vantagens:
- Visualização do conteúdo e estrutura das fontes/receptores;
- Rastreamento da origem dos objetos no fluxo de dados até campos específicos (lineage);
- Execução parcial de transformações com visualização de resultados intermediários;
- Visualização do código-fonte e sua correção antes da execução;
- Validação automática das transformações;
- Carregamento automático de dados 1 para 1.
A barreira de entrada para soluções low-code para geração de transformações é bastante baixa: o desenvolvedor precisa conhecer SQL e ter experiência com ferramentas ETL. Vale ressaltar que geradores de transformações orientados por código não são ferramentas ETL no sentido amplo da palavra. Ferramentas low-code podem não ter seu próprio ambiente para execução de código. Isso significa que o código gerado será executado no ambiente que já existia no cluster antes da instalação da solução low-code. E esse é, sem dúvida, mais um ponto positivo para o low-code. Assim, em paralelo com a equipe low-code, pode trabalhar uma equipe
clássica
Arquitetura da Solução
implementando funcionalidade, por exemplo, em código Scala puro. A integração de alterações de ambas as equipes em produção será simples e "sem costura".
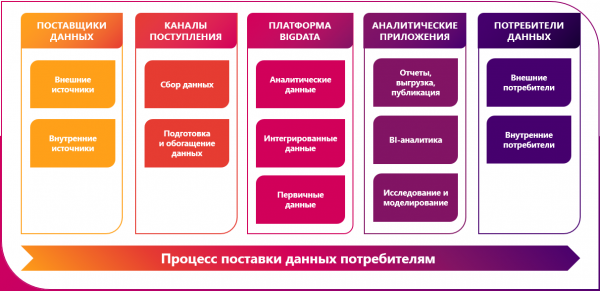
Vale mencionar que, além do low-code, também existem soluções no-code. E, na essência, essas são coisas diferentes. O low-code permite que o desenvolvedor intervenha mais no código gerado. No caso do Datagram, é possível visualizar e editar o código Scala gerado, enquanto o no-code pode não oferecer essa possibilidade. Essa diferença é bastante significativa, tanto em termos de flexibilidade da solução, quanto em termos de conforto e motivação para o trabalho dos engenheiros de dados.
- Pipometros (medidores de TV) são dispositivos de hardware e software que registram o comportamento do usuário entre os entrevistados de um painel de televisão – quem, quando e qual canal assistiu na residência que participa da pesquisa. A informação fornecida é um fluxo de intervalos de audiência vinculados ao pacote de mídia e ao produto de mídia. Os dados na fase de carregamento no Data Lake podem ser enriquecidos com atributos demográficos, associações geográficas, fusos horários e outras informações necessárias para a análise da audiência de determinado produto de mídia. As medições realizadas podem ser usadas para análise ou planejamento de campanhas publicitárias, avaliação da atividade e preferências do público, e elaboração de grades de programação;
- Os dados podem vir de sistemas de monitoramento de transmissão de televisão por streaming e medição de visualização de conteúdo em recursos de vídeo na internet;
- Ferramentas de medição no ambiente web, incluindo contadores centrados no site e centrados no usuário. Um complemento do navegador, como a research bar e um aplicativo móvel embutido pode servir como fornecedor de dados para o Data Lake; VPN.
- Os dados também podem ser coletados de plataformas que consolidam resultados de preenchimento de questionários online e resultados de entrevistas telefônicas em pesquisas da empresa;
- Um enriquecimento adicional do lago de dados pode ocorrer por meio do carregamento de informações a partir de logs de empresas parceiras.
A implementação da carga as is de sistemas-fonte para o staging primário de dados brutos pode ser organizada de várias formas. No caso de utilização de low-code para esses fins, é possível a geração automática de scripts de carga com base em metadados. Nesse contexto, não há necessidade de descer ao nível de desenvolvimento de mapeamentos source to target. Para realizar o carregamento automático, precisamos estabelecer uma conexão com a fonte e, em seguida, determinar na interface de carregamento as entidades a serem carregadas. A criação da estrutura de diretórios no HDFS ocorrerá automaticamente e corresponderá à estrutura de armazenamento de dados no sistema de origem.
No entanto, no contexto deste projeto, decidimos não utilizar essa funcionalidade da plataforma low-code, uma vez que a empresa Mediascope já começou por conta própria a desenvolver um serviço semelhante utilizando a combinação Nifi + Kafka.
É importante deixar claro que essas ferramentas não são substitutas, mas sim complementares entre si. Nifi e Kafka podem operar tanto na ligação direta (Nifi -> Kafka) quanto na inversa (Kafka -> Nifi). Para a plataforma de pesquisa de mídia, foi utilizada a primeira opção de conexão.
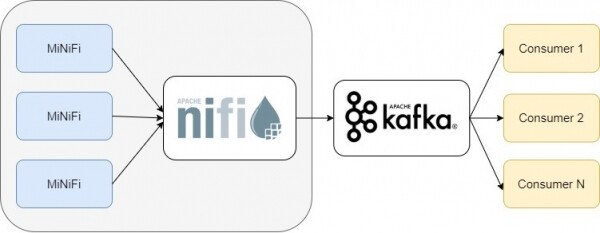
No nosso caso, o Nifi precisava processar diferentes tipos de dados de sistemas fontes e encaminhá-los para o broker Kafka. O direcionamento das mensagens para um tópico específico do Kafka era feito por meio de processadores do Nifi PublishKafka. A orquestração e a manutenção desses pipelines são realizadas na interface gráfica. A ferramenta Nifi e o uso da combinação Nifi + Kafka também podem ser considerados uma abordagem low-code para o desenvolvimento, com baixa barreira de entrada nas tecnologias de Big Data e que acelera o processo de desenvolvimento de aplicações.
A próxima etapa na implementação do projeto foi a adequação ao formato de uma camada semântica unificada de dados detalhados. Caso a entidade possua atributos históricos, o cálculo é feito no contexto da partição analisada. Se a entidade não for histórica, é opcional recalcular todo o conteúdo do objeto ou mesmo optar por não recalcular esse objeto (devido à ausência de alterações). Nesta fase, são geradas as chaves para todas as entidades. As chaves são armazenadas nos diretórios mestres correspondentes no Hbase, que contêm a correspondência entre as chaves na plataforma analítica e as chaves dos sistemas fontes. A consolidação das entidades atômicas é acompanhada pelo enriquecimento com os resultados do cálculo preliminar dos dados analíticos. O framework utilizado para o cálculo dos dados foi o Spark. A funcionalidade descrita para a adequação dos dados à semântica unificada também foi implementada com base nos mapeamentos da ferramenta low-code Datagram.
Na arquitetura alvo, era necessário garantir acesso SQL aos dados para usuários de negócios. Para essa opção, foi utilizado o Hive. O registro de objetos no Hive é realizado automaticamente ao ativar a opção 'Registrar Tabela Hive' na ferramenta low-code.
Gerenciamento do fluxo de cálculo
O Datagram tem uma interface para a construção de designs de fluxos de trabalho. A execução de mapeamentos pode ser feita usando o agendador Oozie. Na interface do desenvolvedor de fluxos, é possível criar esquemas de execução de transformações de dados em paralelo, sequencialmente ou dependendo de condições específicas. Há suporte para shell scripts e programas em Java. Também é possível usar servidor Apache Livy. O Apache Livy é utilizado para executar aplicativos diretamente do ambiente de desenvolvimento.
Caso a empresa já tenha seu próprio orquestrador de processos, é possível utilizar a API REST para integrar mapeamentos no fluxo já existente. Por exemplo, tivemos uma experiência bastante bem-sucedida na integração de mapeamentos em Scala com orquestradores escritos em PLSQL e Kotlin. A API REST da ferramenta de baixo código implica operações como a geração do ano executável com base no design do mapeamento, chamada do mapeamento, chamada de uma sequência de mapeamentos e, claro, a passagem de parâmetros na URL para acionar os mapeamentos.
Juntamente com o Oozie, é possível organizar o fluxo de cálculo usando o Airflow. Não vou me aprofundar na comparação entre Oozie e Airflow, mas apenas direi que, no contexto do projeto de pesquisas de mídia, a escolha recaiu sobre o Airflow. Os principais argumentos desta vez foram uma comunidade mais ativa que desenvolve o produto e uma interface + API mais avançadas.
O Airflow também é bom porque, para descrever os processos de cálculo, ele utiliza o amado Python. E, de fato, não há muitas plataformas de gerenciamento de fluxos de trabalho de código aberto. A execução e monitoramento da execução dos processos (inclusive com gráfico de Gantt) apenas adicionam pontos à reputação do Airflow.
O formato do arquivo de configuração para a execução de mapeamentos da solução de baixo código tornou-se o spark-submit. Isso ocorreu por duas razões. Primeiro, o spark-submit permite iniciar diretamente um arquivo jar a partir do console. Em segundo lugar, ele pode conter todas as informações necessárias para configurar o fluxo de trabalho (o que facilita a escrita de scripts que formam o Dag).
O elemento mais frequentemente encontrado no fluxo de trabalho do Airflow, no nosso caso, foi o SparkSubmitOperator.
O SparkSubmitOperator permite executar arquivos jar — mapeamentos empacotados do Datagram com parâmetros de entrada previamente definidos.
É importante mencionar que cada tarefa do Airflow é executada em uma thread separada e não sabe nada sobre as outras tarefas. Portanto, a interação entre as tarefas é realizada por meio de operadores de controle, como DummyOperator ou BranchPythonOperator.
A combinação do uso da solução low-code Datagram com a universalização de arquivos de configuração (formando o Dag) resultou em uma aceleração significativa e na simplificação do processo de desenvolvimento de fluxos de carregamento de dados.
Cálculo das vitrines
Sem dúvida, a etapa mais intelectualmente exigente na produção de dados analíticos é a construção das vitrines. No contexto de um dos fluxos de cálculo de dados de uma empresa de pesquisa, nesta etapa ocorre a padronização da tradução com a correção para fusos horários, vinculado à grade de transmissão. Também pode haver correção para a grade de transmissão local (notícias e publicidade locais). Entre outras coisas, nesta etapa é feita a segmentação dos intervalos de visualização contínua de produtos de mídia com base na análise dos intervalos de visualização. Aqui também ocorre o 'pesagem' dos valores de visualização com base nas informações sobre sua importância (cálculo do coeficiente de correção).
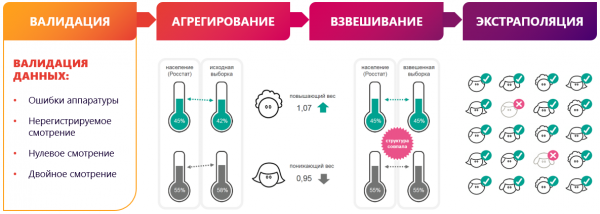
Um passo adicional na preparação das vitrines é a validação dos dados. O algoritmo de validação está associado ao uso de uma série de modelos científicos matemáticos. No entanto, a utilização de plataformas low-code permite dividir um algoritmo complexo em uma série de mapeamentos visualmente legíveis. Cada um desses mapeamentos executa uma tarefa específica. Como resultado, é possível realizar depuração, registro e visualização das etapas de preparação dos dados.
O algoritmo de validação foi dividido nos seguintes subetapas:
- Construção de regressões das dependências de audiência das redes de TV na região em relação à audiência de todas as redes na região durante 60 dias.
- Cálculo dos resíduos estudentizados (desvios dos valores reais em relação aos previstos pelo modelo de regressão) para todos os pontos de regressão e para o dia de cálculo.
- Seleção de pares anômalos região-rede de TV, onde o resíduo estudentizado do dia de cálculo ultrapassa o limite (definido pela configuração da operação).
- Recontagem do saldo estudantes ajustado para pares anômalos região-rede de televisão para cada respondente que assistiu à rede na região, com a definição da contribuição deste respondente (quantidade de mudança do saldo estudantes ajustado) ao excluir a visualização deste respondente da amostra.
- Busca por candidatos cuja exclusão leva o saldo estudantes ajustado do dia de cálculo à normalidade.
O exemplo acima é uma confirmação da hipótese de que um engenheiro de dados já tem muita coisa na cabeça… E, se realmente for um 'engenheiro' e não um 'programador', o medo da degradação profissional ao usar ferramentas low-code deve finalmente desaparecer.
O que mais pode ser feito com low-code?
A área de aplicação da ferramenta low-code para processamento de dados em lote e em fluxo sem a necessidade de escrever código em Scala manualmente não termina aqui.
A aplicação de low-code no desenvolvimento de datalakes já se tornou um padrão para nós. Pode-se dizer que as soluções na pilha Hadoop seguem o caminho de desenvolvimento dos clássicos DWH, baseados em SGBDs. Ferramentas low-code na pilha Hadoop podem resolver tanto problemas de processamento de dados quanto a construção de interfaces BI finais. Além disso, é importante destacar que por BI pode-se entender não apenas a representação de dados, mas também sua edição por usuários de negócios. Essa funcionalidade é frequentemente utilizada por nós na construção de plataformas analíticas para o setor financeiro.
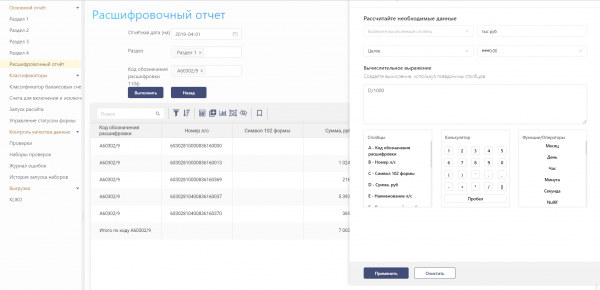
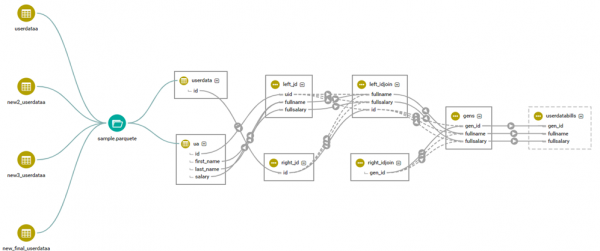
Entre outras coisas, com o uso de low-code e, em particular, Datagram, é possível resolver a tarefa de rastreamento da origem de objetos de fluxos de dados com atomicidade até campos individuais (lineage). Para isso, no instrumento low-code, foi implementada a conexão com o Apache Atlas e o Cloudera Navigator. Essencialmente, o desenvolvedor precisa registrar um conjunto de objetos nos dicionários do Atlas e referenciar os objetos registrados ao construir mapeamentos. O mecanismo de rastreamento da origem dos dados ou análise de dependências de objetos economiza muito tempo quando é necessário fazer ajustes nos algoritmos de cálculo. Por exemplo, ao construir relatórios financeiros, esse recurso permite lidar com mais conforto durante períodos de mudanças na legislação. Quanto melhor entendermos a dependência entre formas no contexto de objetos da camada detalhada, menos enfrentaremos
Qualidade dos Dados & Low-code
Outra tarefa implementada pelo instrumento low-code no projeto da empresa Mediascope foi a classe de tarefa de Qualidade dos Dados. A característica da implementação do pipeline de verificação de dados para o projeto da empresa de pesquisa foi a ausência de impacto na operabilidade e na velocidade do fluxo principal de cálculo de dados. Para possibilitar a orquestração de fluxos independentes de verificação de dados, utilizou-se o já conhecido Apache Airflow. À medida que cada etapa da produção de dados ficava pronta, a parte isolada do pipeline de DQ era executada em paralelo.
É considerado uma boa prática monitorar a qualidade dos dados desde o momento de seu surgimento na plataforma analítica. Tendo informações sobre metadados, podemos começar a verificar o cumprimento das condições básicas — not null, constraints, foreign keys — assim que os dados entram na camada primária. Essa funcionalidade é implementada com base em mapeamentos gerados automaticamente da família de qualidade de dados no Datagram. A geração de código, nesse caso, também se baseia nos metadados do modelo. No projeto da empresa Mediascope, a conexão foi feita com os metadados do produto Enterprise Architect.
Graças à conexão entre o instrumento low-code e o Enterprise Architect, as seguintes verificações foram geradas automaticamente:
- Verificação da presença de valores "null" em campos com o modificador "not null";
- Verificação da presença de duplicatas na chave primária;
- Verificação de chave estrangeira da entidade;
- Verificação de exclusividade de uma linha com base em um conjunto de campos.
Para verificações mais complexas de disponibilidade e validade dos dados, foi criado um mapeamento com Scala Expression, que aceita como entrada um código de verificação em Spark SQL, preparado pelos analistas no Zeppelin.
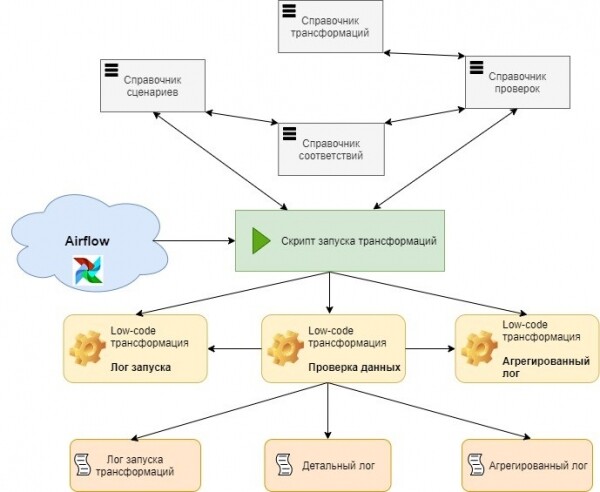
Certamente, a auto-geração de verificações deve ser feita gradualmente. No âmbito do projeto descrito, os seguintes passos foram realizados:
- DQ, realizados em notebooks do Zeppelin;
- DQ, integrados no mapeamento;
- DQ na forma de mapeamentos massivos separados, contendo um conjunto completo de verificações para uma entidade específica;
- Mapeamentos DQ universalmente parametrizados, que aceitam como entrada informações sobre metadados e verificações de negócios.
Sem dúvida, a principal vantagem de criar um serviço de verificações parametrizadas é a redução do tempo de entrega de funcionalidades para o ambiente de produção. Novas verificações de qualidade podem passar pelo padrão clássico de entrega de código de forma indireta através de ambientes de desenvolvimento e teste:
- Todas as verificações de metadados são geradas automaticamente quando a modelagem na EA é alterada;
- Verificações de disponibilidade de dados (determinação da presença de quaisquer dados em um determinado momento) podem ser geradas com base em um diretório que guarda a temporização esperada da chegada do próximo lote de dados em relação aos objetos;
- As verificações de validade dos dados de negócios são criadas pelos analistas nos notebooks do Zeppelin, a partir dos quais são direcionadas diretamente para as tabelas de configuração do módulo DQ no ambiente de produção.
Os riscos de enviar scripts diretamente para a produção são praticamente inexistentes. Mesmo com um erro de sintaxe, o máximo que enfrentamos é o não cumprimento de uma única verificação, pois o fluxo de cálculo de dados e o fluxo de execução de verificações de qualidade estão separados.
Essencialmente, o serviço DQ está permanentemente ativo no ambiente de produção e pronto para iniciar seu trabalho assim que novos dados chegam.
Em conclusão
A vantagem de usar low-code é evidente. Os desenvolvedores não precisam criar um aplicativo "do zero". E um programador liberado de tarefas adicionais entrega resultados mais rapidamente. A velocidade, por sua vez, libera um recurso adicional de tempo para resolver questões de otimização. Portanto, neste caso, pode-se contar com uma solução mais qualitativa e rápida.
Naturalmente, o low-code não é uma panaceia, e a mágica não acontecerá sozinha:
- A indústria de low-code está passando por uma fase de "fortalecimento", e ainda não há padrões industriais homogêneos;
- Muitas soluções low-code não são gratuitas, e sua aquisição deve ser um passo consciente, a ser dado com plena confiança no benefício financeiro de seu uso;
- Muitas soluções de low-code nem sempre se dão bem com GIT / SVN. Ou são inconvenientes de usar no caso de ocultação do código gerado;
- Ao expandir a arquitetura, pode ser necessária uma adaptação da solução low-code – o que, por sua vez, provoca o efeito de "vinculação e dependência" do fornecedor da solução low-code.
- Um nível adequado de segurança é possível, mas é bastante trabalhoso e complexo de implementar em motores de sistemas low-code. As plataformas de low-code devem ser escolhidas não apenas pelo princípio de buscar lucro com seu uso. Ao escolher, deve-se considerar a presença de funcionalidades de gestão de acesso e delegação/escalonamento de dados de identificação em todo o nível de TI da organização.
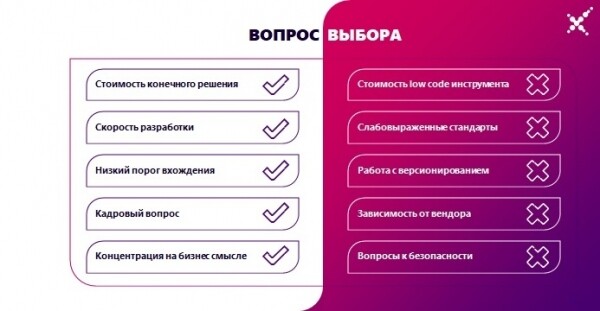
No entanto, se você conhece todas as desvantagens do sistema escolhido, e os benefícios de seu uso, no entanto, estão na maioria dominante, então avance para o low-code sem medo. Além disso, a transição para ele é inevitável – assim como qualquer evolução.
Se um desenvolvedor em uma plataforma low-code consegue executar seu trabalho mais rapidamente do que dois desenvolvedores sem low-code, isso dá à empresa uma vantagem em todos os aspectos. A barreira de entrada para soluções low-code é mais baixa do que para tecnologias 'tradicionais', o que impacta positivamente na questão da escassez de profissionais. O uso de ferramentas de baixo código pode acelerar a interação entre equipes funcionais e a tomada de decisões sobre a validade do caminho escolhida nas pesquisas de data science. As plataformas de baixo código podem ser um motor para a transformação digital da organização, pois as soluções produzidas podem ser compreendidas por especialistas não técnicos (em particular, usuários de negócios).
Se você tem prazos apertados, uma lógica de negócios complexa, escassez de expertise tecnológica e precisa acelerar o time to market, então o low-code é uma das maneiras de atender às suas necessidades.
Não se deve subestimar a importância das ferramentas de desenvolvimento tradicionais, mas em muitos casos, a aplicação de soluções de baixo código é a melhor forma de aumentar a eficiência nas tarefas a serem resolvidas.
Fonte: habr.com
