

Olá, Habr!
A nossa empresa é especializada no desenvolvimento de soluções software de classe ERP, nas quais uma parte significativa é ocupada por sistemas transacionais com grande volume de lógica de negócios e fluxo documental semelhante a SED. As versões mais modernas dos nossos produtos são baseadas em tecnologias JavaEE, mas também estamos experimentando ativamente com microserviços. Um dos pontos mais problemáticos dessas soluções é a integração de diferentes subsistemas relacionados a domínios adjacentes. As tarefas de integração sempre nos deram uma grande dor de cabeça, independentemente dos estilos arquitetônicos, pilhas tecnológicas e frameworks utilizados; no entanto, recentemente, tem havido progresso na resolução dessas questões.
No artigo que apresento a você, discutirei a experiência e as investigações arquitetônicas da NPO 'Krista' nesta área. Também analisaremos um exemplo de uma solução simples para uma tarefa de integração do ponto de vista de um desenvolvedor de aplicações e veremos o que está por trás dessa simplicidade.
Isenção de responsabilidade
As soluções arquitetônicas e técnicas descritas no artigo são sugeridas com base na minha experiência pessoal no contexto de tarefas específicas. Essas soluções não reivindicam universalidade e podem não ser as mais otimais em outras condições de uso.
Qual a relação com BPM?
Para responder a essa pergunta, precisamos nos aprofundar um pouco nas especificidades das tarefas de aplicação das nossas soluções. A maior parte da lógica de negócios em nossa típica sistema transacional é a entrada de dados em um banco de dados através de interfaces de usuário, verificação manual e automatizada desses dados, encaminhamento deles por um certo workflow, publicação em outro sistema / base analítica / arquivo, e a geração de relatórios. Assim, a função chave do sistema para os clientes é a automação de seus processos de negócios internos.
Para facilitar, usamos em nossa comunicação o termo 'documento' como uma certa abstração de um conjunto de dados aglutinados por uma chave comum, à qual um determinado workflow pode ser 'atrelado'.
Mas como lidar com a lógica de integração? Afinal, a tarefa de integração é gerada pela arquitetura do sistema, que é 'dividida' em partes NÃO por demanda do cliente, mas sob a influência de fatores completamente diferentes:
- sob a influência da Lei de Conway;
- como resultado da reutilização de subsistemas desenvolvidos anteriormente para outros produtos;
- de acordo com a decisão do arquiteto, com base nos requisitos não funcionais.
Há uma grande tentação de separar a lógica de integração da lógica de negócios do fluxo de trabalho principal, a fim de não poluir a lógica de negócios com artefatos de integração e isentar o desenvolvedor de se aprofundar nas características da paisagem arquitetônica do sistema. Essa abordagem tem várias vantagens, no entanto, a prática mostra sua ineficácia:
- a solução para tarefas de integração geralmente se reduz às opções mais simples, como chamadas síncronas, devido à limitação de pontos de extensão na implementação do fluxo de trabalho principal (sobre as desvantagens da integração síncrona – mais adiante);
- artefatos de integração ainda se infiltram na lógica de negócios principal quando é necessário feedback de outro subsistema;
- o desenvolvedor ignora a integração e pode facilmente quebrá-la ao alterar o fluxo de trabalho;
- o sistema deixa de ser um todo sob a perspectiva do usuário, as "costuras" entre subsistemas tornam-se visíveis, surgem operações de usuário redundantes que iniciam a transferência de dados de um subsistema para outro.
Outra abordagem é considerar as interações de integração como parte integrante da lógica de negócios principal e do fluxo de trabalho. Para que os requisitos de qualificação dos desenvolvedores de aplicativos não se tornem excessivamente altos, a criação de novas interações de integração deve ser realizada de maneira fácil e natural, com as menores opções possíveis para a escolha do método de solução. Isso é mais complicado do que parece: a ferramenta deve ser suficientemente poderosa para oferecer ao usuário uma variedade adequada de opções de uso e, ao mesmo tempo, não permitir que ele "pise na bola". Existem muitas questões que um engenheiro deve responder no contexto das tarefas de integração, mas que não devem ser consideradas pelo desenvolvedor de aplicativos em seu trabalho cotidiano: limites de transações, consistência, atomicidade, segurança, escalabilidade, distribuição de cargas e recursos, roteamento, marshalling, propagação e troca de contextos, etc. É necessário fornecer aos desenvolvedores de aplicativos modelos de soluções suficientemente simples, nos quais já estejam escondidas as respostas para todas essas questões. Esses modelos devem ser suficientemente seguros: a lógica de negócios muda com frequência, o que aumenta os riscos de cometer erros, e o custo dos erros deve permanecer em um nível suficientemente baixo.
Mas o que BPM tem a ver com isso? Existem muitas opções de implementação de fluxo de trabalho…
De fato, em nossas soluções, outra implementação de processos de negócios é bastante popular – através da definição declarativa do diagrama de transições de estados e da conexão de manipuladores com a lógica de negócios nas transições. Nesse caso, o estado que determina a posição atual do "documento" no processo de negócios é um atributo do próprio "documento".
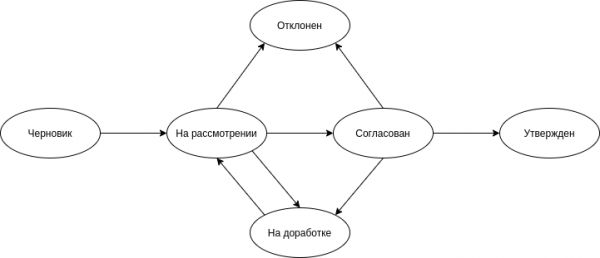
Assim começa o processo no início do projeto.
A popularidade dessa implementação se deve à relativa simplicidade e rapidez na criação de processos de negócios lineares. No entanto, à medida que os sistemas de software se tornam cada vez mais complexos, a parte automatizada do processo de negócios se expande e se torna mais complicada. Surge a necessidade de decomposição, reutilização de partes dos processos e ramificação dos processos, de modo que cada ramificação seja executada em paralelo. Nessas condições, a ferramenta se torna inconveniente, e o diagrama de transição de estados perde sua informatividade (as interações de integração não são refletidas no diagrama de forma alguma).
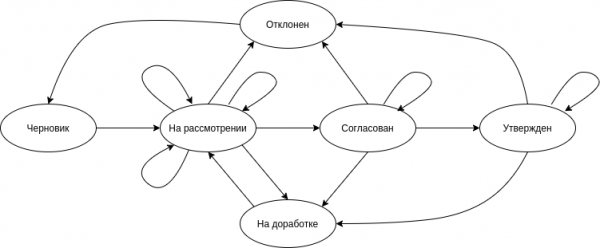
Assim é o processo após várias iterações de refinamento dos requisitos.
A saída dessa situação foi a integração do motor em alguns produtos com os processos de negócios mais complexos. A curto prazo, essa solução teve um certo sucesso: foi possível implementar processos de negócios complexos mantendo um diagrama suficientemente informativo e atual na notação .
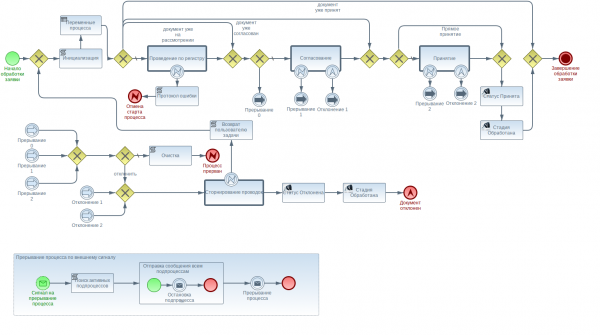
Uma pequena parte de um processo de negócios complexo.
A longo prazo, a solução não atendeu às expectativas: a alta complexidade na criação de processos de negócios por meio de ferramentas visuais não permitiu alcançar índices aceitáveis de produtividade, e a própria ferramenta se tornou uma das menos apreciadas entre os desenvolvedores. Havia também queixas sobre a estrutura interna do motor, que levaram ao surgimento de muitos "patches" e "gambiarras".
O principal aspecto positivo da aplicação do jBPM foi a compreensão dos benefícios e malefícios de se ter um estado persistente próprio da instância do processo de negócios. Também vimos a possibilidade de aplicar uma abordagem de processo para implementar protocolos complexos de integração entre diferentes aplicativos utilizando interações assíncronas por meio de sinais e mensagens. A presença de um estado persistente desempenha um papel crucial nisso.
Com base no que foi dito, podemos concluir que a abordagem de processo no estilo BPM nos permite resolver uma ampla gama de tarefas de automação de processos de negócios em constante complexidade, integrar harmoniosamente atividades de integração nesses processos e manter a possibilidade de visualização do processo implementado em uma notação adequada.
Desvantagens de chamadas síncronas como padrão de integração
Entende-se por integração síncrona uma chamada bloqueante simples. Um subsistema atua como o lado servidor e expõe uma API com o método necessário. O outro subsistema atua como o lado cliente e, no momento apropriado, executa a chamada aguardando o resultado. Dependendo da arquitetura do sistema, os lados cliente e servidor podem estar localizados no mesmo aplicativo e processo ou em diferentes. No segundo caso, é necessário aplicar alguma implementação de RPC e garantir a marshalling dos parâmetros e do resultado da chamada.
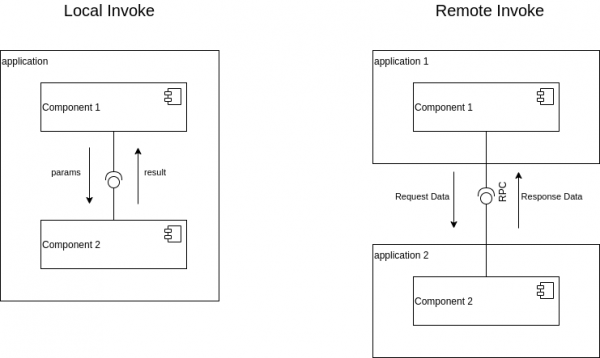
Esse padrão de integração possui um conjunto de desvantagens bastante grande, mas é amplamente utilizado na prática devido à sua simplicidade. A rapidez de implementação é atraente e faz com que seja utilizado repetidamente em condições de prazos apertados, muitas vezes registrando a solução como uma dívida técnica. No entanto, há situações em que desenvolvedores inexperientes o aplicam de maneira inconsciente, sem perceber as consequências negativas.
Além do aumento mais evidente da coesão entre subsistemas, existem também problemas menos evidentes com o "alongamento" e a "dilatação" de transações. De fato, se a lógica de negócios faz alterações, não há como evitar as transações, e essas, por sua vez, bloqueiam determinados recursos da aplicação afetados por essas alterações. Ou seja, enquanto um subsistema não receber a resposta do outro, ele não conseguirá concluir a transação e liberar os bloqueios. Isso aumenta significativamente o risco de surgirem diversos efeitos:
- a capacidade de resposta do sistema se perde, os usuários esperam longos períodos por respostas às suas solicitações;
- o servidor para de responder às requisições dos usuários devido ao esgotamento do pool de threads: a maioria das threads ficou bloqueada esperando o recurso ocupado pela transação;
- começam a surgir deadlocks: a probabilidade de sua ocorrência depende fortemente da duração das transações, da quantidade de lógica de negócios envolvida na transação e dos bloqueios;
- ocorrem erros de tempo limite da transação;
- o servidor "cai" por OutOfMemory, caso a tarefa exija o processamento e a modificação de grandes volumes de dados, e a presença de integrações síncronas dificulta bastante a divisão do processamento em transações mais "leves".
Do ponto de vista arquitetônico, o uso de chamadas bloqueantes na integração resulta na perda de controle da qualidade de subsistemas individuais: não é possível garantir os indicadores de qualidade de um subsistema sem considerar os indicadores de qualidade de outro subsistema. Se os subsistemas forem desenvolvidos por diferentes equipes, isso se torna um grande problema.
Tudo fica ainda mais interessante se os subsistemas integrados estiverem em diferentes aplicativos e for necessário fazer alterações síncronas de ambos os lados. Como garantir a transacionalidade dessas alterações?
Se as alterações forem feitas em transações separadas, será necessário garantir um tratamento confiável de exceções e compensações, o que anula completamente a principal vantagem das integrações síncronas – a simplicidade.
Uma possível solução é considerar transações distribuídas, mas não as utilizamos em nossas soluções: é difícil garantir a confiabilidade.
A 'Saga' como solução para o problema das transações
Com o aumento da popularidade dos microsserviços, a .
Este padrão resolve muito bem os problemas mencionados de transações longas e também expande as possibilidades de gerenciamento do estado do sistema por meio da lógica de negócios: a compensação após uma transação malsucedida pode não reverter o sistema para o estado original, mas fornecer um caminho alternativo para o processamento dos dados. Isso também permite evitar a repetição de etapas de processamento de dados que foram concluídas com sucesso em tentativas subsequentes para levar o processo a um final 'bom'.
Curiosamente, em sistemas monolíticos, esse padrão também é relevante quando se trata da integração de subsistemas fracamente acoplados e quando se observam efeitos negativos causados por transações longas e bloqueios de recursos correspondentes.
Aplicado aos nossos processos de negócios no estilo BPM, implementar 'Sagas' se torna muito fácil: etapas individuais da 'Saga' podem ser definidas como atividades dentro do processo de negócios, e o estado persistente do processo de negócios determina, entre outras coisas, o estado interno da 'Saga'. Ou seja, não precisamos de nenhum mecanismo de coordenação adicional. Necessitaremos apenas de um broker de mensagens com suporte a garantias de 'pelo menos uma vez' como transporte.
Mas essa solução também tem seu 'preço':
- A lógica de negócios torna-se mais complexa: é necessário trabalhar nas compensações;
- será necessário abrir mão da full consistency, o que pode ser especialmente sensível para sistemas monolíticos;
- a arquitetura se torna um pouco mais complicada, surgindo uma necessidade adicional de um broker de mensagens;
- serão necessárias ferramentas adicionais de monitoramento e administração (embora, no geral, isso seja até bom: a qualidade do serviço do sistema aumentará).
Para sistemas monolíticos, a justificativa do uso de "Saga" não é tão óbvia. Para microserviços e outras SOA, onde, provavelmente, já existe um broker, e a full consistency foi sacrificada desde o início do projeto, a vantagem de usar este padrão pode superar significativamente as desvantagens, especialmente na presença de uma API conveniente a nível de lógica de negócios.
Encapsulação da lógica de negócios em microserviços
Quando começamos a experimentar com microserviços, surgiu a pergunta razoável: onde colocar a lógica de negócios de domínio em relação ao serviço que fornece a persistência dos dados de domínio?
Ao olhar para a arquitetura de diversos BPMS, pode parecer razoável separar a lógica de negócios da persistência: criar uma camada de microserviços de plataforma e independentes de domínio, que formam o ambiente e o contêiner para executar a lógica de negócios de domínio, enquanto a persistência dos dados de domínio é tratada em uma camada separada de microserviços muito simples e leves. Os processos de negócios, nesse caso, realizam a orquestração dos serviços da camada de persistência.
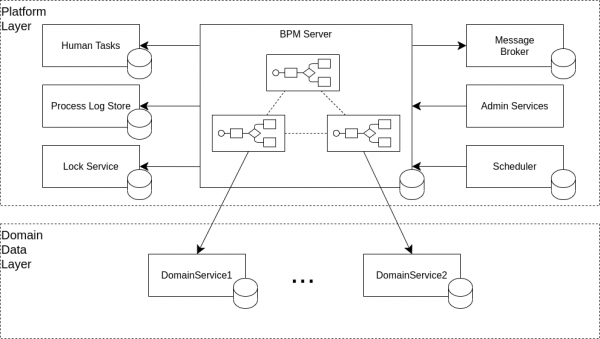
Esse abordagem tem uma grande vantagem: é possível aumentar a funcionalidade da plataforma à vontade, e a "engorda" só afetará a camada correspondente de microserviços de plataforma. Os processos de negócios de qualquer domínio imediatamente têm a possibilidade de usar a nova funcionalidade da plataforma assim que ela for atualizada.
Um estudo mais detalhado revelou desvantagens significativas dessa abordagem:
- um serviço de plataforma que executa a lógica de negócios de vários domínios traz grandes riscos como um único ponto de falha. Mudanças frequentes na lógica de negócios aumentam o risco de erros, levando a falhas que se espalham por todo o sistema;
- problemas de desempenho: a lógica de negócios opera com seus dados através de uma interface estreita e lenta:
- os dados serão processados novamente e aprimorados através da pilha de rede;
- o serviço de domínio frequentemente fornecerá mais dados do que a lógica de negócios necessita para processamento, devido a capacidades insuficientes de parametrização de solicitações a nível da API externa do serviço;
- várias partes independentes da lógica de negócios podem solicitar repetidamente os mesmos dados para processamento (é possível mitigar esse problema adicionando componentes de sessão que armazenam em cache os dados, mas isso complica ainda mais a arquitetura e cria problemas de atualidade dos dados e invalidação do cache);
- problemas de transacionalidade:
- os processos de negócios com estado persistente, cujo armazenamento é gerenciado pelo serviço de plataforma, ficarão desatualizados em relação aos dados de domínio, e não se prevê soluções simples para esse problema;
- remoção do bloqueio de dados de domínio fora da transação: se a lógica de negócios de domínio precisar fazer alterações, após verificar a precisão dos dados atuais, é necessário eliminar a possibilidade de alteração concorrente dos dados processados. O bloqueio externo de dados pode ajudar a resolver essa tarefa, mas essa solução traz riscos adicionais e reduz a confiabilidade geral do sistema;
- complexidade adicional na atualização: em alguns casos, é necessário atualizar o serviço de persistência e a lógica de negócios de forma síncrona ou em uma sequência estrita.
no final, foi necessário voltar às origens: encapsular os dados de domínio e a lógica de negócios de domínio em um único microsserviço. Essa abordagem simplifica a percepção do microsserviço como um componente coeso dentro do sistema e evita os problemas mencionados acima. Isso também não é gratuito:
- é necessária a padronização da API para interagir com a lógica de negócios (particularmente, para garantir as atividades dos usuários no contexto de processos de negócios) e das APIs dos serviços de plataforma; é necessário um maior cuidado em relação às mudanças na API, compatibilidade direta e reversa;
- é necessária a adição de bibliotecas runtime adicionais para garantir o funcionamento da lógica de negócios em cada um desses microsserviços, o que gera novas exigências para essas bibliotecas: leveza e mínimo de dependências transitivas;
- Os desenvolvedores da lógica de negócios precisam acompanhar as versões das bibliotecas: se algum microserviço não é atualizado há muito tempo, provavelmente terá uma versão desatualizada das bibliotecas. Isso pode se tornar um obstáculo inesperado para adicionar novas funcionalidades e pode exigir a migração da lógica de negócios antiga desse serviço para novas versões das bibliotecas, caso tenham ocorrido alterações incompatíveis entre as versões.
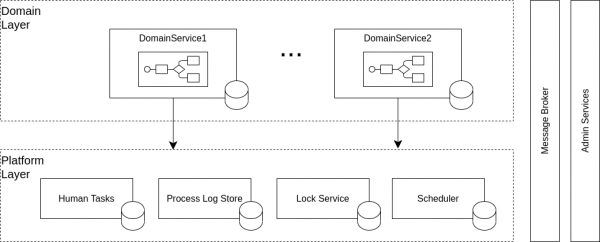
A camada de serviços de plataforma nessa arquitetura também está presente, mas essa camada não forma um contêiner para a execução da lógica de negócios do domínio, mas sim um ambiente para ela, fornecendo funções auxiliares "da plataforma". Essa camada é necessária não apenas para manter a leveza dos microserviços do domínio, mas também para centralizar a gestão.
Por exemplo, as atividades do usuário nos processos de negócios geram tarefas. No entanto, ao trabalhar com essas tarefas, o usuário deve ver tarefas de todos os domínios em uma lista geral, o que significa que deve haver um serviço de plataforma correspondente para registrar as tarefas, livre da lógica de negócios do domínio. Manter a encapsulação da lógica de negócios nesse contexto é bastante problemático, e esse é mais um compromisso dessa arquitetura.
Integração de processos de negócios sob a ótica de um desenvolvedor aplicativo
Como já mencionado, o desenvolvedor aplicativo deve estar abstraído das particularidades técnicas e de engenharia da implementação de interação entre vários aplicativos, para que se possa contar com uma boa produtividade no desenvolvimento.
Vamos tentar resolver uma tarefa de integração bastante desafiadora, especificamente criada para este artigo. Será uma tarefa "lúdica" envolvendo três aplicativos, onde cada um deles define um certo nome de domínio: "app1", "app2", "app3".
Dentro de cada aplicativo, processos de negócios são iniciados, que começam a "jogar a bola" através de um barramento de integração. Nesse caso, a bola será representada por mensagens com o nome "Ball".
Regras do jogo:
- o primeiro jogador – o инициador. Ele convida outros jogadores para a partida, inicia o jogo e pode terminá-lo a qualquer momento;
- os outros jogadores anunciam sua participação no jogo, "se apresentam" uns aos outros e ao primeiro jogador;
- ao receber a bola, o jogador escolhe outro jogador participante e passa a bola para ele. A contagem total de passes é registrada;
- cada jogador tem uma "energia" que diminui a cada passe que ele realiza. Quando sua energia se esgota, o jogador se retira do jogo, anunciando sua saída;
- se o jogador for o único restante, ele imediatamente anuncia sua saída;
- quando todos os jogadores saem, o primeiro jogador anuncia o término do jogo. Se ele já tiver saído antes, ele continua observando o jogo para finalizá-lo.
Para resolver essa tarefa, vou usar nosso DSL para processos de negócios, que permite descrever a lógica em Kotlin de forma compacta, com o mínimo de código repetido.
No aplicativo app1, o processo de negócios do primeiro jogador (que é o iniciador do jogo) será executado:
class InitialPlayer
import ru.krista.bpm.ProcessInstance
import ru.krista.bpm.runtime.ProcessImpl
import ru.krista.bpm.runtime.constraint.UniqueConstraints
import ru.krista.bpm.runtime.dsl.processModel
import ru.krista.bpm.runtime.dsl.taskOperation
import ru.krista.bpm.runtime.instance.MessageSendInstance

data class PlayerInfo(val name: String, val domain: String, val id: String)

class PlayersList : ArrayList()

// Esta é a classe exemplo do processo: encapsula seu estado interno
class InitialPlayer : ProcessImpl(initialPlayerModel) {
    var playerName: String by persistent("Player1")
    var energy: Int by persistent(30)
    var players: PlayersList by persistent(PlayersList())
    var shotCounter: Int = 0
}

// Esta é a declaração do modelo de processo: criada uma vez, usada por todos
// os exemplos do processo da classe correspondente
val initialPlayerModel = processModel(name = "InitialPlayer",
                                                     version = 1) {

    // Segundo as regras, o primeiro jogador é o iniciador do jogo e deve ser o único
    uniqueConstraint = UniqueConstraints.singleton

    // Declaramos as atividades que compõem o processo de negócios
    val sendNewGameSignal = signal("NewGame")
    val sendStopGameSignal = signal("StopGame")
    val startTask = humanTask("Start") {
        taskOperation {
            processCondition { players.size > 0 }
            confirmation { "${players.size} jogadores se conectaram. Podemos começar?" }
        }
    }
    val stopTask = humanTask("Stop") {
        taskOperation {}
    }
    val waitPlayerJoin = signalWait("PlayerJoin") { signal ->
        players.add(PlayerInfo(
                signal.data!!,
                signal.sender.domain,
                signal.sender.processInstanceId))
        println("... jogador ${signal.data} se juntou ...")
    }
    val waitPlayerOut = signalWait("PlayerOut") { signal ->
        players.remove(PlayerInfo(
                signal.data!!,
                signal.sender.domain,
                signal.sender.processInstanceId))
        println("... jogador ${signal.data} saiu ...")
    }
    val sendPlayerOut = signal("PlayerOut") {
        signalData = { playerName }
    }
    val sendHandshake = messageSend("Handshake") {
        messageData = { playerName }
        activation = {
            receiverDomain = process.players.last().domain
            receiverProcessInstanceId = process.players.last().id
        }
    }
    val throwStartBall = messageSend("Ball") {
        messageData = { 1 }
        activation = { selectNextPlayer() }
    }
    val throwBall = messageSend("Ball") {
        messageData = { shotCounter + 1 }
        activation = { selectNextPlayer() }
        onEntry { energy -= 1 }
    }
    val waitBall = messageWaitData("Ball") {
        shotCounter = it
    }

    // Agora construímos o grafo do processo a partir das atividades declaradas
    startFrom(sendNewGameSignal)
            .fork("mainFork") {
                next(startTask)
                next(waitPlayerJoin).next(sendHandshake).next(waitPlayerJoin)
                next(waitPlayerOut)
                        .branch("checkPlayers") {
                            ifTrue { players.isEmpty() }
                                    .next(sendStopGameSignal)
                                    .terminate()
                            ifElse().next(waitPlayerOut)
                        }
            }
    startTask.fork("afterStart") {
        next(throwStartBall)
                .branch("mainLoop") {
                    ifTrue { energy < 5 }.next(sendPlayerOut).next(waitBall)
                    ifElse().next(waitBall).next(throwBall).loop()
                }
        next(stopTask).next(sendStopGameSignal)
    }

    // Adicionamos manipuladores adicionais para logging nas atividades
    sendNewGameSignal.onExit { println("Vamos jogar!") }
    sendStopGameSignal.onExit { println("Parar!") }
    sendPlayerOut.onExit { println("$playerName: Eu estou fora!") }
}

private fun MessageSendInstance.selectNextPlayer() {
    val player = process.players.random()
    receiverDomain = player.domain
    receiverProcessInstanceId = player.id
    println("Passo ${process.shotCounter + 1}: " +
            "${process.playerName} >>> ${player.name}")
}
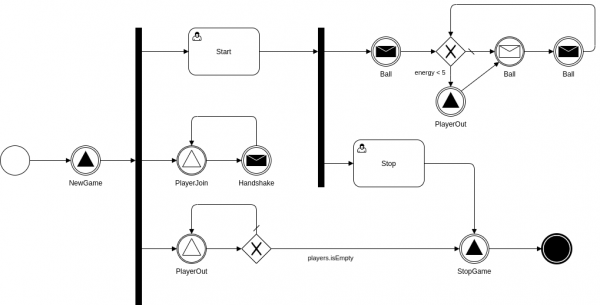
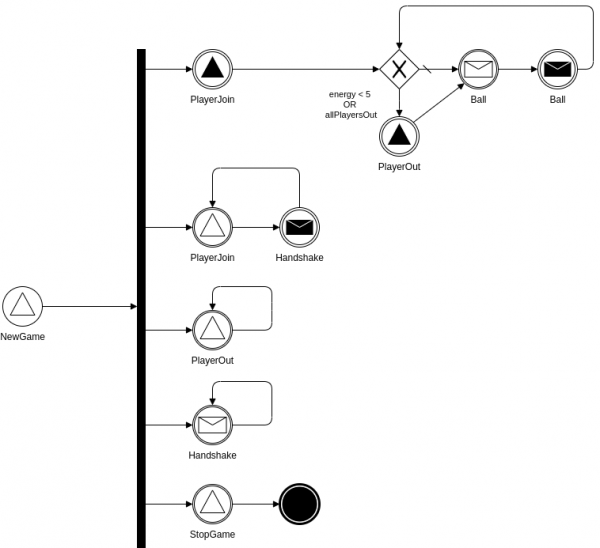
Além de executar a lógica de negócios, o código apresentado consegue fornecer um modelo de objeto do processo de negócios, que pode ser visualizado como um diagrama. O visualizador ainda não foi implementado, então tivemos que gastar um tempo desenhando (aqui eu simplifiquei um pouco a notação BPMN em relação ao uso de portas, para melhorar a consistência do diagrama com o código fornecido):
O aplicativo app2 incluirá o processo de negócios de outro jogador:
class RandomPlayer
import ru.krista.bpm.ProcessInstance
import ru.krista.bpm.runtime.ProcessImpl
import ru.krista.bpm.runtime.dsl.processModel
import ru.krista.bpm.runtime.instance.MessageSendInstance

data class PlayerInfo(val name: String, val domain: String, val id: String)

class PlayersList: ArrayList()

class RandomPlayer : ProcessImpl(randomPlayerModel) {

    var playerName: String by input(persistent = true,
                                    defaultValue = "RandomPlayer")
    var energy: Int by input(persistent = true, defaultValue = 30)
    var players: PlayersList by persistent(PlayersList())
    var allPlayersOut: Boolean by persistent(false)
    var shotCounter: Int = 0

    val selfPlayer: PlayerInfo
        get() = PlayerInfo(playerName, env.eventDispatcher.domainName, id)
}

val randomPlayerModel = processModel(name = "RandomPlayer",
                                                   version = 1) {

    val waitNewGameSignal = signalWait("NewGame")
    val waitStopGameSignal = signalWait("StopGame")
    val sendPlayerJoin = signal("PlayerJoin") {
        signalData = { playerName }
    }
    val sendPlayerOut = signal("PlayerOut") {
        signalData = { playerName }
    }
    val waitPlayerJoin = signalWaitCustom("PlayerJoin") {
        eventCondition = { signal ->
            signal.sender.processInstanceId != process.id
                && !process.players.any { signal.sender.processInstanceId == it.id}
        }
        handler = { signal ->
            players.add(PlayerInfo(
                    signal.data!!,
                    signal.sender.domain,
                    signal.sender.processInstanceId))
        }
    }
    val waitPlayerOut = signalWait("PlayerOut") { signal ->
        players.remove(PlayerInfo(
                signal.data!!,
                signal.sender.domain,
                signal.sender.processInstanceId))
        allPlayersOut = players.isEmpty()
    }
    val sendHandshake = messageSend("Handshake") {
        messageData = { playerName }
        activation = {
            receiverDomain = process.players.last().domain
            receiverProcessInstanceId = process.players.last().id
        }
    }
    val receiveHandshake = messageWait("Handshake") { message ->
        if (!players.any { message.sender.processInstanceId == it.id}) {
            players.add(PlayerInfo(
                    message.data!!,
                    message.sender.domain,
                    message.sender.processInstanceId))
        }
    }
    val throwBall = messageSend("Ball") {
        messageData = { shotCounter + 1 }
        activation = { selectNextPlayer() }
        onEntry { energy -= 1 }
    }
    val waitBall = messageWaitData("Ball") {
        shotCounter = it
    }

    startFrom(waitNewGameSignal)
            .fork("mainFork") {
                next(sendPlayerJoin)
                        .branch("mainLoop") {
                            ifTrue { energy < 5 || allPlayersOut }
                                    .next(sendPlayerOut)
                                    .next(waitBall)
                            ifElse()
                                    .next(waitBall)
                                    .next(throwBall)
                                    .loop()
                        }
                next(waitPlayerJoin).next(sendHandshake).next(waitPlayerJoin)
                next(waitPlayerOut).next(waitPlayerOut)
                next(receiveHandshake).next(receiveHandshake)
                next(waitStopGameSignal).terminate()
            }

    sendPlayerJoin.onExit { println("$playerName: Estou aqui!") }
    sendPlayerOut.onExit { println("$playerName: Estou fora!") }
}

private fun MessageSendInstance.selectNextPlayer() {
    val player = if (process.players.isNotEmpty())
        process.players.random()
    else
        process.selfPlayer
    receiverDomain = player.domain
    receiverProcessInstanceId = player.id
    println("Passo ${process.shotCounter + 1}: " +
            "${process.playerName} >>> ${player.name}")
}
Diagrama:
No aplicativo app3, faremos o jogador agir de forma um pouco diferente: em vez de escolher aleatoriamente o próximo jogador, ele seguirá um algoritmo round-robin:
class RoundRobinPlayer
import ru.krista.bpm.ProcessInstance
import ru.krista.bpm.runtime.ProcessImpl
import ru.krista.bpm.runtime.dsl.processModel
import ru.krista.bpm.runtime.instance.MessageSendInstance

data class PlayerInfo(val name: String, val domain: String, val id: String)

class PlayersList: ArrayList()

class RoundRobinPlayer : ProcessImpl(roundRobinPlayerModel) {

    var playerName: String by input(persistent = true,
                                    defaultValue = "RoundRobinPlayer")
    var energy: Int by input(persistent = true, defaultValue = 30)
    var players: PlayersList by persistent(PlayersList())
    var nextPlayerIndex: Int by persistent(-1)
    var allPlayersOut: Boolean by persistent(false)
    var shotCounter: Int = 0

    val selfPlayer: PlayerInfo
        get() = PlayerInfo(playerName, env.eventDispatcher.domainName, id)
}

val roundRobinPlayerModel = processModel(
        name = "RoundRobinPlayer",
        version = 1) {

    val waitNewGameSignal = signalWait("NewGame")
    val waitStopGameSignal = signalWait("StopGame")
    val sendPlayerJoin = signal("PlayerJoin") {
        signalData = { playerName }
    }
    val sendPlayerOut = signal("PlayerOut") {
        signalData = { playerName }
    }
    val waitPlayerJoin = signalWaitCustom("PlayerJoin") {
        eventCondition = { signal ->
            signal.sender.processInstanceId != process.id
                && !process.players.any { signal.sender.processInstanceId == it.id}
        }
        handler = { signal ->
            players.add(PlayerInfo(
                    signal.data!!,
                    signal.sender.domain,
                    signal.sender.processInstanceId))
        }
    }
    val waitPlayerOut = signalWait("PlayerOut") { signal ->
        players.remove(PlayerInfo(
                signal.data!!,
                signal.sender.domain,
                signal.sender.processInstanceId))
        allPlayersOut = players.isEmpty()
    }
    val sendHandshake = messageSend("Handshake") {
        messageData = { playerName }
        activation = {
            receiverDomain = process.players.last().domain
            receiverProcessInstanceId = process.players.last().id
        }
    }
    val receiveHandshake = messageWait("Handshake") { message ->
        if (!players.any { message.sender.processInstanceId == it.id}) {
            players.add(PlayerInfo(
                    message.data!!,
                    message.sender.domain,
                    message.sender.processInstanceId))
        }
    }
    val throwBall = messageSend("Ball") {
        messageData = { shotCounter + 1 }
        activation = { selectNextPlayer() }
        onEntry { energy -= 1 }
    }
    val waitBall = messageWaitData("Ball") {
        shotCounter = it
    }

    startFrom(waitNewGameSignal)
            .fork("mainFork") {
                next(sendPlayerJoin)
                        .branch("mainLoop") {
                            ifTrue { energy < 5 || allPlayersOut }
                                    .next(sendPlayerOut)
                                    .next(waitBall)
                            ifElse()
                                    .next(waitBall)
                                    .next(throwBall)
                                    .loop()
                        }
                next(waitPlayerJoin).next(sendHandshake).next(waitPlayerJoin)
                next(waitPlayerOut).next(waitPlayerOut)
                next(receiveHandshake).next(receiveHandshake)
                next(waitStopGameSignal).terminate()
            }

    sendPlayerJoin.onExit { println("$playerName: Estou aqui!") }
    sendPlayerOut.onExit { println("$playerName: Saí!") }
}

private fun MessageSendInstance.selectNextPlayer() {
    var idx = process.nextPlayerIndex + 1
    if (idx >= process.players.size) {
        idx = 0
    }
    process.nextPlayerIndex = idx
    val player = if (process.players.isNotEmpty())
        process.players[idx]
    else
        process.selfPlayer
    receiverDomain = player.domain
    receiverProcessInstanceId = player.id
    println("Passo ${process.shotCounter + 1}: " +
            "${process.playerName} >>> ${player.name}")
}
No restante, o comportamento do jogador não difere do anterior, portanto, o diagrama permanece o mesmo.
Agora precisamos de um teste para executar tudo isso. Vou fornecer apenas o código do teste em si, para não sobrecarregar o artigo com boilerplate (na verdade, utilizei o ambiente de teste criado anteriormente para testar a integração de outros processos de negócios):
testGame()
@Test
public void testGame() throws InterruptedException {
    String pl2 = startProcess(app2, "RandomPlayer", playerParams("Player2", 20));
    String pl3 = startProcess(app2, "RandomPlayer", playerParams("Player3", 40));
    String pl4 = startProcess(app3, "RoundRobinPlayer", playerParams("Player4", 25));
    String pl5 = startProcess(app3, "RoundRobinPlayer", playerParams("Player5", 35));
    String pl1 = startProcess(app1, "InitialPlayer");
    // Agora precisamos esperar um pouco para que os jogadores "se conheçam".
    // Esperar usando sleep é uma má solução, mas é a mais simples.
    // Não faça isso em testes sérios!
    Thread.sleep(1000);
    // Iniciando o jogo, encerrando a atividade do usuário
    assertTrue(closeTask(app1, pl1, "Start"));
    app1.getWaiting().waitProcessFinished(pl1);
    app2.getWaiting().waitProcessFinished(pl2);
    app2.getWaiting().waitProcessFinished(pl3);
    app3.getWaiting().waitProcessFinished(pl4);
    app3.getWaiting().waitProcessFinished(pl5);
}

private Map playerParams(String name, int energy) {
    Map params = new HashMap();
    params.put("playerName", name);
    params.put("energy", energy);
    return params;
}
Iniciando o teste, verificando o log:
console output
Bloqueio da chave lock://app1/process/InitialPlayer
Vamos jogar!
Desbloqueio da chave lock://app1/process/InitialPlayer
Jogador2: Estou aqui!
Jogador3: Estou aqui!
Jogador4: Estou aqui!
Jogador5: Estou aqui!
... se juntar ao jogador Jogador2 ...
... se juntar ao jogador Jogador4 ...
... se juntar ao jogador Jogador3 ...
... se juntar ao jogador Jogador5 ...
Passo 1: Jogador1 >>> Jogador3
Passo 2: Jogador3 >>> Jogador5
Passo 3: Jogador5 >>> Jogador3
Passo 4: Jogador3 >>> Jogador4
Passo 5: Jogador4 >>> Jogador3
Passo 6: Jogador3 >>> Jogador4
Passo 7: Jogador4 >>> Jogador5
Passo 8: Jogador5 >>> Jogador2
Passo 9: Jogador2 >>> Jogador5
Passo 10: Jogador5 >>> Jogador4
Passo 11: Jogador4 >>> Jogador2
Passo 12: Jogador2 >>> Jogador4
Passo 13: Jogador4 >>> Jogador1
Passo 14: Jogador1 >>> Jogador4
Passo 15: Jogador4 >>> Jogador3
Passo 16: Jogador3 >>> Jogador1
Passo 17: Jogador1 >>> Jogador2
Passo 18: Jogador2 >>> Jogador3
Passo 19: Jogador3 >>> Jogador1
Passo 20: Jogador1 >>> Jogador5
Passo 21: Jogador5 >>> Jogador1
Passo 22: Jogador1 >>> Jogador2
Passo 23: Jogador2 >>> Jogador4
Passo 24: Jogador4 >>> Jogador5
Passo 25: Jogador5 >>> Jogador3
Passo 26: Jogador3 >>> Jogador4
Passo 27: Jogador4 >>> Jogador2
Passo 28: Jogador2 >>> Jogador5
Passo 29: Jogador5 >>> Jogador2
Passo 30: Jogador2 >>> Jogador1
Passo 31: Jogador1 >>> Jogador3
Passo 32: Jogador3 >>> Jogador4
Passo 33: Jogador4 >>> Jogador1
Passo 34: Jogador1 >>> Jogador3
Passo 35: Jogador3 >>> Jogador4
Passo 36: Jogador4 >>> Jogador3
Passo 37: Jogador3 >>> Jogador2
Passo 38: Jogador2 >>> Jogador5
Passo 39: Jogador5 >>> Jogador4
Passo 40: Jogador4 >>> Jogador5
Passo 41: Jogador5 >>> Jogador1
Passo 42: Jogador1 >>> Jogador5
Passo 43: Jogador5 >>> Jogador3
Passo 44: Jogador3 >>> Jogador5
Passo 45: Jogador5 >>> Jogador2
Passo 46: Jogador2 >>> Jogador3
Passo 47: Jogador3 >>> Jogador2
Passo 48: Jogador2 >>> Jogador5
Passo 49: Jogador5 >>> Jogador4
Passo 50: Jogador4 >>> Jogador2
Passo 51: Jogador2 >>> Jogador5
Passo 52: Jogador5 >>> Jogador1
Passo 53: Jogador1 >>> Jogador5
Passo 54: Jogador5 >>> Jogador3
Passo 55: Jogador3 >>> Jogador5
Passo 56: Jogador5 >>> Jogador2
Passo 57: Jogador2 >>> Jogador1
Passo 58: Jogador1 >>> Jogador4
Passo 59: Jogador4 >>> Jogador1
Passo 60: Jogador1 >>> Jogador4
Passo 61: Jogador4 >>> Jogador3
Passo 62: Jogador3 >>> Jogador2
Passo 63: Jogador2 >>> Jogador5
Passo 64: Jogador5 >>> Jogador4
Passo 65: Jogador4 >>> Jogador5
Passo 66: Jogador5 >>> Jogador1
Passo 67: Jogador1 >>> Jogador5
Passo 68: Jogador5 >>> Jogador3
Passo 69: Jogador3 >>> Jogador4
Passo 70: Jogador4 >>> Jogador2
Passo 71: Jogador2 >>> Jogador5
Passo 72: Jogador5 >>> Jogador2
Passo 73: Jogador2 >>> Jogador1
Passo 74: Jogador1 >>> Jogador4
Passo 75: Jogador4 >>> Jogador1
Passo 76: Jogador1 >>> Jogador2
Passo 77: Jogador2 >>> Jogador5
Passo 78: Jogador5 >>> Jogador4
Passo 79: Jogador4 >>> Jogador3
Passo 80: Jogador3 >>> Jogador1
Passo 81: Jogador1 >>> Jogador5
Passo 82: Jogador5 >>> Jogador1
Passo 83: Jogador1 >>> Jogador4
Passo 84: Jogador4 >>> Jogador5
Passo 85: Jogador5 >>> Jogador3
Passo 86: Jogador3 >>> Jogador5
Passo 87: Jogador5 >>> Jogador2
Passo 88: Jogador2 >>> Jogador3
Jogador2: Estou fora!
Passo 89: Jogador3 >>> Jogador4
... jogador Jogador2 está fora ...
Passo 90: Jogador4 >>> Jogador1
Passo 91: Jogador1 >>> Jogador3
Passo 92: Jogador3 >>> Jogador1
Passo 93: Jogador1 >>> Jogador4
Passo 94: Jogador4 >>> Jogador3
Passo 95: Jogador3 >>> Jogador5
Passo 96: Jogador5 >>> Jogador1
Passo 97: Jogador1 >>> Jogador5
Passo 98: Jogador5 >>> Jogador3
Passo 99: Jogador3 >>> Jogador5
Passo 100: Jogador5 >>> Jogador4
Passo 101: Jogador4 >>> Jogador5
Jogador4: Estou fora!
... jogador Jogador4 está fora ...
Passo 102: Jogador5 >>> Jogador1
Passo 103: Jogador1 >>> Jogador3
Passo 104: Jogador3 >>> Jogador1
Passo 105: Jogador1 >>> Jogador3
Passo 106: Jogador3 >>> Jogador5
Passo 107: Jogador5 >>> Jogador3
Passo 108: Jogador3 >>> Jogador1
Passo 109: Jogador1 >>> Jogador3
Passo 110: Jogador3 >>> Jogador5
Passo 111: Jogador5 >>> Jogador1
Passo 112: Jogador1 >>> Jogador3
Passo 113: Jogador3 >>> Jogador5
Passo 114: Jogador5 >>> Jogador3
Passo 115: Jogador3 >>> Jogador1
Passo 116: Jogador1 >>> Jogador3
Passo 117: Jogador3 >>> Jogador5
Passo 118: Jogador5 >>> Jogador1
Passo 119: Jogador1 >>> Jogador3
Passo 120: Jogador3 >>> Jogador5
Passo 121: Jogador5 >>> Jogador3
Jogador5: Estou fora!
... jogador Jogador5 está fora ...
Passo 122: Jogador3 >>> Jogador5
Passo 123: Jogador5 >>> Jogador1
Jogador5: Estou fora!
Passo 124: Jogador1 >>> Jogador3
... jogador Jogador5 está fora ...
Passo 125: Jogador3 >>> Jogador1
Passo 126: Jogador1 >>> Jogador3
Jogador1: Estou fora!
... jogador Jogador1 está fora ...
Passo 127: Jogador3 >>> Jogador3
Jogador3: Estou fora!
Passo 128: Jogador3 >>> Jogador3
... jogador Jogador3 está fora ...
Jogador3: Estou fora!
Pare!
Passo 129: Jogador3 >>> Jogador3
Jogador3: Estou fora!
A partir disso, podemos fazer algumas conclusões importantes:
- com as ferramentas necessárias, os desenvolvedores aplicados podem criar interações de integração entre aplicativos sem se afastar da lógica de negócios;
- a complexidade da tarefa de integração, que exige competências de engenharia, pode ser oculta dentro do framework, se for inicialmente incorporada na arquitetura do mesmo. A dificuldade da tarefa não pode ser escondida, por isso, a solução de uma tarefa difícil no código terá uma aparência correspondente;
- ao desenvolver a lógica de integração, é essencial considerar a consistência eventual e a ausência de linearidade nas mudanças de estado de todos os participantes da integração. Isso leva a uma lógica mais complexa, a fim de torná-la insensível à ordem em que os eventos externos ocorrem. No nosso exemplo, o jogador deve participar do jogo apenas após declarar sua saída: outros jogadores continuarão a passar a bola para ele até que a informação sobre sua saída chegue e seja processada por todos os participantes. Essa lógica não decorre das regras do jogo e é uma solução de compromisso dentro da arquitetura escolhida.
Em seguida, falaremos sobre várias sutilezas da nossa solução, compromissos e outros aspectos.
Todas as mensagens – em uma única fila
Todos os aplicativos integrados trabalham com um único barramento de integração, que é apresentado na forma de um broker externo, uma fila BPMQueue – para mensagens e um tópico BPMTopic – para sinais (eventos). Passar todas as mensagens por uma única fila é, por si só, um compromisso. No nível da lógica de negócios, agora é possível introduzir quantos novos tipos de mensagens forem necessários, sem alterar a estrutura do sistema. Isso é uma simplificação significativa, mas traz certos riscos que, no contexto das nossas tarefas típicas, nos pareceram não tão significativos.
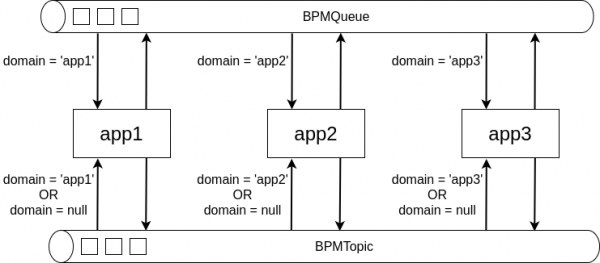
No entanto, aqui há um detalhe: cada aplicativo filtra suas próprias mensagens da fila desde a entrada, com base no nome de seu domínio. O domínio também pode ser especificado nos sinais, caso seja necessário limitar a "visibilidade" do sinal a um único aplicativo. Isso deve aumentar a capacidade da bus, mas a lógica de negócios agora deve operar com nomes de domínio: para endereçamento de mensagens – é obrigatório, para sinais – é desejável.
Garantindo a confiabilidade da bus de integração
A confiabilidade é composta por vários fatores:
- o corretor de mensagens escolhido é um componente crítico da arquitetura e um único ponto de falha: ele deve ser suficientemente tolerante a falhas. Apenas implementações comprovadas ao longo do tempo, com bom suporte e uma grande comunidade, devem ser utilizadas;
- é necessário garantir alta disponibilidade do corretor de mensagens, para o que ele deve estar fisicamente separado dos aplicativos integrados (garantir alta disponibilidade de aplicativos com lógica de negócios aplicada é significativamente mais complexo e caro);
- o corretor deve garantir a entrega "pelo menos uma vez". Este é um requisito obrigatório para o funcionamento confiável da bus de integração. Não há necessidade de garantias de nível "exatamente uma vez": os processos de negócios geralmente não são sensíveis à recepção repetida de mensagens ou eventos, e em tarefas especiais, onde isso é importante, é mais fácil adicionar uma verificação adicional na lógica de negócios do que usar continuamente garantias bastante "caras";
- o envio de mensagens e sinais deve ser incluído em uma transação geral com alterações no estado dos processos de negócios e dados de domínio. A opção preferencial será o uso do padrão , mas isso exigirá uma tabela adicional no banco de dados e um retransmissor. Em aplicativos JEE, esse aspecto pode ser simplificado utilizando um gerenciador JTA local, mas a conexão com o corretor escolhido deve ser capaz de operar no modo ;
- os manipuladores de mensagens e eventos recebidos também devem trabalhar com a transação de alteração do estado do processo de negócios: se tal transação for revertida, o recebimento da mensagem também deve ser cancelado;
- as mensagens que não puderam ser entregues devido a erros devem ser armazenadas em um repositório separado (Dead Letter Queue). Para isso, criamos um microserviço de plataforma separado, que armazena essas mensagens em seu repositório, as indexa por atributos (para agrupamento e busca rápida) e disponibiliza uma API para visualização, reenvio ao destino e exclusão de mensagens. Os administradores do sistema podem interagir com esse serviço através de sua interface web;
- nas configurações do broker, é necessário ajustar o número de tentativas de entrega e o intervalo entre as entregas, a fim de reduzir a probabilidade de mensagens irem para a DLQ (calcular os parâmetros ideais é praticamente impossível, mas é possível agir empiricamente e ajustá-los ao longo da operação);
- o armazenamento da DLQ deve ser monitorado continuamente, e o sistema de monitoramento deve alertar os administradores do sistema para que, ao surgirem mensagens não entregues, possam responder o mais rápido possível. Isso ajudará a reduzir a 'zona de impacto' do erro ou falha na lógica de negócios;
- o barramento de integração deve ser insensível à ausência temporária de aplicativos: as assinaturas para o tópico devem ser duráveis e o nome do aplicativo deve ser único, para que, durante a ausência do aplicativo, suas mensagens na fila não sejam processadas por outra pessoa.
Garantindo que a lógica de negócios seja thread-safe
O mesmo exemplo de processo de negócios pode receber várias mensagens e eventos simultaneamente, com o processamento iniciando em paralelo. Ao mesmo tempo, para o desenvolvedor de aplicativos, tudo deve ser simples e thread-safe.
A lógica de negócios do processo trata cada evento externo que afeta este processo de negócios separadamente. Esses eventos podem incluir:
- a inicialização de um exemplo de processo de negócios;
- uma ação do usuário relacionada à atividade dentro do processo de negócios;
- o recebimento de uma mensagem ou sinal ao qual o exemplo de processo de negócios está inscrito;
- o acionamento de um temporizador configurado pelo exemplo de processo de negócios;
- uma intervenção de controle através de API (por exemplo, uma interrupção de emergência do processo).
Cada evento como esse pode alterar o estado da instância do processo de negócios: algumas atividades podem ser concluídas e outras iniciadas, e os valores das propriedades persistentes podem mudar. O fechamento de qualquer atividade pode levar à ativação de uma ou mais atividades subsequentes. Estas, por sua vez, podem parar à espera de outros eventos ou, se não precisarem de dados adicionais, podem ser concluídas na mesma transação. Antes de fechar a transação, o novo estado do processo de negócios é salvo no banco de dados, onde aguardará a ocorrência do próximo evento externo.
Os dados persistentes do processo de negócios, salvos em um banco de dados relacional, representam um ponto muito conveniente de sincronização do processamento, se usarmos SELECT FOR UPDATE. Se uma transação conseguiu obter o estado do processo de negócios do banco para modificación, então nenhuma outra transação poderá obter esse mesmo estado simultaneamente para outra modificação, e após a conclusão da primeira transação, a segunda receberá garantidamente o estado já modificado.
Ao usar bloqueios pessimistas do lado do SGBD, estamos atendendo a todos os requisitos necessários , além de preservar a capacidade de escalar o aplicativo com a lógica de negócios aumentando o número de instâncias em execução.
No entanto, os bloqueios pessimistas nos colocam em risco de deadlocks, e portanto, é prudente limitar o SELECT FOR UPDATE a um tempo limite razoável caso deadlocks ocorram em certos casos críticos da lógica de negócios.
Outro problema é a sincronização do início do processo de negócios. Enquanto não houver uma instância do processo de negócios, seu estado também não estará no banco, portanto, o método descrito não será adequado. Se for necessário garantir a singularidade da instância do processo de negócios em um escopo específico, será necessário algum objeto de sincronização, associado à classe do processo e ao escopo correspondente. Para resolver esse problema, usamos um mecanismo diferente de bloqueios que permite obter um bloqueio de um recurso arbitrário, definido por uma chave no formato URI, através de um serviço externo.
Em nossos exemplos, o processo de negócios InitialPlayer contém a declaração
uniqueConstraint = UniqueConstraints.singletonPortanto, o log contém mensagens sobre a aquisição e liberação do bloqueio da chave correspondente. Não há mensagens semelhantes para outros processos de negócios: uniqueConstraint não está definido.
Problemas com processos de negócios de estado persistente
Às vezes, ter um estado persistente não apenas ajuda, mas também dificulta muito o desenvolvimento.
Os problemas começam quando é necessário fazer alterações na lógica de negócios e/ou no modelo de processo de negócios. Nem toda alteração é compatível com o antigo estado dos processos de negócios. Se houver muitos instantes "ativos" no banco de dados, implementar alterações incompatíveis pode causar muitos problemas, que frequentemente enfrentamos ao usar jBPM.
Dependendo da profundidade das alterações, pode-se seguir dois caminhos:
- criar um novo tipo de processo de negócios para evitar fazer alterações incompatíveis no antigo e usá-lo em vez do antigo ao iniciar novas instâncias. As instâncias antigas continuarão operando "como antes";
- migrar o estado persistente dos processos de negócios ao atualizar a lógica de negócios.
O primeiro caminho é mais simples, mas tem suas limitações e desvantagens, como:
- duplicação da lógica de negócios em muitos modelos de processo de negócios, aumentando o volume da lógica de negócios;
- frequentemente é necessário uma transição instantânea para a nova lógica de negócios (especialmente em tarefas de integração – quase sempre);
- o desenvolvedor não sabe em que momento pode remover os modelos obsoletos.
Na prática, usamos ambos os métodos, mas tomamos uma série de decisões para facilitar nossa vida:
- no banco de dados, o estado persistente do processo de negócios é salvo em um formato JSON que é fácil de ler e processar. Isso permite que migrações sejam feitas tanto dentro do aplicativo quanto externas. Em casos extremos, pode até ser ajustado manualmente (especialmente útil no desenvolvimento durante a depuração);
- a lógica de negócios de integração não usa nomes de processos de negócios para que a qualquer momento seja possível substituir a implementação de um dos processos participantes por uma nova, com um novo nome (por exemplo, "InitialPlayerV2"). O vínculo ocorre através de nomes de mensagens e sinais;
- O modelo de processo tem um número de versão, que aumentamos se fizermos alterações incompatíveis nesse modelo, e esse número é mantido junto com o estado da instância do processo;
- O estado persistente do processo é lido do banco de dados primeiro em um modelo de objeto conveniente, que a procedure de migração pode trabalhar, se o número da versão do modelo mudou;
- A procedure de migração é colocada ao lado da lógica de negócios e é chamada "preguiçosamente" para cada instância do processo de negócios no momento de sua recuperação do banco de dados;
- Se for necessário migrar o estado de todas as instâncias do processo de forma rápida e síncrona, são aplicadas soluções mais clássicas de migração de banco de dados, mas isso exige trabalhar com JSON.
É necessário mais um framework para processos de negócios?
As soluções descritas no artigo nos permitiram simplificar significativamente nosso trabalho, ampliar o escopo de questões abordadas no nível de desenvolvimento de aplicativos e tornar as ideias de separar a lógica de negócios em microsserviços mais atraentes. Para isso, muito trabalho foi feito, e um framework "leve" para processos de negócios foi criado, assim como componentes utilitários para resolver os problemas mencionados no contexto de uma ampla gama de tarefas de aplicativos. Temos a intenção de compartilhar esses resultados, tornando a criação de componentes comuns de código aberto sob uma licença livre. Isso exigirá esforços e tempo. Compreender a demanda por tais soluções poderia se tornar um estímulo adicional para nós. O artigo proposto dedica muito pouca atenção às capacidades do próprio framework, mas algumas delas são visíveis nos exemplos apresentados. Se decidirmos publicar nosso framework, dedicaremos um artigo separado a ele. Enquanto isso, ficaremos gratos se você nos deixar um breve feedback, respondendo à pergunta:
Apenas usuários registrados podem participar da pesquisa. , por favor.
É necessário mais um framework para processos de negócios?
18,8%Sim, estamos procurando algo assim há muito tempo.
12,5%Estou curioso para saber mais sobre sua implementação, pode ser útil.
6,2%Estamos usando um dos frameworks existentes, mas estamos pensando em uma substituição.
18,8%Estamos usando um dos frameworks existentes, tudo está bom.
18,8%Estamos conseguindo sem framework.
25,0%Estamos escrevendo o nosso.
16 usuários votaram. 7 usuários se abstiveram.
Fonte: habr.com
