

A apresentação aborda questões práticas sobre o desenvolvimento de operadores no Kubernetes, o projeto de sua arquitetura e os principais princípios de funcionamento.
Na primeira parte da apresentação, abordaremos:
- o que é um operador no Kubernetes e para que serve;
- como um operador simplifica a gestão de sistemas complexos;
- o que um operador pode e o que não pode fazer.
Em seguida, vamos discutir a estrutura interna do operador. Analisaremos a arquitetura e o funcionamento do operador passo a passo. Vamos detalhar:
- a interação entre o operador e o Kubernetes;
- quais funções o operador assume e quais delega ao Kubernetes.
Vamos revisar a gestão de shards e réplicas de bancos de dados no Kubernetes.
Em seguida, vamos discutir questões de armazenamento de dados:
- como trabalhar com Persistent Storage do ponto de vista do operador;
- os desafios de usar Local Storage.
Na parte final da apresentação, examinaremos exemplos práticos de aplicação na Amazon ou Google Cloud Service. A apresentação é baseada na experiência de desenvolvimento e operação de um operador para ClickHouse.
Vídeo:
Meu nome é Vladislav Klimenko. Hoje, gostaria de compartilhar nossa experiência no desenvolvimento e operação de um operador, que é um operador especializado para gerenciar clusters de bancos de dados. Usaremos como exemplo para gerenciar o cluster de ClickHouse.
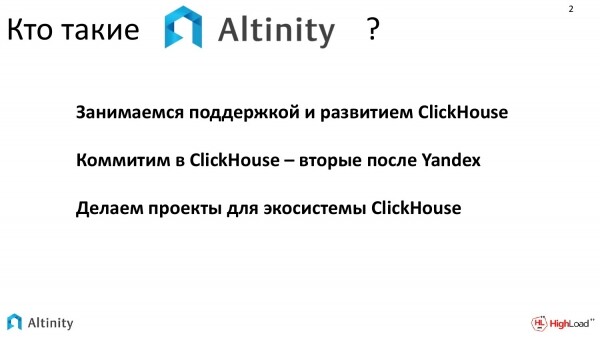
Por que temos a oportunidade de falar sobre o operador e o ClickHouse?
- Estamos envolvidos no suporte e desenvolvimento do ClickHouse.
- Atualmente, estamos tentando contribuir gradualmente para o desenvolvimento do ClickHouse. E somos os segundos após o Yandex em termos de mudanças feitas no ClickHouse.
- Temos buscado fazer projetos adicionais para o ecossistema ClickHouse.
Sobre um desses projetos, gostaria de falar. É sobre o ClickHouse-operator para Kubernetes.
Na minha apresentação, quero abordar dois temas:
- O primeiro tema é como nosso operador para gerenciar bancos de dados ClickHouse funciona no Kubernetes.
- O segundo tema é como qualquer operador funciona, ou seja, como ele interage com o Kubernetes.
Essas duas questões se cruzarão ao longo de toda a minha apresentação.
Quem estaria interessado em ouvir o que estou tentando compartilhar?
- Será mais interessante para aqueles que operam operadores.
- Ou para aqueles que desejam criar seu próprio operador para entender como ele funciona internamente, como o operador interage com o Kubernetes e quais desafios podem surgir.
Para entender melhor o que vamos discutir hoje, seria bom saber como funciona o Kubernetes e ter uma formação básica em tecnologias de nuvem.
O que é o ClickHouse? É um banco de dados orientado a colunas, especializado em processar consultas analíticas em tempo real. E é completamente open source.
E precisamos saber apenas duas coisas. É preciso entender que é um banco de dados, então o que vou explicar será aplicável praticamente a qualquer banco de dados. E que o SGBD ClickHouse escala muito bem, oferecendo escalabilidade praticamente linear. Portanto, o estado do cluster é um estado natural para o ClickHouse. E o que mais nos interessa discutir é como gerenciar um cluster ClickHouse no Kubernetes.
Por que ele é necessário lá? Por que não podemos continuar a operá-lo de forma independente? As respostas são parcialmente técnicas e parcialmente organizacionais.
- Na prática, encontramos cada vez mais situações em que, em grandes empresas, praticamente todos os componentes já estão no Kubernetes. As bases de dados permanecem fora.
- E frequentemente surge a questão: “É possível colocá-las lá dentro?”. Portanto, grandes empresas se esforçam para criar a máxima unificação de gerenciamento, a fim de ter rapidamente a capacidade de gerenciar seus repositórios de dados.
- E isso ajuda especialmente quando é necessária a máxima possibilidade de replicar a mesma coisa em um novo local, ou seja, máxima portabilidade.
Quão simples ou difícil isso é? É claro que pode ser feito manualmente. Mas não é tão simples, porque somamos a complexidade de gerenciar o próprio Kubernetes, e ainda há as especificidades do ClickHouse. E assim resulta em uma agregação.
E tudo isso resulta em um conjunto considerável de tecnologias, cuja gestão se torna bastante complicada, pois o Kubernetes traz suas questões cotidianas para a operação, enquanto o ClickHouse traz suas questões para a operação diária. Especialmente se tivermos vários ClickHouse e precisarmos constantemente trabalhar com eles.
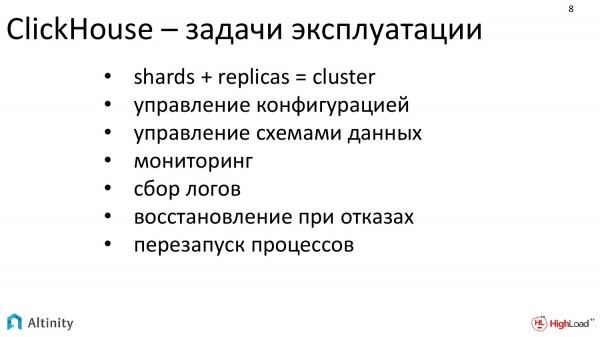
No ClickHouse, ao ter uma configuração dinâmica, existem várias questões que geram uma carga constante para o DevOps:
- Quando queremos mudar algo no ClickHouse, como adicionar uma réplica ou shard, precisamos gerenciar a configuração.
- Depois, é necessário alterar o esquema de dados, pois o ClickHouse tem uma maneira específica de sharding. É preciso organizar o esquema de dados e as configurações.
- É necessário configurar a monitorização.
- Coleta de logs para novos shards e novas réplicas.
- Preocupar-se com a recuperação.
- E com o reinício.
Essas são tarefas rotineiras que gostaríamos muito de facilitar na operação.
O Kubernetes ajuda bastante na operação, mas nas questões básicas do sistema.
O Kubernetes facilita e automatiza tais tarefas como:
- Recuperação.
- Reinício.
- Gerenciamento do sistema de armazenamento.
Isso é bom, é a direção certa, mas ele não tem uma compreensão completa de como operar um cluster de banco de dados.
Queremos mais, gostaríamos que todo o nosso banco de dados funcionasse no Kubernetes.
Gostaríamos de ter algo como um grande botão mágico vermelho, que você pressiona e tem um cluster que se despliega e é mantido durante todo o ciclo de vida, lidando com tarefas diárias que precisam ser resolvidas. Um cluster ClickHouse no Kubernetes.
E nós nos esforçamos para criar uma solução que ajude a facilitar o trabalho. Este é o ClickHouse-operator para Kubernetes da empresa Altinity.
O operador é um programa cuja principal função é gerenciar outros programas, ou seja, é um gestor.
E ele contém modelos de comportamento. Pode-se chamar isso de conhecimentos codificados sobre a área.
E sua principal tarefa é facilitar a vida do DevOps e reduzir o micromanagement, para que ele (DevOps) pense em termos de alto nível, ou seja, que ele (DevOps) não se preocupe com o micromanagement e não precise ajustar todos os detalhes manualmente.
E justamente o operador é um assistente robô que lida com microtarefas e ajuda o DevOps.
Por que precisamos do operador? Ele se destaca especialmente em duas questões:
- Quando o especialista que trabalha com ClickHouse não tem experiência suficiente, mas já é necessário operar o ClickHouse, o operador facilita a operação e permite gerenciar um cluster ClickHouse com uma configuração bastante complexa, sem precisar entrar em detalhes sobre como tudo funciona por dentro. Basta dar-lhe tarefas de alto nível e isso funciona.
- E a segunda tarefa, na qual ele se destaca, é quando é necessário automatizar uma grande quantidade de tarefas padrão. Remove microtarefas dos administradores de sistema.
Isso é mais útil para aqueles que estão apenas começando sua jornada ou para aqueles que precisam se dedicar muito à automação.
Qual é a diferença entre a abordagem baseada em operadores e outros sistemas? Existe o Helm. Ele também ajuda a instalar o ClickHouse, é possível desenhar gráficos do helm que até montam um cluster completo de ClickHouse. Então, qual é a diferença entre um operador e, por exemplo, o Helm?
A principal diferença fundamental é que o Helm é um gerenciador de pacotes, enquanto o operador vai além. Ele abrange todo o ciclo de vida. Não é apenas instalação, mas tarefas diárias que incluem escalonamento, sharding, ou seja, tudo o que precisa ser feito durante o ciclo de vida (se necessário, até desinstalação) – tudo isso é resolvido pelo operador. Ele tenta automatizar e manter todo o ciclo de vida do software. Essa é sua diferença fundamental em relação a outras soluções disponíveis.
Essa foi a parte introdutória, vamos seguir em frente.
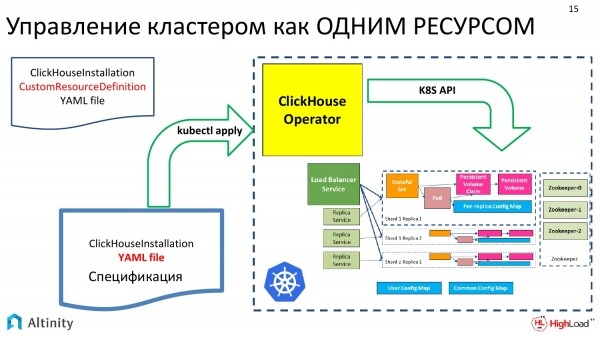
Como construímos nosso operador? Tentamos abordar a questão de gerenciar o cluster de ClickHouse como um único recurso.
Aqui temos, na parte esquerda da imagem, os dados de entrada. É um YAML com a especificação do cluster, que é passado de maneira clássica através do kubectl para o Kubernetes. Lá, nosso operador captura, faz sua mágica. E no final, temos este esquema. Esta é a implementação do ClickHouse no Kubernetes.
E prosseguiremos vendo lentamente como o operador realmente funciona, quais tarefas padrão podem ser resolvidas. Vamos nos concentrar apenas nas tarefas padrão, pois temos tempo limitado. E não será abordado tudo o que o operador pode resolver.
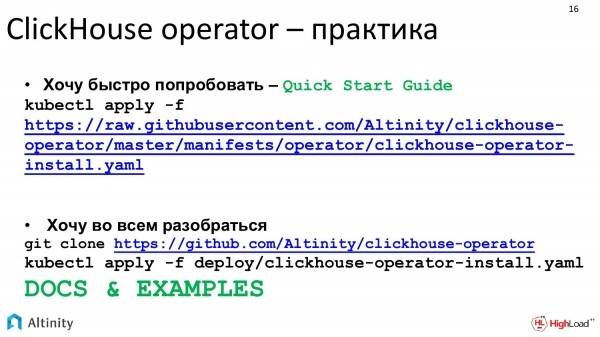
Vamos nos basear na prática. Nosso projeto é totalmente open source, então você pode ver no GitHub como ele funciona. E pode considerar que, se quiser apenas iniciar, com o Guia Rápido é possível começar.
Se você quiser se aprofundar, tentamos manter a documentação em um estado mais ou menos decente.
Vamos começar com uma tarefa prática. A primeira tarefa, com a qual todos queremos começar, é executar o primeiro exemplo de alguma forma. Como executar o ClickHouse usando um operador, mesmo sem saber muito bem como ele funciona? Escrevemos um manifesto, já que toda a comunicação com o k8s acontece através de manifestos.
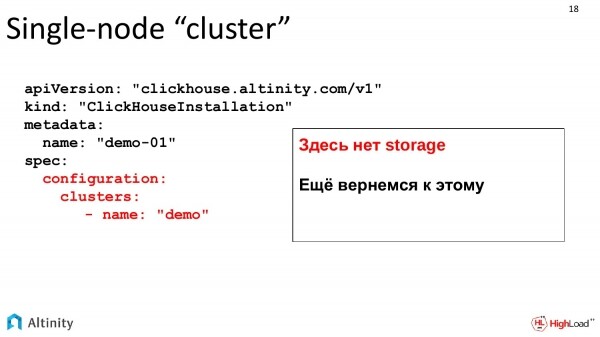
Aqui está um manifesto complexo. O que está destacado em vermelho é o que precisamos enfatizar. Estamos pedindo ao operador para criar um cluster chamado demo.
Por enquanto, esses são exemplos básicos. O armazenamento ainda não está descrito, mas voltaremos a ele um pouco mais tarde. Por enquanto, estaremos observando o desenvolvimento do cluster em tempo real.
Criamos este manifesto. Enviamos para o nosso operador. Ele trabalhou e fez sua mágica.
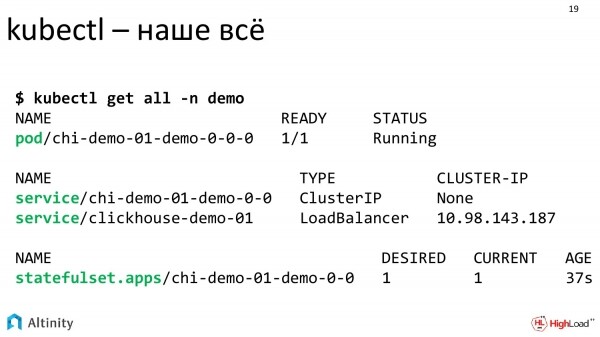
Olhamos no console. Três componentes despertam nosso interesse – o Pod, dois Services e o StatefulSet.
O operador executou e podemos ver o que exatamente ele criou.
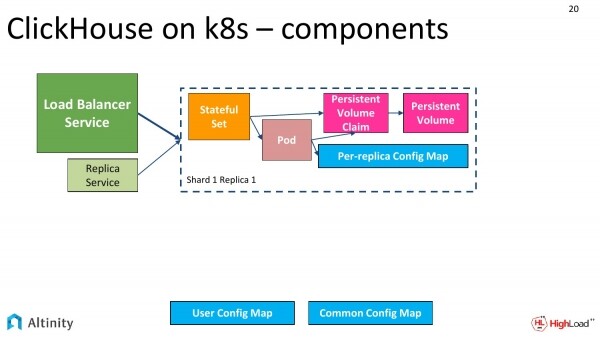
Ele cria um esquema semelhante a este. Temos um StatefulSet, um Pod, um ConfigMap para cada réplica e um ConfigMap para todo o cluster. É imprescindível ter serviços como pontos de entrada para o cluster.
Os serviços consistem em um Load Balancer Service central e mais um para cada réplica, para cada shard.
Aqui está como nosso cluster básico se parece. Ele é composto por um único nó.
Vamos em frente, vamos complicar as coisas. Precisamos shardizar o cluster.
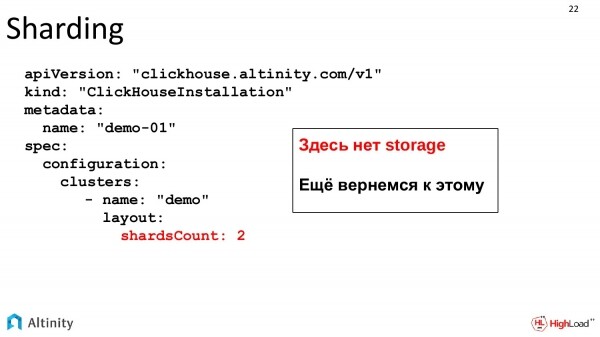
Nossas demandas estão crescendo, a dinâmica começa. Queremos adicionar um shard. Acompanhemos o desenvolvimento. Alteramos nossa especificação. Estamos indicando que queremos dois shards.
Esse é o mesmo arquivo que se desenvolve dinamicamente com o crescimento do sistema. O armazenamento ainda não está incluído, mas será abordado mais adiante, é um tópico à parte.
Enviamos o operador YAML e vemos o que acontece.
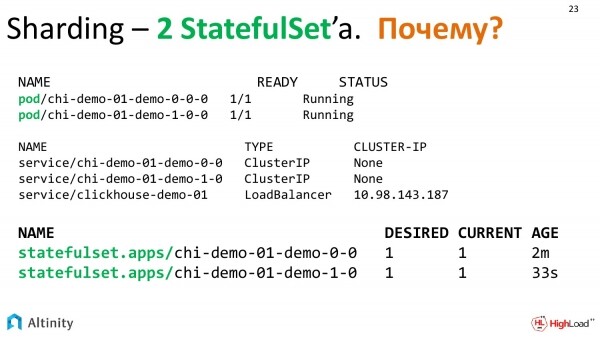
O operador pensou e criou as seguintes entidades. Já temos dois Pods, três Services e, repentinamente, dois StatefulSets. Por que dois StatefulSets?
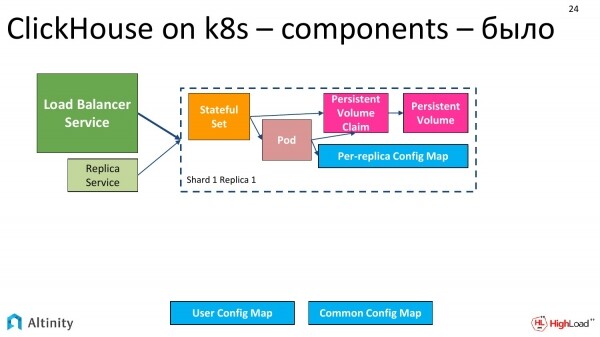
Na representação estava assim – esse é nosso estado inicial, quando tínhamos um pod.
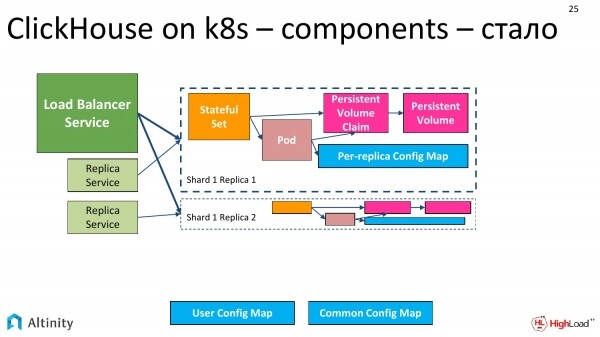
Ficou assim. Até agora tudo é simples, foi duplicado.
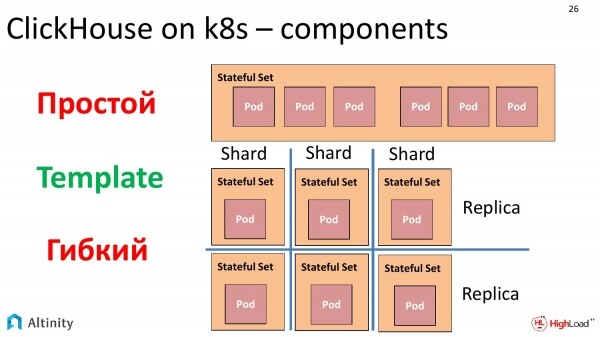
E por que o StatefulSet se tornou dois? Aqui precisamos desviar um pouco e discutir como a gestão de Pods ocorre no Kubernetes.
Há um objeto chamado StatefulSet, que permite criar um conjunto de Pods a partir de um modelo. O fator chave aqui é o Template. E é possível executar muitos Pods de um único template em um StatefulSet. E a frase chave aqui é 'muitos Pods de um único template'.
Houve uma grande tentação de criar todo o cluster, encapsulando tudo em um único StatefulSet. Isso funcionaria, não há problemas quanto a isso. Mas há um detalhe. Se quisermos montar um cluster heterogêneo, ou seja, com várias versões do ClickHouse, então surgem questões. Sim, o StatefulSet pode realizar atualizações contínuas (rolling updates) e é possível aplicar uma nova versão, ressaltando que não devemos tentar atualizar mais do que um certo número de nós ao mesmo tempo.
Mas se extrapolarmos a tarefa e dissermos que queremos fazer um cluster completamente heterogêneo e não queremos simplesmente mudar da versão antiga para a nova através de uma atualização contínua, mas queremos criar um cluster heterogêneo tanto em termos de diferentes versões do ClickHouse quanto em termos de diferentes storages. Queremos, por exemplo, fazer algumas réplicas em discos separados, em discos lentos, construindo, de maneira geral, um cluster completamente heterogêneo. E devido ao fato de que o StatefulSet cria uma solução padronizada a partir de um único modelo, não é possível fazer isso.
Depois de alguma reflexão, foi tomada a decisão de fazer assim. Cada réplica estará em seu próprio StatefulSet. Existem algumas desvantagens nessa solução, mas na prática isso encapsula completamente o operador. E há muitas vantagens. Podemos construir um cluster exatamente como desejamos, por exemplo, absolutamente heterogêneo. Portanto, em um cluster onde temos dois shards com uma réplica cada, teremos 2 StatefulSets e 2 Pods justamente porque escolhemos essa abordagem devido às razões mencionadas acima para possibilitar a construção de um cluster heterogêneo.
Vamos voltar às tarefas práticas. Precisamos configurar usuários em nosso cluster, ou seja, precisamos realizar alguma configuração do ClickHouse no Kubernetes. O operador oferece todas as possibilidades para isso.
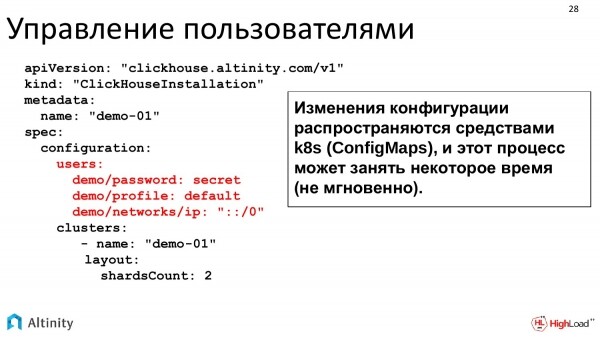
Podemos escrever diretamente no YAML o que queremos. Todas as opções de configuração mapeiam diretamente desse YAML para as configurações do ClickHouse, que depois são distribuídas por todo o cluster.
Também podemos escrever assim. Isso é apenas um exemplo. A senha pode ser criptografada. Todas as opções de configuração do ClickHouse são absolutamente suportadas. Aqui é apenas um exemplo.
A configuração do cluster é disseminada como ConfigMap. Na prática, a atualização do ConfigMap não acontece instantaneamente, portanto, se for um cluster grande, o processo de propagação da configuração leva algum tempo. Mas tudo isso é muito conveniente na prática.
Estamos complicando a tarefa. O cluster está se desenvolvendo. Queremos replicar dados. Ou seja, já temos dois shards, cada um com uma réplica, os usuários estão configurados. Estamos crescendo e queremos trabalhar com replicação.
O que precisamos para replicação?
Precisamos do ZooKeeper. No ClickHouse, a replicação é construída utilizando o ZooKeeper. O ZooKeeper é necessário para que várias réplicas do ClickHouse cheguem a um consenso sobre quais blocos de dados estão em qual ClickHouse.
Qualquer ZooKeeper pode ser utilizado. Se a empresa tiver um ZooKeeper externo, ele pode ser utilizado. Caso contrário, é possível instalar a partir do nosso repositório. Existe um instalador que facilita tudo isso.
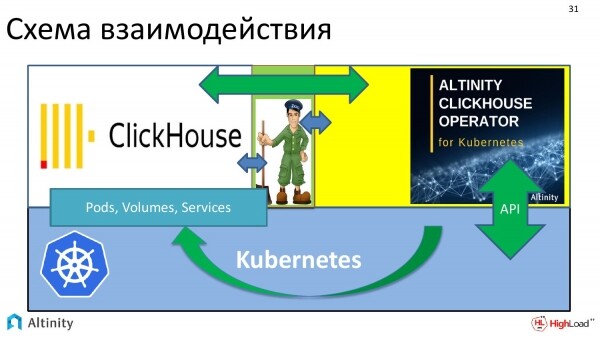
E o esquema de interação de todo o sistema fica assim. Temos o Kubernetes como plataforma. Nela, é executado o operador do ClickHouse. O ZooKeeper está representado aqui. E o operador interage tanto com o ClickHouse quanto com o ZooKeeper. Ou seja, temos uma interação.
E tudo isso é necessário para que o ClickHouse consiga replicar dados com sucesso no k8s.
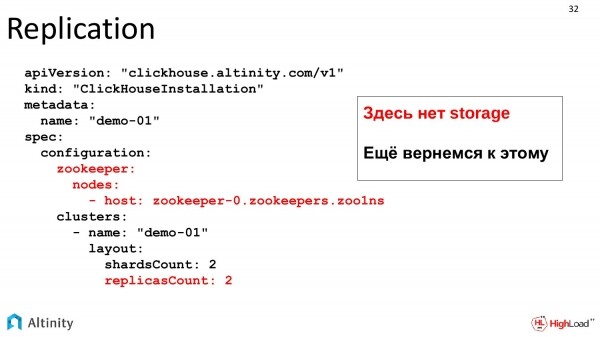
Agora vamos analisar a tarefa em si, como será o manifesto para a replicação.
Adicionamos duas seções ao nosso manifesto. A primeira indica de onde obter o ZooKeeper, que pode ser tanto interno ao Kubernetes quanto externo. Isso é apenas uma descrição. E solicitamos as réplicas. Ou seja, queremos duas réplicas. No total, devemos ter 4 pods. Sobre o armazenamento, devemos lembrar, ele voltará um pouco mais adiante. Armazenamento é uma história à parte.
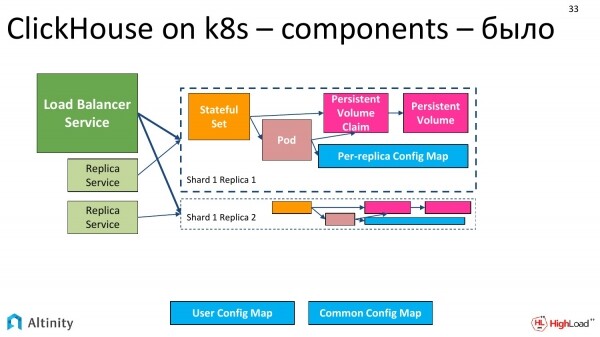
Era assim.
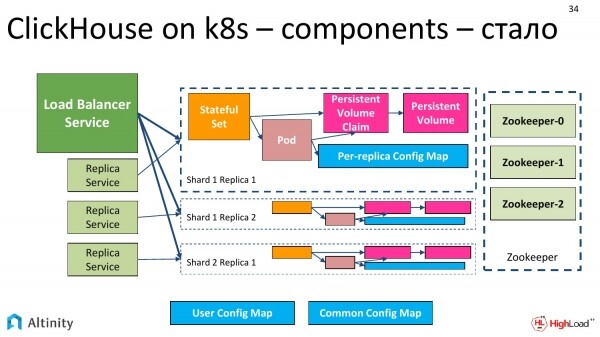
Fica assim. As réplicas são adicionadas. A quarta não coube, acreditamos que pode haver muitas. E ao lado é adicionado o ZooKeeper. Os esquemas estão se tornando mais complexos.
E chegou a hora de adicionar a próxima tarefa. Vamos adicionar Armazenamento Persistente.
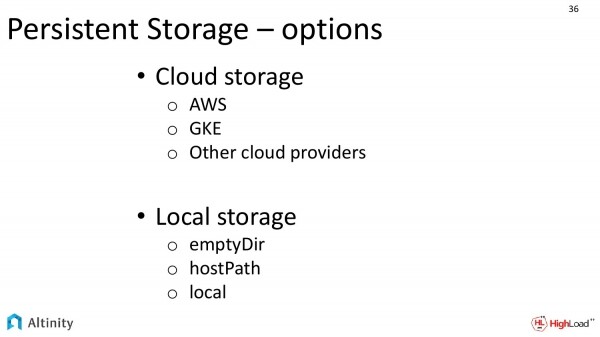 Temos várias opções para Armazenamento Persistente.
Caso estejamos operando em um provedor de nuvem, como Amazon ou Google, há uma grande tentação de utilizar armazenamento em nuvem. É muito conveniente, é uma boa opção.
E há uma segunda opção. É para armazenamento local, quando temos discos locais em cada nó. Esta opção é muito mais complexa de implementar, mas, ao mesmo tempo, é mais eficiente.
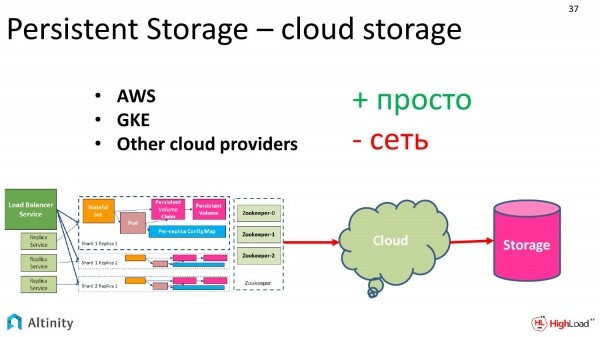
Vamos analisar o que temos em relação ao armazenamento em nuvem.
Existem vantagens. É muito simples de configurar. Basta solicitar ao provedor de nuvem que forneça um armazenamento de determinada capacidade e classe. As classes são detalhadas pelos próprios provedores.
E há uma desvantagem. Para algumas pessoas, isso não é uma desvantagem crítica. Claro, haverá algumas limitações de desempenho. É muito conveniente para o trabalho, confiável, mas existem algumas potenciais quedas de desempenho.
E como o ClickHouse se concentra exatamente no desempenho, pode-se até dizer que extrai tudo o que é possível, portanto muitos clientes tentam maximizar o desempenho.
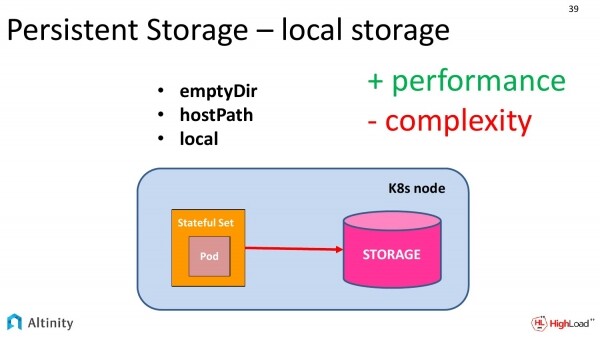
E para extrair o máximo, precisamos de armazenamento local.
O Kubernetes fornece três abstrações para o uso de armazenamento local no Kubernetes. São:
- EmptyDir
- HostPath.
- Local
Vamos considerar como eles diferem e em que são semelhantes.
Primeiro, em todas as três abordagens, nosso armazenamento é composto por discos locais, que estão na mesma nó física do k8s. Mas eles têm algumas diferenças.
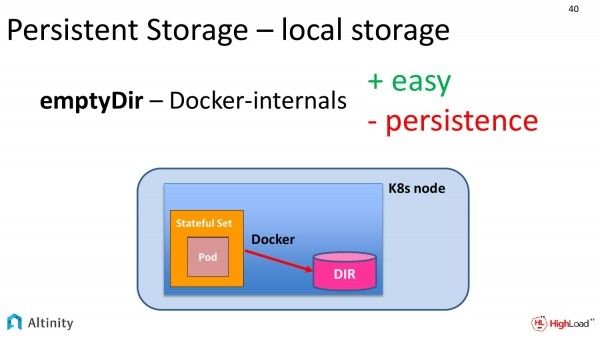
Começaremos com o mais simples, ou seja, com o emptyDir. O que é isso na prática? É quando pedimos ao nosso sistema de especificação que o sistema de contêiner (na maioria das vezes, isso é o Docker) nos forneça acesso a uma pasta no disco local.
Na prática, o Docker cria temporariamente uma pasta em seus próprios caminhos, chamando-a de um longo hash. E fornece uma interface de acesso a ela.
Como isso funcionará em termos de desempenho? Funcionará na velocidade do disco local, ou seja, é acesso total ao seu disco.
Mas esse método tem sua desvantagem. O Persistent é um tanto duvidoso nesse caso. Na primeira movimentação dos contêineres pelo Docker, o Persistent se perde. Se o Kubernetes quiser, por algum motivo, mover esse Pod para outro disco, os dados serão perdidos.
Essa abordagem é boa para testes, pois já apresenta uma velocidade normal, mas para algo sério, essa opção não é adequada.
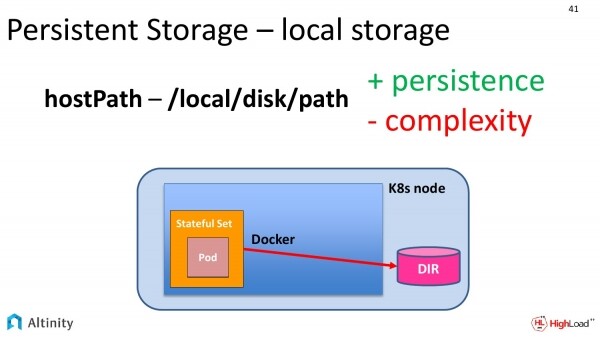
Portanto, há uma segunda abordagem. É o hostPath. Se olharmos o slide anterior e este, podemos ver uma única diferença. Temos a pasta saindo do Docker diretamente para o nó do Kubernetes. Aqui é um pouco mais simples. Definimos diretamente o caminho no sistema de arquivos local onde gostaríamos de armazenar nossos dados.
Os benefícios desse método existem. Agora temos um verdadeiro Persistent, e é clássico. Os dados serão gravados em um endereço específico no disco.
Há também desvantagens. A complexidade de gerenciamento. Nosso Kubernetes pode querer mover um Pod para outro nó físico. E é aqui que o DevOps entra em ação. Ele deve explicar corretamente a todo o sistema que esses pods só podem ser movidos para nós nos quais você tem algo montado nesses caminhos, e não mais de um nó por vez. Isso é bastante complicado.
Para esses fins, nós, como operadores, criamos modelos para ocultar toda essa complexidade. E poderíamos simplesmente dizer: 'Eu quero que haja uma instância do ClickHouse em cada nó físico e neste caminho específico.'
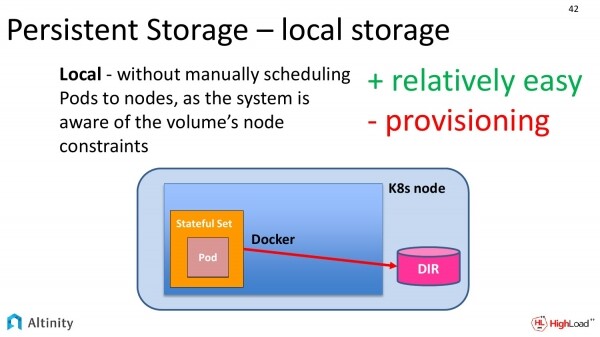
Mas essa necessidade não é só nossa, portanto, os senhores do próprio Kubernetes também entendem que as pessoas gostariam de ter acesso a discos físicos, por isso eles fornecem um terceiro nível.
Ele é chamado de local. Não há praticamente nenhuma diferença em relação ao slide anterior. Antes, era necessário fazer manualmente, que não podemos mover esses pods de um nó para outro, porque eles devem estar ligados a um disco físico local em tal caminho, e agora todo esse conhecimento é encapsulado no próprio Kubernetes. E fica muito mais fácil configurar.
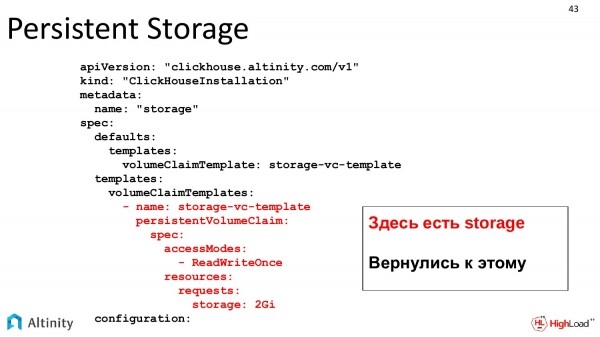
Voltemos à nossa tarefa prática. Vamos voltar ao modelo YAML. Aqui temos um verdadeiro storage. Nós retornamos a isso. Definimos um clássico modelo de VolumeClaim como no k8s. E descrevemos qual storage queremos.
Após isso, o k8s solicitará o storage. Ele nos alocará dentro do StatefulSet. E, no final, isso ficará à disposição do ClickHouse.
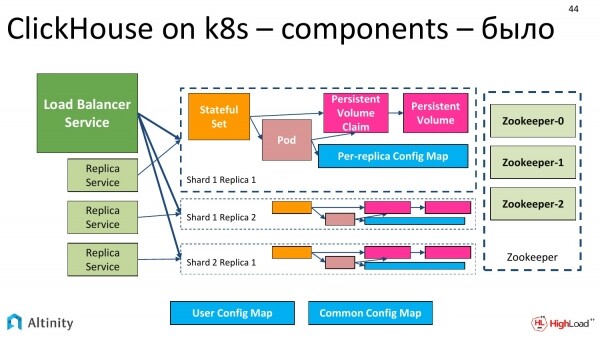
Tínhamos esse esquema. Nosso Persistent Storage estava em vermelho, o que sugeria que deveria ser feito.
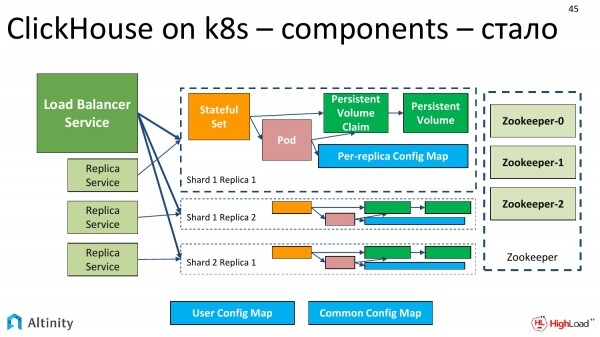
E ele fica verde. Agora o esquema do cluster ClickHouse no k8s está completamente finalizado. Temos shards, réplicas, ZooKeeper, há um verdadeiro Persistent, que é implementado de uma forma ou de outra. O esquema já está totalmente funcional.
Continuamos vivendo. Nosso cluster está se desenvolvendo. E Alexey se esforça e lança uma nova versão do ClickHouse.
Surge uma tarefa prática – testar a nova versão do ClickHouse em nosso cluster. E, naturalmente, não queremos atualizar tudo, queremos talvez colocar uma nova versão em uma réplica em um canto distante, ou talvez não uma nova versão, mas duas de uma vez, pois elas saem com frequência.
O que podemos dizer sobre isso?
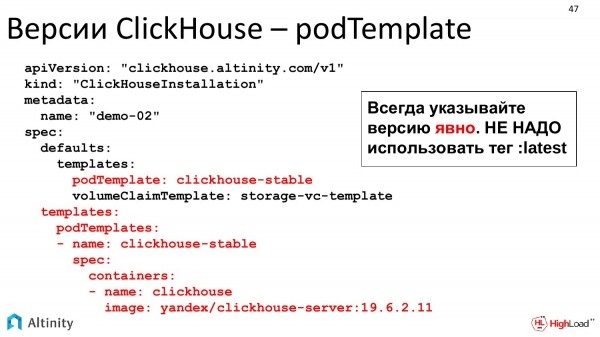
Aqui temos exatamente essa oportunidade. São os templates de pods. Podemos detalhar, nosso operador permite construir um cluster heterogêneo. Ou seja, podemos configurar desde todas as réplicas em conjunto até cada réplica individual, definindo qual versão do ClickHouse desejamos e qual versão de armazenamento. Podemos configurar completamente o cluster da maneira que precisamos.
Vamos nos aprofundar um pouco mais. Antes, falamos sobre como o ClickHouse-operator funciona em relação às especificidades do ClickHouse.
Agora, gostaria de dizer algumas palavras sobre como qualquer operador funciona e como interage com o K8s.
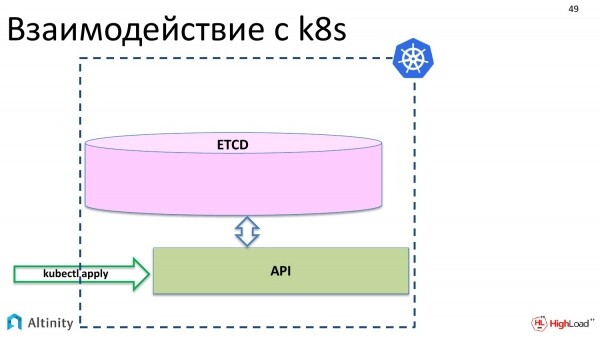
Vamos considerar a interação com o K8s primeiramente. O que acontece quando fazemos kubectl apply? Nossos objetos aparecem em etcd através da API.
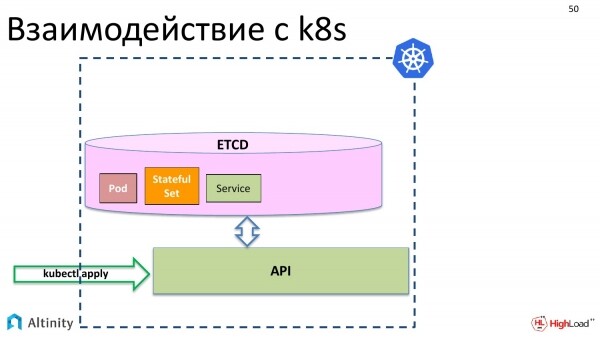
Por exemplo, os objetos básicos do Kubernetes: pod, StatefulSet, service e assim por diante.
Neste momento, nada físico acontece ainda. Esses objetos precisam ser materializados no cluster.
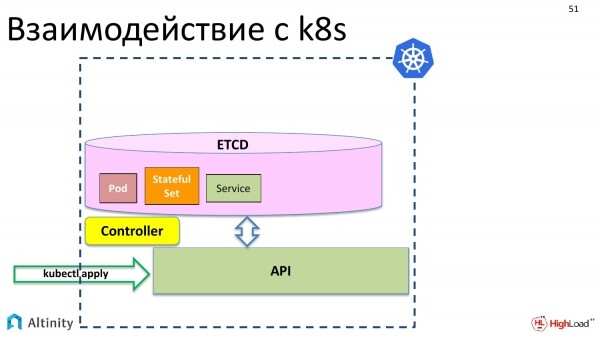
Para isso, aparece o controlador. O controlador é um componente especial do k8s que consegue materializar essas descrições. Ele sabe como e o que deve ser feito fisicamente. Ele sabe como iniciar contêineres e o que deve ser configurado para que o servidor funcione.
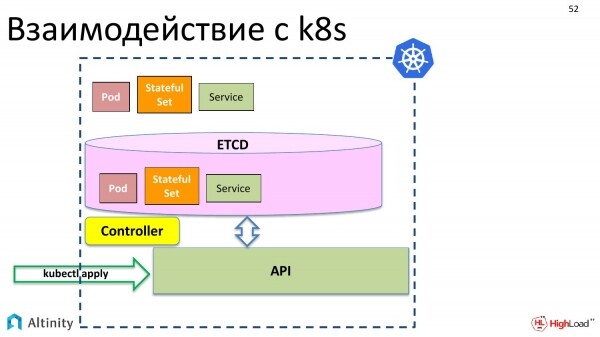
E ele materializa nossos objetos no K8s.
Mas queremos operar não apenas com pods e StatefulSets, queremos criar ClickHouseInstallation, ou seja, um objeto do tipo ClickHouse, para operá-lo como um todo. Até agora, essa possibilidade não existe.
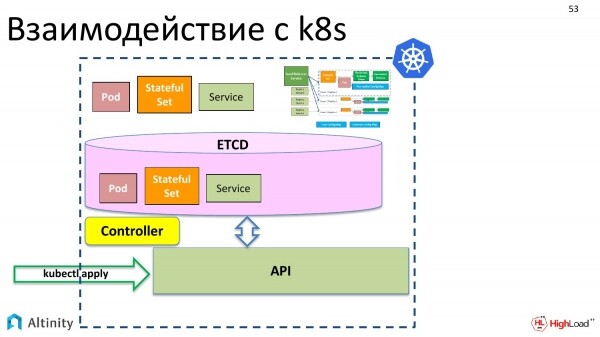
Mas o K8s tem uma outra coisa agradável. Queremos que exista uma entidade complexa, que seja composta de pods e StatefulSets do nosso cluster.
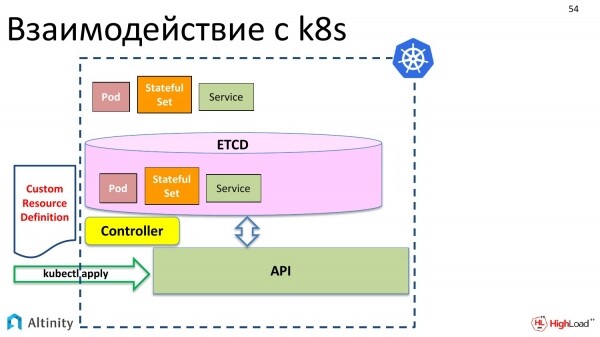
E o que é necessário para isso? Primeiro, surge a Custom Resource Definition. O que é isso? É uma descrição para o K8s que informa que você terá mais um tipo de dado, que queremos adicionar um recurso personalizado ao pod, StatefulSet, que será complexo internamente. É uma descrição da estrutura de dados.
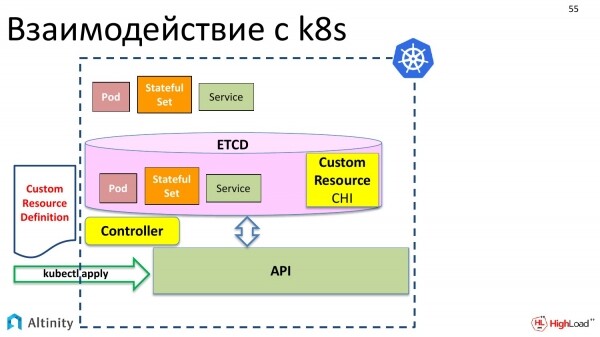
Também o enviamos para lá através do kubectl apply. O Kubernetes o aceitou com prazer.
E agora temos, no armazenamento, a possibilidade de registrar um recurso personalizado chamado ClickHouseInstallation no objeto em etcd.
Mas até agora, nada mais acontecerá. Ou seja, se criarmos agora um arquivo YAML, que discutimos contendo a descrição de shards, réplicas e dissermos 'kubectl apply', o Kubernetes o aceitará, colocará no etcd e dirá: 'Ótimo, mas não sei o que fazer com isso. Não sei como gerenciar ClickHouseInstallation.'
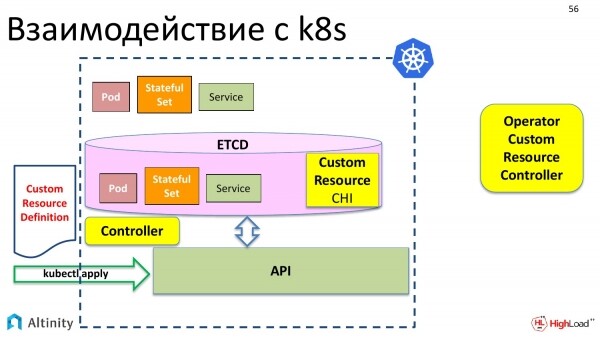
Portanto, precisamos de alguém que ajude o Kubernetes a gerenciar um novo tipo de dados. À esquerda, temos o controlador padrão do Kubernetes, que trabalha com tipos de dados padrão. E à direita, devemos ter um controlador personalizado, que pode lidar com tipos de dados personalizados.
E de outra forma, ele é chamado de operador. Eu o destaquei aqui fora do Kubernetes, porque ele pode ser executado fora do K8s. Na maioria das vezes, claro, todos os operadores são executados no Kubernetes, mas nada impede que ele funcione fora, por isso foi especificamente destacado aqui.
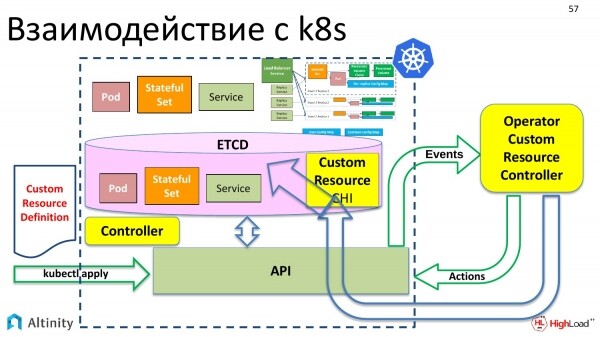
E, por sua vez, o controlador personalizado, também conhecido como operador, interage com o Kubernetes através da API. Ele já sabe como interagir com a API. E ele já sabe como materializar um esquema complexo a partir do recurso personalizado que queremos criar. É exatamente isso que o operador faz.
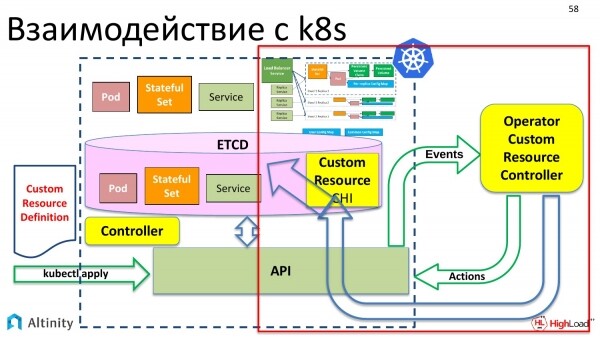
Como funciona o operador? Vamos dar uma olhada na parte direita, para entender como ele faz isso. Descobriremos como o operador materializa tudo isso e como a interação com o K8s acontece a seguir.
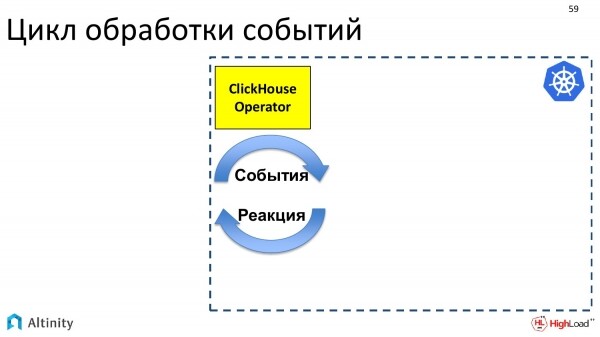
O operador é um programa. Ele é orientado a eventos. O operador, através da API do Kubernetes, se inscreve em eventos. Na API do Kubernetes, existem pontos de entrada onde você pode se inscrever em eventos. E se algo mudar no K8s, o Kubernetes enviará eventos a todos que quiserem, ou seja, quem se inscreveu naquele ponto da API receberá notificações.
O operador se inscreve em eventos e deve fazer alguma reação. Sua tarefa é reagir a eventos que surgem.
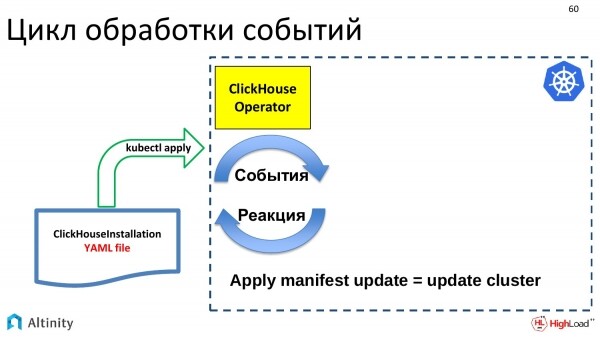
Os eventos são gerados por algumas atualizações. Chega nosso arquivo YAML com a descrição do ClickHouseInstallation. Ele foi para o etcd através do kubectl apply. Lá, um evento foi acionado, e esse evento chegou ao ClickHouse-operator. O operador recebeu essa descrição. E ele deve fazer algo. Se uma atualização para o objeto ClickHouseInstallation chegou, então é necessário atualizar o cluster. E a tarefa do operador é atualizar o cluster.
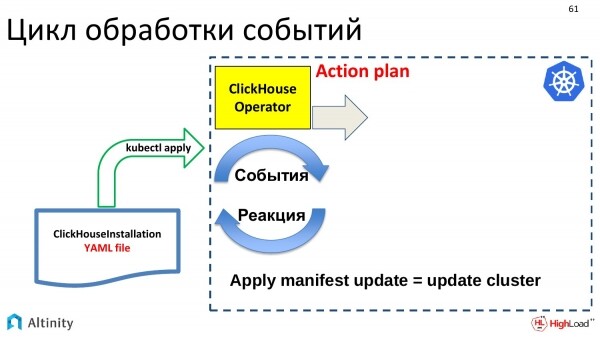
O que ele faz? Primeiro, é necessário elaborar um plano de ação sobre o que faremos com essa atualização. As atualizações podem ser muito pequenas, ou seja, pequenas na execução do YAML, mas podem resultar em mudanças muito grandes no cluster. Portanto, o operador cria um plano e o segue.
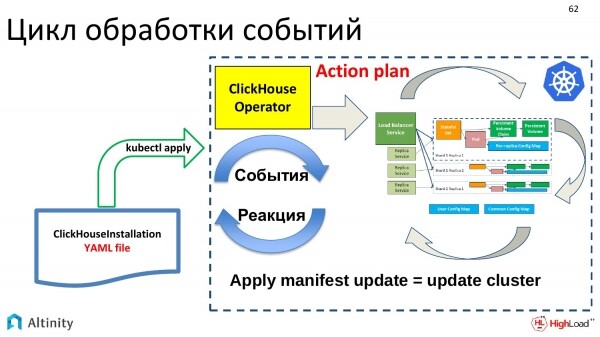
Ele começa a trabalhar de acordo com esse plano, para construir essa estrutura internamente, a fim de materializar pods, serviços, ou seja, fazer o que é sua tarefa principal. Isso é como construir um cluster ClickHouse no Kubernetes.
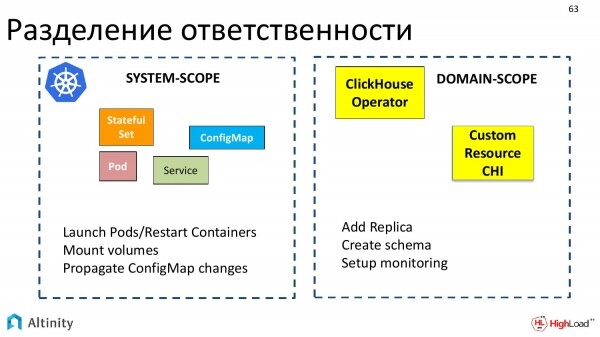
Agora, vamos abordar algo interessante. Esta é a divisão de responsabilidades entre o Kubernetes e o operador, ou seja, o que o Kubernetes faz, o que o operador faz e como eles interagem entre si.
O Kubernetes é responsável pelas coisas do sistema, ou seja, pelo conjunto básico de objetos que pode ser interpretado como de escopo sistêmico. O Kubernetes sabe como iniciar pods, reiniciar contêineres, fazer o mount de volumes, trabalhar com ConfigMap, ou seja, tudo que pode ser chamado de sistema.
Os operadores operam em áreas temáticas. Cada operador é feito para sua área temática. Nós fizemos um para o ClickHouse.
E o operador interage precisamente em termos da área temática, como adicionar uma réplica, criar um esquema, configurar monitoração. Há, portanto, essa divisão.
Vamos considerar um exemplo prático de como essa divisão de responsabilidades ocorre quando realizamos a ação de adicionar uma réplica.
O operador recebe a tarefa de adicionar uma réplica. O que o operador faz? O operador calculará que é necessário criar um novo StatefulSet, no qual é preciso descrever determinados modelos, volume claim.
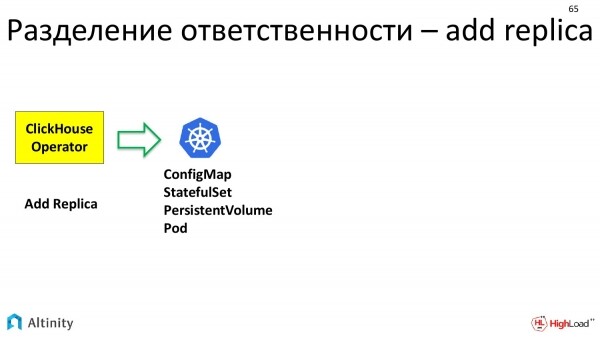
Ele preparou tudo isso e passa adiante para o K8s. Diz que precisa de ConfigMap, StatefulSet, Volume. O Kubernetes processa. Ele materializa as unidades básicas com as quais opera.
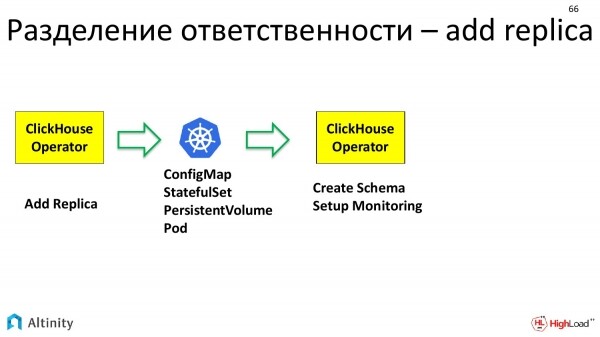
E em seguida, entra em ação novamente o ClickHouse-operator. Ele já tem um pod físico, no qual já é possível fazer algo. E o ClickHouse-operator novamente trabalha em termos da área temática. Ou seja, para incluir uma réplica no cluster, é necessário, primeiro, configurar o esquema de dados que existe nesse cluster. E, em segundo lugar, essa réplica deve ser incluída na monitoração, para que seja bem rastreada. Já é o operador que configura isso.
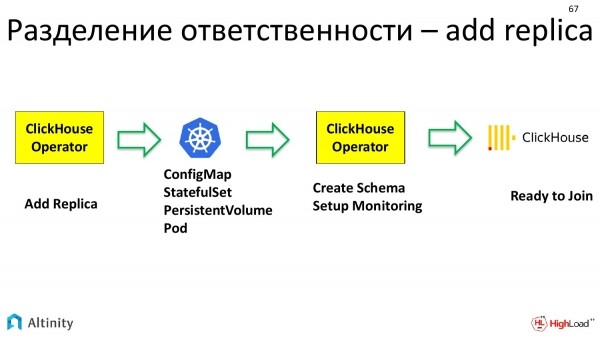
E somente depois disso é que o próprio ClickHouse entra em cena, ou seja, mais uma entidade de nível superior. Isso já é um banco de dados. Ele possui sua própria instância, uma réplica configurada, pronta para entrar no cluster.
Consequentemente, a cadeia de execução e divisão de responsabilidades ao adicionar uma réplica é bastante longa.
Vamos continuar com nossas tarefas práticas. Se o cluster já existe, é possível realizar a migração da configuração.
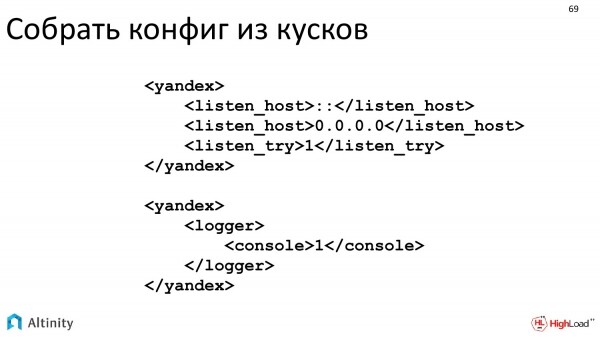
Fizemos de modo que no XML existente, que o ClickHouse entende, se possa passar adiante.
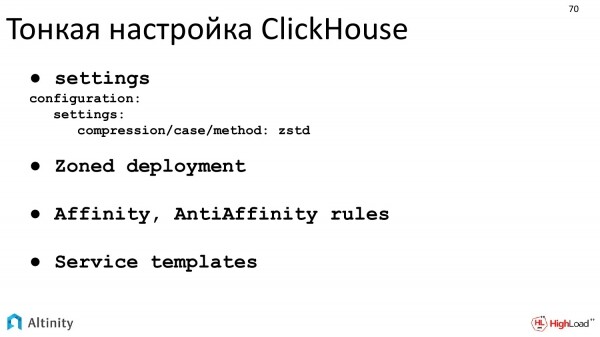
É possível fazer um ajuste fino do ClickHouse. O deployment zonado é exatamente o que eu mencionei ao explicar o hostPath e o armazenamento local. É como fazer corretamente um deployment zonado.
A próxima tarefa prática é o monitoramento.
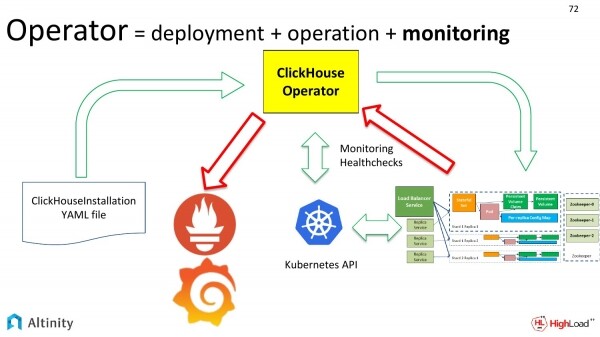
Se temos alteração no cluster, precisamos configurar o monitoramento periodicamente.
Vamos analisar o diagrama. Já revisamos as setas verdes. Agora vamos considerar as setas vermelhas. Isso mostra como queremos monitorar nosso cluster. Como as métricas do cluster ClickHouse vão para o Prometheus e depois para o Grafana.
E qual é a dificuldade com o monitoramento? Por que isso é considerado uma conquista? A dificuldade está na dinâmica. Quando temos um único cluster e ele é estático, é possível configurar o monitoramento uma vez e depois não se preocupar mais com isso.
Mas se temos muitos clusters ou se algo está constantemente mudando, o processo é dinâmico. E estar sempre configurando o monitoramento novamente consome recursos e tempo, ou seja, é um trabalho que pode ser tedioso. Isso precisa ser automatizado. A dificuldade realmente está na dinâmica do processo. E o operador consegue automatizar isso muito bem.
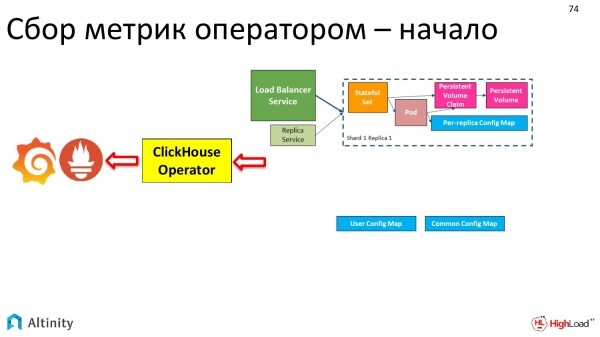
Como o nosso cluster se desenvolveu? No início ele era assim.
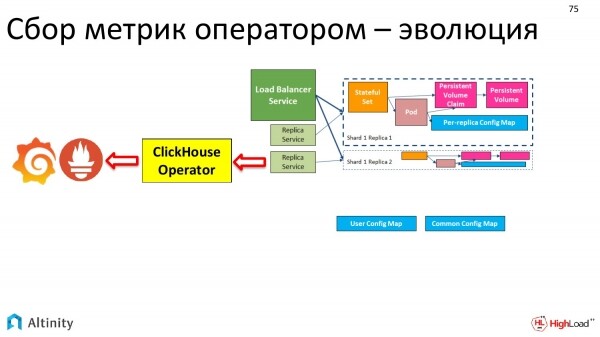
Depois ele ficou assim.
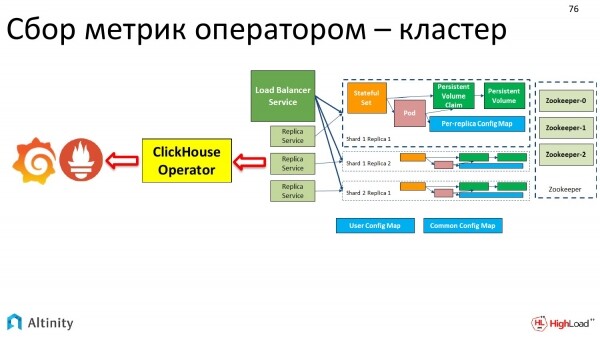
E, por fim, tornou-se assim.
O monitoramento é feito automaticamente pelo operador. Um único ponto de entrada.
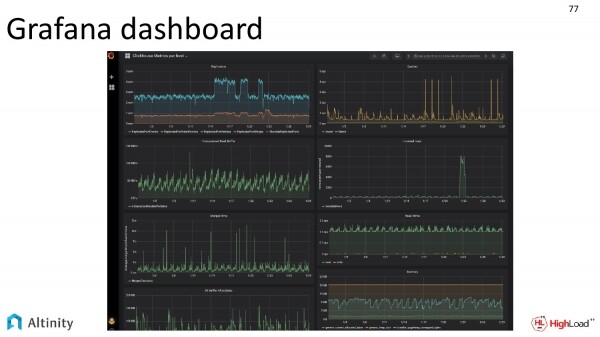
E nós apenas olhamos no painel do Grafana, observando como a vida do nosso cluster flui internamente.
Aliás, o painel do Grafana também é distribuído com nosso operador diretamente nos fontes. É possível conectar e utilizar. Este screenshot foi fornecido pelos nossos DevOps.
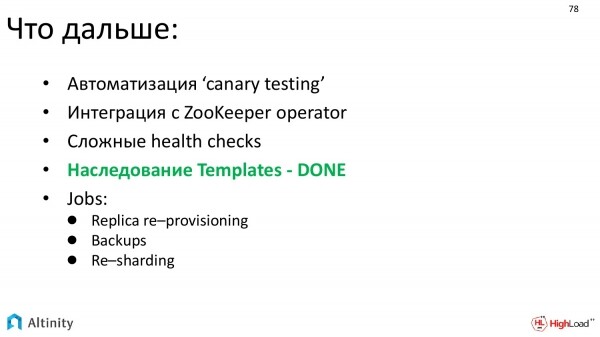
Para onde gostaríamos de avançar a partir daqui? Isso é:
- Desenvolver a automação dos testes. A principal tarefa é o teste automatizado de novas versões.
- Além disso, queremos muito automatizar a integração com o ZooKeeper. E estamos planejando nos integrar com o ZooKeeper-operator. Ou seja, foi escrito um operador para o ZooKeeper, e é lógico que dois operadores comecem a se integrar para construir uma solução mais conveniente.
- Queremos realizar verificações de saúde mais complexas.
- Eu destaquei em verde que estamos prestes a implementar a herança de Templates – CONCLUÍDO, ou seja, com o próximo lançamento do operador, já teremos a herança de templates. É uma ferramenta poderosa, que permite construir configurações complexas a partir de partes.
- E queremos a automação de tarefas complexas. A principal delas é o Re-sharding.
Vamos fazer um resumo intermediário.
O que estamos obtendo no final? E vale a pena ou não? Deveríamos mesmo tentar trazer o banco de dados para o Kubernetes e aplicar o operador em geral e o operador Alitnity em particular.
No final, obtemos:
- Uma simplificação e automação significativas da configuração, deployment e também da manutenção.
- Monitoramento integrado desde o início.
- E templates codificados prontos para uso em situações complexas. Não precisamos mais fazer manualmente ações como adicionar uma réplica. Isso é feito pelo operador.
Ainda resta apenas uma última pergunta. Já temos um banco de dados no Kubernetes, virtualização. Como fica o desempenho dessa solução, principalmente considerando que o ClickHouse é otimizado para desempenho?
A resposta é – tudo certo! Não vou me aprofundar, isso é um assunto para uma palestra separada.
Mas existe um projeto chamado TSBS. Qual é o seu principal objetivo? É um teste de bancos de dados para desempenho. É uma tentativa de comparar coisas semelhantes.
Como funciona? Um conjunto de dados é gerado. Depois, esse conjunto de dados é testado em diferentes bancos de dados com um conjunto idêntico de testes. E cada banco de dados resolve uma tarefa da forma que consegue. Assim, os resultados podem ser comparados.
Ele já suporta uma grande variedade de bancos de dados. Eu destaquei três principais. São eles:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
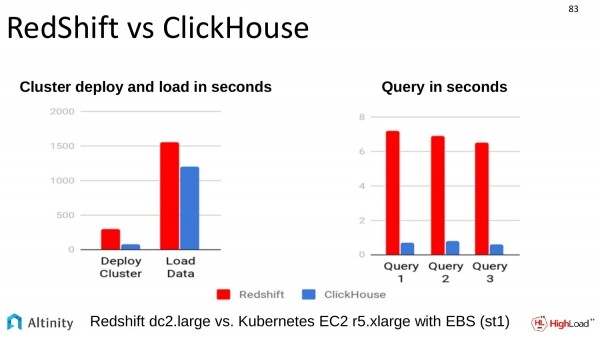
Também foi feita uma comparação com outra solução semelhante. A comparação com o RedShift foi realizada na Amazon. O ClickHouse também superou todos nesse aspecto.
Que conclusões podemos tirar do que eu apresentei?
- DB no Kubernetes é possível. Provavelmente, é possível qualquer um, mas, em geral, parece que é viável. ClickHouse no Kubernetes com certeza é possível com o suporte do nosso operador.
- O operador ajuda a automatizar processos e realmente facilita a vida.
- O desempenho é normal.
- E, nos parece, que isso pode e deve ser utilizado.
Código aberto – junte-se a nós!
Como já mencionei, o operador é um produto totalmente de código aberto, então seria ótimo se o maior número possível de pessoas o utilizasse. Junte-se a nós! Estamos esperando por todos vocês!
Muito obrigado a todos!
Perguntas
Obrigado pela apresentação! Meu nome é Anton. Eu sou da empresa SEMrush. Estou curioso sobre a parte de logging. Sobre monitoramento estamos cientes, mas sobre logging não sei nada, se falamos sobre o cluster como um todo. Por exemplo, nós levantamos um cluster em hardware. E usamos logging centralizado, coletando dados com ferramentas padrão em um único local. E depois extraímos os dados interessantes.
Boa pergunta, ou seja, logging está na lista de tarefas. Nosso operador ainda não automatiza isso. Ele ainda está em desenvolvimento, o projeto é bastante jovem. Nós entendemos a necessidade de logging. Este é também um tema muito importante. E provavelmente não é menos importante que o monitoramento. Mas o monitoramento foi o primeiro na lista de implementações. O logging virá. Estamos, naturalmente, tentando automatizar todos os aspectos da vida do cluster. Portanto, a resposta é: no momento, o operador, infelizmente, não faz isso, mas está nos planos, faremos isso. Se houver interesse em se juntar, por favor, enviem pull requests.
Olá! Obrigado pela apresentação! Tenho uma pergunta padrão relacionada a Persistent Volumes. Quando criamos uma configuração com esse operador, como o operador determina em qual nó um disco ou pasta está montado? Precisamos explicar a ele que, por favor, coloque nosso ClickHouse exatamente nesses nós onde o disco está disponível?
Pelo que eu entendo, essa pergunta é uma extensão do armazenamento local, especialmente na parte sobre hostPath. É como explicar ao sistema que é necessário que o pod seja executado exatamente naquele nó, onde temos um disco fisicamente conectado, que está montado em tal caminho. É uma seção inteira, que eu abordei de forma muito superficial, pois a resposta é bastante extensa.
De forma resumida, isso funciona assim. Naturalmente, precisamos provisionar esses volumes. No momento, não há provisionamento dinâmico em armazenamento local, então os DevOps devem criar os discos manualmente, esses volumes. E devem explicar ao Kubernetes o seguinte: que você terá Persistent volumes de um certo tipo, localizados em determinados nós. Em seguida, precisamos explicar ao Kubernetes que os pods que requerem esse tipo de armazenamento local devem ser agendados apenas em certos nós, com base em labels. Para isso, o operador tem a possibilidade de atribuir algum label e um por instância do host. Assim, os pods serão roteados pelo Kubernetes para serem executados apenas em nós que atendem aos requisitos dos labels, falando de forma simples. Os administradores atribuem labels, criam os discos manualmente. E assim, se torna escalável.
E é exatamente essa terceira opção de armazenamento local que ajuda a facilitar um pouco isso. Como já destaquei, é um trabalho meticuloso de configuração que, ao final, ajuda a obter o máximo desempenho.
Tenho uma segunda pergunta relacionada a isso. O Kubernetes foi concebido para que não importasse se perdêssemos um nó ou não. O que devemos fazer, nesse caso, se perdermos um nó onde está o nosso shard?
Sim, o Kubernetes foi inicialmente posicionado de forma que nossa relação com os pods é como a de gado, mas aqui cada disco se torna algo como um animal de estimação. Há um problema em que não podemos simplesmente descartá-los. E o desenvolvimento do Kubernetes está indo na direção de que não é possível tratá-los completamente de forma filosófica, como recursos totalmente descartáveis.
Agora, uma pergunta prática. O que fazer se você perder um nó onde o disco estava? Aqui, a tarefa é resolvida em um nível mais alto. No caso do ClickHouse, temos réplicas que funcionam em um nível superior, ou seja, no nível do ClickHouse.
Qual é a disposição? A responsabilidade por não perder dados cabe ao DevOps. Ele deve configurar corretamente a replicação e deve monitorar se a replicação está sendo executada. Na réplica, no nível do ClickHouse, os dados devem ser duplicados. Essa não é uma tarefa que o operador resolve. E não é uma tarefa que o próprio Kubernetes resolve. Isso está no nível do ClickHouse.
O que fazer se você tiver um nó físico falhando? E parece que teremos que instalar um segundo, corretamente provisionar o disco nele, aplicar labels. E, após isso, ele atenderá aos requisitos para que o Kubernetes possa iniciar uma instância do pod. O Kubernetes o iniciará. Você não tem o número suficiente de pods até o especificado. Ele passará pelo ciclo que eu mostrei. E no nível mais alto, o ClickHouse entenderá que uma réplica entrou, ela ainda está vazia e precisamos começar a transferir dados para ela. Ou seja, esse processo ainda está pouco automatizado.
Obrigado pela apresentação! Quando acontecem várias coisas ruins, o operador falha e reinicia, e nesse momento eventos chegam, você de alguma forma os processa?
O que acontece se o operador falhar e reiniciar, certo?
Sim. E nesse momento eventos chegaram.
A tarefa do que fazer nesse caso é parcialmente dividida entre o operador e o Kubernetes. O Kubernetes tem a capacidade de reproduzir o evento que ocorreu. Ele o reproduz. E a tarefa do operador é garantir que, quando um replay do log de eventos for feito, esses eventos sejam idempotentes. E que a reinserção do mesmo evento não quebre nosso sistema. E nosso operador lida bem com essa tarefa.
Olá! Obrigado pela apresentação! Dmitry Zavyalov, empresa Smidova. Está planejada a adição de configuração no operador com haproxy? Estou interessado em algum outro balanceador além do padrão, que seja inteligente e entenda que realmente existe ClickHouse.
Você está falando sobre Ingress?
Sim, substituir Ingress por haproxy. No haproxy, é possível especificar a topologia do cluster, onde estão suas réplicas.
Por enquanto, não pensamos sobre isso. Se você precisar e puder explicar por que isso é necessário, podemos implementar, especialmente se você quiser participar. Teremos prazer em considerar essa opção. Resumindo, não, não temos essa funcionalidade no momento. Obrigado pela sugestão, vamos analisar isso. E se você ainda explicar o caso de uso e por que isso é necessário na prática, por exemplo, criando issues no GitHub, será ótimo.
Já existe.
Certo. Estamos abertos a quaisquer propostas. E haproxy está na lista de tarefas. A lista de tarefas está crescendo e não diminuindo por enquanto. Mas isso é bom, significa que o produto é solicitado.
Fonte: habr.com
