

Em meu trabalho, frequentemente me deparo com novas soluções técnicas/produtos de software, sobre os quais há pouca informação na internet em língua russa. Com este artigo, pretendo preencher uma dessas lacunas, trazendo um exemplo da minha prática recente, quando foi necessário configurar o envio de eventos CDC de dois bancos de dados populares (PostgreSQL e MongoDB) para um cluster Kafka utilizando o Debezium. Espero que este artigo de revisão, surgido ao final do trabalho realizado, se mostre útil também para outros.
O que é Debezium e o que é CDC?
— é um representante da categoria de software CDC (), ou mais exatamente, um conjunto de conectores para vários SGBDs compatíveis com o framework Apache Kafka Connect.
Isso é que utiliza a licença Apache License v2.0 e é patrocinado pela empresa Red Hat. O desenvolvimento começou em 2016 e, até o momento, oferece suporte oficial para os seguintes SGBDs: MySQL, PostgreSQL, MongoDB e SQL Server. Também existem conectores para Cassandra e Oracle, mas atualmente eles estão em status de "acesso antecipado", e os novos lançamentos não garantem compatibilidade retroativa.
Comparando o CDC com a abordagem tradicional (quando o aplicativo lê dados diretamente do SGBD), suas principais vantagens incluem a implementação de streaming de mudança de dados a nível de linha, com baixa latência, alta confiabilidade e disponibilidade. Os últimos dois pontos são alcançados através da utilização de um cluster Kafka como repositório de eventos CDC.
Outra vantagem é o fato de que uma única modelo é usado para armazenar eventos, portanto o aplicativo final não precisa se preocupar com os nuances da operação de diferentes SGBDs.
Finalmente, ao utilizar um broker de mensagens, abre-se espaço para escalonamento horizontal de aplicativos que monitoram alterações nos dados. Isso minimiza a influência na fonte dos dados, já que a obtenção ocorre não diretamente do SGBD, mas do cluster Kafka.
Sobre a arquitetura do Debezium
O uso do Debezium resume-se a um esquema simples:
SGBD (como fonte de dados) → conector no Kafka Connect → Apache Kafka → consumidor
Como ilustração, apresentei um esquema do site do projeto:
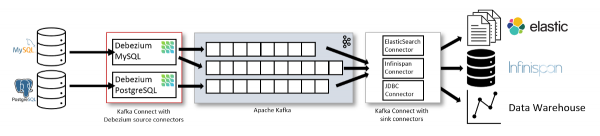
No entanto, este esquema não me agrada muito, pois dá a impressão de que é possível apenas usar um conector sink.
Na realidade, a situação é diferente: o preenchimento do seu Data Lake (último elemento no diagrama acima) — este não é o único modo de usar o Debezium. Os eventos enviados para o Apache Kafka podem ser utilizados por seus aplicativos para resolver diversas situações. Por exemplo:
- remoção de dados obsoletos do cache;
- envio de notificações;
- atualizações de índices de pesquisa;
- uma espécie de logs de auditoria;
- …
Caso você tenha um aplicativo em Java e não tenha a necessidade/ou possibilidade de usar um cluster Kafka, também existe a opção de operação através do . A vantagem óbvia é que você pode abrir mão de infraestrutura adicional (na forma de conector e Kafka). No entanto, essa solução foi declarada obsoleta (deprecated) desde a versão 1.1 e não é mais recomendada para uso (em versões futuras, pode ser retirada do suporte).
Neste artigo, será abordada a arquitetura recomendada pelos desenvolvedores, que garante resiliência e escalabilidade.
Configuração do conector
Para começar a rastrear as mudanças do ativo mais importante — os dados — precisaremos de:
- uma fonte de dados, que pode ser MySQL a partir da versão 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- um cluster Apache Kafka;
- uma instância Kafka Connect (versões 1.x, 2.x);
- um conector Debezium configurado.
As atividades dos dois primeiros itens, ou seja, o processo de instalação do SGBD e do Apache Kafka, estão além do escopo deste artigo. No entanto, para aqueles que desejam implementar tudo em um sandbox, no repositório oficial de exemplos, há um .
Nosso foco será nas duas últimas questões.
0. Kafka Connect
Aqui e adiante neste artigo, todos os exemplos de configuração são abordados no contexto da imagem Docker distribuída pelos desenvolvedores do Debezium. Ela contém todos os arquivos de plugin necessários (conectores) e permite a configuração do Kafka Connect através de variáveis de ambiente.
Caso se pretenda usar o Kafka Connect da Confluent, será necessário adicionar manualmente os plugins dos conectores necessários no diretório especificado em plugin.path ou definido através da variável de ambiente CLASSPATH. As configurações do worker do Kafka Connect e dos conectores são definidas através de arquivos de configuração, que são passados como argumentos para o comando de inicialização do worker. Para mais detalhes, veja em .
Todo o processo de configuração do Debezium com conector é realizado em duas etapas. Vamos analisar cada uma delas:
1. Configuração do framework Kafka Connect
Para o streaming de dados para o cluster Apache Kafka no framework Kafka Connect, são especificados parâmetros específicos, como:
- parâmetros de conexão com o cluster,
- nomes dos tópicos onde a configuração do conector será armazenada,
- nome do grupo em que o conector está sendo executado (no caso do modo distribuído).
A imagem Docker oficial do projeto suporta configuração através de variáveis de ambiente — que utilizaremos. Portanto, faça o download da imagem:
docker pull debezium/connectO conjunto mínimo de variáveis de ambiente necessário para iniciar o conector é o seguinte:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— lista inicial de servidores do cluster Kafka para obter a lista completa de membros do cluster; -
OFFSET_STORAGE_TOPIC=connector-offsets— tópico para armazenar as posições onde o conector está atualmente; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— tópico para armazenar o status do conector e suas tarefas; -
CONFIG_STORAGE_TOPIC=connector-config— tópico para armazenar os dados de configuração do conector e suas tarefas; -
GROUP_ID=1— identificador do grupo de workers onde a tarefa do conector pode ser executada; necessário ao usar o modo distribuído (distributed) modo.
Inicie o contêiner com essas variáveis:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Nota sobre Avro
Por padrão, o Debezium escreve dados no formato JSON, o que é aceitável para ambientes de teste e pequenos volumes de dados, mas pode se tornar um problema em bancos de dados de alto desempenho. Uma alternativa ao conversor JSON é a serialização de mensagens usando em formato binário, o que ajuda a reduzir a carga no subsistema I/O no Apache Kafka.
Para usar o Avro, é necessário implementar um (para armazenar esquemas). As variáveis para o conversor serão as seguintes:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Os detalhes sobre o uso do Avro e a configuração do registry estão além do escopo deste artigo — a seguir, para fins ilustrativos, utilizaremos JSON.
2. Configuração do conector
Agora podemos passar para a configuração do próprio conector, que irá ler os dados da fonte.
Vamos considerar como exemplo conectores para dois SGBDs: PostgreSQL e MongoDB, - dos quais tenho experiência e cujas diferenças existem (mesmo que pequenas, mas em alguns casos - significativas!).
A configuração é descrita na notação JSON e é carregada no Kafka Connect por meio de uma solicitação POST.
2.1. PostgreSQL
Exemplo de configuração do conector para PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
O princípio de funcionamento do conector após essa configuração é bastante simples:
- Na primeira execução, ele se conecta ao banco de dados especificado na configuração e é iniciado em modo initial snapshot, enviando ao Kafka um conjunto inicial de dados obtidos com a instrução
SELECT * FROM table_name. - Após a conclusão da inicialização, o conector passa para o modo de leitura das mudanças dos arquivos WAL do PostgreSQL.
Sobre as opções utilizadas:
-
nome— nome do conector, para o qual a configuração descrita abaixo é usada; mais tarde, esse nome é utilizado para trabalhar com o conector (ou seja, visualizar status/reiniciar/atualizar configuração) através da API REST do Kafka Connect; -
connector.class— classe do conector SGBD que será utilizada pelo conector configurável; -
plugin.name— nome do plugin para decodificação lógica de dados dos arquivos WAL. Estão disponíveis para escolha:wal2json,decoderbuffsepgoutput. Os dois primeiros exigem a instalação das extensões correspondentes no SGBD, enquantopgoutputpara versões do PostgreSQL 10 e superiores não requer manipulações adicionais; -
database.*— opções para conectar-se ao BD, ondedatabase.server.name— nome da instância do PostgreSQL utilizada para formar o nome do tópico no cluster Kafka; -
table.include.list— lista de tabelas cujas mudanças queremos monitorar; especificada no formatoschema.table_name; não pode ser usada em conjunto comtable.exclude.list; -
heartbeat.interval.ms— intervalo (em milissegundos), com o qual o conector envia mensagens heartbeat para um tópico específico; -
heartbeat.action.query— consulta que será executada ao enviar cada mensagem heartbeat (opção disponível a partir da versão 1.1); -
slot.name— nome do slot de replicação que será utilizado pelo conector; publication.name— nome no PostgreSQL que o conector utiliza. Caso não exista, o Debezium tentará criá-la. Se o usuário que está se conectando não tiver permissões suficientes para essa ação, o conector será encerrado com um erro;-
transformsdefine como exatamente modificar o nome do tópico de destino:-
transforms.AddPrefix.typeindica que usaremos expressões regulares; -
transforms.AddPrefix.regex— máscara pela qual o nome do tópico de destino é redefinido; -
transforms.AddPrefix.replacement— diretamente o que estamos redefinindo.
-
Mais detalhes sobre heartbeat e transforms
Por padrão, o conector envia dados ao Kafka a cada transação confirmada, e seu LSN (Log Sequence Number) é gravado em um tópico de serviço offset. Mas o que acontecerá se o conector estiver configurado para ler não toda a base, mas apenas partes de suas tabelas (nas quais a atualização de dados não ocorre com frequência)?
- O conector lerá os arquivos WAL e não detectará neles a confirmação de transações nas tabelas que está monitorando.
- Portanto, ele não atualizará sua posição atual nem no tópico, nem no slot de replicação.
- Isso, por sua vez, levará à "retenção" dos arquivos WAL no disco e ao provável esgotamento de todo o espaço em disco.
E aqui entram as opções heartbeat.interval.ms e heartbeat.action.query. O uso dessas opções em conjunto permite que a cada envio de mensagem heartbeat seja feita uma consulta para alterar dados em uma tabela separada. Assim, o LSN, no qual o conector está atualmente (no slot de replicação), é constantemente atualizado. Isso permite que o SGBD delete os arquivos WAL que não são mais necessários. Para saber mais sobre como as opções funcionam, consulte .
Outra opção que merece atenção especial é transforms. Embora seja mais sobre conveniência e estética...
Por padrão, o Debezium cria tópicos seguindo a seguinte política de nomenclatura: serverName.schemaName.tableName. Isso nem sempre pode ser conveniente. As opções transforms é possível usar expressões regulares para determinar a lista de tabelas cujos eventos precisam ser roteados para um tópico com um nome específico.
Na nossa configuração, graças a No final da descrição da configuração do conector para PostgreSQL, é importante mencionar as seguintes características/restrições de seu funcionamento: Assim, vamos carregar nossa configuração no conector: Verificamos se o carregamento foi bem-sucedido e se o conector está em execução: Ótimo: ele está configurado e pronto para uso. Agora vamos agir como consumidores e nos conectar ao Kafka, depois adicionaremos e alteraremos um registro na tabela: No nosso tópico, isso será exibido da seguinte forma: JSON muito longo com nossas alterações Em ambos os casos, as entradas consistem na chave (PK) do registro que foi alterado e na própria essência das mudanças: como era o registro antes e como ficou depois. Este conector utiliza o mecanismo padrão de replicação do MongoDB, lendo informações do oplog do nó primário do SGBD. Semelhante ao conector já descrito para PgSQL, aqui também, na primeira execução, é feita uma captura primária dos dados, após o que o conector muda para o modo de leitura do oplog. Exemplo de configuração: Como pode ser observado, aqui não há novas opções em comparação com o exemplo anterior, mas o número de opções relacionadas à conexão com o banco de dados e seus prefixos foi reduzido. Configurações A questão da resistência a falhas e alta disponibilidade é mais crítica do que nunca — especialmente quando falamos sobre dados e transações, e a rastreabilidade das mudanças nos dados não pode ficar de fora desse contexto. Vamos considerar o que pode dar errado e o que vai acontecer com o Debezium em cada um dos casos. Existem três opções de falha: No entanto, há exceções. Se o conector ficou desligado por um período prolongado (ou não conseguiu se conectar à instância do MongoDB), e o oplog passou por rotação nesse meio tempo, ao restaurar a conexão, o conector continuará a ler dados da primeira posição disponível, fazendo com que parte dos dados na Kafka não seja perdida. Debezium — minha primeira experiência com sistemas CDC e, em geral, foi bastante positiva. O projeto conquistou pela suporte das principais SGBDs, simplicidade de configuração, suporte à clustering e uma comunidade ativa. Recomendo aos interessados a se familiarizarem com os guias para e . Comparado ao conector JDBC para Kafka Connect, a principal vantagem do Debezium é que as alterações são lidas dos logs dos SGBDs, permitindo obter dados com mínima latência. O Conector JDBC (da entrega do Kafka Connect) faz consultas na tabela monitorada em intervalos fixos e (por esta mesma razão) não gera mensagens ao excluir dados (como se pode solicitar dados que não existem?). Para resolver tarefas semelhantes, você pode considerar as seguintes soluções (além do Debezium): Confira também em nosso blog: Fonte: habr.comtransforms ocorre o seguinte: todos os eventos CDC do banco de dados monitorado irão para o tópico com o nome data.cdc.dbname. Caso contrário (sem essas configurações), o Debezium, por padrão, criaria um tópico para cada tabela do tipo: pg-dev.public..
Restrições do conector
Aplicação da configuração
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: o valor anterior (before) é igual a null, e depois — a string que foi inserida. ATUALIZAÇÃO: em payload.before apresenta o estado anterior da string, e em payload.after — o novo com a essência das mudanças.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet\/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms desta vez faz o seguinte: transforma o nome do tópico de destino do esquema <server_name>.<db_name>.<collection_name> em data.cdc.mongo_<db_name>.Resiliência
Conclusão
P.S.
