

Algoritmos baseados em dados, como redes neurais, conquistaram o mundo. Seu desenvolvimento é impulsionado por várias razões, incluindo hardware poderoso e acessível e a imensa quantidade de dados disponíveis. Atualmente, as redes neurais estão na vanguarda de tarefas 'cognitivas', como reconhecimento de imagens e compreensão de linguagem natural, entre outras. No entanto, elas não devem se limitar a essas funções. Este material aborda como comprimir imagens usando redes neurais e aprendizagem residual. A abordagem apresentada no artigo funciona mais rapidamente e de forma mais eficaz do que os codecs padrão. Diagramas, equações e, claro, uma tabela com testes estão disponíveis a seguir.
Este artigo é baseado em trabalho. Assume-se que você esteja familiarizado com redes neurais e seus conceitos convolução e função de perda.
O que é compressão de imagens e que tipos existem?
Compressão de imagens é o processo de transformar uma imagem de modo que ela ocupe menos espaço. O armazenamento simples de imagens ocuparia muito espaço, por isso existem codecs, como JPEG e PNG, que têm como objetivo reduzir o tamanho da imagem original.
Como é sabido, existem dois tipos de compressão de imagens: sem perda e com perdas. Como o nome sugere, na compressão sem perdas é possível recuperar os dados da imagem original, enquanto na compressão com perdas, alguns dados são perdidos durante o processo. Por exemplo, JPG é um algoritmo com perdas [nota do tradutor — não devemos esquecer também o JPEG sem perdas], enquanto PNG é um algoritmo sem perdas.
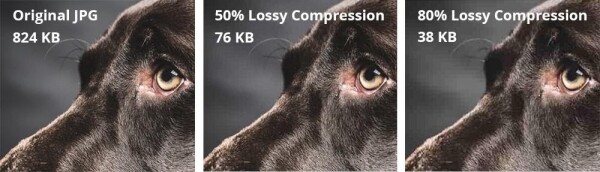
Comparação entre compressão sem perdas e com perdas
Observe que na imagem à direita há muitos artefatos de bloco. Isso é informação perdida. Pixels adjacentes de cores semelhantes são comprimidos como uma única área para economizar espaço, mas isso resulta na perda de informações sobre os pixels reais. Claro, os algoritmos usados nos codecs JPEG, PNG, etc., são muito mais complexos, mas este é um bom exemplo intuitivo de compressão com perda. A compressão sem perda é boa, mas os arquivos comprimidos sem perdas ocupam muito espaço em disco. Existem métodos mais eficientes de compressão de imagens sem perder muita informação, mas eles são bastante lentos, e muitos adotam abordagens iterativas. Isso significa que não podem ser executados em paralelo em vários núcleos de CPU ou GPU. Essa limitação os torna completamente impraticáveis no uso cotidiano.
Entrada da rede neural convolucional
Se algo precisa ser calculado e os cálculos podem ser aproximados, adicione . Os autores usaram uma rede neural convolucional bastante padrão para melhorar a compressão de imagens. O método apresentado não só funciona em nível com as melhores soluções (se não melhor), mas também pode utilizar cálculos paralelos, resultando em um aumento acentuado de velocidade. A razão é que as redes neurais convolucionais (CNN) são muito boas em extrair informações espaciais de imagens, que são então apresentadas de forma mais compacta (por exemplo, armazenando apenas os "bits importantes" da imagem). Os autores queriam aproveitar essa capacidade da CNN para representar melhor as imagens.
Arquitetura
Os autores propuseram uma rede dupla. A primeira rede aceita uma imagem como entrada e gera uma representação compacta (ComCNN). Os dados de saída dessa rede são então processados por um codec padrão (como JPEG). Após o processamento do codec, a imagem é passada para a segunda rede, que "corrige" a imagem do codec na tentativa de retornar à imagem original. Os autores chamaram essa rede de CNN reconstrutiva (RecCNN). Assim como as GAN, ambas as redes são treinadas iterativamente.
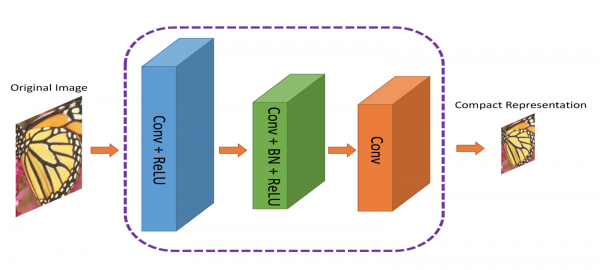
A representação compacta do ComCNN é passada para o codec padrão
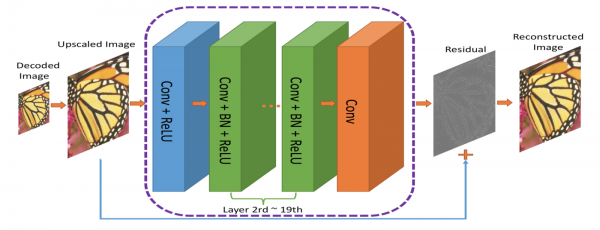
RecCNN. Os dados de saída do ComCNN são ampliados e passados para a RecCNN, que tentará aprender o restante.
A saída do codec é escalável à medida que aumenta e é então passada para o RecCNN. O RecCNN tentará produzir uma imagem que se assemelha ao original o máximo possível.
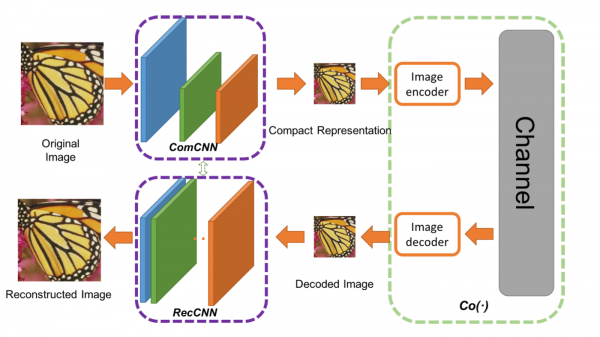
Estrutura de compressão de imagem em pipeline. Co(.) é um algoritmo de compressão de imagem. Os autores aplicaram JPEG, JPEG2000 e BPG.
O que é o residual?
O residual pode ser visto como uma etapa de pós-processamento para "melhorar" a imagem decodificada pelo codec. Com mais "informação" sobre o mundo, a rede neural pode tomar decisões cognitivas sobre o que corrigir. Esta ideia é baseada em , cujos detalhes você pode ler .
Funções de perda
Duas funções de perda são usadas porque temos duas redes neurais. A primeira delas, ComCNN, é rotulada como L1 e é definida assim:
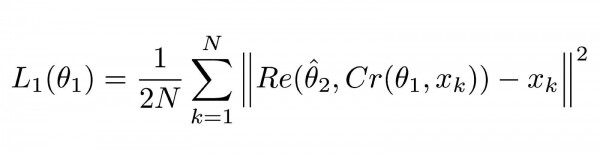
Função de perda para ComCNN
Explicação
Esta equação pode parecer complexa, mas na verdade é um padrão (erro quadrático médio) MSE. ||² significa a norma do vetor que eles encerram.
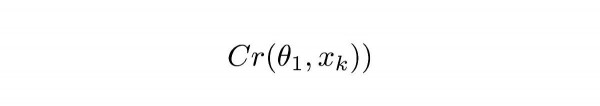
Equação 1.1
Cr representa a saída do ComCNN. θ representa a treinabilidade dos parâmetros do ComCNN, XK é a imagem de entrada.
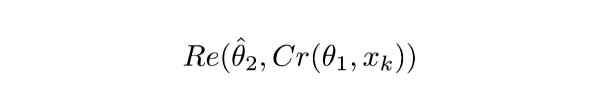
Equação 1.2
Re() representa o RecCNN. Esta equação simplesmente transmite o valor da equação 1.1 para o RecCNN. θ representa os parâmetros treináveis do RecCNN (o símbolo de chapéu acima indica que os parâmetros estão fixos).
Definição intuitiva
A equação 1.0 fará com que o ComCNN ajuste seus pesos de forma que, após a recriação pelo RecCNN, a imagem final pareça o mais semelhante possível à imagem de entrada. A segunda função de perda do RecCNN é definida assim:
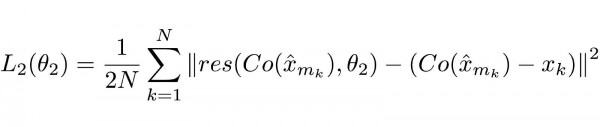
Equação 2.0
Explicação
Novamente, a função pode parecer complexa, mas é em grande parte uma função de perda padrão de rede neural (MSE).
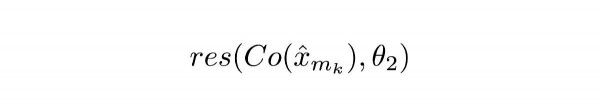
Equação 2.1
Co() representa a saída do codec, x com um chapéu acima significa a saída do ComCNN. θ2 são os parâmetros treináveis do RecCNN. res() simplesmente representa a saída residual do RecCNN. Vale ressaltar que o RecCNN é treinado na diferença entre Co() e a imagem de entrada, mas não na imagem de entrada.
Definição intuitiva
A equação 2.0 fará com que o RecCNN ajuste seus pesos de forma que a saída pareça o mais semelhante possível à imagem de entrada.
Esquema de aprendizado
Os modelos são treinados de forma iterativa, semelhante a Os pesos do primeiro modelo são fixados enquanto os pesos do segundo modelo são atualizados, depois os pesos do segundo modelo são fixados enquanto o primeiro modelo é treinado.
Testes
Os autores compararam seu método com métodos existentes, incluindo codecs simples. Seu método supera os outros, mantendo uma alta velocidade no equipamento apropriado. Além disso, os autores tentaram usar apenas uma das duas redes e observaram uma queda de desempenho.
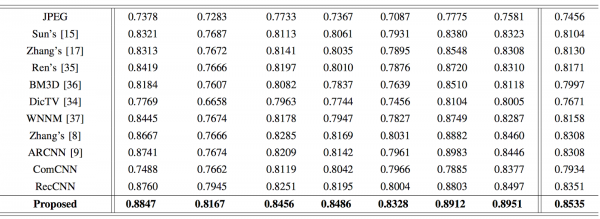
Comparação do índice de similaridade estrutural (SSIM). Valores altos indicam uma melhor semelhança com o original. O resultado dos autores é destacado em negrito.
Conclusão
Analisamos uma nova forma de aplicar aprendizado profundo para compressão de imagens, discutindo a possibilidade de usar redes neurais em tarefas além das 'gerais', como classificação de imagens e processamento de linguagem. Este método não só atende aos requisitos modernos, mas também permite processar imagens muito mais rapidamente.
Estudar redes neuronais ficou mais fácil, pois criamos um código promocional especialmente para os membros do Habr. HABR, que oferece um desconto adicional de 10% sobre o desconto indicado no banner.
Mais cursos
Artigos recomendados
Fonte: habr.com
