

Nota do tradutor.: os autores deste artigo são engenheiros de uma pequena empresa tcheca chamada pipetail. Eles conseguiram compilar uma lista notável de [algumas questões banais, mas ainda assim] tão relevantes sobre os problemas e mal-entendidos relacionados à operação de clusters Kubernetes.
Ao longo dos anos usando o Kubernetes, tivemos a oportunidade de trabalhar com um grande número de clusters (tanto gerenciados quanto não gerenciados - na GCP, AWS e Azure). Com o tempo, começamos a notar que alguns erros se repetem constantemente. No entanto, não há nada de vergonhoso nisso: nós mesmos cometemos a maioria deles!
Este artigo reúne os erros mais comuns e menciona como corrigi-los.
1. Recursos: solicitações e limites
Este ponto definitivamente merece a mais cuidadosa atenção e o primeiro lugar na lista.
A solicitação de CPU geralmente ou não é definida de forma alguma, ou tem um valor muito baixo (para acomodar o maior número possível de pods em cada nó). Assim, os nós acabam sobrecarregados. Durante alta carga, os recursos de CPU do nó estão totalmente ocupados e a carga de trabalho específica recebe apenas o que 'solicitou' por meio de throttling de CPU. Isso leva a atrasos aumentados no aplicativo, timeouts e outras consequências indesejadas. (Para mais detalhes sobre isso, leia nossa tradução recente: '' - nota do tradutor.)
BestEffort (extremamente não recomendado):
resources: {}Solicitação de CPU extremamente baixa (extremamente não recomendado):
   resources:
      Requests:
        cpu: "1m"
Por outro lado, ter um limite de CPU pode levar a uma redução não justificável de ciclos pelos pods, mesmo que a CPU do nó não esteja totalmente carregada. Novamente, isso pode levar a atrasos aumentados. Existem debates em curso sobre o parâmetro quota de CPU CFS no núcleo do Linux e throttling de CPU dependendo dos limites definidos, bem como a desativação da cota CFS... Infelizmente, limites de CPU podem causar mais problemas do que resolver. Mais detalhes podem ser encontrados no link abaixo.
O uso excessivo de (overcommitting) memória pode levar a problemas mais graves. Atingir o limite de CPU resulta em perda de ciclos, enquanto atingir o limite de memória resulta na 'morte' do pod. Você já observou OOMkill? Да, речь идет именно о нем.
Quer minimizar a probabilidade desse evento? Não distribua volumes excessivos de memória e use QoS Garantido (Quality of Service), definindo a solicitação de memória igual ao limite (como no exemplo abaixo). Saiba mais sobre isso na (engenheiro sênior da Zalando).
Burstable (maior probabilidade de receber OOMKilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Garantido:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
O que pode ajudar potencialmente na configuração de recursos?
Com metrics-server pode mostrar o consumo atual de recursos de CPU e utilização de memória pelos pods (e pelos contêineres dentro destes). Provavelmente, você já está usando. Simplesmente execute os seguintes comandos:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
No entanto, eles mostram apenas o uso atual. Com isso, você pode obter uma ideia aproximada das ordens de magnitude, mas, em última análise, você precisará do histórico de métricas ao longo do tempo (para responder a perguntas como: "Qual foi a carga máxima da CPU?", "Qual era a carga ontem de manhã?" — etc.). Para isso, você pode usar Prometheus, DataDog e outras ferramentas. Elas simplesmente recuperam as métricas do metrics-server e as armazenam, e o usuário pode consultá-las e gerar gráficos correspondentes.
permite automatizar esse processo. Ele rastreia o histórico de uso da CPU e da memória e ajusta novas solicitações e limites com base nessas informações.
Utilizar de forma eficaz os recursos computacionais não é uma tarefa simples. É como jogar Tetris constantemente. Se você está pagando demais por capacidade computacional com um baixo consumo médio (digamos, ~10%), recomendamos que você preste atenção aos produtos baseados no AWS Fargate ou Virtual Kubelet. Eles são fundamentados em um modelo de cobrança serverless/pay-per-usage, que pode ser mais barato nessas condições.
2. Liveness e readiness probes
Por padrão, as verificações de estado liveness e readiness no Kubernetes não estão habilitadas. E às vezes, elas são esquecidas...
Mas como mais poderia o serviço ser reiniciado em caso de erro irrecuperável? E como o balanceador de carga saberá que um pod está pronto para receber tráfego? Ou que ele pode processar mais tráfego?
Essas probes são frequentemente confundidas:
- Liveness — verificação de "sobrevivência" que reinicia o pod em caso de falha;
- Readiness — verificação de prontidão, que desconecta o pod do serviço Kubernetes em caso de falha (isso pode ser verificado com
kubectl get endpoints) e não recebe tráfego até que a próxima verificação seja bem-sucedida.
Ambas essas verificações SÃO REALIZADAS DURANTE TODO O CICLO DE VIDA DO POD. Isso é muito importante.
É um equívoco comum pensar que as verificações de readiness são executadas apenas na inicialização, para que o balanceador possa saber que o pod está pronto (Pronto) e pode começar a processar o tráfego. No entanto, essa é apenas uma das formas de aplicação.
Outra — é a possibilidade de detectar que o tráfego para o pod está excessivo e o está sobrecarregando (ou o pod está realizando cálculos que consomem muitos recursos). Nesse caso, a verificação de readiness ajuda a reduzir a carga no pod e "refriá-lo".A conclusão bem-sucedida da verificação de readiness no futuro permite aumentar novamente a carga no pod.Nesse caso (em caso de falha da verificação de readiness), a falha da verificação de liveliness seria muito contraproducente. Por que reiniciar um pod que está saudável e trabalhando arduamente?
Portanto, em alguns casos, é melhor não ter verificações do que ativá-las com parâmetros configurados incorretamente. Como mencionado, se a verificação de liveliness copia a verificação de readiness, você estará em grandes problemas. Uma opção possível é configurar , e perigosa liveliness.
Ambos os tipos de verificações não devem falhar ao cair dependências comuns, caso contrário, isso levará a uma falha em cascata (avalanche) de todos os pods. Em outras palavras, .
3. LoadBalancer para cada serviço HTTP
Provavelmente, você tem serviços HTTP em seu cluster que gostaria de expor ao mundo externo.
Se abrir o serviço como type: LoadBalancer, seu controlador (dependendo do provedor de serviços) fornecerá e negociará um LoadBalancer externo (não necessariamente operando em L7, mais provavelmente em L4), e isso pode afetar os custos (um endereço IPv4 estático externo, poder computacional, cobrança por segundo) devido à necessidade de criar muitos desses recursos.
Nesse caso, faria muito mais sentido usar um único balanceador de carga externo, abrindo serviços como type: NodePort.Ou, ainda melhor, implantar algo como nginx-ingress-controller (ou traefik.), que será o único NodePort endpoint relacionado ao balanceador de carga externo e irá roteirizar o tráfego no cluster usando ingress-recursos do Kubernetes.
Outros serviços (micro)intra-cluster que interagem entre si podem "se comunicar" através de serviços do tipo ClusterIP e do mecanismo de descoberta de serviços embutido via DNS. Porém, não utilize seus DNS/IP públicos, pois isso pode impactar na latência e aumentar os custos dos serviços em nuvem.
4. Autoescalonamento do cluster sem considerar suas particularidades
Ao adicionar e remover nós do cluster, não se deve confiar em algumas métricas básicas como uso de CPU nesses nós. O planejamento dos pods deve considerar uma série de restrições, como afinidade de pods/nós, taints e tolerâncias, requisições de recursos, QoS, etc. O uso de um autoscaler externo que não leva em consideração esses detalhes pode causar problemas.
Imagine que um pod deve ser agendado, mas todos os recursos de CPU disponíveis foram solicitados/ocupados e o pod fica preso em um estado Pending. O autoscaler externo vê a carga média atual da CPU (e não a solicitada) e não inicia a ampliação (scale-out) — não adiciona outro nó. Como resultado, esse pod não será agendado.
Por outro lado, a redução do escalonamento (scale-in) — remoção de um nó do cluster — é sempre mais difícil de implementar. Imagine que você tenha um pod stateful (com armazenamento persistente conectado). Volumes persistentes geralmente pertencem a uma determinada zona de disponibilidade e não são replicados na região. Assim, se o autoscaler externo remover o nó com esse pod, o scheduler não conseguirá agendar esse pod em outro nó, pois isso só pode ser feito na zona de disponibilidade onde está o armazenamento persistente. O pod ficará preso em um estado Pending.
Na comunidade Kubernetes, o é bastante popular. Ele opera no cluster, suporta a API dos principais provedores de serviços em nuvem, considera todas as restrições e pode escalar nos casos acima mencionados. Ele também é capaz de realizar scale-in mantendo todas as restrições configuradas, economizando assim dinheiro (que de outra forma seria gasto em recursos não utilizados).
5. Desconsiderar as capacidades do IAM/RBAC
Evite usar usuários IAM com segredos permanentes para máquinas e aplicativos. Organize acessos temporários utilizando funções e contas de serviços (service accounts).
Frequentemente encontramos chaves de acesso (e segredos) que acabam sendo 'hardcoded' na configuração do aplicativo, além da negligência na rotação de segredos, apesar do acesso ao Cloud IAM. Utilize funções IAM e contas de serviços em vez de usuários, onde for apropriado.
Esqueça o kube2iam e vá direto para as funções IAM para contas de serviço (como descrito na Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Uma anotação. Não é tão difícil, certo?
Além disso, não conceda contas de serviços e perfis de instância privilégios admin e cluster-admin, se não precisarem disso. Isso é um pouco mais complicado de implementar, especialmente no RBAC K8s, mas definitivamente vale o esforço.
6. Não confie na anti-affinity automática para pods
Imagine que você tenha três réplicas de um determinado deployment em um nó. O nó falha, e com ele todas as réplicas. Uma situação indesejável, não é?
Mas por que todas as réplicas estavam em um único nó? Kubernetes não deveria garantir alta disponibilidade (HA)?! (anti-affinity) Infelizmente, o scheduler do Kubernetes não garante por conta própria as regras de separação
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
para pods. Elas precisam ser explicitamente definidas: requiredDuringSchedulingIgnoredDuringExecution).
Aqui estamos falando sobre podAntiAffinity em diferentes nós: topologyKey: "kubernetes.io/hostname", — e não em diferentes zonas de disponibilidade. Para implementar uma HA completa, você precisará explorar mais a fundo este tema.
7. Ignorando PodDisruptionBudgets
Imagine que você tenha uma carga de produção em um cluster Kubernetes. Ocasionalmente, os nós e o próprio cluster precisam ser atualizados (ou retirados de serviço). O PodDisruptionBudget (PDB) é como um acordo de garantia de serviço entre os administradores do cluster e os usuários.
O PDB ajuda a evitar interrupções nos serviços causadas pela falta de nós:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
Neste exemplo, você, como usuário do cluster, informa os administradores: "Ei, eu tenho um serviço zookeeper, e não importa o que vocês façam, eu gostaria que pelo menos 2 réplicas desse serviço estivessem sempre disponíveis."
Você pode ler mais sobre isso .
8. Vários usuários ou ambientes em um cluster compartilhado
Espaços de nome no Kubernetes (namespaces) não oferecem forte isolamento.
É um equívoco comum pensar que se você implantar uma carga de não-prod em um espaço de nome e uma carga de prod em outro, eles não afetarão um ao outro… No entanto, algum nível de isolamento pode ser alcançado por meio de solicitações/restrições de recursos, configuração de cotas e definição de priorityClass. Um tipo de isolamento "físico" no plano de dados é garantido por affinities, tolerations, taints (ou nodeselectors), mas essa separação é bastante difícil de implementar.
Aqueles que precisam combinar ambos os tipos de cargas de trabalho em um único cluster terão que lidar com a complexidade. Se não houver essa necessidade e você puder ter outro cluster (digamos, na nuvem pública), é melhor fazê-lo. Isso permitirá alcançar um nível de isolamento muito maior.
9. externalTrafficPolicy: Cluster
Frequentemente, observamos que todo o tráfego para dentro do cluster chega através de um serviço do tipo NodePort, para o qual a política padrão é externalTrafficPolicy: Cluster.Isso significa que NodePort aberto em cada nó do cluster, e você pode usar qualquer um deles para interagir com o serviço desejado (um conjunto de pods).
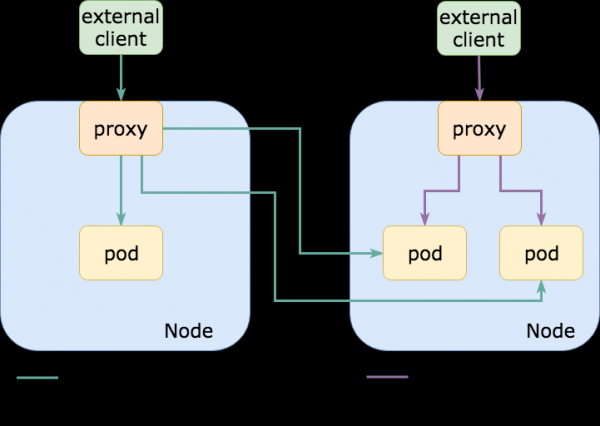
Entretanto, os pods reais associados ao mencionado serviço NodePort geralmente estão presentes apenas em um subconjunto desses nós.Em outras palavras, se eu me conectar a um nó onde não há o pod desejado, ele redirecionará o tráfego para outro nó, adicionando um salto (hop) e aumentando a latência (se os nós estiverem em diferentes zonas de disponibilidade/datacenters, a latência pode ser bastante alta; além disso, os custos com tráfego de egressão aumentarão).
Por outro lado, se uma política externalTrafficPolicy: Localfor definida para um serviço Kubernetes, o NodePort será aberto apenas nos nós onde os pods desejados estão efetivamente em execução. Ao usar um balanceador de carga externo, que verifica o estado (healthchecking) dos endpoints (como faz AWS ELB),ele enviará tráfego apenas para os nós necessários., o que terá um efeito positivo nos atrasos, nas necessidades computacionais e nas contas de egress (e o bom senso também indica o mesmo).
É bem provável que você já esteja usando algo como traefik. ou nginx-ingress-controller como um ponto NodePort final (ou LoadBalancer, que também utiliza NodePort) para rotear o tráfego HTTP ingress, e habilitar esta opção pode reduzir significativamente a latência para tais requisições.
Em você pode descobrir mais sobre externalTrafficPolicy, suas vantagens e desvantagens.
10. Não fique preso aos clusters e não abuse do control plane
No passado, os servidores eram comumente chamados por nomes próprios: , HAL9000 e Colossus… Hoje, eles foram substituídos por identificadores gerados aleatoriamente. No entanto, o hábito ficou, e agora nomes próprios são dados aos clusters.
Uma história típica (baseada em eventos reais): tudo começou como uma prova de conceito, então o cluster tinha o orgulhoso nome de testing… Anos se passaram, e ele AINDA é usado em produção, e todos têm medo de tocá-lo.
Não há nada de engraçado no fato de que os clusters se tornam pets, então recomendamos removê-los periodicamente, enquanto praticamos em recuperação após falhas (isso ajudará — nota do tradutor.). Além disso, não faz mal também cuidar da camada de gerenciamento (control plane). Ter medo de tocá-la não é um sinal muito bom. Etcd morreu? Pessoal, vocês realmente se meteram em problemas!
Por outro lado, não se deixe levar por manipulações com ele. Com o tempo, a camada de gerenciamento pode ficar lenta. Isso provavelmente está relacionado ao grande número de objetos criados sem sua rotação (uma situação comum ao usar Helm com configurações padrão, resultando na não atualização de seu estado em configmaps/secrets — como resultado, milhares de objetos se acumulam na camada de gerenciamento) ou à edição constante de objetos kube-api (para escalonamento automático, para CI/CD, para monitoramento, logs de eventos, controladores, etc.).
Além disso, recomendamos verificar os acordos SLA/SLO com o fornecedor de Kubernetes gerenciado e prestar atenção às garantias. O fornecedor pode garantir a disponibilidade da camada de gerenciamento (ou de seus subcomponentes), mas não a latência p99 das requisições que você lhes envia. Em outras palavras, pode-se introduzir kubectl get nodes, e a resposta pode levar até 10 minutos, e isso não será uma violação das condições do contrato de serviço.
11. Bônus: uso da tag latest
Isso já é um clássico. Recentemente, encontremos essa técnica com menos frequência, pois muitos, ensaiados pela amarga experiência, pararam de usar a tag :latest e começaram a fixar (pin) versões. Uhul!
ECR ; recomendamos que você confira essa característica notável.
Resumo
Não espere que tudo funcione com um estalar de dedos: Kubernetes não é uma panaceia. Um aplicativo ruim (e, talvez, fique ainda pior). A negligência resultará em complexidade excessiva, operação lenta e estressante da camada de controle. Além disso, você corre o risco de ficar sem uma estratégia de recuperação de desastres. Não conte que o Kubernetes 'pronto para uso' assumirá a responsabilidade pela isolamento e alta disponibilidade. Invista algum tempo para tornar seu aplicativo realmente cloud native.
Você pode conhecer as experiências infelizes de várias equipes na de Henning Jacobs.
Quem quiser complementar a lista de erros apresentada neste artigo pode nos contatar no Twitter (, ).
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «» (resumo e vídeo da apresentação);
- «».
Fonte: habr.com
