

Esse é um mito, bastante comum no setor de hardware de servidores. Na prática, no entanto, soluções hiperconvergentes (quando tudo está em um só lugar) são necessárias por muitos motivos. Historicamente, as primeiras arquiteturas foram desenvolvidas pela Amazon e Google para seus serviços. Naquela época, a ideia era criar uma fazenda computacional com nós idênticos, cada um com seus próprios discos. Tudo isso era unido por algum software sistema (hipervisor) e dividido em máquinas virtuais. O objetivo principal era minimizar o esforço na manutenção de um único nó e minimizar os problemas de escalabilidade: simplesmente comprava-se mais mil ou duas mil de servidores semelhantes e conectava-se ao lado. Na prática, isso é uma exceção, e muito mais frequentemente fala-se de um número menor de nós e uma arquitetura um pouco diferente.
Mas a vantagem continua a mesma — uma incrível simplicidade de escalabilidade e gerenciamento. A desvantagem é que diferentes tarefas consomem recursos de maneira diferente, e em alguns lugares haverá muitos discos locais, em outros, pouca memória operacional, e assim por diante, ou seja, dependendo do tipo de tarefas, a utilização dos recursos pode cair.
Acontece que você paga de 10 a 15% a mais pelo conforto da configuração. Isso gerou o mito do título. Nós procuramos muito onde a tecnologia poderia ser utilizada de forma ideal, e encontramos. O fato é que a Cisco não tinha suas próprias soluções de armazenamento, mas queria todo o mercado de servidores. E eles desenvolveram o Cisco Hyperflex — uma solução com armazenamento local nos nós.
E a partir disso, surgiu uma solução muito boa para data centers de backup (Disaster Recovery). Por que e como — vou explicar agora. E vou mostrar os testes do cluster.
Onde necessário
Hiperconvergência é:
- Transferência de discos para nós computacionais.
- Integração completa do subsistema de armazenamento de dados com o subsistema de virtualização.
- Transferência/integracão com o subsistema de rede.
Esse tipo de combinação permite implementar muitos recursos de armazenamento no nível da virtualização, tudo a partir de uma única interface de gerenciamento.
Na nossa empresa, projetos de design de data centers de backup são muito procurados, e frequentemente opta-se pela solução hiperconvergente devido à variedade de opções de replicação (inclusive até metrocómodos) prontamente disponíveis.
Nos casos de data centers de backup, geralmente se refere a um local remoto na cidade oposta ou até mesmo em outra cidade. Isso permite a recuperação de sistemas críticos em caso de falha parcial ou total do data center principal. Dados são constantemente replicados do ambiente de produção, e essa replicação pode ocorrer no nível da aplicação ou no nível do dispositivo de armazenamento (SDS).
Portanto, agora irei falar sobre a estrutura do sistema e os testes, e depois sobre alguns cenários de aplicação real com dados sobre economia.
Testes
Nossa configuração consiste em quatro servidores, cada um equipado com 10 discos SSD de 960 GB. Há um disco dedicado para o cache de operações de escrita e para armazenar a máquina virtual de serviço. A própria solução é a quarta versão. A primeira era visivelmente inacabada (de acordo com o feedback), a segunda ainda era um pouco crua, a terceira já era bastante estável, e esta pode ser chamada de versão final após o término dos testes beta para o público. Durante o período de teste, não encontrei problemas, tudo funciona como um relógio.
Mudanças na v4Um monte de bugs foi corrigido.
Inicialmente, a plataforma só funcionava com o hipervisor VMware ESXi e suportava um número limitado de nós. Além disso, o processo de implantação nem sempre terminava com sucesso, precisando reiniciar algumas etapas, havia problemas na atualização de versões anteriores, e os dados na GUI nem sempre eram exibidos corretamente (embora ainda não esteja totalmente satisfeito com a exibição dos gráficos de desempenho); às vezes, surgiam problemas na interseção com a virtualização.
Agora todas as doenças infantis foram corrigidas, o HyperFlex suporta tanto ESXi quanto Hyper-V, além disso, é possível:
- Criar um cluster estendido.
- Criar um cluster para escritórios sem a necessidade de Fabric Interconnect, com de dois a quatro nós (compramos apenas os servidores).
- Trabalhar com SDS externos.
- Suporte a contêineres e Kubernetes.
- Criar zonas de disponibilidade.
- Integração com VMware SRM, caso a funcionalidade embutida não seja satisfatória.
A arquitetura não difere muito das soluções dos principais concorrentes, não se reinventou a roda. Tudo isso opera na plataforma de virtualização VMware ou Hyper-V. O hardware está hospedado em servidores desenvolvidos pela própria Cisco UCS. Há quem odeie a plataforma devido à relativa complexidade da configuração inicial, a multitude de botões, e um sistema de modelos e dependências não triviais, mas há também quem tenha encontrado o zen, compreendido a ideia e não deseje mais trabalhar com outros servidores.
Vamos analisar especificamente a solução para VMware, pois a solução foi criada originalmente para ela e possui funcionalidades mais avançadas, enquanto que a Hyper-V foi aprimorada ao longo do tempo para acompanhar a concorrência e atender às expectativas do mercado.
Há um cluster de servidores equipados com discos. Existem discos para armazenamento de dados (SSD ou HDD — a sua escolha e necessidades), além de um disco SSD para cache. Ao gravar dados no datastore, os dados são armazenados na camada de cache (um disco SSD dedicado e RAM da VM de serviço). Paralelamente, um bloco de dados é enviado para os nós do cluster (o número de nós depende do fator de replicação do cluster). Após a confirmação de todos os nós sobre a gravação bem-sucedida, a confirmação é enviada ao hipervisor e, em seguida, à VM. Os dados gravados são desduplicados, comprimidos e gravados nos discos de armazenamento em segundo plano. Nesse processo, grandes blocos são gravados sequencialmente nos discos de armazenamento, reduzindo a carga sobre eles.
A deduplicação e compressão estão sempre ativadas e não podem ser desativadas. A leitura de dados ocorre diretamente dos discos de armazenamento ou do cache da RAM. Se for utilizada uma configuração híbrida, a leitura também é armazenada no disco SSD.
Os dados não estão vinculados à localização atual da máquina virtual e são distribuídos uniformemente entre os nós. Essa abordagem permite que todos os discos e interfaces de rede sejam igualmente carregados. Surge uma desvantagem óbvia: não conseguimos minimizar a latência de leitura, já que não há garantia de que os dados estão localmente disponíveis. Mas considero que essa é uma sacrifício insignificante em comparação com os benefícios obtidos. Além disso, as latências na rede alcançaram valores que praticamente não afetam o resultado geral.
Toda a lógica de funcionamento do subsistema de disco é gerida por uma máquina virtual de serviço especializada, o controlador Cisco HyperFlex Data Platform, que é criada em cada nó de armazenamento. Na nossa configuração, a máquina virtual de serviço foi alocada com oito vCPUs e 72 GB de RAM, o que não é pouco. Lembro que o próprio host possui 28 núcleos físicos e 512 GB de RAM.
A máquina virtual de serviço tem acesso direto aos discos físicos através do passthrough do controlador SAS na VM. A comunicação com o hipervisor ocorre através de um módulo especial chamado IOVisor, que intercepta operações de entrada e saída, e com um agente que permite enviar comandos para a API do hipervisor. O agente é responsável pelo trabalho com snapshots e clones do HyperFlex.
No hipervisor, os recursos de disco são montados como compartilhamentos NFS ou SMB (dependendo do tipo de hipervisor, adivinhe qual é onde). E, por trás disso, está um sistema de arquivos distribuído, que permite adicionar funcionalidades de storage avançadas: provisionamento fino de volumes, compressão e deduplicação, snapshots utilizando a tecnologia Redirect-on-Write, replicação síncrona/assíncrona.
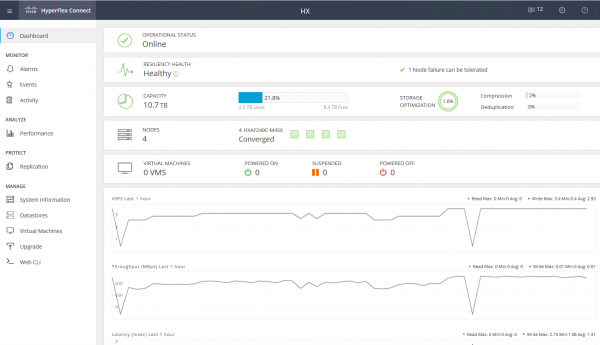
A máquina virtual de serviço fornece acesso à interface web de gerenciamento do subsistema HyperFlex. Existe integração com o vCenter, e a maior parte das tarefas do dia a dia pode ser executada a partir dele, mas as datastores, por exemplo, são mais facilmente configuradas a partir de uma interface web separada, se você já mudou para a rápida interface HTML5, ou pode usar o cliente Flash completo com integração total. Na interface web de serviço, você pode ver o desempenho e o status detalhado do sistema.
Existe também outro tipo de nó no cluster — nós de computação. Estes podem ser servidores em rack ou blade sem discos embutidos. Nestes servidores, é possível iniciar VMs cujos dados são armazenados em servidores com discos. Em termos de acesso a dados, não há diferença entre os tipos de nós, pois a arquitetura implica uma abstração da localização física dos dados. A máxima proporção de nós de computação para nós de armazenamento é de 2:1.
O uso de nós de computação aumenta a flexibilidade ao escalar recursos do cluster: não precisamos necessariamente comprar nós com discos, se a nossa necessidade é apenas de CPU/RAM. Além disso, podemos adicionar uma blade chassis e obter economia em colocação de servidores no rack.
Como resultado, temos uma plataforma hiperconvergente com as seguintes características:
- Até 64 nós no cluster (até 32 nós de armazenamento).
- O número mínimo de nós no cluster é três (dois para o cluster Edge).
- Mecanismo de redundância de dados: espelhamento com fator de replicação 2 e 3.
- Metro-cluster.
- Replicação assíncrona de VMs para outro cluster HyperFlex.
- Orquestração de failover de VMs para o data center remoto.
- Snapshots nativos com tecnologia Redirect-on-Write.
- Até 1 PB de espaço útil com fator de replicação 3 e sem considerar deduplicação. O fator de replicação 2 não é considerado, pois não é uma opção para vendas sérias.
Outro grande benefício é a simplicidade de gerenciamento e implantação. Todas as complexidades na configuração dos servidores UCS são feitas por uma VM especializada, preparada por engenheiros da Cisco.
Configuração do ambiente de testes:
- 2 x Cisco UCS Fabric Interconnect 6248UP como cluster de controle e componentes de rede (48 portas funcionando no modo Ethernet 10G/FC 16G).
- Quatro servidores Cisco UCS HXAF240 M4.
Características dos servidores:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/rank duplo/x4/1.2v
Rede
UCSC-MLOM-CSC-02 (VIC 1227). 2 portas de 10G Ethernet
Storage HBA
Controlador SAS Modular de Passagem de 12G da Cisco
Discos de Armazenamento
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Mais opções de configuraçãoAlém do hardware selecionado, atualmente estão disponíveis as seguintes opções:
- HXAF240c M5.
- Um ou dois CPUs, de Intel Silver 4110 a Intel Platinum I8260Y. A segunda geração está disponível.
- 24 slots de memória, módulos de 16 GB RDIMM 2600 até 128 GB LRDIMM 2933.
- De 6 a 23 discos para dados, um disco de cache, um disco do sistema e um disco de inicialização.
Discos de Capacidade
- HX-SD960G61X-EV 960GB 2.5 Inch Enterprise Value 6G SATA SSD (1X endurance) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inch Enterprise Value 6G SATA SSD (1X endurance) SAS 3.8 TB.
- Discos de Cache
- HX-NVMEXPB-I375 375GB 2.5 inch Intel Optane Drive, Desempenho Extremo & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 inch Ent. Perf. NVMe SSD (3X endurance) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inch Ent. Perf. 12G SAS SSD (10X endurance) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inch Ent. Perf. 12G SAS SED SSD (10X endurance) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inch Enterprise performance 12G SAS SSD (3X endurance).
Discos do Sistema / Log
- HX-SD240GM1X-EV 240GB 2.5 inch Enterprise Value 6G SATA SSD (Requer atualização).
Discos de Inicialização
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Conexão à rede através de portas Ethernet de 40G, 25G ou 10G.
Como FI, podem ser HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
O teste
Para testar o subsistema de disco, usei o HCIBench 2.2.1. Esta é uma ferramenta gratuita que automatiza a criação de carga a partir de várias máquinas virtuais. A própria carga é gerada pelo fio normal.
Nosso cluster é composto por quatro nós, fator de replicação 3, todos os discos Flash.
Para os testes, criei quatro datastores e oito máquinas virtuais. Para os testes de gravação, considera-se a situação em que o disco de cache não fica cheio.
Os resultados dos testes são os seguintes:
100 % Leitura 100 % Aleatória
0 % Leitura 100% Aleatória
Bloco/profundidade da fila
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Os valores em negrito indicam os pontos após os quais não há aumento de desempenho, e às vezes até há uma degradação perceptível. Isso está relacionado ao fato de que estamos limitados pelo desempenho da rede/controladores/discos.
- Leitura sequencial 4432 MB/s.
- Gravação sequencial 804 MB/s.
- Ao falhar um controlador (falha da máquina virtual ou do host), a queda de desempenho é de duas vezes.
- Ao falhar o disco de armazenamento, a queda é de 1/3. O rebuild do disco consome 5% dos recursos de cada controlador.
Em blocos pequenos, estamos limitados pelo desempenho do controlador (máquina virtual), cujo CPU está carregado em 100%; ao aumentar o bloco, estamos limitados pela largura de banda das portas. 10 Gbps não são suficientes para explorar todo o potencial do sistema AllFlash. Infelizmente, o fornecimento de 40 Gbps não é permitido pelas especificações do demo fornecido.
Nas minhas impressões dos testes e da arquitetura estudada, devido ao algoritmo que distribui os dados entre todos os hosts, obtemos um desempenho escalável e previsível, mas isso também se torna uma limitação durante a leitura, pois poderia ser extraído mais dos discos locais; aqui, uma rede mais potente pode ajudar, por exemplo, com FI disponíveis a 40 Gbps.
Além disso, um único disco para cache e deduplicação pode ser uma limitação; efetivamente, neste estande podemos gravar em quatro SSDs. Seria excelente ter a capacidade de aumentar o número de discos de cache e ver a diferença.
Uso real
Para organizar um datacenter de backup, podem-se usar duas abordagens (não estamos considerando o armazenamento de backups em uma localização remota):
- Ativo-Passivo. Todos os aplicativos são hospedados no Data Center principal. A replicação pode ser síncrona ou assíncrona. Em caso de falha do Data Center principal, precisamos ativar o secundário. Isso pode ser feito manualmente / com scripts / aplicativos de orquestração. Aqui obteremos um RPO comparável à frequência de replicação, e o RTO depende da reação e das habilidades do administrador e da qualidade da elaboração / depuração do plano de failover.
- Ativo-Ativo. Nesse caso, existe apenas replicação síncrona, a disponibilidade dos Data Centers é determinada por um quórum / árbitro, colocado rigorosamente em um terceiro local. RPO = 0, e o RTO pode atingir 0 (se o aplicativo permitir) ou igual ao tempo de tratamento da falha de um nó no cluster de virtualização. Em nível de virtualização, um cluster estendido (Metro) é criado, exigindo um armazenamento de dados Ativo-Ativo.
Normalmente, vemos nos clientes uma arquitetura já implementada com armazenamento clássico no Data Center principal, então projetamos mais um para replicação. Como mencionei, o Cisco HyperFlex oferece replicação assíncrona e a criação de um cluster de virtualização estendido. Nesse caso, não precisamos de um armazenamento de dados de nível médio ou superior com funções de replicação e acesso Ativo-Ativo a dados em dois storages caros.
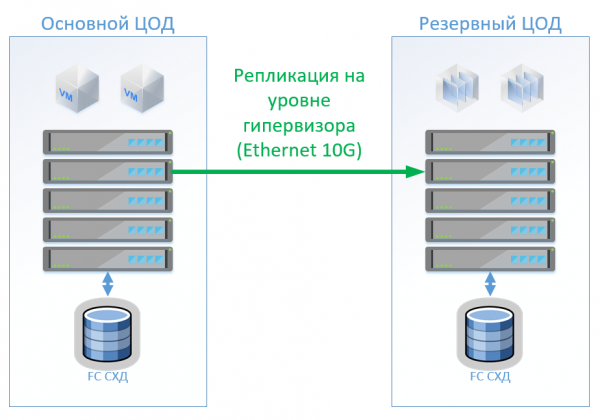
Cenário 1: Temos Data Centers principal e secundário, e a plataforma de virtualização é VMware vSphere. Todos os sistemas produtivos estão no Data Center principal, e a replicação das máquinas virtuais é realizada no nível do hipervisor, o que permite não manter as VMs ligadas no Data Center secundário. Bancos de dados e aplicativos especiais são replicados com recursos embutidos, e mantemos as VMs ligadas. Em caso de falha do Data Center principal, ativamos os sistemas no Data Center secundário. Consideramos que temos cerca de 100 máquinas virtuais. Enquanto o Data Center principal estiver operacional, o Data Center secundário pode executar ambientes de teste e outros sistemas que podem ser desligados em caso de failover do Data Center principal. Também é possível que utilizemos replicação bidirecional. Do ponto de vista de hardware, nada mudará.
No caso da arquitetura clássica, iremos instalar no cada Data Center um sistema de armazenamento híbrido com acesso via FibreChannel, tiering, deduplicação e compressão (mas não online), 8 servidores em cada local, com 2 switches FibreChannel e Ethernet de 10G. Para replicação e gerenciamento de failover na arquitetura clássica, podemos utilizar as ferramentas da VMware (Replication + SRM) ou ferramentas de terceiros, que podem ser um pouco mais baratas e às vezes mais convenientes.
A figura apresenta o diagrama.
No caso do uso do Cisco HyperFlex, a arquitetura é a seguinte:
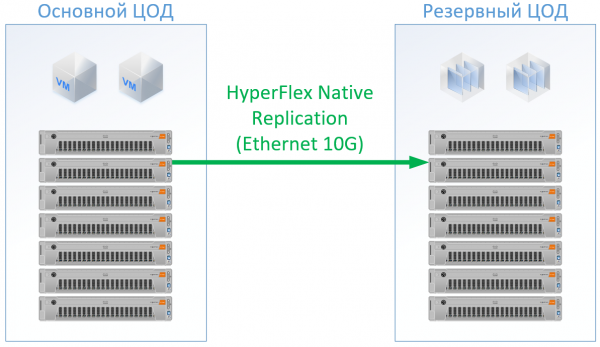
Para o HyperFlex, utilizei servidores com recursos robustos de CPU/RAM, já que parte dos recursos será dedicada à VM do controlador HyperFlex. Em relação à CPU e memória, até mesmo ampliei um pouco a configuração do HyperFlex, para não favorecer a Cisco e garantir recursos para as outras VMs. Assim, podemos dispensar os switches FibreChannel, e não precisamos de portas Ethernet para cada servidor, pois o tráfego local é comutado internamente no FI.
Assim, obtivemos a seguinte configuração para cada Data Center:
Servidores
8 x Servidor 1U (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Armazenamento em Bloco
Armazenamento híbrido com Front-End FC (20 TB SSD, 130 TB NL-SAS)
—
LAN
2 x Switch Ethernet 10G 12 portas
—
SAN
2 x Switch FC 32/16Gb 24 portas
2 x Cisco UCS FI 6332
Licenças
VMware Ent Plus
Replicação e/ou orquestração de failover de VM
VMware Ent Plus
Para o HyperFlex, não considerei licenças de software de replicação, pois temos isso disponível de fábrica.
Para a arquitetura clássica, escolhi um fornecedor que se destacou como um fabricante de qualidade e de bom custo. Para ambas as opções, apliquei o desconto padrão para a solução específica e, no final, obtive preços reais.
A solução com Cisco HyperFlex saiu 13% mais barata.
Cenário 2: criação de dois Data Centers ativos. Neste cenário, projetamos um cluster estendido na VMware.
A arquitetura clássica consiste em servidores de virtualização, SAN (protocolo FC) e dois sistemas de armazenamento, que podem ler e gravar neste, estendido entre eles. Para cada sistema de armazenamento, consideramos uma capacidade útil para local.
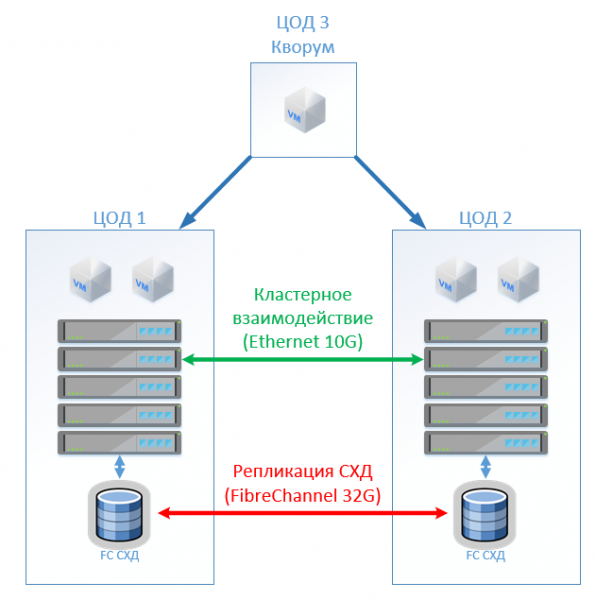
No HyperFlex, simplesmente criamos um Stretch Cluster com o mesmo número de nós em ambas as localidades. Neste caso, utiliza-se um fator de replicação 2+2.
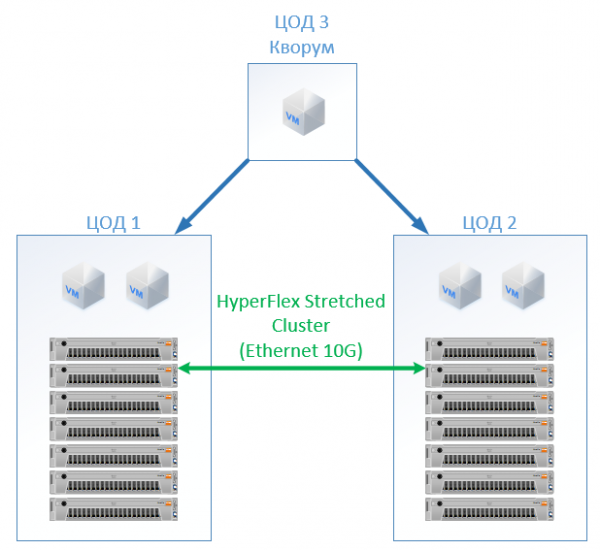
Obtivemos a seguinte configuração:
Arquitetura clássica
HyperFlex
Servidores
16 x Servidor 1U (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Armazenamento em Bloco
2 x Sistemas AllFlash de armazenamento (150 TB SSD)
—
LAN
4 x Switch Ethernet 10G 24 portas
—
SAN
4 x Switch FC 32/16Gb 24 portas
4 x Cisco UCS FI 6332
Licenças
VMware Ent Plus
VMware Ent Plus
Nas contagens, não considerei a infraestrutura de rede, os custos do data center, etc.: eles serão iguais para a arquitetura clássica e para a solução HyperFlex.
Em termos de custo, o HyperFlex ficou 5% mais caro. Vale ressaltar que, quanto aos recursos de CPU/RAM, houve um desvio na configuração da Cisco, pois preenchi os canais dos controladores de memória de forma uniforme. O custo é um pouco mais alto, mas não em grande escala, o que indica claramente que a hiperconvergência não é necessariamente um 'brinquedo para ricos', podendo competir com a abordagem padrão de construção de data centers. Isso também pode ser interessante para quem já possui servidores Cisco UCS e a infraestrutura correspondente.
Entre os benefícios, teremos a eliminação dos custos de administração de SAN e armazenamento, compressão e deduplicação online, um único ponto de entrada para suporte (virtualização, servidores, que também são armazenamento), economia de espaço (embora não em todos os cenários) e simplificação da operação.
No que diz respeito ao suporte, você o recebe de um único fornecedor — a Cisco. Com base na experiência de trabalho com servidores Cisco UCS, apreciei o suporte, não precisei abrir chamados para o HyperFlex, tudo funcionava bem. Os engenheiros respondem rapidamente e podem resolver não apenas problemas comuns, mas também casos complexos. Às vezes, contato-os com perguntas como: 'É possível fazer isso, adicionar aquilo?' ou 'Configurei algo aqui e não está funcionando. Me ajudem!' — eles pacientemente encontram o guia necessário e indicam as ações corretas, não costumam responder: 'Nós resolvemos apenas problemas de hardware'.
Links
- Meu e-mail é StGeneralov@croc.ru
Fonte: habr.com
