

Olá, Habr! Neste artigo, quero falar sobre uma ferramenta excepcional para o desenvolvimento de processos em lote de manipulação de dados, por exemplo, na infraestrutura de um DWH corporativo ou no seu DataLake. Farei uma introdução ao Apache Airflow (daqui em diante, Airflow). Ele é injustamente negligenciado no Habr, e em grande parte tentarei convencê-lo de que, no mínimo, o Airflow deve ser considerado ao escolher um planejador para seus processos ETL/ELT.
Anteriormente, escrevi uma série de artigos sobre DWH, quando trabalhava no Tinkoff Bank. Agora sou parte da equipe da Mail.Ru Group e estou dedicado ao desenvolvimento de uma plataforma para análise de dados na área de jogos. Assim, à medida que novas informações e soluções interessantes surgirem, nós, da equipe, compartilharemos aqui sobre a nossa plataforma de análise de dados.
Prólogo
Então, vamos começar. O que é o Airflow? É uma biblioteca (ou ) para o desenvolvimento, planejamento e monitoramento de fluxos de trabalho. A principal característica do Airflow é que, para a descrição (desenvolvimento) de processos, utiliza-se código na linguagem Python. Isso resulta em uma série de vantagens para a organização do seu projeto e desenvolvimento: essencialmente, seu projeto ETL é apenas um projeto Python, e você pode organizá-lo como preferir, levando em consideração as características da infraestrutura, o tamanho da equipe e outros requisitos. A parte instrumental é bastante simples. Por exemplo, utilize PyCharm + Git. Isso é ótimo e muito prático!
Agora vamos examinar as principais entidades do Airflow. Compreendendo sua essência e propósito, você organizará a arquitetura dos processos de maneira otimizada. A principal entidade é o Directed Acyclic Graph (DAG).
DAG
Um DAG é uma certa consolidação significativa das tarefas que você deseja executar em uma sequência específica de acordo com um cronograma determinado. O Airflow oferece uma interface web amigável para trabalhar com DAGs e outras entidades:
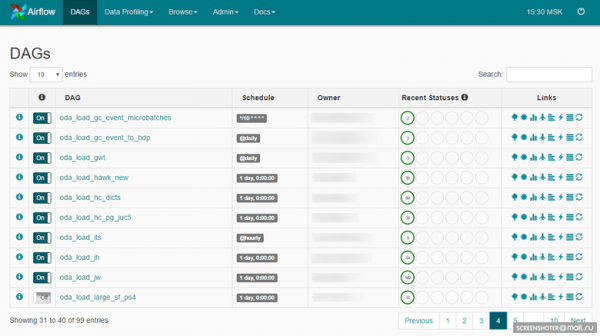
Um DAG pode parecer assim:
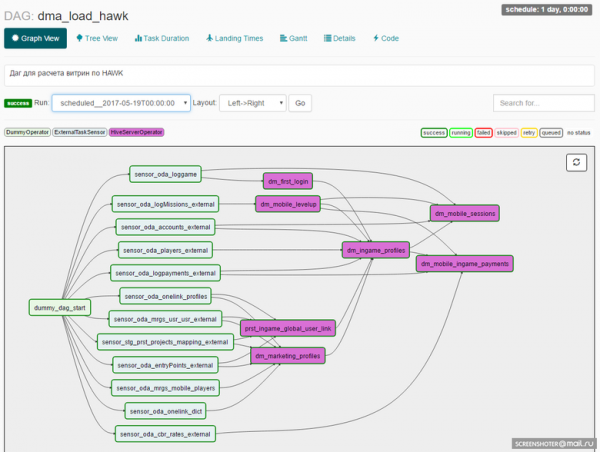
Ao projetar um DAG, o desenvolvedor define um conjunto de operadores sobre os quais as tarefas dentro do DAG serão construídas. Aqui chegamos a outra entidade importante: o Airflow Operator.
Operadores
Um operador é uma entidade a partir da qual instâncias de tarefas são criadas, descrevendo o que acontecerá durante a execução da instância da tarefa. já contêm um conjunto de operadores prontos para uso. Exemplos:
- BashOperator — operador para executar comandos bash.
- PythonOperator — operador para chamar código Python.
- EmailOperator — operador para enviar e-mails.
- HTTPOperator — operador para operar com requisições http.
- SqlOperator — operador para executar código SQL.
- Sensor — operador que aguarda um evento (como o tempo certo, a aparição de um arquivo necessário, uma linha em um banco de dados, uma resposta de API etc.).
Existem operadores mais específicos: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Você também pode desenvolver operadores de acordo com suas particularidades e usá-los em seu projeto. Por exemplo, criamos o MongoDBToHiveViaHdfsTransfer, um operador para exportar documentos do MongoDB para o Hive, e vários outros operadores para trabalhar com : CHLoadFromHiveOperator e CHTableLoaderOperator. Essencialmente, sempre que um código utilizado com frequência surge em um projeto, baseado em operadores básicos, você pode considerar agrupá-lo em um novo operador. Isso simplificará o desenvolvimento futuro e enriquecerá sua biblioteca de operadores no projeto.
Depois, todas essas instâncias de tarefas precisam ser executadas, e agora falaremos sobre o Agendador.
Agendador
O Agendador de tarefas no Airflow é construído em . Celery é uma biblioteca Python que permite organizar uma fila além da execução assíncrona e distribuída de tarefas. No Airflow, todas as tarefas são divididas em pools. Os pools são criados manualmente. Geralmente, seu objetivo é limitar a carga de trabalho com a fonte ou tipificar tarefas dentro do DWH. Os pools podem ser gerenciados através da interface web:
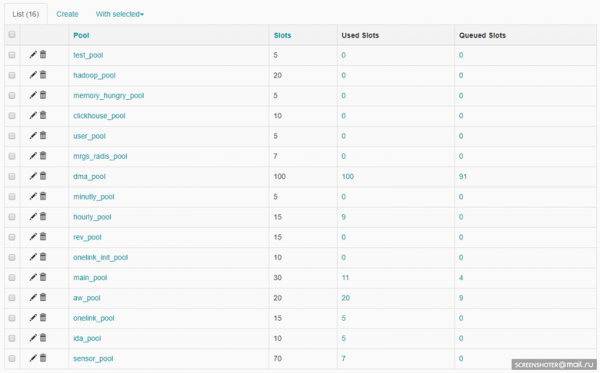
Cada pool tem uma limitação de slots. Ao criar um DAG, um pool é atribuído a ele:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
O pool atribuído no nível do DAG pode ser sobreposto no nível da tarefa.
Um processo separado — o Agendador — é responsável pela programação de todas as tarefas no Airflow. O Agendador cuida de toda a mecânica de atribuição das tarefas para execução. Antes de uma tarefa ser executada, ela passa por várias etapas:
- No DAG, as tarefas anteriores foram concluídas, uma nova pode ser colocada na fila.
- A fila é organizada de acordo com a prioridade das tarefas (as prioridades também podem ser gerenciadas), e, se houver uma vaga no pool, a tarefa pode ser iniciada.
- Se houver um worker celery livre, a tarefa é direcionada para ele; começa a execução que você programou na tarefa, usando um operador específico.
É bastante simples.
O Scheduler opera em muitos DAGs e em todas as tarefas dentro dos DAGs.
Para que o Scheduler comece a trabalhar com o DAG, é necessário definir um cronograma para o DAG:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Há um conjunto de presets prontos: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Você também pode usar expressões cron:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*/*10 * * * *')Data de Execução
Para entender como o Airflow funciona, é importante compreender o que é a Data de Execução para o DAG. No Airflow, o DAG tem uma dimensão de Data de Execução, ou seja, de acordo com o cronograma do DAG, são criadas instâncias das tarefas para cada Data de Execução. E para cada Data de Execução, as tarefas podem ser executadas novamente — ou, por exemplo, o DAG pode operar simultaneamente em várias Datas de Execução. Isso é claramente visível aqui:
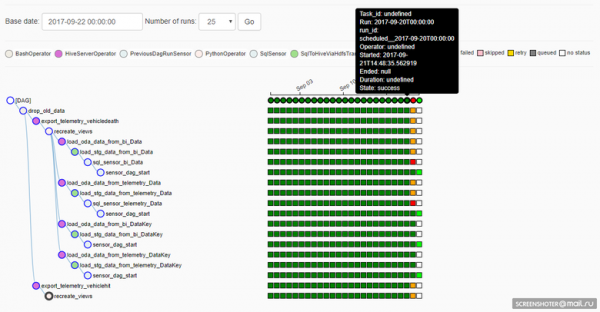
Infelizmente (ou talvez felizmente: depende da situação), se a implementação de uma tarefa no DAG for alterada, a execução nas Datas de Execução anteriores levará em conta as correções. Isso é bom se for necessário recalcular dados em períodos passados com um novo algoritmo, mas ruim porque a reproducibilidade do resultado é perdida (claro, ninguém impede de reverter para a versão correta no Git e calcular uma vez o que é necessário da maneira desejada).
Geração de Tarefas
A implementação do DAG é um código em Python, por isso temos uma maneira muito conveniente de reduzir a quantidade de código ao trabalhar, por exemplo, com fontes particionadas. Suponha que você tenha três shards MySQL como fonte, você precisa acessar cada um deles e coletar alguns dados. E isso de forma independente e paralela. O código em Python no DAG pode ser assim:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
O DAG se torna assim:
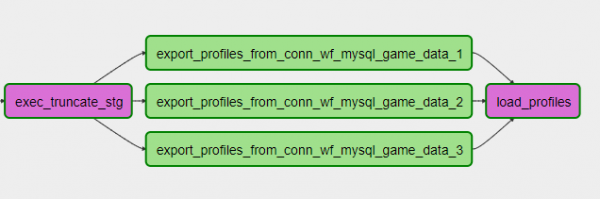
Além disso, você pode adicionar ou remover um shard, simplesmente ajustando a configuração e atualizando o DAG. Prático!
Você pode usar uma geração de código mais complexa, por exemplo, trabalhar com fontes em forma de BD ou descrever a estrutura de uma tabela, o algoritmo de trabalho com a tabela e, considerando as particularidades da infraestrutura DWH, gerar o processo de carregamento de N tabelas para o seu armazenamento. Ou, por exemplo, ao trabalhar com uma API que não suporta a operação com parâmetros em forma de lista, você pode gerar N tarefas no DAG com essa lista, limitar a paralelidade das solicitações na API com um pool e extrair os dados necessários da API. Flexível!
Repositório
No Airflow, há um repositório backend próprio, um BD (que pode ser MySQL ou Postgres, nós usamos Postgres), onde são armazenados os estados das tarefas, dos DAGs, configurações de conexões, variáveis globais etc. Vale destacar que o repositório no Airflow é muito simples (cerca de 20 tabelas) e conveniente se você deseja construir algum processo sobre isso. Lembro-me de 100500 tabelas no repositório da Informatica, que precisavam de bastante tempo para entender como construir uma consulta.
Monitoramento
Considerando a simplicidade do repositório, você mesmo pode construir um processo de monitoramento de tarefas que seja conveniente para você. Usamos um notebook no Zeppelin, onde verificamos o estado das tarefas:
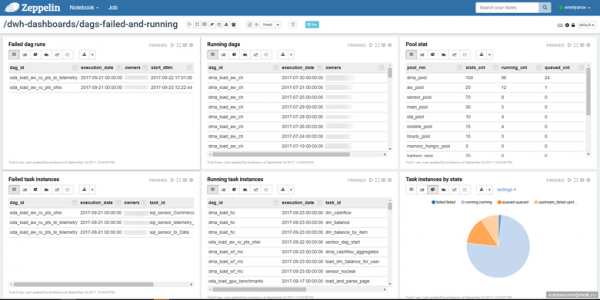
Pode ser também a interface web do próprio Airflow:
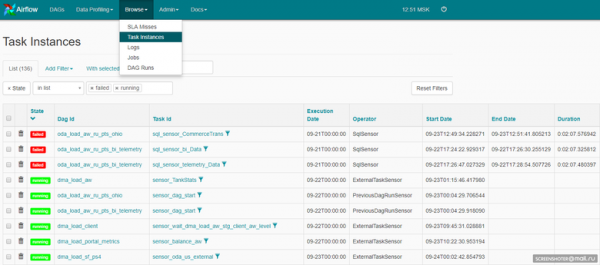
O código do Airflow é aberto, então adicionamos um alerta no Telegram. Cada instância de tarefa em execução, se ocorrer um erro, envia mensagens para o grupo no Telegram, onde está toda a equipe de desenvolvimento e suporte.
Recebemos através do Telegram uma resposta rápida (se necessária), e pelo Zeppelin — uma visão geral das tarefas no Airflow.
Total
O Airflow é, em primeiro lugar, open source, e você não deve esperar milagres dele. Esteja preparado para dedicar tempo e esforço para construir uma solução funcional. O objetivo é alcançável, acredite, vale a pena. A velocidade de desenvolvimento, flexibilidade, facilidade de adição de novos processos — você vai gostar. Claro, é necessário dedicar muita atenção à organização do projeto e à estabilidade do próprio Airflow: milagres não existem.
Atualmente, nosso Airflow processa diariamente cerca de 6,5 mil tarefasPor natureza, eles são bastante diferentes. Há tarefas de carregamento de dados no DWH principal a partir de várias fontes diferentes e muito específicas, há tarefas de cálculo de vitrines dentro do DWH principal, há tarefas de publicação de dados em um DWH ágil, há muitas, muitas tarefas diferentes — e o Airflow as processa dia após dia. Se falarmos em números, isso é 2,3 mil tarefas de ELT de diferentes complexidades dentro do DWH (Hadoop), cerca de 250 bancos de dados fontes, isso é uma equipe de quatro desenvolvedores de ETL, que se dividem entre o processamento ETL de dados no DWH e o processamento ELT de dados dentro do DWH e, claro, mais um administrador, que cuida da infraestrutura do serviço.
Planos futuros
O número de processos inevitavelmente cresce, e o principal foco que teremos na parte de infraestrutura do Airflow será a escalabilidade. Queremos construir um cluster Airflow, designar algumas instâncias para os workers do Celery e criar um nó duplicador com processos de agendamento de tarefas e repositório.
Epílogo
Isso, claro, está longe de ser tudo o que gostaria de compartilhar sobre o Airflow, mas tentei cobrir os principais pontos. O apetite vem comendo, experimente — e você vai gostar 🙂
Fonte: habr.com
