

Normalmente, para monitorar e analisar o funcionamento do Nginx, utilizam-se produtos comerciais ou alternativas open-source prontas, como Prometheus + Grafana. Esta é uma boa opção para monitoramento ou análise em tempo real, mas não é muito conveniente para análises históricas. Em qualquer recurso popular, o volume de dados dos logs do Nginx cresce rapidamente, e para analisar grandes volumes de dados, é lógico usar algo mais especializado.
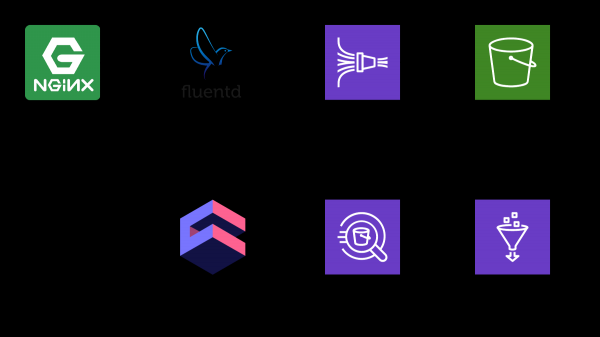
Neste artigo, vou explicar como é possível usar para análise de logs, usando o Nginx como exemplo, e mostrarei como coletar esses dados em um painel analítico, utilizando o framework open-source cube.js. Aqui está a arquitetura completa da solução:
TL:DR;
.
Para coletar informações, usamos , para processamento — e , para armazenamento — . Com esta combinação, é possível armazenar não apenas logs do Nginx, mas também outros eventos, assim como logs de outros serviços. Você pode substituir algumas partes por equivalentes para sua pilha, por exemplo, é possível enviar logs para o Kinesis diretamente do Nginx, ignorando o fluentd, ou usar o Logstash para isso.
Coletando logs do Nginx
Por padrão, os logs do Nginx têm a seguinte aparência:
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, como Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, como Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
É possível analisá-los, mas é muito mais fácil ajustar a configuração do Nginx para que ele produza logs em JSON:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 para armazenamento
Para armazenar os logs, usaremos o S3. Isso permite armazenar e analisar logs em um só lugar, pois o Athena pode trabalhar com dados no S3 diretamente. No próximo trecho do artigo, vou explicar como organizar e processar logs corretamente, mas primeiro precisamos de um bucket limpo no S3, onde nada mais será armazenado. Vale a pena pensar previamente sobre em qual região você criará o bucket, pois o Athena não está disponível em todas as regiões.
Criamos um esquema no console Athena
Vamos criar uma tabela no Athena para logs. Ela é necessária tanto para gravação quanto para leitura, caso você planeje usar o Kinesis Firehose. Abra o console Athena e crie a tabela:
SQL para criação da tabela
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Criamos o Kinesis Firehose Stream
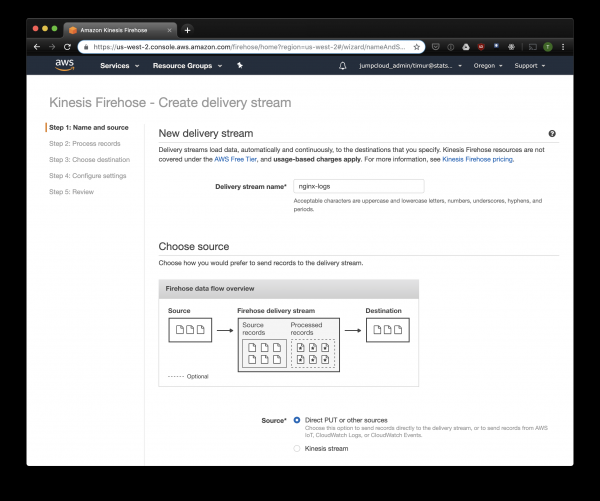
O Kinesis Firehose gravará os dados recebidos do Nginx no S3 no formato escolhido, organizando-os em diretórios no formato AAAA/MM/DD/HH. Isso será útil ao ler os dados. Pode-se, claro, gravar diretamente no S3 a partir do fluentd, mas neste caso terá que escrever em JSON, o que não é eficiente devido ao grande tamanho dos arquivos. Além disso, ao usar PrestoDB ou Athena, JSON é o formato de dados mais lento. Portanto, abrimos o console Kinesis Firehose, clicamos em "Create delivery stream", selecionamos "direct PUT" no campo "delivery":
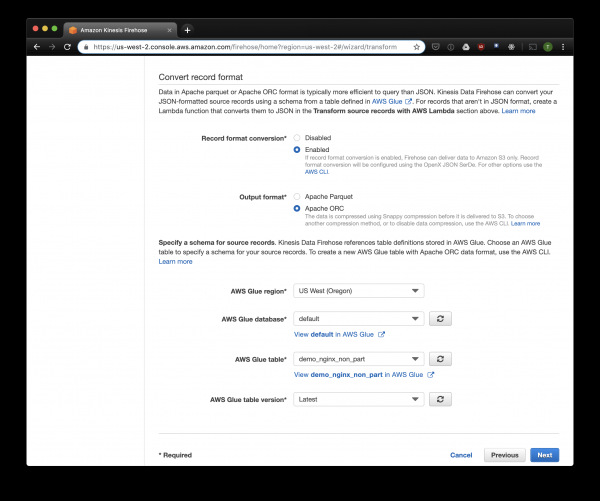
Na próxima aba, escolhemos "Record format conversion" — "Enabled" e selecionamos "Apache ORC" como formato para gravação. De acordo com alguns estudos , este é o formato ideal para PrestoDB e Athena. Como esquema, indicamos a tabela que criamos acima. Note que a localização do S3 no Kinesis pode ser qualquer uma, a tabela usa apenas o esquema. Mas se você indicar outra localização no S3, não será possível ler esses registros dessa tabela.
Selecionamos o S3 para armazenamento e o bucket que criamos anteriormente. O Aws Glue Crawler, que irei descrever mais tarde, não consegue trabalhar com prefixos em buckets do S3, então é importante deixá-lo vazio.
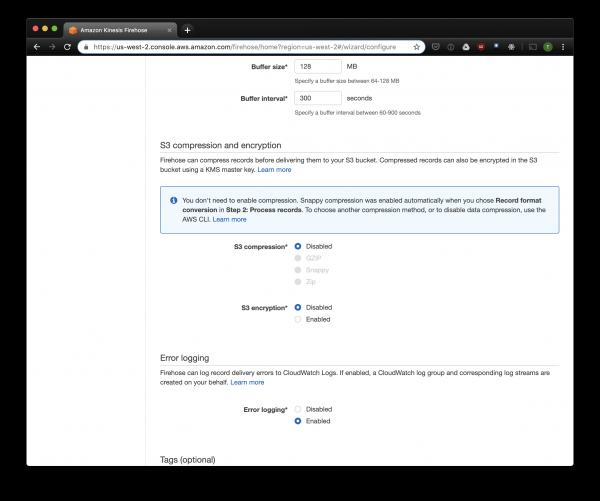
As outras opções podem ser alteradas conforme sua carga, eu normalmente uso as configurações padrão. Note que a compressão S3 não está disponível, mas o ORC utiliza sua própria compressão por padrão.
Fluentd
Agora que temos configurado o armazenamento e a recepção dos logs, precisamos configurar o envio. Vamos usar , porque gosto de Ruby, mas você pode usar o Logstash ou enviar logs diretamente para o Kinesis. O servidor Fluentd pode ser iniciado de várias maneiras, vou falar sobre o docker, pois é simples e conveniente.
Para começar, precisamos de um arquivo de configuração fluent.conf. Crie-o e adicione source:
forward
porta 24224
bind 0.0.0.0
Agora você pode iniciar o servidor Fluentd. Se precisar de uma configuração mais avançada, há um guia detalhado, incluindo como compilar sua própria imagem.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Esta configuração usa o caminho /fluentd/log para armazenar os logs em cache antes de enviá-los. Você pode não usar isso, mas reunindo tudo novamente, pode perder todos os dados em cache caso precise reiniciar. Você também pode usar qualquer porta, 24224 é a porta padrão do Fluentd.
Agora que temos o Fluentd em execução, podemos enviar os logs do Nginx para lá. Geralmente executamos o Nginx em um contêiner Docker, e, nesse caso, o Docker possui um driver nativo para logs do Fluentd:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Se você estiver executando o Nginx de outra forma, pode usar os arquivos de log, em Fluentd existe um .
Vamos adicionar à configuração do Fluent o processamento de logs configurado acima:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
E o envio de logs para o Kinesis, utilizando :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Se tudo estiver configurado corretamente, após algum tempo (por padrão, o Kinesis grava os dados recebidos a cada 10 minutos) você deve ver arquivos de logs no S3. No menu "monitoramento" do Kinesis Firehose, é possível ver quanto de dados foi gravado no S3, bem como erros. Não se esqueça de fornecer acesso para gravação no bucket S3 para o papel do Kinesis. Se o Kinesis não conseguir analisar algo, ele armazenará os erros no mesmo bucket.
Agora podemos ver os dados no Athena. Vamos encontrar as requisições recentes para as quais enviamos erros:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Escaneando todos os registros em cada consulta
Agora nossos logs foram processados e armazenados no S3 em ORC, comprimidos e prontos para análise. O Kinesis Firehose até os organizou em diretórios para cada hora. No entanto, enquanto a tabela não for particionada, o Athena carregará os dados de todo o tempo para cada consulta, salvo raras exceções. Isso é um grande problema por duas razões:
- O volume de dados está crescendo continuamente, retardando as consultas;
- A cobrança pelo Athena é baseada no volume de dados escaneados, com um mínimo de 10 MB para cada consulta.
Para corrigir isso, usamos o AWS Glue Crawler, que escaneará os dados no S3 e gravará informações sobre as partições no Glue Metastore. Isso nos permitirá usar as partições como filtro em consultas no Athena, e ele irá escanear apenas os diretórios especificados na consulta.
Configurando o Amazon Glue Crawler
O Amazon Glue Crawler escaneia todos os dados no bucket S3 e cria tabelas com partições. Crie um Glue Crawler a partir do console do AWS Glue e adicione o bucket onde você armazena os dados. Você pode usar um crawler para vários buckets; neste caso, ele criará tabelas no banco de dados especificado com nomes correspondentes aos nomes dos buckets. Se você planeja usar esses dados continuamente, não se esqueça de configurar um cronograma para a execução do Crawler de acordo com suas necessidades. Usamos um Crawler para todas as tabelas, que é executado a cada hora.
Tabelas particionadas
Após a primeira execução do crawler, no banco de dados especificado nas configurações, as tabelas para cada bucket escaneado devem aparecer. Abra o console do Athena e encontre a tabela com os logs do Nginx. Vamos tentar ler algo:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Esta consulta selecionará todos os registros recebidos das 6 às 7 da manhã do dia 8 de abril de 2019. Mas quão mais eficiente é do que apenas ler de uma tabela não particionada? Vamos descobrir e selecionar os mesmos registros filtrando-os pelo timestamp:
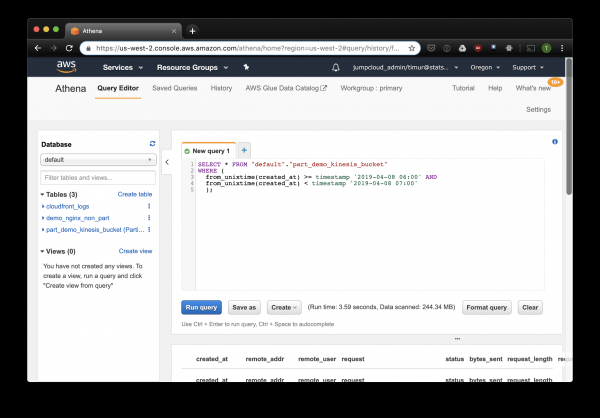
3.59 segundos e 244.34 megabytes de dados em um conjunto de dados que contém apenas uma semana de logs. Vamos tentar o filtro por partições:
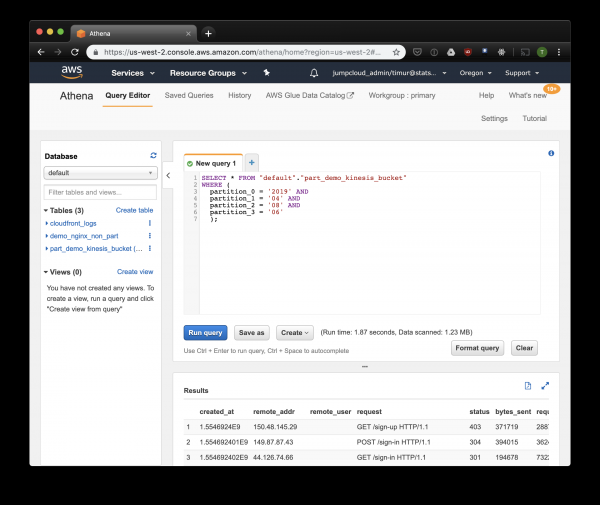
Um pouco mais rápido, mas o mais importante — apenas 1.23 megabytes de dados! Isso seria muito mais barato, se não fosse pelo mínimo de 10 megabytes por consulta na precificação. Mas ainda assim é muito melhor, e em conjuntos de dados maiores a diferença será muito mais impressionante.
Собираем дэшборд с помощью Cube.js
Para montar um dashboard, usamos o framework analítico Cube.js. Ele possui muitas funcionalidades, mas estamos interessados em duas: a capacidade de usar filtros por partições automaticamente e a pré-agregação dos dados. Ele utiliza um esquema de dados , escrito em Javascript, para gerar SQL e executar a consulta no banco de dados. O que precisamos fazer é simplesmente indicar como usar o filtro por partições no esquema de dados.
Vamos criar um novo aplicativo Cube.js. Como já estamos usando o stack AWS, faz sentido usar Lambda para o deployment. Você pode usar o template express para gerar, se planeja hospedar o backend do Cube.js no Heroku ou Docker. A documentação descreve outras .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
Para configurar o acesso ao banco de dados no cube.js, são usadas variáveis de ambiente. O gerador criará um arquivo .env, onde você pode especificar suas chaves para .
Agora precisaremos de , onde especificaremos como exatamente nossos logs são armazenados. Também podemos indicar como calcular métricas para os dashboards.
No diretório schema, crie um arquivo Logs.js. Aqui está um exemplo de modelo de dados para nginx:
Código do modelo
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Yes`
        }],
        else: { label: `No` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Aqui usamos a variável , para gerar a consulta SQL com filtro por partições.
Também definimos as métricas e parâmetros que queremos exibir no dashboard, e especificamos as pré-agregações. O Cube.js criará tabelas adicionais com dados pré-agregados e atualizará automaticamente os dados conforme eles chegam. Isso não apenas acelera as consultas, mas também reduz o custo de uso do Athena.
Vamos adicionar essas informações ao arquivo do esquema de dados:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
Especificamos neste modelo que precisamos pré-agregar dados para todas as métricas utilizadas e usar partição por meses. pode acelerar significativamente a coleta e atualização de dados.
Agora podemos montar o dashboard!
O backend do Cube.js fornece e um conjunto de bibliotecas cliente para populares frameworks frontend. Vamos usar a versão React do cliente para construir o dashboard. O Cube.js fornece apenas os dados, então precisaremos de uma biblioteca para visualizações — eu gosto de , mas você pode usar qualquer uma.
O servidor Cube.js aceita solicitações em , no qual estão especificadas as métricas necessárias. Por exemplo, para calcular quantos erros o Nginx gerou por dia, precisamos enviar a seguinte solicitação:
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Vamos instalar o cliente do Cube.js e a biblioteca de componentes React via NPM:
$ npm i --save @cubejs-client/core @cubejs-client/reactImportamos os componentes cubejs e QueryRenderer, para extrair os dados, e montamos o dashboard:
Código do dashboard
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Loading...';
        }

        return (


        );
      }}
    />
  )
}
Os códigos fonte do dashboard estão disponíveis no .
Fonte: habr.com
