

O banco de dados de séries temporais (TSDB, time series database) no Prometheus 2 é um excelente exemplo de solução de engenharia que oferece melhorias significativas em comparação com o armazenamento v2 no Prometheus 1 em termos de velocidade de coleta de dados e execução de consultas, eficiência no uso de recursos. Implementamos o Prometheus 2 no Percona Monitoring and Management (PMM), e tive a oportunidade de analisar o desempenho do TSDB do Prometheus 2. Neste artigo, compartilharei os resultados dessas observações.
Carga de trabalho média do Prometheus
Para aqueles que estão acostumados a lidar com bancos de dados de uso geral, a carga de trabalho típica do Prometheus é bastante interessante. A velocidade de coleta de dados tende a um valor estável: geralmente, os serviços que você monitora enviam uma quantidade semelhante de métricas, e a infraestrutura muda relativamente devagar.
As solicitações de informações podem vir de várias fontes. Algumas delas, como alertas, também tendem a um valor estável e previsível. Outras, como solicitações de usuários, podem causar picos, embora isso não seja característico da maior parte da carga.
Teste de carga
Durante o teste, concentrei-me na capacidade de coleta de dados. Eu implantei o Prometheus 2.3.2, compilado com Go 1.10.1 (como parte do PMM 1.14) no serviço Linode, usando este script: . Para gerar a carga de maneira o mais realista possível, utilizei este e executei várias instâncias do MySQL com carga real (Teste Sysbench TPC-C), cada uma emulava 10 nós Linux/MySQL.
Todos os testes a seguir foram realizados em um servidor Linode com oito núcleos virtuais e 32 GB de memória, onde 20 simulações de carga estavam monitorando duzentas instâncias do MySQL. Ou, em termos do Prometheus, 800 alvos, 440 coletas por segundo, 380 mil registros por segundo e 1,7 milhão de séries temporais ativas.
Design
A abordagem comum dos bancos de dados tradicionais, incluindo o que era utilizado no Prometheus 1.x, envolve . Se não houver memória suficiente para suportar a carga, você enfrentará grandes latências, e algumas solicitações não serão atendidas. O uso de memória no Prometheus 2 é configurado através da chave storage.tsdb.min-block-duration, que determina quanto tempo os registros serão mantidos na memória antes de serem descartados no disco (o padrão é de 2 horas). A quantidade necessária de memória dependerá do número de séries temporais, rótulos (labels) e a intensidade da coleta de dados (scrapes), somados ao fluxo de entrada puro. Em termos de espaço em disco, o Prometheus tende a usar cerca de 3 bytes por registro (sample). Por outro lado, os requisitos de memória são bem mais altos.
Embora haja a possibilidade de configurar o tamanho do bloco, não é recomendável ajustá-lo manualmente, portanto, você deve fornecer ao Prometheus a quantidade de memória que ele solicitará para sua carga de trabalho.
Se a memória não for suficiente para suportar o fluxo de métricas, o Prometheus irá falhar com out of memory ou será alcançado pelo OOM killer.
Adicionar swap para adiar o momento da falha, quando o Prometheus fica sem memória, não ajuda muito, pois o uso dessa funcionalidade provoca um consumo explosivo de memória. Acredito que isso se deve ao Go, seu coletor de lixo e como ele lida com o swap.
Uma abordagem interessante é configurar o descarte do head block no disco em um determinado momento, em vez de contar a partir do início do processo.
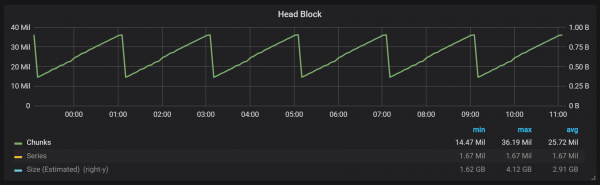
Como você pode ver no gráfico, os descartes no disco ocorrem a cada duas horas. Se você alterar o parâmetro min-block-duration para uma hora, esses descartes ocorrerão a cada hora, começando após meia hora.
Se você deseja usar este e outros gráficos na sua instalação do Prometheus, pode usar este . Ele foi desenvolvido para PMM, mas, com pequenas alterações, se adapta a qualquer instalação do Prometheus.
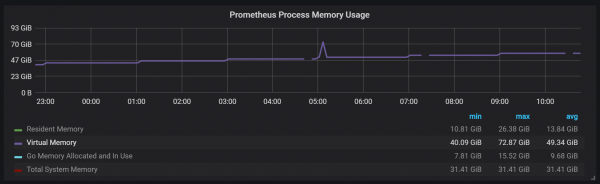
Temos um bloco ativo, chamado head block, que é mantido na memória; os blocos com dados mais antigos estão disponíveis através de mmap(). Isso elimina a necessidade de configurar o cache separadamente, mas também significa que você precisa deixar espaço suficiente para o cache do sistema operacional, se quiser fazer consultas aos dados mais antigos do que os que cabem no head block.
Além disso, isso significa que o consumo de memória virtual do Prometheus parecerá bastante alto, o que não deve ser uma preocupação.
Outro aspecto interessante do design é o uso do WAL (write ahead log). Como pode ser visto na documentação do armazenamento, o Prometheus utiliza o WAL para evitar perdas em caso de falhas. Os mecanismos específicos que garantem a durabilidade dos dados, infelizmente, não estão suficientemente documentados. A versão 2.3.2 do Prometheus grava o WAL no disco a cada 10 segundos, e essa configuração não é ajustável pelo usuário.
Compacções
O Prometheus TSDB é projetado à semelhança do armazenamento LSM (Log Structured Merge - árvore estrutural de log com mesclagem): o bloco de cabeçalho é periodicamente gravado no disco, enquanto o mecanismo de compactação combina vários blocos juntos para evitar a varredura de um número excessivo de blocos durante as consultas. Aqui está a quantidade de blocos que observei no sistema de teste após um dia de carga.
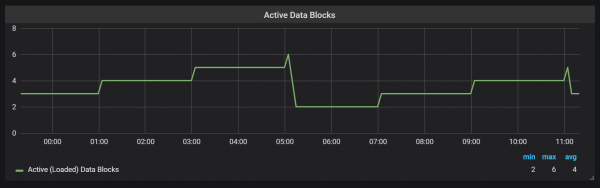
Se você quiser saber mais sobre o armazenamento, pode estudar o arquivo meta.json, que contém informações sobre os blocos disponíveis e como eles foram criados.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
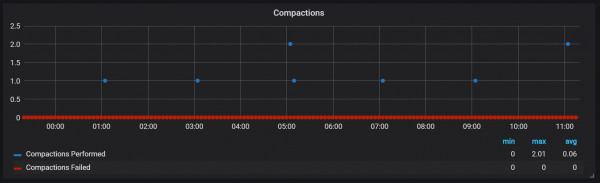
As compacções no Prometheus estão atreladas ao tempo de gravação do bloco de cabeçalho no disco. Nesse momento, várias dessas operações podem estar ocorrendo.
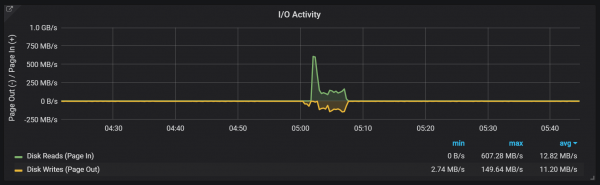
Parece que as compactações não têm limitações e podem causar grandes picos de I/O em disco durante a execução.
Picos no uso da CPU
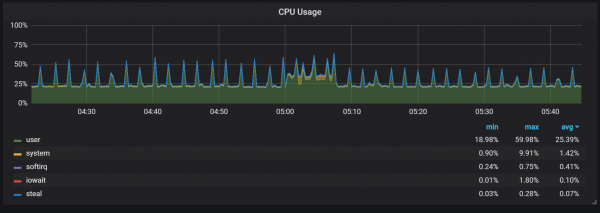
Obviamente, isso afeta negativamente a rapidez do sistema e é um grande desafio para os armazenamentos LSM: como realizar compactações para manter uma alta velocidade de consulta sem causar um overhead excessivo?
O uso de memória durante as compactações também parece bastante curioso.
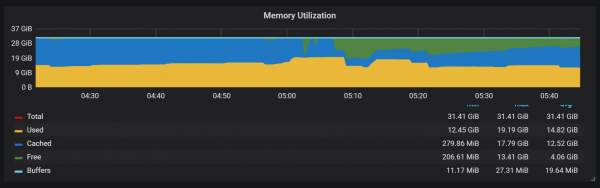
Podemos ver que, após a compactação, a maior parte da memória muda de estado de Cached para Free: isso significa que informações potencialmente valiosas foram removidas de lá. É curioso saber se aqui é utilizado fadvice() ou alguma outra técnica de minimização, ou se isso se deve ao fato de que o cache foi liberado de blocos destruídos durante a compactação?
Recuperação após falha
A recuperação após falhas leva tempo e isso é justificável. Para um fluxo de entrada de um milhão de registros por segundo, eu tive que esperar cerca de 25 minutos enquanto a recuperação era realizada considerando o disco SSD.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Iniciando o Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Começando a escutar conexões" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Iniciando TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="bloco saudável encontrado" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="prefixo do roteador" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="bloco saudável encontrado" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="bloco saudável encontrado" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="bloco saudável encontrado" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="bloco saudável encontrado" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Corrupção do WAL detectada; truncando" err="CRC32 checksum inesperado d0465484, esperado 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB iniciado"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Carregando arquivo de configuração" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Carregamento do arquivo de configuração concluído" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Servidor pronto para receber solicitações web."
O principal problema do processo de recuperação é o alto consumo de memória. Embora em uma situação normal o servidor possa funcionar de forma estável com a mesma quantidade de memória, durante uma queda ele pode não reiniciar devido ao OOM. A única solução que encontrei foi desativar a coleta de dados, reiniciar o servidor, permitir que ele se recupere e, em seguida, reiniciá-lo com a coleta ativada.
Aquecimento
Outro comportamento a se ter em mente durante o aquecimento é a relação entre baixo desempenho e alto consumo de recursos logo após a inicialização. Em algumas, mas não em todas as inicializações, observei uma carga significativa de CPU e memória.
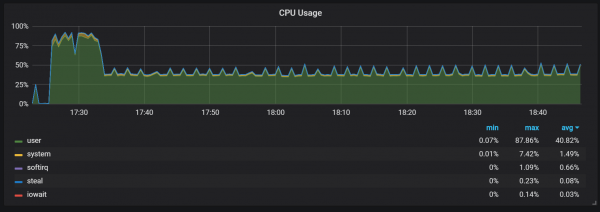
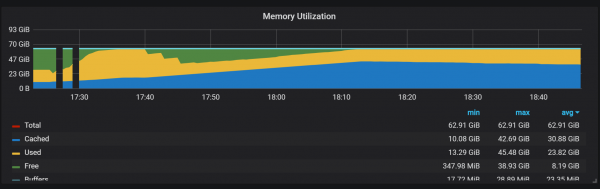
Quedas no uso de memória indicam que o Prometheus não consegue configurar todas as coletas no início, resultando em informação perdida.
Não consegui descobrir as causas exatas da alta carga na CPU e na memória. Suspeito que isso esteja relacionado à criação de novas séries temporais no bloco principal com alta frequência.
Picos de carga na CPU
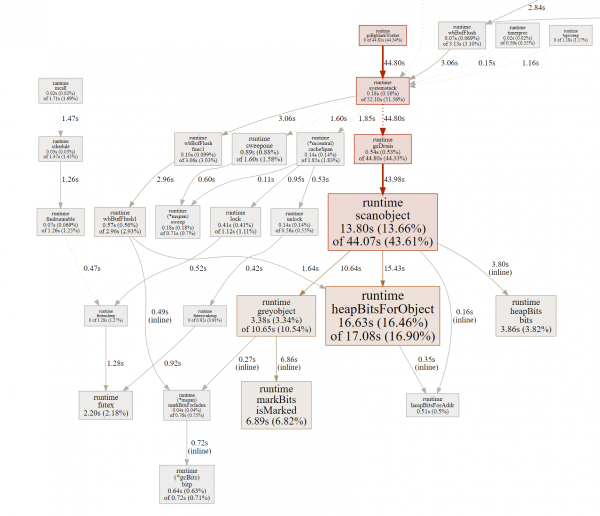
Além dos agrupamentos que geram uma carga bastante alta de I/O, notei picos significativos na carga da CPU a cada dois minutos. Os picos duram mais durante um fluxo de entrada elevado e parecem ser causados pelo coletor de lixo Go, pelo menos alguns núcleos ficam totalmente ocupados.
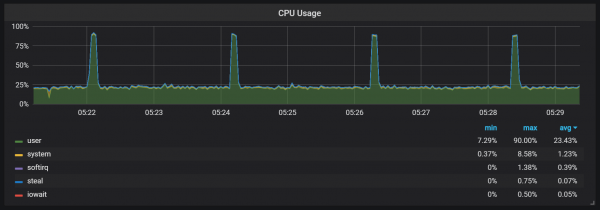
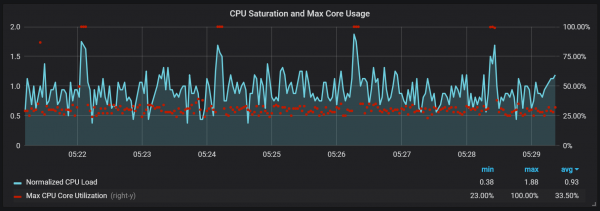
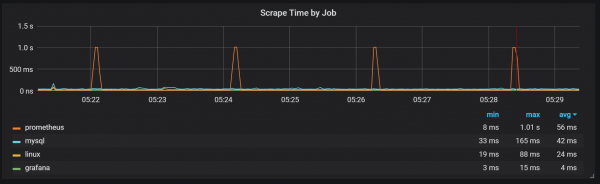
Esses picos não são tão insignificantes. Parece que, quando ocorrem, o ponto de entrada interno e as métricas do Prometheus ficam indisponíveis, o que causa falhas nos dados nesses mesmos intervalos.
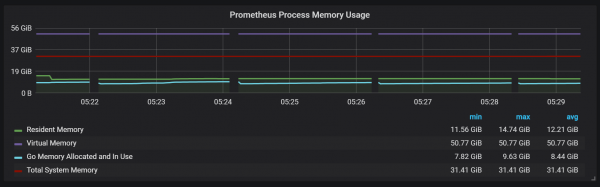
Também é possível notar que o exportador do Prometheus trava por um segundo.
Podemos notar correlações com a coleta de lixo (GC).
Conclusão
O TSDB no Prometheus 2 é rápido, capaz de lidar com milhões de séries temporais e, ao mesmo tempo, com milhares de gravações por segundo, utilizando hardware bastante modesto. A utilização da CPU e de I/O de disco também é impressionante. Meu exemplo mostrou até 200.000 métricas por segundo em um único núcleo utilizado.
Para planejar a expansão, é preciso lembrar de que a memória deve ser suficiente, e isso precisa ser memória real. O volume de memória utilizada que observei era de cerca de 5 GB para 100.000 gravações por segundo de fluxo de entrada, resultando em cerca de 8 GB de memória ocupada somando-se ao cache do sistema operacional.
Certamente, ainda há muito a ser feito para controlar os picos de CPU e I/O de disco, e isso não é surpreendente, considerando o quão jovem o TSDB Prometheus 2 é em comparação com InnoDB, TokuDB, RocksDB, WiredTiger, mas todos eles enfrentaram problemas semelhantes no início de seu ciclo de vida.
Fonte: habr.com
