

Sistema de análise de tráfego sem a sua decodificação. Este método é simplesmente chamado de 'aprendizado de máquina'. Descobriu-se que, se um classificador especial for alimentado com um grande volume de tráfego diversificado, o sistema pode detectar com alta probabilidade as ações do código malicioso dentro do tráfego criptografado.
As ameaças de rede mudaram e se tornaram 'mais inteligentes'. Nos últimos tempos, a própria concepção de ataque e defesa se alterou. O número de eventos na rede aumentou exponencialmente. Os ataques se tornaram mais sofisticados e os hackers agora têm um alcance maior em suas investidas.
De acordo com estatísticas da Cisco, os criminosos aumentaram em 3 vezes o número de programas maliciosos que utilizam para suas atividades, ou mais especificamente, para ocultá-las — através da criptografia. Na teoria, sabe-se que um ‘algoritmo’ de criptografia 'correto' não pode ser quebrado. Para entender o que está oculto dentro do tráfego criptografado, é necessário ou decifrá-lo conhecendo a chave, ou tentar decifrá-lo por meio de várias artimanhas, ou quebrá-lo diretamente, ou explorar vulnerabilidades em protocolos criptográficos.
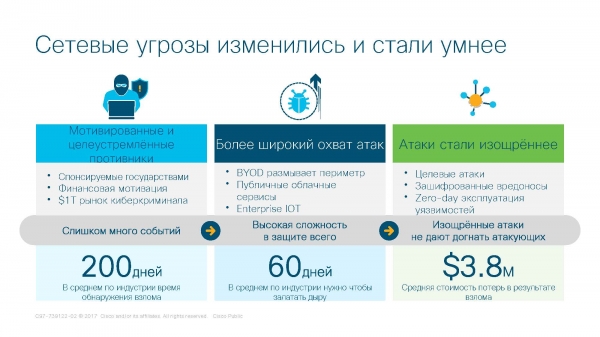
O panorama das ameaças de rede em nosso tempo
Aprendizado de Máquina
Conheça a tecnologia a fundo! Antes de falarmos sobre como funciona a própria tecnologia de decodificação baseada em aprendizado de máquina, é necessário entender como funciona a tecnologia das redes neurais.
O aprendizado de máquina (Machine Learning) é uma vasta subárea da inteligência artificial que estuda métodos para construir algoritmos capazes de aprender. Esta ciência tem como objetivo criar modelos matemáticos para o 'aprendizado' dos computadores. O objetivo do aprendizado é prever algo. Em termos humanos, chamamos esse processo de ‘sabedoria’. A sabedoria se manifesta em pessoas que viveram muitos anos (uma criança de 2 anos não pode ser sábia). Ao pedir conselho a colegas mais velhos, fornecemos a eles alguma informação sobre o evento (dados de entrada) e pedimos ajuda. Eles, por sua vez, lembram de todas as situações da vida que estão de alguma forma relacionadas ao seu problema (base de conhecimento) e, com base nesses conhecimentos (dados), nos oferecem uma espécie de predição (conselho). Esse tipo de conselho foi chamado de predição porque a pessoa que dá o conselho não sabe com certeza o que vai acontecer, apenas supõe. A experiência de vida demonstra que a pessoa pode estar certa, mas também pode errar.
Não se deve comparar redes neurais com um algoritmo de ramificação (if-else). São coisas diferentes e há diferenças-chave entre elas. Vou demonstrar com exemplos.
Tarefa. Determinar a distância de frenagem de um carro com base em sua marca e ano de fabricação.
Exemplo de funcionamento de um algoritmo de ramificação. Se o carro é da marca 1 e fabricado em 2012, sua distância de frenagem é de 10 metros; caso contrário, se o carro for da marca 2 e fabricado em 2011, e assim por diante.
Exemplo de funcionamento de uma rede neural. Coletamos dados sobre distâncias de frenagem de carros nos últimos 20 anos. Com base na marca e no ano, elaboramos uma tabela do tipo 'marca-ano de fabricação-distância de frenagem'. Damos essa tabela para a rede neural e começamos a treiná-la. O treinamento é realizado da seguinte forma: fornecemos dados à rede neural, mas sem a distância de frenagem. A rede tenta prever qual será a distância de frenagem com base na tabela carregada. Ela faz uma previsão e pergunta ao usuário: 'Estou certa?'. Antes da pergunta, ela cria uma quarta coluna - a coluna de adivinhação. Se ela estiver certa, coloca 1 na quarta coluna; se errou, coloca 0. A rede neural avança para o próximo evento (mesmo que tenha cometido um erro). Assim, a rede aprende e, quando o treinamento é concluído (um determinado critério de convergência é alcançado), fornecemos dados sobre o carro que nos interessa e finalmente obtemos a resposta.
Para esclarecer a questão sobre o critério de convergência, explico que se trata de uma fórmula derivada matematicamente para estatística. Um exemplo marcante de duas diferentes fórmulas de convergência. A vermelha - convergência binária, a azul - convergência normal.
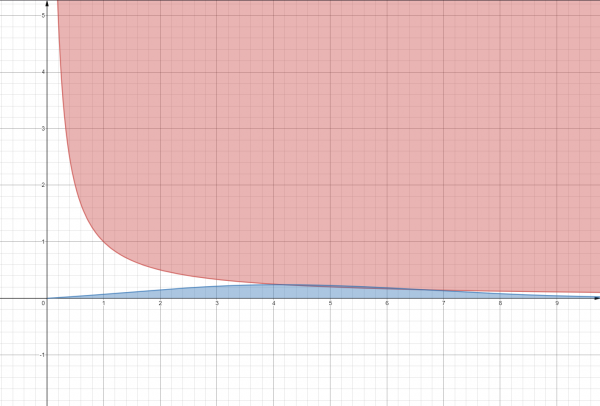
Distribuições binomial e normal de probabilidade
Para tornar mais claro, faça a pergunta "Qual é a probabilidade de encontrar um dinossauro?". Há 2 opções de resposta. Opção 1 – muito baixa (gráfico azul). Opção 2 – ou eu encontro, ou não (gráfico vermelho).
Claro, o computador não é humano e ele aprende de maneira diferente. Existem 2 tipos de aprendizado do ferreiro de ferro – aprendizado por precedentes e aprendizado dedutivo.
O aprendizado por precedentes é uma forma de aprendizado baseada em leis matemáticas. Os matemáticos coletam tabelas estatísticas, fazem inferências e carregam na rede neural o resultado – uma fórmula para cálculo.
O aprendizado dedutivo ocorre inteiramente na rede neural (desde a coleta de dados até a análise). Aqui, forma-se uma tabela sem fórmula, mas com estatísticas.
Uma visão ampla da tecnologia tomaria mais algumas dezenas de artigos. Por enquanto, isso é suficiente para uma compreensão geral.
Neuroplasticidade
Na biologia, existe o conceito de neuroplasticidade. Neuroplasticidade é a capacidade dos neurônios (células do cérebro) de agir "conforme a situação". Por exemplo, uma pessoa que ficou cega ouve melhor os sons, sente os cheiros e percebe os objetos. Isso ocorre porque parte do cérebro (alguns neurônios) responsável pela visão redistribui seu trabalho para outra funcionalidade.
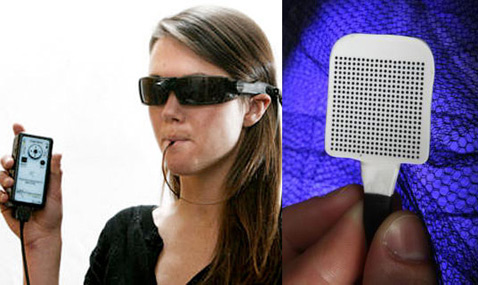
Um exemplo claro de neuroplasticidade na vida é o doce BrainPort.
Em 2009, a Universidade de Wisconsin em Madison anunciou o lançamento de um novo dispositivo que desenvolve as ideias do "display linguístico" – ele foi nomeado BrainPort. O BrainPort funciona segundo este algoritmo: o sinal de vídeo é enviado de uma câmera para um processador, que gerencia o zoom, o brilho e outros parâmetros da imagem. Ele também converte sinais digitais em impulsos elétricos, assumindo, de fato, as funções da retina.
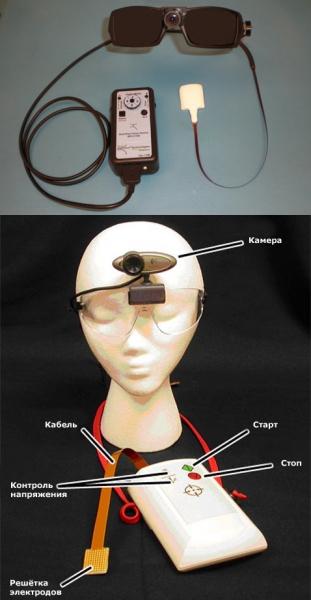
Doce BrainPort com óculos e câmera
BrainPort em funcionamento
O mesmo acontece com o computador. Se a rede neural percebe uma mudança no processo, ela se ajusta a isso. Esse é um dos principais benefícios das redes neurais em comparação com outros algoritmos – a autonomia. É uma espécie de humanidade.
Análise de Tráfego Encriptado
A Análise de Tráfego Criptografado é parte do sistema Stealthwatch. O Stealthwatch é uma solução desenvolvida pela Cisco na área de monitoramento e análise de segurança, que utiliza dados de telemetria corporativa da infraestrutura de rede existente.
Os componentes fundamentais do Stealthwatch Enterprise são a Licença Flow Rate, o Coletor de Fluxo, o Console de Gerenciamento e o Sensor de Fluxo.
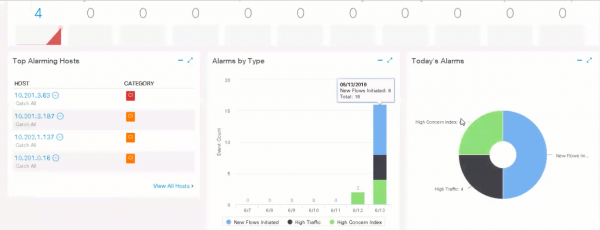
Interface do Cisco Stealthwatch
A questão da criptografia tornou-se bastante crítica, uma vez que a quantidade de tráfego criptografado aumentou significativamente. Anteriormente, apenas o código era criptografado (principalmente), mas agora todo o tráfego é criptografado, tornando muito mais difícil distinguir os dados 'limpos' de vírus. Um exemplo notável é o WannaCry, que utilizou o Tor para ocultar sua presença na rede.
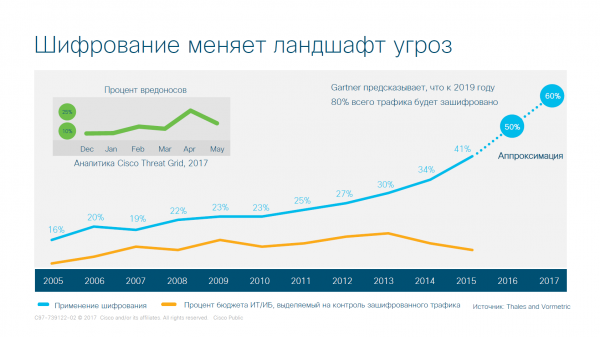
Visualização do aumento da criptografia de tráfego na rede
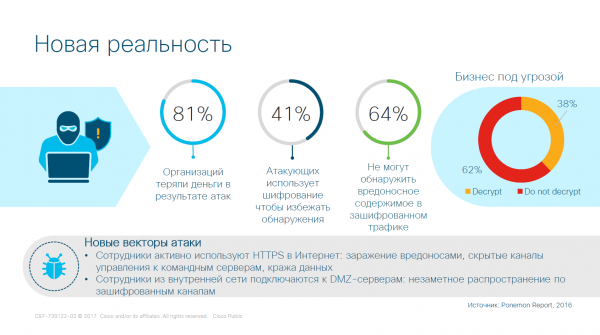
Criptografia na macroeconomia
O sistema Encrypted Traffic Analytics (ETA) é essencial para trabalhar com tráfego criptografado sem a necessidade de descriptografá-lo. Os criminosos são astutos e utilizam algoritmos de criptografia resistentes, e quebrá-los não é apenas um desafio, mas também um investimento extremamente elevado para as organizações.
O sistema funciona da seguinte maneira. Um determinado tráfego chega à empresa. Ele passa pela TLS (transport layer security — protocolo de segurança de transporte). Suponhamos que o tráfego esteja criptografado. Tentamos responder a uma série de perguntas sobre qual conexão foi estabelecida.
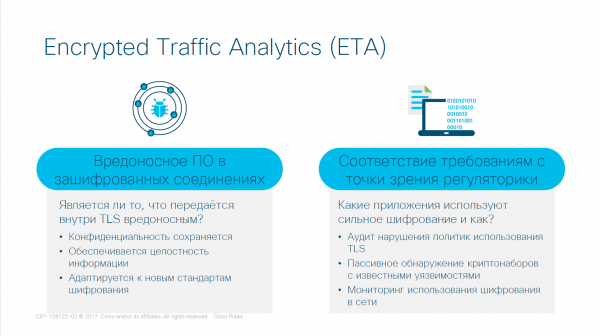
Princípio de funcionamento do sistema Encrypted Traffic Analytics (ETA)
Para responder a essas perguntas, utilizamos aprendizado de máquina neste sistema. Realizam-se estudos da Cisco e, a partir dessas pesquisas, é criada uma tabela com 2 resultados – tráfego malicioso e 'bom' tráfego. Claro, não sabemos com certeza que tipo de tráfego entrou no sistema naquele momento específico, mas podemos rastrear o histórico do tráfego tanto dentro quanto fora da empresa, utilizando dados disponíveis globalmente. No final desta etapa, obtemos uma tabela enorme com dados.
Os resultados da pesquisa revelam características distintas - regras específicas que podem ser expressas de forma matemática. Essas regras variam muito de acordo com diferentes critérios - tamanho dos arquivos transmitidos, tipo de conexão, país de origem do tráfego, etc. Como resultado do trabalho, uma enorme tabela se transformou em um conjunto de fórmulas. Elas diminuíram em número, mas isso ainda não é suficiente para um trabalho confortável.
Em seguida, aplica-se a tecnologia de aprendizado de máquina - a convergência da fórmula e, com base no resultado da convergência, obtemos um gatilho - um interruptor, onde ao sair os dados, obtemos um desligador (flag) em posição elevada ou baixa.
A etapa resultante - a obtenção de um conjunto de gatilhos que cobriu 99% do tráfego.
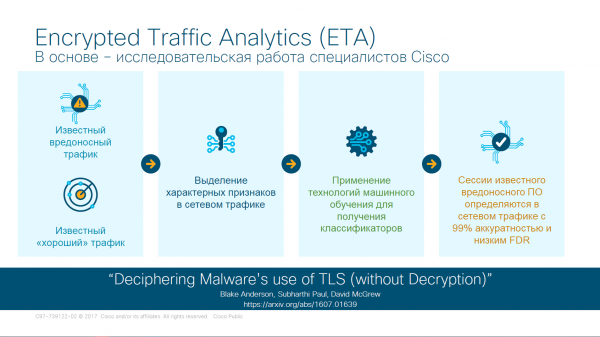
Etapas de verificação do tráfego no ETA
O trabalho resolve mais um problema - um ataque interno. Não são mais necessárias pessoas no meio para filtrar o tráfego manualmente (neste ponto estou me prejudicando). Primeiro, não é mais necessário gastar muito dinheiro em um administrador de sistemas qualificado (continuo me prejudicando). Em segundo lugar, não há mais o risco de invasão interna (pelo menos, parcial).
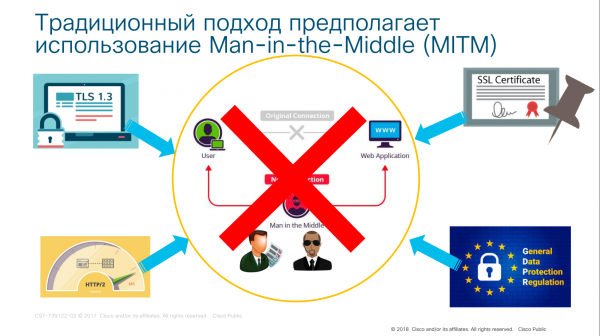
Conceito desatualizado de Man-in-the-Middle
Agora, vamos entender sobre o que a sistema se baseia.
O sistema opera em 4 protocolos de comunicação: TCP/IP - protocolo de transmissão de dados na internet, DNS - servidor de nomes de domínio, TLS - protocolo de segurança de transporte, SPLT (SpaceWire Physical Layer Tester) - testador da camada física de comunicação.
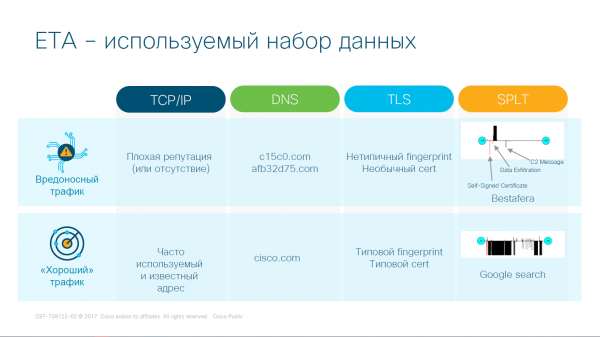
Protocolos operando com ETA
A comparação é feita através da correlação de dados. Com os protocolos TCP/IP, verifica-se a reputação dos sites (histórico de visitas, propósito da criação do site, etc.), graças ao protocolo DNS, podemos descartar endereços de sites 'malignos'. O protocolo TLS trabalha com 'impressões digitais' do site (fingerprint) e verifica o site na base de dados do grupo de resposta a emergências de computadores (cert). A última etapa da verificação da conexão - verificação no nível físico. Os detalhes do funcionamento desta etapa não são discutidos, mas o sentido é o seguinte: verificação de senóides e cossinóides das curvas de transmissão de dados em configurações oscilográficas, ou seja, através da estrutura da solicitação no nível físico, determinamos o objetivo da conexão.
Como resultado do trabalho do sistema, podemos extrair dados do tráfego criptografado. Ao analisar os pacotes, conseguimos ler o máximo de informações dos campos não criptografados dentro do pacote. Através da inspeção do pacote no nível físico, descobrimos características do pacote (parcial ou completamente). Além disso, não devemos esquecer da reputação dos sites. Se a solicitação veio de alguma fonte .onion, não devemos confiá-la. Para facilitar o manuseio desse tipo de dados, foi criado um mapa de riscos.
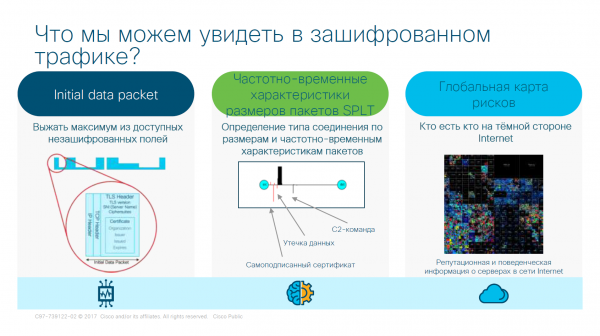
Resultado do trabalho do ETA
E tudo parecia bem, mas vamos falar sobre a implementação da rede.
Implementação física do ETA
Aqui surgem uma série de nuances e sutilezas. Em primeiro lugar, ao criar um tipo de
rede com software de alto nível, é necessário coletar dados. Coletar dados manualmente é totalmente
difícil, e implementar um sistema de resposta – já é mais interessante. Em segundo lugar, os dados
devem ser abundantes, o que significa que os sensores instalados na rede devem funcionar
não apenas de forma autônoma, mas também em um modo fino e ajustado, o que traz uma série de dificuldades.
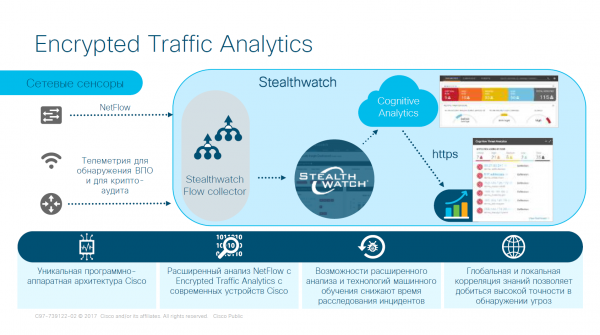
Sensores e sistema Stealthwatch
Instalar um sensor é uma coisa, mas configurá-lo é uma tarefa completamente diferente. Para a configuração dos sensores, há um conjunto que opera na seguinte topologia – ISR = roteador com integração de serviços da Cisco (Cisco Integrated Services Router); ASR = roteador com agregação de serviços da Cisco (Cisco Aggregation Services Router); CSR = roteador de serviços em nuvem da Cisco (Cisco Cloud Services Router); WLC = controlador de redes locais sem fio da Cisco (Cisco Wireless LAN Controller); IE = comutador Ethernet industrial da Cisco (Cisco Industrial Ethernet); ASA = dispositivo de segurança adaptativa da Cisco (Cisco Adaptive Security Appliance); FTD = solução de defesa contra ameaças da Cisco Firepower Threat Defense; WSA = dispositivo de segurança de tráfego web (Web Security Appliance); ISE = módulo de serviços de identificação (Identity Services Engine)
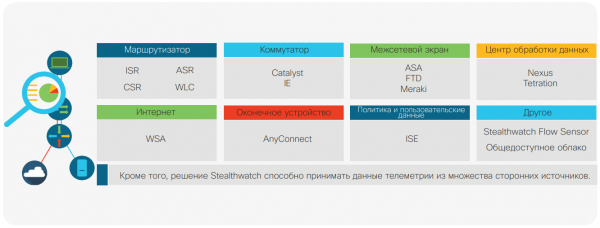
Monitoramento abrangente levando em conta quaisquer dados de telemetria
Os administradores de rede começam a ter arritmia com a quantidade de palavras "Cisco" no parágrafo anterior. O preço dessa maravilha não é pequeno, mas não é sobre isso que falaremos hoje...
A modelagem do comportamento de um hacker ocorrerá da seguinte forma. O Stealthwatch monitora atentamente a atividade de cada dispositivo na rede e é capaz de criar um padrão de comportamento normal. Além disso, essa solução proporciona uma compreensão profunda de comportamentos inadequados conhecidos. Para isso, utiliza cerca de 100 diferentes algoritmos de análise ou regras heurísticas, que se referem a diversos tipos de comportamento de tráfego, como varredura, transmissão de quadros de alerta de nós, entrada no sistema por tentativa de força bruta, captura presumida de dados, vazamentos presumidos de dados, entre outros. Os eventos de segurança listados se enquadram na categoria de alerta lógico de alto nível. Alguns eventos de segurança também podem ativar alarmes por si só. Assim, o sistema é capaz de correlacionar numerosos incidentes anômalos isolados e agrupá-los para determinar o possível tipo de ataque, além de vinculá-lo a um dispositivo específico e a um usuário (figura 2). Posteriormente, o incidente pode ser analisado em dinâmica e com base nos dados de telemetria relacionados. Isso constitui a informação contextual em sua melhor forma. Médicos que examinam um paciente para entender o que aconteceu não consideram os sintomas isoladamente. Eles analisam o todo para fazer um diagnóstico. Da mesma forma, o Stealthwatch registra cada atividade anômala na rede e a estuda de forma integrada, enviando alertas levando em consideração o contexto, ajudando assim os especialistas em segurança a priorizar os riscos.
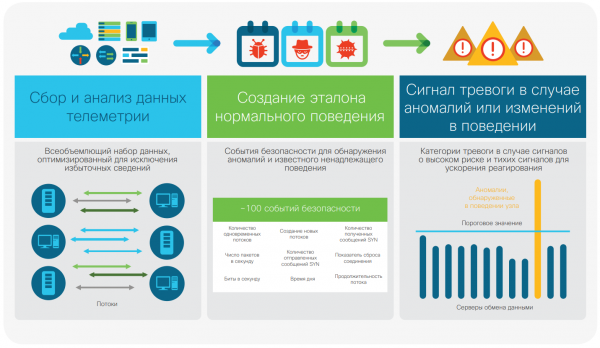
Detecção de anomalias através da modelagem de comportamento
A implantação física da rede se apresenta assim:
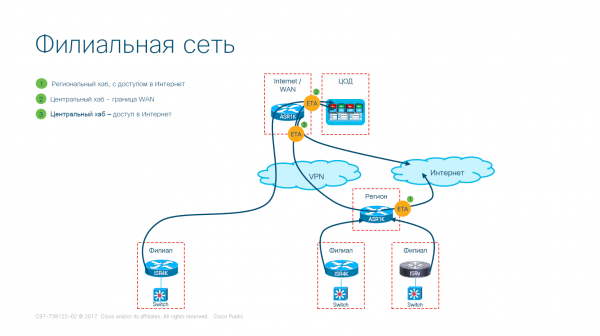
Opção de implantação de rede de filial (simplificada)
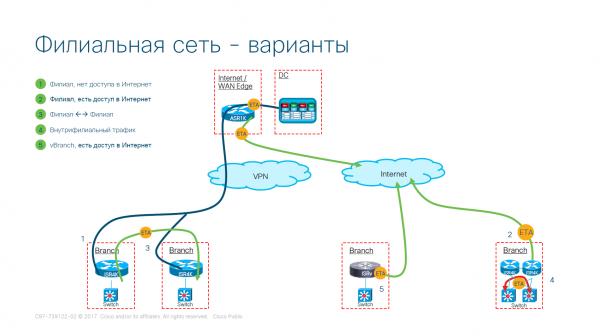
Opção de implantação de rede de filial
A rede foi implantada, mas ainda há uma questão em aberto sobre a rede neural. Foi organizada uma rede de transmissão de dados, instalados sensores nos limites e um sistema de coleta de informações foi lançado, mas a rede neural não participou até o momento.
Rede neural de múltiplas camadas
O sistema analisa o comportamento do usuário e do dispositivo para identificar infecções maliciosas, comunicações com servidores de comando, vazamentos de dados, bem como aplicativos potencialmente indesejados que operam na infraestrutura da organização. Existem vários níveis de processamento de dados, nos quais uma combinação de métodos de inteligência artificial, aprendizado de máquina e estatística matemática ajuda a rede a se auto-aprender sobre sua atividade normal, para que possa identificar atividades maliciosas.
O pipeline de análise de segurança da rede, que coleta dados de telemetria de todas as partes da rede ampliada, incluindo tráfego criptografado, é um recurso único do Stealthwatch. Ele forma gradualmente uma compreensão do que é 'anômalo', depois classifica os elementos individuais da 'atividade suspeita' e, por fim, toma uma decisão final sobre se o dispositivo ou o usuário foram realmente comprometidos. A capacidade de reunir pequenos fragmentos que, juntos, formam evidências para a tomada de uma decisão final sobre a compromissão do objeto é garantida através de uma análise e correlação muito rigorosas.
Essa capacidade é extremamente importante, pois uma empresa padrão pode receber diariamente uma quantidade imensa de alarmes, e investigar cada um deles é inviável — os recursos dos especialistas de segurança são limitados. O módulo de aprendizado de máquina processa uma grande quantidade de informações praticamente em tempo real para identificar incidentes críticos com um alto grau de confiança e também é capaz de sugerir uma ordem clara de ações para resolução rápida.
Vamos explorar mais detalhadamente os diversos métodos de aprendizado de máquina utilizados no Stealthwatch. Quando um incidente é enviado para o módulo de aprendizado de máquina do Stealthwatch, ele passa por um funil de análise de segurança, onde combina métodos de aprendizado de máquina supervisionado e não supervisionado.
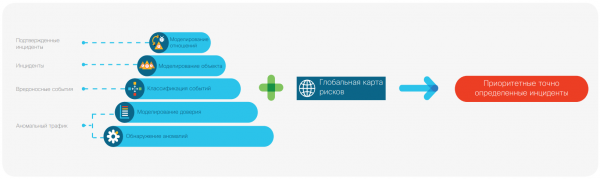
Capacidades de aprendizado de máquina em múltiplos níveis
Nível 1. Detecção de anomalias e modelagem de confiança
Neste nível, 99% do tráfego é descartado através de detectores de anomalias estatísticas. Os sensores mencionados colaboram para formar modelos complexos do que é normal e, contrariamente, o que é anômalo. Contudo, o anômalo não é necessariamente malicioso. Muito do que acontece em sua rede não está relacionado a ameaças — é apenas estranho. É importante classificar esses processos independentemente do comportamento ameaçador. Por esse motivo, os resultados do trabalho desses detectores passam por uma análise adicional para identificar comportamentos estranhos que podem ser explicados e nos quais podemos confiar. No final, apenas uma pequena fração dos fluxos e solicitações mais relevantes avança para os níveis 2 e 3. Sem a aplicação de tais métodos de aprendizado de máquina, os custos operacionais para separar o sinal do ruído seriam excessivos.
Detecção de anomalias. Na primeira etapa da detecção de anomalias, são utilizados métodos estatísticos de aprendizado de máquina para separar o tráfego estatisticamente normal do anômalo. Mais de 70 detectores distintos processam os dados de telemetria coletados pelo Stealthwatch sobre o tráfego que passa pelo perímetro de sua rede, separando o tráfego interno do sistema de nomes de domínio (DNS) e os dados do servidor proxy, quando disponíveis. Cada solicitação é processada por mais de 70 detectores, com cada detector utilizando seu próprio algoritmo estatístico para formar uma avaliação das anomalias identificadas. Essas avaliações são combinadas, resultando em uma única estimativa para cada solicitação individual, que é então utilizada para separar o tráfego normal do anômalo.
Modelagem de confiança. Em seguida, as solicitações semelhantes são agrupadas, e a avaliação acumulada de anomalias para esses grupos é definida como a média de longo prazo. Com o tempo, mais solicitações são analisadas e submetidas à determinação da média de longo prazo, o que permite reduzir disparos falsos positivos e falsos negativos. Os resultados da modelagem de confiança são utilizados para selecionar um subconjunto de tráfego, cuja avaliação de anomalias excede um determinado valor limite definido dinamicamente, para ser movido para o próximo nível de processamento.
Nível 2. Classificação de eventos e modelagem de objetos
Neste nível, acontece a classificação dos resultados obtidos nas etapas anteriores, atribuindo-os a eventos maliciosos específicos. A classificação de eventos é realizada com base nos valores atribuídos pelos classificadores de aprendizado de máquina com o objetivo de manter um índice de precisão constante acima de 90%. Entre eles estão:
- modelos lineares baseados no lema de Neyman-Pearson (a lei da distribuição normal do gráfico no início do artigo)
- máquinas de vetor de suporte, usando aprendizado multivariado
- redes neurais e o algoritmo de 'floresta aleatória'.
Em seguida, esses eventos de segurança isolados são ligados, ao longo do tempo, a um único dispositivo final. É nesta fase que uma descrição da ameaça é formada, com base na qual é criada uma visão completa de como o respectivo criminoso conseguiu alcançar determinados resultados.
Classificação de eventos. Um subconjunto estatisticamente anômalo do nível anterior é distribuído em 100 ou mais categorias com o auxílio de classificadores. A maioria dos classificadores é baseada em comportamento individual, relações em grupo ou comportamento em uma escala global ou local, enquanto outros podem ser bastante específicos. Por exemplo, um classificador pode indicar tráfego de servidores de comando, uma extensão suspeita ou uma atualização de software não autorizada. Com os resultados desta etapa, é formado um conjunto de eventos anômalos na segurança do sistema, classificados em categorias específicas.
Modelagem de objetos. Se a quantidade de evidências que apoiam a hipótese sobre a maliciosidade de um determinado objeto ultrapassar um limiar significativo, a ameaça é identificada. Eventos relevantes que impactaram a definição da ameaça são associados a essa ameaça e tornam-se parte de um modelo discreto de longo prazo do objeto. À medida que as evidências se acumulam ao longo do tempo, o sistema identifica novas ameaças ao atingir o limiar de significância. Este limiar possui um caráter dinâmico e passa por ajustes inteligentes com base no nível de risco da ameaça e outros fatores. Após isso, a ameaça aparece no painel de controle da interface web e é elevada para o próximo nível.
Nível 3. Modelagem de Relações
O objetivo da modelagem de relações é sintetizar os resultados obtidos nos níveis anteriores, de uma perspectiva global, levando em consideração não apenas o contexto local, mas também o contexto global do incidente correspondente. É neste estágio que você pode determinar quantas organizações enfrentaram tal ataque, para entender se ele foi direcionado especificamente a você ou se faz parte de uma campanha global, e você simplesmente foi 'atirado na linha de fogo'.
Os incidentes são confirmados ou descobertos. Um incidente confirmado implica uma confiança de 99 a 100%, uma vez que os métodos e ferramentas relevantes foram observados anteriormente em ação em uma escala maior (global). Incidentes descobertos são únicos para você e fazem parte de uma campanha mais direcionada. Os resultados obtidos no passado são transmitidos com a indicação de uma sequência de ações conhecida, permitindo economizar seu tempo e recursos em resposta. Eles vêm acompanhados de ferramentas de investigação que você precisará para entender quem o atacou, bem como qual é o grau de direcionamento da campanha em relação ao seu negócio digital. Como você pode imaginar, o número de incidentes confirmados supera em muito o número de incidentes descobertos, simplesmente porque os incidentes confirmados não envolvem custos altos para os atacantes, enquanto os incidentes descobertos têm um custo associado.
caro, pois precisam ser novos e personalizados. Ao criar a oportunidade de identificar incidentes confirmados, a economia do jogo finalmente mudou a favor dos defensores, proporcionando-lhes uma certa vantagem.
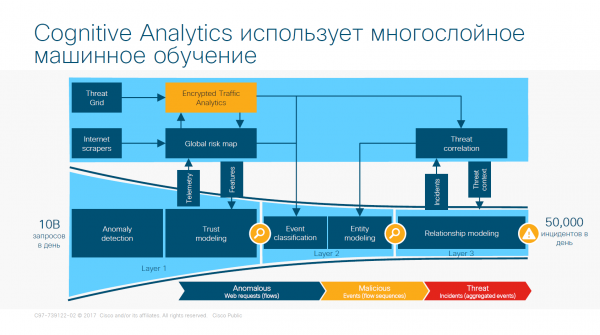
Aprendizado em múltiplas camadas do sistema de redes neurais baseado em ETA
Mapa global de riscos
O mapa global de riscos é criado a partir da análise aplicada por algoritmos de aprendizado de máquina a um dos maiores conjuntos de dados do setor. Ele fornece amplas estatísticas sobre o comportamento de servidores na Internet, mesmo aqueles desconhecidos. Esses servidores estão associados a ataques, podendo ser utilizados ou mobilizados em futuros ataques. Não se trata de uma 'lista negra', mas sim de uma visão abrangente do servidor em questão do ponto de vista de segurança. Essas informações sobre a atividade dos servidores indicados, preparadas com consideração ao contexto, permitem que detectores e classificadores de aprendizado de máquina Stealthwatch prevejam com precisão o nível de risco associado à comunicação com esses servidores.
Você pode visualizar os mapas disponíveis .
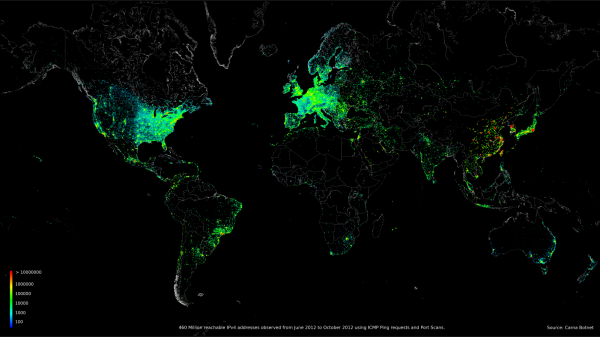
Mapa do mundo mostrando 460 milhões endereços IP
Agora a rede está aprendendo e se protegendo contra a sua rede.
Finalmente, encontrou-se a panaceia?
Infelizmente, não. A partir da experiência com o sistema, posso dizer que existem 2 problemas globais.
Problema 1. Custo. Toda a rede é implantada em sistema Cisco. Isso é bom e ruim. O lado bom é que você não precisa se preocupar e colocar um monte de soluções temporárias como D-Link, MikroTik, etc. O lado negativo – o custo imenso do sistema. Considerando o estado econômico das empresas russas, no momento, apenas um proprietário rico de uma grande empresa ou banco pode se dar ao luxo dessa maravilha.
Problema 2. Treinamento. Eu não mencionei no artigo o tempo de treinamento da rede neural, não porque ele não exista, mas porque ela está sempre aprendendo e não conseguimos prever quando ela realmente aprenderá. Claro, existem ferramentas de estatística matemática (como a formulação do critério de convergência de Pearson), mas isso é apenas uma solução temporária. Obtivemos a probabilidade de filtragem do tráfego, embora isso seja sob a condição de que o ataque já foi compreendido e é conhecido.
Apesar desses 2 problemas, fizemos um grande avanço no desenvolvimento da segurança da informação como um todo e na proteção de redes em particular. Esse fato pode ser motivador para o estudo de tecnologias de rede e redes neurais, que são atualmente uma área muito promissora.
Fonte: habr.com
