

Olá, sou Dmitry Logvinenko — Engenheiro de Dados do departamento de análise do grupo de empresas "Veze't".
Vou lhe falar sobre uma ferramenta incrível para o desenvolvimento de processos ETL — Apache Airflow. Mas o Airflow é tão versátil e multifacetado que você deve considerá-lo mesmo que não trabalhe com fluxos de dados, mas precise periodicamente executar alguns processos e monitorar sua execução.
E sim, não vou apenas falar, mas também mostrar: o programa contém muito código, capturas de tela e recomendações.
O que geralmente você vê ao pesquisar a palavra Airflow / Wikimedia Commons
Índice
Introdução
Apache Airflow — ele é como Django:
- escrito em Python,
- possui uma excelente interface administrativa,
- é ilimitadamente expansível,
— apenas melhor, e feito para objetivos completamente diferentes, a saber (como está escrito até o kata):
- execução e monitoramento de tarefas em um número ilimitado de máquinas (o que seu Celery/Kubernetes e sua consciência permitirem)
- com geração dinâmica de workflows a partir de código Python que é muito fácil de escrever e entender
- e a capacidade de conectar qualquer banco de dados e API usando tanto componentes prontos quanto plugins personalizados (o que é feito de forma extremamente simples).
Usamos Apache Airflow assim:
- coletamos dados de várias fontes (vários instâncias de SQL Server e PostgreSQL, diversas APIs com métricas de aplicativos, até mesmo 1C) em DWH e ODS (para nós isso é Vertica e Clickhouse).
- como um avançado
cron, que inicia processos de consolidação de dados no ODS, além de monitorar sua manutenção.
Até recentemente, nossas necessidades eram atendidas por um pequeno servidor com 32 núcleos e 50 GB de RAM. No Airflow, operamos:
- mais de 200 dags (na verdade, workflows nos quais agrupamos as tarefas),
- cada um com uma média de 70 tarefas,
- isso é ativado (também em média) uma vez por hora.
E sobre como expandimos, escreverei abaixo, mas agora vamos definir a über-tarefa que iremos resolver:
Existem três SQL Servers de origem, cada um com 50 bancos de dados — instâncias de um único projeto, portanto, a estrutura deles é a mesma (quase em todos os lugares, muahaha), o que significa que cada um deles possui uma tabela Orders (felizmente, uma tabela com esse nome pode ser inserida em qualquer negócio). Estamos coletando dados, adicionando campos de controle (servidor de origem, banco de origem, identificador da tarefa ETL) e ingenuamente os jogaremos em, digamos, Vertica.
Vamos lá!
Parte principal, prática (e um pouco teórica)
Por que precisamos dele (e você também)
Quando as árvores eram grandes e eu era simples SQL- servidor em um varejo russo, acelerávamos processos ETL, ou seja, fluxos de dados, com duas ferramentas disponíveis para nós:
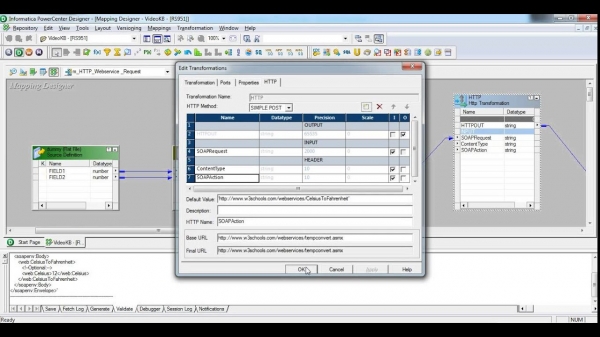
- Informatica Power Center — um sistema extremamente complexo, altamente produtivo, com seu próprio hardware e versionamento. Usei, se Deus quiser, 1% de suas capacidades. Por quê? Bem, primeiro, essa interface é algo dos anos 2000, que psicologicamente nos pressionava. Em segundo lugar, essa ferramenta é projetada para processos extremamente elaborados, reutilização feroz de componentes e outras funcionalidades muito importantes para enterprise. Sobre o fato de que custa o mesmo que a asa de um Airbus A380/ano, ficaremos em silêncio.
Cuidado, a captura de tela pode machucar um pouco pessoas com menos de 30 anos.

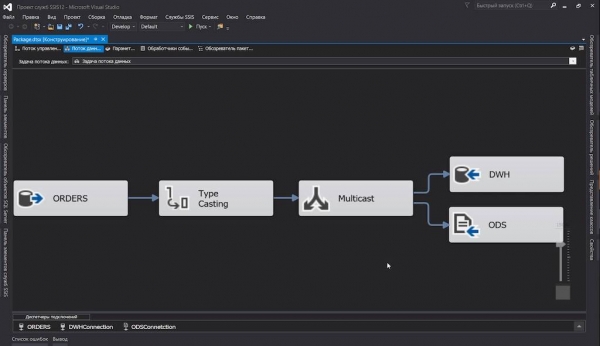
- SQL Server Integration Server — essa ferramenta foi usada em nossos fluxos internos do projeto. Afinal, já estamos usando SQL Server, e não usar suas ferramentas ETL seria algo insensato. Tudo nele é bom: a interface é bonita e os relatórios de execução... Mas não é por isso que amamos produtos de software, oh não é por isso. Podemos versionar
dtsx(que é um XML com nós se misturando ao salvar), mas e daí? E para criar um pacote de tarefas que transfira cem tabelas de um servidor para outro? Sim, o que é cem, se você tentar arrastar vinte, seu dedo indicador vai falhar com o clique do mouse. Mas com certeza parece mais moderno:
Certamente estávamos buscando soluções. A questão quase chegou a um gerador de pacotes SSIS feito por nós mesmos... ... e então eu encontrei um novo trabalho. E nesse trabalho, fui alcançado pelo Apache Airflow.
Quando descobri que as descrições dos processos ETL eram apenas código Python, quase não dancei de alegria. Assim, os fluxos de dados foram versionados e diffs, e empilhar tabelas com uma estrutura única de cem bancos de dados em um único alvo tornou-se uma tarefa de código Python em uma tela de 13 polegadas de um a dois.
Quando soube que as descrições dos processos ETL eram apenas um código simples em Python, quase pulei de alegria. Assim, os fluxos de dados passaram a ser versionados e diferenciados, e consolidar tabelas com uma estrutura única de cem bancos de dados em um único destino se tornou uma tarefa do código Python em uma tela de 13” de um a dois.
Montando um cluster
Vamos evitar transformar isso em um verdadeiro parquinho e não falar sobre coisas tão óbvias como a instalação do Airflow, o banco de dados que vocês escolheram, o Celery e outras questões descritas na documentação.
Para que possamos começar imediatamente os experimentos, eu esbocei docker-compose.yml onde:
- Vamos levantar propriamente dito Airflow: Scheduler, Webserver. Será lá que o Flower vai rodar para monitorar as tarefas do Celery (porque já foi incluído no
apache/airflow:1.10.10-python3.7, e nós não nos opomos a isso); - PostgreSQL, onde o Airflow escreverá suas informações de serviço (dados do agendador, estatísticas de execução, etc.), e o Celery marcará as tarefas concluídas;
- Redis, que atuará como corretor de tarefas para o Celery;
- Trabalhador do Celery, que ficará responsável pela execução direta das tarefas.
- Na pasta
. /dagsvamos colocar nossos arquivos com a descrição dos dag. Eles serão capturados em tempo real, então não é necessário reiniciar toda a pilha a cada pequena mudança.
Em alguns lugares, o código nos exemplos não é fornecido completamente (para não sobrecarregar o texto), e em outros ele é modificado durante o processo. Exemplos de código funcionais podem ser vistos no repositório. .
docker-compose.yml
versão: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis como um broker de Celery
  broker:
    image: redis:6.0.5-alpine

  # DB para os metadados do Airflow
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Contêiner principal com o Webserver do Airflow, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Webserver do Airflow
      - 8080:8080

  # Worker do Celery, será escalado usando `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Notas:
- Na configuração do compose, eu me baseei muito na imagem conhecida — não deixe de conferir. Pode ser que você não precise de mais nada na sua vida.
- Todas as configurações do Airflow estão disponíveis não apenas através de
airflow.cfg, mas também através de variáveis de ambiente (graças aos desenvolvedores), o que eu usei intensamente. - Naturalmente, não é pronto para produção: eu intencionalmente não configurei heartbeat para os contêineres e não me preocupei com segurança. Mas eu fiz um mínimo adequado para nossos experimentos.
- Observe que:
- A pasta com os dags deve ser acessível tanto para o agendador quanto para os workers.
- O mesmo se aplica a todas as bibliotecas externas — todas devem estar instaladas nas máquinas com o agendador e os workers.
Agora, de forma simples:
$ docker-compose up --scale worker=3Depois que tudo estiver funcionando, você pode verificar as interfaces web:
- Airflow:
- Flower:
Conceitos principais
Se você não entendeu nada sobre todos esses "dags", aqui está um breve glossário:
- Agendador — o cara mais importante do Airflow, que controla para que sejam os robôs e não os humanos que trabalhem: ele gerencia o cronograma, atualiza os dags e inicia as tarefas.
Na verdade, nas versões antigas, ele tinha problemas de memória (não, não é amnésia, mas sim vazamentos) e os configs ainda têm um parâmetro legado
run_duration— o intervalo de reinício. Mas agora está tudo bem. - DAG (também conhecido como "dag") — "grafo dirigido acíclico", mas essa definição pouco diz a alguém, e, na essência, é um contêiner para tarefas que interagem entre si (veja abaixo) ou equivalente a um Pacote no SSIS e um Fluxo de Trabalho no Informatica.
Além dos dags, também podem existir subdags, mas provavelmente não chegaremos a eles.
- Execução do DAG — um dag inicializado, ao qual foi atribuído seu
execution_date. As execuções de um mesmo dag podem funcionar em paralelo (se você, claro, tornar suas tarefas idempotentes). - Operador — são pedaços de código responsáveis por executar uma ação específica. Existem três tipos de operadores:
- ação, como nosso amado
PythonOperator, que pode executar qualquer código Python (válido); - transferência, que movimentam dados de um lugar para outro, digamos,
MsSqlToHiveTransfer; - sensor — permitirá reagir ou atrasar a execução do dag até que algum evento aconteça.
HttpSensorpode chamar o endpoint especificado, e quando recebe a resposta necessária, inicia a transferênciaGoogleCloudStorageToS3Operator. Uma mente curiosa perguntará: "por que? Afinal, podemos fazer repetições diretamente no operador!" E então, para não sobrecarregar o pool de tarefas com operadores pendentes. O sensor é iniciado, verifica e morre até a próxima tentativa.
- ação, como nosso amado
- Tarefa — operadores declarados, independentemente do tipo, anexados ao dag, são elevados ao status de tarefa.
- Instância da Tarefa — quando o planejador-geral decide que é hora de enviar as tarefas para os executores-trabalhadores (diretamente no local, se estivermos usando
LocalExecutorou em um nó remoto no caso doCeleryExecutor), ele atribui um contexto (ou seja, um conjunto de variáveis — parâmetros de execução), expande os templates de comandos ou consultas e os coloca no pool.
Gerando tarefas
Primeiro, definiremos o esquema geral do nosso dag, e então vamos mergulhar cada vez mais nos detalhes, porque aplicamos algumas soluções não triviais.
Então, em sua forma mais simples, esse dag parecerá assim:
from datetime import timedelta, datetime

from airflow import DAG
from airflow.operators.python_operator import PythonOperator

from commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Vamos entender:
- Primeiro, importamos as bibliotecas necessárias e algo mais;
sql_server_dssejaList[namedtuple[str, str]]com os nomes das conexões do Airflow Connections e os bancos de dados dos quais vamos extrair nossa tabela;dagé a declaração do nosso DAG, que deve estar obrigatoriamente emglobals(), caso contrário, o Airflow não irá encontrá-lo. Também precisamos informar ao DAG:- qual é o seu nome
orders— este nome aparecerá na interface da web, - que ele começará a trabalhar à meia-noite do dia oito de julho,
- e que deve ser executado a cada 6 horas, aproximadamente (para os caras legais, ao invés de
timedelta()pode ser usadocron-string0 0 0/6 ? * * *, para os menos legais — uma expressão como@daily);
- qual é o seu nome
workflow()fará o trabalho principal, mas não agora. Agora, vamos apenas despejar nosso contexto no log.- E agora a mágica simples de criar tarefas:
- iteramos sobre nossas fontes;
- inicializamos
PythonOperator, que executará nossa tarefa vaziaworkflow(). Não se esqueça de especificar um nome único (dentro do DAG) para a tarefa e ligá-la ao próprio DAG. A flagprovide_contextpor sua vez, vai adicionar argumentos adicionais à função, que vamos coletar cuidadosamente com**context.
Por enquanto, isso é tudo. O que conseguimos:
- um novo DAG na interface da web,
- cento e cinquenta tarefas que serão executadas em paralelo (se as configurações do Airflow, Celery e a capacidade dos servidores permitirem).
Bem, quase conseguimos.
Quem vai definir as dependências?
Para simplificar tudo isso, eu integrei na docker-compose.yml processamento requirements.txt em todos os nós.
Agora vai começar:
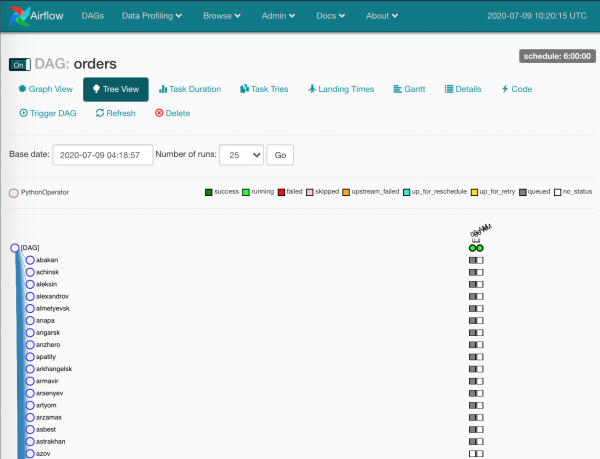
Os quadrados cinzentos são instâncias de tarefas, processadas pelo agendador.
Aguardamos um pouco, as tarefas são pegas pelos workers:
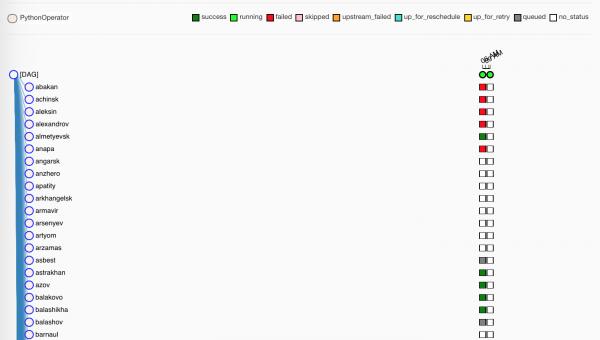
Verde, claro, significa que foram executadas com sucesso. Vermelho — não tão bem.
A propósito, no nosso ambiente de produção, não há nenhuma pasta
. /dags, sincronizada entre as máquinas — todos os DAGs estão emgitno nosso Gitlab, e o Gitlab CI distribui as atualizações nas máquinas durante o merge emmaster.
Um pouco sobre Flower
Enquanto os workers executam nossas tarefas vazias, lembremos de outra ferramenta que pode nos mostrar algumas informações — Flower.
A primeira página com informações resumidas sobre os nós-workers:
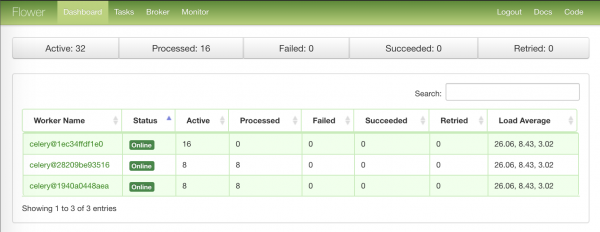
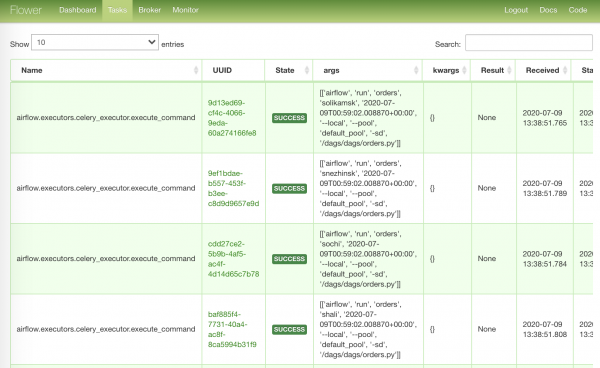
A página mais detalhada com as tarefas que foram enviadas para execução:
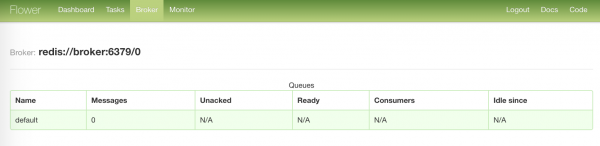
A página mais chata com o estado do nosso corretor:
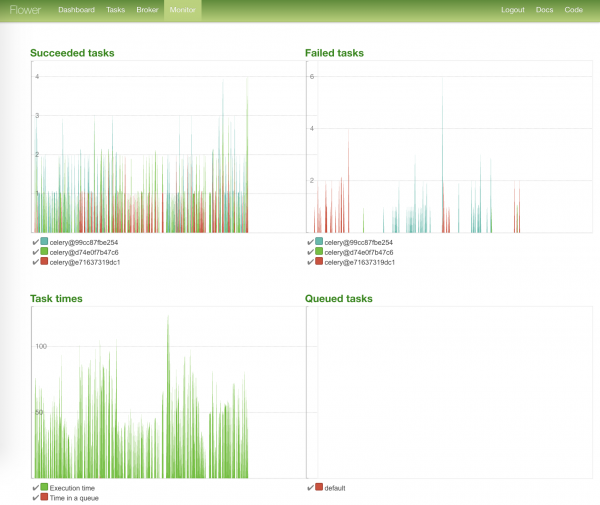
A página mais colorida — com gráficos do estado das tarefas e seu tempo de execução:
Carregando o que não foi carregado
Então, todas as tarefas foram concluídas, é hora de levar os feridos.
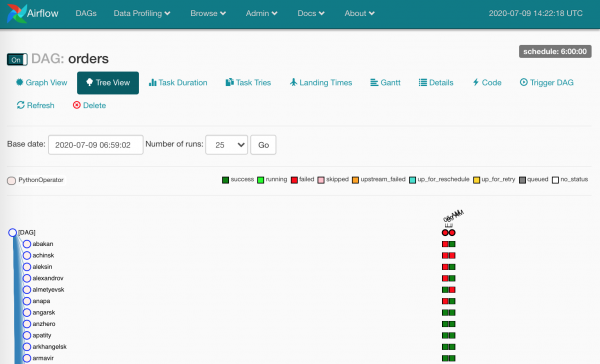
E os feridos foram muitos — por vários motivos. Se o Airflow for usado corretamente, esses quadrados indicam que os dados definitivamente não chegaram.
É preciso verificar o log e reiniciar as instâncias de tarefa que falharam.
Ao clicar em qualquer quadrado, veremos as ações disponíveis para nós:
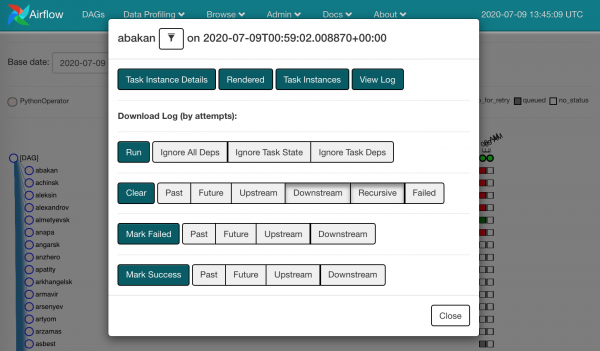
Podemos pegar e fazer Clear na que falhou. Isso significa que nos esquecemos de que algo travou, e a mesma instância da tarefa irá para o planejador.
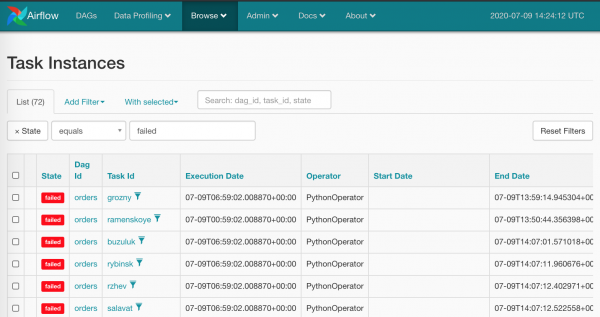
É claro que fazer isso com todos os quadrados vermelhos com o mouse não é muito humanitário — não é isso que esperamos do Airflow. Naturalmente, temos uma arma de destruição em massa: Browse/Task Instances
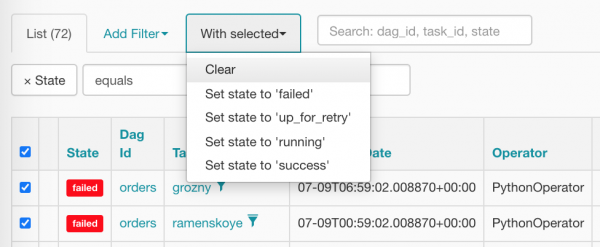
Vamos selecionar tudo de uma vez e zerar, clicando na opção correta:
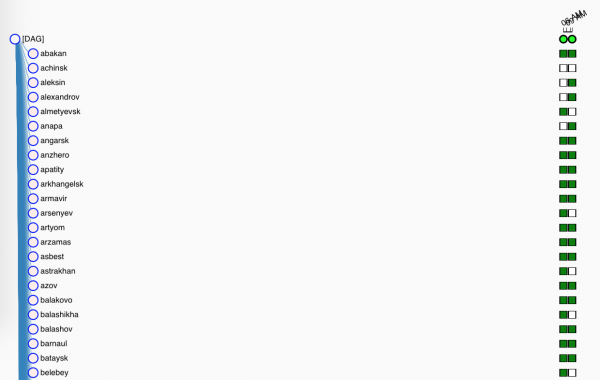
Após a limpeza, nossas tasks ficam assim (já estão ansiosas para que o scheduler as agende):
Conexões, hooks e outras variáveis
É hora de olhar para o próximo DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Prezados, os relatórios foram atualizados"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, acorde, nós derrubamos {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Todos já fizemos uma atualização de relatórios, certo? Aqui está ela novamente: temos uma lista de fontes de onde obter dados; uma lista de destinos; e não podemos esquecer de avisar quando tudo acontece ou quebra (bem, isso não se aplica a nós).
Vamos rever o arquivo e olhar para as novas coisas confusas:
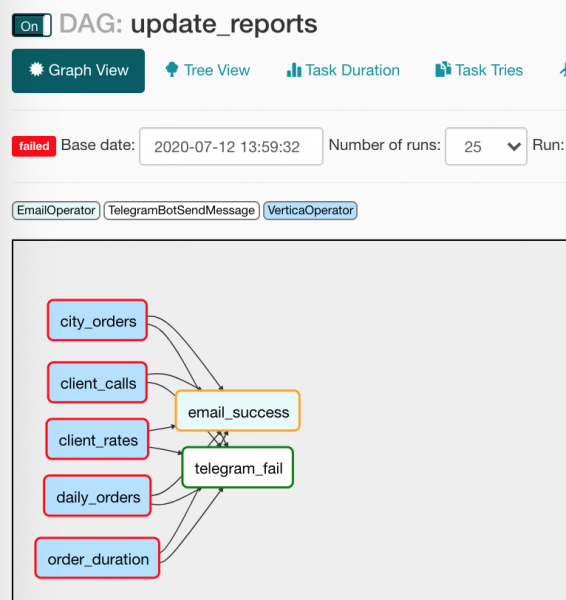
from commons.operators import TelegramBotSendMessage— não há nada que nos impeça de criar nossos próprios operadores, e assim fizemos, criando uma pequena camada para enviar mensagens no Desbloqueado. (Sobre este operador, falaremos mais abaixo);default_args={}— o DAG pode fornecer os mesmos argumentos a todos os seus operadores;to='{{ var.value.all_the_kings_men }}'— campoparanão será hardcoded, mas será gerado dinamicamente usando Jinja e a variável com a lista de emails, que eu gentilmente coloquei emAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— condição de acionamento do operador. No nosso caso, o email será enviado aos chefes apenas se todas as dependências forem executadas com sucesso;tg_bot_conn_id='tg_main'— argumentosconn_idrecebem os identificadores de conexões que criamos emAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— mensagens no Telegram serão enviadas apenas se houver tarefas falhas;task_concurrency=1— proibimos a execução simultânea de várias instâncias de tarefas da mesma tarefa. Caso contrário, teremos a execução simultânea de váriasVerticaOperator(observando uma tabela);report_update >> [email, tg]— todosVerticaOperatorse reunir para enviar um email e uma mensagem, assim:

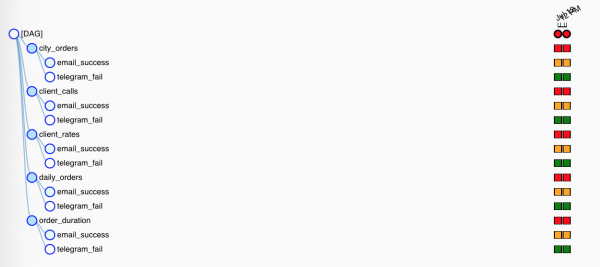
Mas como os operadores de notificação têm diferentes condições de acionamento, apenas um funcionará. No Tree View, tudo parece um pouco menos claro:

Vou dizer algumas palavras sobre macros e seus amigos — de variáveis.
Macros são placeholders Jinja que podem inserir várias informações úteis nos argumentos dos operadores. Por exemplo, assim:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} será expandido no conteúdo da variável de contexto execution_date no formato YYYY-MM-DD: 2020-07-14. O mais legal é que as variáveis de contexto estão atreladas a uma instância específica da tarefa (um quadrado no Tree View), e ao reiniciar, os placeholders se expandirão nos mesmos valores.
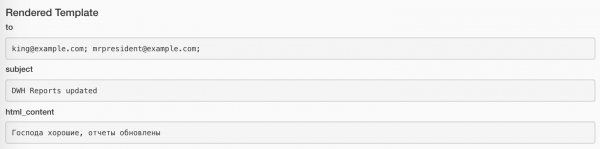
Os valores atribuídos podem ser visualizados usando o botão Rendered em cada instância de tarefa. Assim é para a tarefa de envio de email:
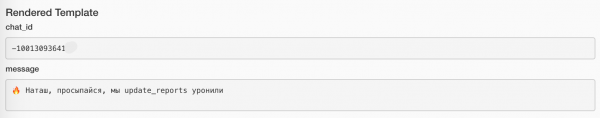
E assim para a tarefa de envio de mensagem:
Uma lista completa de macros integrados para a última versão disponível está disponível aqui:
Além disso, com a ajuda de plugins, podemos declarar nossas próprias macros, mas essa já é uma história completamente diferente.
Além de variáveis predefinidas, podemos inserir valores das nossas variáveis (já utilizei isso anteriormente no código). Vamos criar em Admin/Variables algumas variáveis:
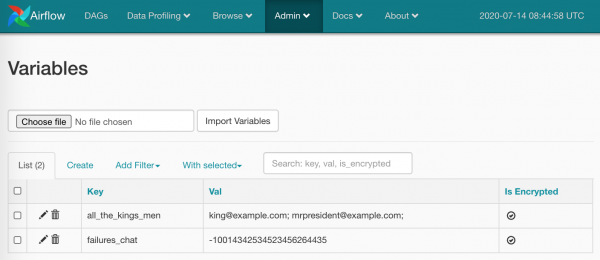
Pronto, podemos usar:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')O valor pode ser escalar ou até JSON. No caso do JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
basta usarmos o caminho para a chave desejada: {{ var.json.bot_config.bot.token }}.
Deixe-me mencionar uma palavra e mostrar uma captura de tela sobre conexões. Aqui é tudo simples: na página Admin/Connections criamos a conexão, inserimos nossos logins/senhas e parâmetros mais específicos. Assim:
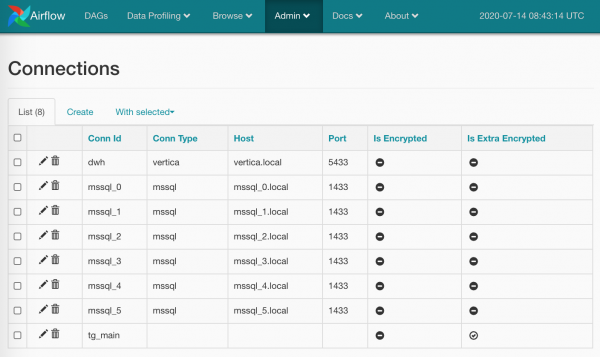
As senhas podem ser criptografadas (de maneira mais segura do que na opção padrão), ou podemos não especificar o tipo de conexão (como fiz para tg_main) — o fato é que a lista de tipos está embutida nos modelos do Airflow e não pode ser alterada sem mexer no código-fonte (se por acaso eu não pesquisei corretamente — por favor, me corrijam), mas obter as credenciais simplesmente pelo nome não deve ser um problema.
Além disso, é possível fazer várias conexões com o mesmo nome: nesse caso, o método BaseHook.get_connection(), que nos fornece conexões pelo nome, retornará um aleatório entre vários homônimos (seria mais lógico fazer Round Robin, mas deixemos isso a critério dos desenvolvedores do Airflow).
Variáveis e Conexões são, sem dúvida, ótimas ferramentas, mas é importante não perder o equilíbrio: quais partes de seus fluxos você armazena no código, e quais você delega ao armazenamento do Airflow. Por um lado, mudar rapidamente o valor, por exemplo, da caixa de correio, pode ser conveniente através da interface. Por outro lado, estamos voltando à questão do clique do mouse, da qual queríamos nos livrar.
Trabalhar com conexões é uma das tarefas ganchos. No geral, os hooks do Airflow são pontos de conexão do mesmo com serviços e bibliotecas externas. Por exemplo, JiraHook abrirá para nós um cliente para interação com o Jira (podemos mover as tarefas de lá para cá), e com o SambaHook podemos enviar um arquivo local para o ponto smb.E agora chegamos perto de analisar como o
Analisando um operador personalizado
TelegramBotSendMessage commons/operators.py
Código funciona com o operador: com o próprio operador:
from typing import Union

from airflow.operators import BaseOperator

from commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Enviar mensagem para chat_id usando TelegramBotHook

    Exemplo:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} falhou :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Enviar "{self.message}" para o chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Aqui, como em todo o Airflow, tudo é muito simples:
- Herança de
BaseOperator, que implementa muitas coisas específicas do Airflow (dê uma olhada quando puder) - Declaramos os campos
template_fields, onde o Jinja irá buscar macros para processamento. - Organizamos os argumentos corretos para
__init__(), definindo valores padrão onde necessário. - Não esquecemos da inicialização do pai.
- Abrimos o hook correspondente
TelegramBotHook, obtemos o objeto-cliente dele. - Sobrescrevemos (override) o método
BaseOperator.execute(), que o Airflow chamará quando chegar a hora de executar o operador — é nele que implementamos a ação principal, sem esquecer de registrar logs. (Registramos logs, aliás, diretamente nostdoutestderr— o Airflow interceptará tudo, embalará de forma elegante e distribuirá onde necessário.)
Vamos ver o que temos em commons/hooks.py. A primeira parte do arquivo, com o próprio hook:
from typing import Union

from airflow.hooks.base_hook import BaseHook
from requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Hook da API do Telegram Bot

    Nota: adicione uma conexão com Tipo de Conexão vazio e não esqueça
    de preencher Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Eu realmente não sei o que pode ser explicado aqui, apenas destacarei os pontos importantes:
- Estamos herdando, pensando nos argumentos — na maioria dos casos haverá apenas um:
conn_id; - Sobrescrevemos os métodos padrão: fiquei com
get_conn(), onde obtenho os parâmetros de conexão pelo nome e simplesmente extraio a seçãoextra(este campo é para JSON), onde eu (conforme minhas próprias instruções!) coloquei o token do bot do Telegram:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Criando uma instância do nosso
TelegramBot, passando a ele um token específico.
E é isso. Para obter o cliente do hook, você pode usar TelegramBotHook().clent ou TelegramBotHook().get_conn().
E a segunda parte do arquivo, onde eu criei uma micro-cobertura para a API REST do Telegram, para não ter que puxar o mesmo apenas para um método sendMessage.
class TelegramBot:
    """Wrapper da API do Telegram Bot

    Exemplos:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Oi, querido')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Oi, querido', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
O caminho correto é juntar tudo isso:
commons/operators.py,TelegramBotHook,TelegramBot— em um plugin, colocar no repositório público e disponibilizar como Open Source.
Enquanto estávamos estudando tudo isso, nossas atualizações de relatórios conseguiram falhar com sucesso e me enviaram uma mensagem de erro no canal. Vou verificar o que está errado novamente…
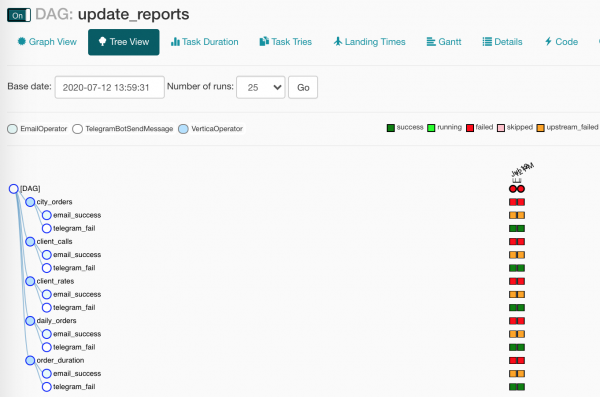
Algo quebrou no nosso DAG! E não era isso que estávamos esperando? Exatamente!
Você vai beber?
Sentindo que eu perdi algo? Eu prometi despejar dados do SQL Server para o Vertica e aqui fui eu, desviando do assunto, um extravagante!
Esse crime foi intencional, eu simplesmente tinha que decifrar algumas terminologias para vocês. Agora podemos seguir em frente.
Nosso plano era o seguinte:
- Fazer o DAG
- Gerar tarefas
- Ver como tudo fica bonito
- Atribuir números de sessão às cargas
- Pegar dados do SQL Server
- Colocar dados no Vertica
- Coletar estatísticas
Então, para rodar tudo isso, fiz uma pequena adição ao nosso docker-compose.yml:
docker-compose.db.yml
versão: '3.4'

x-mssql-base: &mssql-base
  imagem: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  reiniciar: sempre
  ambiente:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

serviços:
  dwh:
    imagem: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    imagem: mio101/py3-sql-db-client-base
    comando: python3 ./mssql_init.py
    depende_de:
      - mssql_0
      - mssql_1
      - mssql_2
    ambiente:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Lá nós levantamos:
- Vertica como host
dwhcom as configurações padrão, - três instâncias do SQL Server,
- preenchendo bancos com alguns dados recentes (de modo algum olhe para
mssql_init.py!)
Executamos tudo com um comando um pouco mais complexo do que da última vez:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3O que nosso gerador de sorteio criou pode ser acessado usando a opção Data Profiling/Ad Hoc Query:
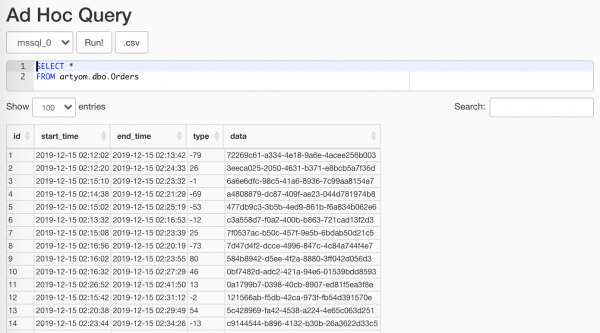
O principal é não mostrar isso para os analistas
Não vou detalhar sobre sessões ETL é tudo trivial: criamos o banco, nele uma tabela, encapsulamos tudo em um gerenciador de contexto, e agora fazemos assim:
com Session(task_name) como sessão:
    print('Carga', sessão.id, 'iniciada')

    # Carregar fluxo de trabalho
    ...

    sessão.sucesso = True
    sessão.linhas_carregadas = 15
session.py
from sys import stderr

class Session:
    """Sessão de fluxo de trabalho ETL

    Exemplo:
        with Session(task_name) as session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Bem feito'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'aberta')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Sessão não está aberta')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'fechada',
              ', bem-sucedida: ', self.successful,
              ', Carregado: ', self.loaded_rows,
              ', comentário:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Chegou a hora de coletar nossos dados de nossas mais de cento e cinquenta tabelas. Vamos fazer isso com algumas linhas muito simples:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Usando o hook, vamos obter do Airflow
pymssql-conexão - No pedido, vamos definir uma restrição de data — a função será passada pelo template.
- Estamos passando nossa consulta
pandas, que obterá para nósDataFrame— isso será útil mais tarde.
Estou usando a substituição
{dt}em vez do parâmetro da consulta%snão porque sou um Buratino maligno, mas porquepandasnão pode lidar compymssqle empurra para o últimoparams: Lista, embora ele deseje muitoestá contida em uma subconsulta. Isso é algo que pessoalmente senti muito falta em outros bancos de dados. Se eu quiser comparar algo com uma subconsulta, em outros bancos de dados só posso comparar um escalar, e para várias colunas é necessário escrever.
Além disso, note que o desenvolvedorpymssqldecidiu não mais suportá-lo, e é hora de mudar parapyodbc.
Vamos ver como o Airflow alimentou os argumentos das nossas funções:
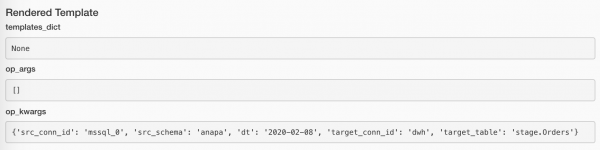
Se não houver dados, não faz sentido continuar. Mas também é estranho considerar o upload como bem-sucedido. Mas isso não é um erro. Ah, o que fazer?! É exatamente isso:
if df.empty:
    raise AirflowSkipException('Sem linhas para carregar')
AirflowSkipException dirá que não há realmente um erro, e a tarefa será ignorada. Na interface, não haverá um quadrado verde ou vermelho, mas sim um quadrado rosa.
Vamos adicionar aos nossos dados várias colunas:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Ou seja:
- O banco de dados de onde retiramos os pedidos,
- O identificador da nossa sessão de upload (que será diferente para cada tarefa),
- O hash da fonte e do identificador do pedido — para que na base de dados final (onde tudo será reunido em uma única tabela) tenhamos um identificador de pedido único.
Falta o penúltimo passo: enviar tudo para o Vertica. E, estranhamente, um dos métodos mais eficazes de fazer isso é através de CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Estamos criando um receptor especial
StringIO. pandasque gentilmente armazenará nossoDataFramena forma deCSV-linhas.- Vamos abrir uma conexão com a nossa querida Vertica usando o hook.
- E agora, com o auxílio de
copy()vamos enviar nossos dados diretamente para o Vertica!
Do driver, vamos pegar quantas linhas foram carregadas e informar ao gerente da sessão que está tudo OK:
session.loaded_rows = cursor.rowcount
session.successful = True
Isso é tudo.
Na produção, criamos a tabela alvo manualmente. Aqui eu me permiti uma pequena automação:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Com o auxílio de
VerticaOperator()crio o esquema do banco de dados e a tabela (se ainda não existirem, naturalmente). O principal é definir as dependências corretamente:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Resumindo
— E aí, — disse o ratinho, — não é verdade que agora
Você se convenceu de que na floresta sou a criatura mais assustadora?
Julia Donaldson, "Gruffalo"
Acho que se meus colegas e eu fizéssemos uma competição: quem consegue montar e iniciar um processo ETL do zero mais rápido: eles com seu SSIS e mouse e eu com Airflow... E depois compararíamos a facilidade de manutenção... Ufa, acho que você concordaria que eu os superaria em todos os aspectos!
Se formos um pouco mais sérios, o Apache Airflow — devido à descrição dos processos como código — tornou meu trabalho muito mais conveniente e agradável.
Sua ilimitada capacidade de expansão: tanto em termos de plugins quanto sua predisposição para escalabilidade — permite que você aplique Airflow praticamente em qualquer área: seja em todo o ciclo de coleta, preparação e processamento de dados, ou até no lançamento de foguetes (para Marte, claro).
Parte final, informativa e de referência
Os tropeços que coletamos para você
start_date. Sim, isso já é um meme local. Através do argumento principal do DAGstart_datetodos passam. Resumindo, se você especificar nastart_datedata atual, e noschedule_interval— um dia, então o DAG será iniciado amanhã, no mínimo.start_date = datetime(2020, 7, 7, 0, 1, 2)E sem mais problemas.
Está também relacionado a outro erro de execução:
Task is missing the start_date parameter, que geralmente indica que você esqueceu de vincular à operator do DAG.- Tudo em uma única máquina. Sim, tanto o banco de dados (do próprio Airflow e da nossa camada), quanto o servidor web, o agendador e os workers. E funcionou até mesmo. Mas com o tempo, o número de tarefas nos serviços aumentou, e quando o PostgreSQL começou a responder com índice em 20 ms em vez de 5 ms, nós o retiramos.
- LocalExecutor. Sim, ainda estamos com ele, e já estamos à beira do precipício. O LocalExecutor ainda era suficiente, mas agora chegou a hora de expandir com pelo menos um worker, e teremos que nos esforçar para mudar para o CeleryExecutor. E como é possível trabalhar com ele em uma única máquina, nada impede o uso do Celery em um servidor que "naturalmente, nunca vai para produção, eu prometo!"
- Não utilizar os recursos integrados:
- Connections para armazenar credenciais de serviços,
- SLA Misses para responder a tarefas que não foram concluídas a tempo,
- XCom para compartilhar metadados (eu disse metadados!) entre as tarefas do DAG.dados!) entre as tarefas do DAG.
- Abuso de e-mail. O que posso dizer? Foram configurados alertas para todas as repetições de tarefas falhadas. Agora, na minha conta de Gmail para trabalho, tenho mais de 90 mil e-mails do Airflow, e a interface da web do e-mail se recusa a processar e excluir mais de 100 de cada vez.
Mais armadilhas:
Meios de ainda mais automação
Para que possamos trabalhar ainda mais com a cabeça e menos com as mãos, o Airflow preparou o seguinte para nós:
- — ele ainda mantém o status Experimental, o que não impede seu funcionamento. Com ele, é possível não apenas obter informações sobre DAGs e tarefas, mas também parar/iniciar um DAG, criar uma execução de DAG ou um pool.
- — através da linha de comando, muitos recursos estão disponíveis, que não apenas são inconvenientes na interface WebUI, mas estão completamente ausentes. Por exemplo:
backfillé necessário para reiniciar instâncias das tarefas.
Por exemplo, os analistas chegam e dizem: "Mas, senhor, temos um problema nos dados de 1 a 13 de janeiro! Corre-corre-corre!". E você faz assim:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Manutenção do banco de dados:
initdb,resetdb,upgradedb,checkdb. run, que permite executar uma instância única de uma tarefa, sem se preocupar com todas as dependências. Além disso, pode ser iniciado através deLocalExecutor, mesmo que você tenha um cluster Celery.- Faz aproximadamente a mesma coisa que
test, só que não escreve nada no banco. connectionspermite criar conexões em massa a partir do shell.
- — uma maneira bastante hardcore de interagir, destinada a plugins, não para mexer manualmente. Mas quem nos impediria de ir até
/home/airflow/dags, executaripythone começar a brincar? Por exemplo, você pode exportar todas as conexões com o seguinte código:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Conexão com o banco de dados de metadados do Airflow. Não recomendo escrever nele, mas é possível extrair o estado das tarefas para várias métricas específicas de forma muito mais rápida e simples do que por meio de qualquer uma das APIs.
Digamos que nem todas as nossas tarefas sejam idempotentes e que às vezes podem falhar, e isso é normal. Mas várias falhas já são suspeitas, e seria bom verificar.
Cuidado com o SQL!
COM as últimas_execuções COMO (
SELECIONE
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
DE PUBLIC.task_instance
ONDE
    execution_date > agora() - INTERVAL '2' DIAS
),
falhou COMO (
    SELECIONE
        task_id,
        dag_id,
        execution_date,
        state,
        CASO QUANDO rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 ENTÃO VERDADEIRO FINAL AS last_fail_seq
    DE últimas_execuções
    ONDE
        state IN ('falhou', 'em_retry')
)
SELECIONE
    task_id,
    dag_id,
    contagem(last_fail_seq)                       AS malsucedidos,
    contagem(CASO QUANDO last_fail_seq
        E estado = 'falhou' ENTÃO 1 FINAL)       AS falhou,
    contagem(CASO QUANDO last_fail_seq
        E estado = 'em_retry' ENTÃO 1 FINAL) AS em_retry
DE falhou
AGRUPAR POR
    task_id,
    dag_id
TENDO
    contagem(last_fail_seq) > 0
Links
E, claro, os primeiros dez links no resultado do Google contêm o conteúdo da pasta Airflow dos meus favoritos.
- — claro, você deve começar pela documentação oficial, mas quem lê instruções?
- — pelo menos leia as recomendações dos criadores.
- — o começo: interface do usuário em imagens
- — os conceitos básicos estão bem explicados, caso você (de repente!) não tenha entendido comigo.
- — um guia curto sobre a configuração do cluster Airflow.
- — um artigo quase tão interessante, embora com mais formalismo e menos exemplos.
- — sobre o trabalho em conjunto com o Celery.
- — sobre a idempotência das tarefas, carga pelo ID em vez da data, transformações, estrutura de arquivos e outras coisas interessantes.
- — dependências das tarefas e Trigger Rule, que mencionei apenas de passagem.
- — como superar alguns "funciona como pretendido" do planejador, carregar dados perdidos e priorizar tarefas.
- — consultas SQL úteis nos metadados do Airflow.
- — há uma seção útil sobre como criar um sensor customizado.
- — uma nota curta interessante sobre a construção da infraestrutura na AWS para Ciência de Dados.
- — erros comuns (quando alguém não lê as instruções).
- — sorria, como as pessoas mal conseguem armazenar senhas, embora você possa simplesmente usar Connections.
- — passagem implícita do DAG, injeção de contexto na função, novamente sobre dependências, e também sobre a omissão de execuções de tarefas.
- — sobre o uso de
argumentos padrãoeparamsem templates, bem como sobre Variables e Connections. - — uma explicação de como o planejador foi preparado para o Airflow 2.0.
- — um artigo um pouco desatualizado sobre a implantação de nosso cluster em
docker-compose. - — tarefas dinâmicas usando templates e injeção de contexto.
- — notificações padrão e personalizadas por email e Slack.
- — ramificações de tarefas, macros e XCom.
E links usados no artigo:
- — placeholders disponíveis para uso em templates.
- — erros frequentes ao criar DAGs.
- —
docker-composepara experimentos, depuração e muito mais. - — wrapper Python para a API REST do Telegram.
Fonte: habr.com
