

Provavelmente, não é segredo para ninguém que o ano passado foi um ano de grandes mudanças para o Apache Hadoop. No ano passado, ocorreu a fusão entre Cloudera e Hortonworks (na verdade, a absorção da segunda), enquanto a MapR, devido a sérios problemas financeiros, foi vendida para a Hewlett Packard. E se há alguns anos, nas instalações on-premises, a escolha frequentemente recaía entre Cloudera e Hortonworks, hoje, infelizmente, essa escolha não existe mais. Outra surpresa foi o fato de que a Cloudera anunciou em fevereiro deste ano a suspensão da distribuição pública de compilações binárias de seu software, que agora estão disponíveis apenas mediante assinatura paga. Claro, ainda é possível baixar as versões mais recentes do CDH e HDP lançadas até o final de 2019, e o suporte para essas versões está previsto para um ou dois anos. Mas o que fazer a seguir? Para aqueles que anteriormente pagavam por uma assinatura, nada mudou. E para aqueles que não desejam migrar para a versão paga do software, mas ainda assim desejam receber versões atualizadas dos componentes do cluster, bem como patches e outras atualizações, preparamos este artigo. Nele, discutiremos possíveis opções para superar a situação atual.
Este artigo é mais uma visão geral. Não haverá comparação de distribuições nem uma análise detalhada, e também não haverá receitas para instalação e configuração. Então, o que haverá? Vamos falar brevemente sobre uma distribuição chamada Arenadata Hadoop, que merece nossa atenção devido à sua acessibilidade, algo que hoje em dia é uma grande raridade. Depois, discutiremos sobre o Vanilla Hadoop, principalmente sobre como ele pode ser "preparado" com a ajuda do Apache Bigtop. Prontos? Então, sejam bem-vindos.
Arenadata Hadoop
Esta é uma distribuição completamente nova e, por enquanto, pouco conhecida no cenário local. Infelizmente, no momento, no Habr, há apenas .
Mais informações podem ser encontradas no site oficial do projeto. As versões mais recentes da distribuição são baseadas no Hadoop 3.1.2 para a versão 3 e 2.8.5 para a versão 2.
Informações sobre o roadmap podem ser encontradas .
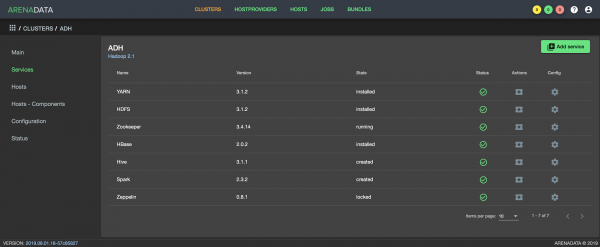
Interface do Arenadata Cluster Manager
O principal produto da Arenadata é , que é usado para instalar, configurar e monitorar várias soluções de software da empresa. O ADCM é distribuído gratuitamente e sua funcionalidade é ampliada com a adição de pacotes, que consistem em um conjunto de ansible-playbooks. Os pacotes são divididos em dois tipos: enterprise e community. Os últimos estão disponíveis para download gratuito no site da Arenadata. Também é possível desenvolver seu próprio pacote e conectá-lo ao ADCM.
Para o deployment e gerenciamento do Hadoop 3, é oferecida a versão community do pacote em conjunto com o ADCM, enquanto para o Hadoop 2 existe apenas como alternativa. Quanto aos repositórios de pacotes, eles estão abertos ao acesso público e podem ser baixados e instalados da maneira habitual para todos os componentes do cluster. No geral, a distribuição parece bastante interessante. Tenho certeza de que haverá quem esteja acostumado a soluções como Cloudera Manager e Ambari e que goste do próprio ADCM. Para alguns, será um grande benefício também o fato de que a distribuição para substituição de importações.
Se falarmos sobre desvantagens, elas serão as mesmas que para todas as outras distribuições do Hadoop. Ou seja:
- O chamado «vendor lock-in». No exemplo da Cloudera e Hortonworks, já entendemos que sempre há o risco de mudança na política da empresa.
- Um atraso significativo em relação ao upstream do Apache.
Vanilla Hadoop
Como você sabe, Hadoop não é um produto monolítico, mas, na verdade, uma verdadeira gama de serviços em torno de seu sistema de arquivos distribuído HDFS. Poucas pessoas ficarão satisfeitas apenas com um cluster de arquivos. Alguns precisam do Hive, outros do Presto, e ainda há o HBase e Phoenix, com o Spark sendo cada vez mais utilizado. Para orquestração e carga de dados, Oozie, Sqoop e Flume são algumas vezes utilizados. E quando a questão da segurança surge, logo nos lembramos do Kerberos em conjunto com o Ranger.
As versões binárias dos componentes Hadoop estão disponíveis no site de cada um dos projetos da ecossistema como tarballs. Elas podem ser baixadas e instaladas, mas com uma condição: além de montar pacotes a partir de binários 'crus', o que você provavelmente desejará fazer, você não terá nenhuma certeza sobre a compatibilidade das versões dos componentes baixados entre si. Uma opção mais preferível é a montagem usando o Apache Bigtop. O Bigtop permitirá que a montagem seja feita a partir dos repositórios do Maven da Apache, execute testes e crie pacotes. Mas, o que é muito importante para nós, o Bigtop montará as versões dos componentes que serão compatíveis entre si. É sobre isso que falaremos mais detalhadamente a seguir.
Apache Bigtop
Apache Bigtop é uma ferramenta para montagem, empacotamento e teste de uma série
de projetos de código aberto, como Hadoop e Greenplum. O Bigtop tem várias
versões. No momento da redação deste artigo, a última versão estável era a 1.4,
enquanto a master estava na 1.5. Em diferentes versões de lançamento, são usadas diferentes versões
dos componentes. Por exemplo, para 1.4, os componentes principais do Hadoop têm a versão 2.8.5, enquanto na master
é 2.10.0. A composição dos componentes suportados também muda. Algumas versões obsoletas e
não atualizadas saem, e em seu lugar entram novidades mais demandadas, que
não precisam ser necessariamente da própria família Apache.
Além disso, o Bigtop possui muitos .
Quando começamos a nos familiarizar com o Bigtop, o que mais nos surpreendeu foi a sua modesta, em comparação com outros projetos da Apache, disseminação e notoriedade, bem como sua comunidade bastante reduzida. Isso implica que há uma quantidade mínima de informação sobre o produto, e buscar soluções para problemas surgidos em fóruns e listas de discussão pode não resultar em nada. A princípio, para nós, foi uma tarefa complicada realizar a montagem completa da distribuição devido às peculiaridades da própria ferramenta, mas falaremos sobre isso um pouco mais tarde.
Como um teaser — para aqueles que na sua época gostaram de projetos do universo Linux, como Gentoo e LFS, pode ser nostálgico e agradável trabalhar com essa ferramenta e relembrar aqueles tempos "épicos", quando nós mesmos buscávamos (ou até escrevíamos) ebuilds e recompilávamos regularmente com novos patches o Mozilla.
Um dos grandes pontos positivos do Bigtop é a transparência e versatilidade das ferramentas em que é baseado. Suas fundações são o Gradle e o Apache Maven. O Gradle é bem conhecido como a ferramenta utilizada pelo Google para compilar o Android. Ele é flexível e, como se diz, "testado em combate". O Maven é a ferramenta padrão para montagem de projetos na própria Apache, e, dado que a maioria de seus produtos é lançada através do Maven, ele também é imprescindível aqui. Vale a pena prestar atenção no POM (project object model) – o arquivo XML "fundamental" que descreve tudo o que o Maven precisa para trabalhar com seu projeto, em torno do qual todo o trabalho é construído. É isso que
na parte do Maven que surgem alguns obstáculos que normalmente encontram aqueles que estão lidando com o Bigtop pela primeira vez.
Prática
Então, por onde começar? Vamos à página de download e faça o download da última versão estável em formato de arquivo. Lá você também pode encontrar os artefatos binários compilados pelo Bigtop. A propósito, os gerenciadores de pacotes mais comuns suportados são YUM e APT.
Uma alternativa é baixar a última versão estável diretamente do
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitClonando para "bigtop"…
remote: Enumerando objetos: 46, concluído.
remote: Contando objetos: 100% (46/46), concluído.
remote: Compactando objetos: 100% (41/41), concluído.
remote: Total 40217 (delta 14), reutilizado 10 (delta 1), pack-reused 40171
Recebendo objetos: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, pronto.
Determinando alterações: 100% (20503/20503), pronto.
Atualizando arquivos: 100% (1998/1998), pronto.
O diretório resultante ./bigtop se parece aproximadamente com isso:
./bigtop-bigpetstore — aplicações de demonstração, exemplos sintéticos
./bigtop-ci — ferramentas CI, jenkins
./bigtop-data-generators — geração de dados, sintéticos, para testes de fumaça etc.
./bigtop-deploy — ferramentas para implantação
./bigtop-packages — configs, scripts, patches para construção, parte principal da ferramenta
./bigtop-test-framework — framework de teste
./bigtop-tests — os próprios testes, de carga e de fumaça
./bigtop_toolchain — ambiente para construção, preparação do ambiente para o funcionamento da ferramenta
./build — diretório de trabalho de construção
./dl — diretório para os fontes baixados
./docker — construção em imagens docker, teste
./gradle — configuração do gradle
./output — diretório onde os artefatos da construção são colocados
./provisioner — provisionamento
O mais interessante neste estágio para nós é a configuração principal ./bigtop/bigtop.bom, onde vemos todos os componentes suportados com suas versões. É aqui que podemos especificar outra versão do produto (caso queiramos experimentá-la) ou a versão de build (se, por exemplo, adicionamos um patch significativo).
Além disso, há grande interesse pela subpasta .\/bigtop\/bigtop-packages, que tem relação direta com o processo de construção de componentes e pacotes relacionados a eles.
Então, baixamos o arquivo, descompactamos ou fizemos um clone do GitHub, podemos começar a construção?
Não, primeiro vamos preparar o ambiente.
Preparação do ambiente
E aqui é necessário fazer um pequeno desvio. Para construir praticamente qualquer produto mais ou menos complexo, é necessário um ambiente específico — neste caso, isso é JDK, as mesmas bibliotecas compartilhadas, arquivos de cabeçalho, etc., ferramentas como ant, ivy2 e muito mais. Uma das opções para obter o ambiente necessário para o Bigtop é instalar os componentes necessários no host de construção. Posso estar errado na cronologia, mas parece que a partir da versão 1.0 também surgiu a opção de construção em imagens docker pré-configuradas e disponíveis, que podem ser consultadas aqui.
Quanto à preparação do ambiente, há uma ajuda — Puppet.
Podemos usar os seguintes comandos, a execução é feita a partir do diretório raiz
da ferramenta, .\/bigtop:
.\/gradlew toolchain
.\/gradlew toolchain-devtools
.\/gradlew toolchain-puppetmodules
Ou diretamente através do puppet:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"
Infelizmente, já neste estágio podem surgir dificuldades. Uma recomendação geral aqui é usar uma distribuição suportada, em estado atual no host de construção, ou tentar o caminho com docker.
Compilação
O que podemos tentar construir? A resposta a essa pergunta será dada pela saída do comando
.\/gradlew tasks Na seção Package tasks, há uma série de produtos que são artefatos finais do Bigtop.
Eles podem ser identificados pelo sufixo -rpm ou -pkg-ind (no caso de construção
em docker). Nesse caso, o mais interessante é o Hadoop.
Vamos tentar realizar a construção no ambiente do nosso servidor de build:
.\/gradlew hadoop-rpmO Bigtop irá baixar os fontes necessários para o componente específico e começará a construção. Assim, o funcionamento da ferramenta está atrelado aos repositórios Maven e outras fontes, ou seja, ela precisa de acesso à Internet.
Durante o processo de trabalho, uma saída padrão é gerada. Às vezes, é possível identificar o que deu errado através dela e das mensagens de erro. Em outras ocasiões, é necessário obter informações adicionais. Nesse caso, é possível adicionar argumentos --info ou --debug, o que também pode ser útil –stacktrace. Existe uma maneira conveniente de formar um conjunto de dados para posterior referência nas listas de distribuição, a chave --scan.
Com isso, o bigtop coletará todas as informações e as armazenará no gradle, após o que fornecerá um link,
ao qual, ao acessar, uma pessoa qualificada poderá entender por que a construção falhou.
Deve-se ter em mente que essa opção pode tornar públicas informações indesejadas para você, como nomes de usuários, nós, variáveis de ambiente, etc., então tenha cuidado.
Frequentemente, os erros são resultado da incapacidade de obter alguns componentes necessários para a construção. Geralmente, o problema pode ser corrigido por meio da criação de um patch para corrigir algo no código-fonte, como o endereço no pom.xml no diretório raiz dos fontes. Isso é feito criando e colocá-lo no diretório apropriado .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ patch, por exemplo, na forma de patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@


central
- http:\/\/repo1.maven.org\/maven2
+ https:\/\/repo1.maven.org\/maven2

false
Provavelmente, no momento da leitura deste artigo, a correção mencionada acima não precisará ser feita por você.
Ao implementar patches ou correções no mecanismo de construção, pode ser necessário "resetar" a construção através do comando de limpeza:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Essa operação reverterá todas as alterações na construção deste componente, após o que a construção será executada novamente. Desta vez, tentaremos construir o projeto em uma imagem docker:
.\/gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Tarefa :hadoop-pkg-ind
Construindo 1.2.1 hadoop-pkg no centos-7 no Docker...
+++ dirname .\/bigtop-ci\/build.sh
++ cd .\/bigtop-ci\/..
++ pwd
+ BIGTOP_HOME=\/tmp\/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop\/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop\/slaves:1.2.1-centos-7 \/sbin\/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
Muita saída
....
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-secondarynamenode-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-journalnode-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-resourcemanager-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-nodemanager-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-proxyserver-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-timelineserver-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-historyserver-2.8.5-
1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-client-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Escreveu: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ cd hadoop-2.8.5-src
+ \/usr\/bin\/rm -rf \/bigtop\/build\/hadoop\/rpm\/BUILDROOT\/hadoop-2.8.5-1.el7.x86_64
Executando(%clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Executando(--clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.CwDb22
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Criando \/bigtop\/build\/hadoop\/.rpm
:hadoop-rpm (Thread[Task worker for ':',5,main]) concluído. Levou 38 mins 1.151 secs.
:hadoop-pkg (Thread[Task worker for ':',5,main]) iniciado.
> Tarefa :hadoop-pkg
Tarefa ':hadoop-pkg' não está atualizada porque:
A tarefa não declarou nenhuma saída apesar de executar ações.
:hadoop-pkg (Thread[Task worker for ':',5,main]) concluído. Levou 0.0 secs.
BUILD SUCESSO em 40m 37s
6 tarefas acionáveis: 6 executadas
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Erro: Nenhum container encontrado:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BUILD SUCESSO em 41m 24s
1 tarefa acionável: 1 executada
A construção foi realizada sob CentOS, mas pode ser feita também sob Ubuntu:
./gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indAlém da construção de pacotes para várias distribuições Linux, a ferramenta também é capaz de criar um repositório com os pacotes construídos, por exemplo:
./gradlew yumTambém podemos lembrar dos smoke tests e da implantação em docker.
Criar um cluster de três nós:
./gradlew -Pnum_instances=3 docker-provisionerExecutar smoke tests no cluster de três nós:
./gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerRemover o cluster:
./gradlew docker-provisioner-destroyObter comandos para conectar dentro dos containers docker:
./gradlew docker-provisioner-sshMostrar estado:
./gradlew docker-provisioner-statusVocê pode ler mais sobre as tarefas de Deployment na documentação.
Falando sobre os testes, existem muitos, principalmente smoke e testes de integração. A análise deles está fora do escopo deste artigo. Apenas direi que a construção da distribuição não é uma tarefa tão complexa quanto pode parecer à primeira vista. Todos os componentes que utilizamos em produção foram construídos e passaram pelos testes, além de não termos enfrentado problemas com sua implantação e execução de operações básicas no ambiente de teste.
Além dos componentes existentes no Bigtop, existe a possibilidade de adicionar mais um, até mesmo o seu próprio desenvolvimento de software. Tudo isso é muito bem automatizado e se encaixa na conceito de CI/CD.
Conclusão
É evidente que a distribuição construída dessa forma não deve ser imediatamente enviada para produção. É preciso entender que, se houver uma necessidade real de construir e manter sua própria distribuição, será necessário investir recursos financeiros e tempo nisso.
No entanto, com a abordagem correta e uma equipe profissional, é perfeitamente possível gerenciar sem soluções comerciais.
É importante notar que o próprio projeto Bigtop precisa de desenvolvimento e, aparentemente, não está havendo um desenvolvimento ativo atualmente. Também não está clara a perspectiva de aparecimento do Hadoop 3 nele. A propósito, se você tiver uma necessidade real de construir Hadoop 3, pode conferir o da Arenadata, que além dos componentes padrão
possui uma série de adicionais (Ranger, Knox, NiFi).
No que diz respeito à Rostelecom, para nós o Bigtop é uma das opções consideradas atualmente. Se escolheremos ele ou não, o tempo dirá.
Apêndice
Para incluir um novo componente na construção, você precisa adicionar sua descrição em bigtop.bom e ./bigtop-packages. Você pode tentar fazer isso por analogia com os componentes existentes. Tente entender. Não é tão complicado quanto parece à primeira vista.
E o que você acha? Ficaremos felizes em ver sua opinião nos comentários e obrigado pela atenção!
O artigo foi preparado pela equipe de gerenciamento de dados da "Rostelecom".
Fonte: habr.com
