

Artem Denisov ( , )
Badoo é o maior site de encontros do mundo. No momento, temos cerca de 330 milhões de usuários registrados em todo o mundo. Mas, o que é muito mais importante no contexto da nossa conversa de hoje, é que armazenamos cerca de 3 petabytes de fotos dos usuários. A cada dia, nossos usuários enviam cerca de 3,5 milhões de novas fotos, e a carga de leitura é de aproximadamente 80 mil solicitações por segundo. Isso é bastante para nosso backend, e às vezes enfrentamos dificuldades com isso.
Vou falar sobre o design desse sistema que armazena e fornece fotos de maneira geral, e darei uma perspectiva de desenvolvedor. Falarei sobre como ele se desenvolveu, com uma breve retrospectiva, onde marcarei os principais marcos, mas focarei mais detalhadamente nas soluções que estamos usando atualmente.
E agora vamos começar.
Como já mencionei, será uma retrospectiva, e para começar, vamos pegar o exemplo mais simples.
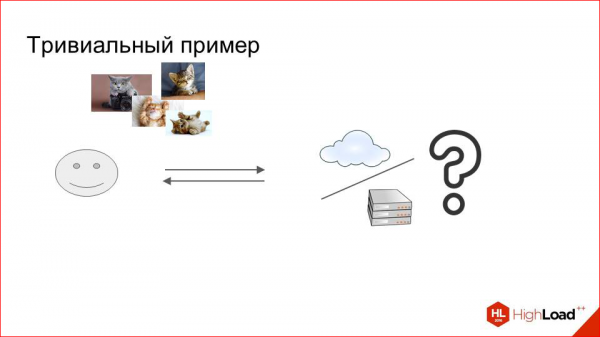
Temos um desafio comum: precisamos receber, armazenar e fornecer as fotos dos usuários. De forma geral, o desafio é amplo, e podemos usar qualquer coisa:
- um armazenamento em nuvem moderno,
- uma solução pronta, que também são muitas atualmente;
- podemos configurar várias máquinas em nosso data center e colocar grandes discos rígidos nelas para armazenar fotos lá.
Historicamente, o Badoo — tanto agora quanto na época em que estava apenas começando — opera em nossos próprios servidores, dentro de nossos próprios data centers. Portanto, para nós, essa opção era a mais adequada.
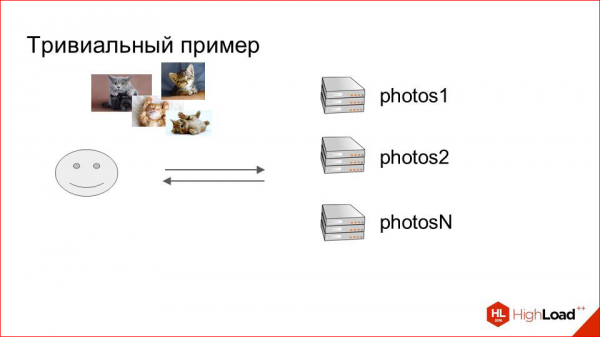
Simplesmente pegamos algumas máquinas, nomeamos de "photos", e assim formamos um cluster que armazena fotos. Mas, parece que falta algo. Para que tudo funcione, precisamos de alguma forma determinar em qual máquina algumas fotos serão armazenadas. E aqui, não é preciso descobrir a pólvora.
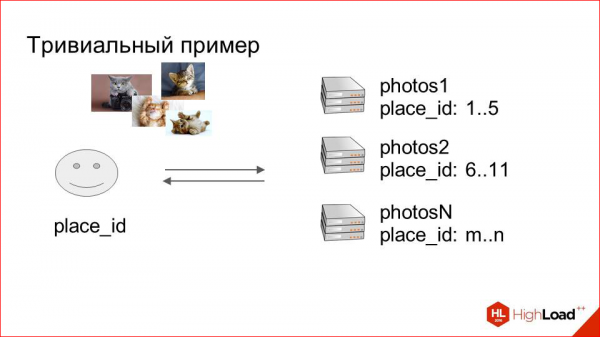
Adicionamos ao nosso armazenamento com informações sobre os usuários um campo. Esse será a chave de sharding. No nosso caso, o nomeamos como place_id, e esse id de locais indica onde as fotos dos usuários são armazenadas. Nós constituímos mapas.
Na primeira fase, isso pode até ser feito manualmente — dizemos que a foto deste usuário com esse local será armazenada em tal servidor. Graças a este mapa, sabemos sempre quando o usuário carrega uma foto, onde salvá-la e de onde entregá-la.
É um esquema absolutamente trivial, mas tem algumas vantagens significativas. Primeiro — é simples, como já mencionei, e segundo — com essa abordagem, podemos facilmente escalar horizontalmente, apenas entregando novos dispositivos e adicionando-os ao mapa. Não precisamos fazer mais nada.
Assim foi por um tempo conosco.
Isso foi por volta de 2009. Estávamos entregando dispositivos, entregando…
E em certo momento começamos a notar que esse esquema apresentava certas desvantagens. Quais desvantagens?
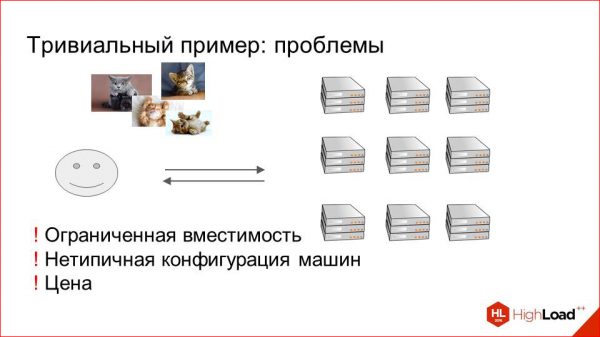
Em primeiro lugar, é a capacidade limitada. Não conseguimos colocar tantos discos rígidos em um servidor físico quanto gostaríamos. E isso se tornou um problema ao longo do tempo e com o crescimento do dataset.
E o segundo. Essa configuração de máquinas é atípica, pois é difícil reutilizar essas máquinas em outros clusters, elas são bastante específicas, ou seja, devem ser de baixo desempenho, mas ao mesmo tempo ter um disco rígido grande.
Isso tudo era em 2009, mas, na verdade, esses requisitos ainda são relevantes hoje. Temos uma retrospectiva, então em 2009 tudo estava ruim com isso.
E o último ponto — é o preço.
Naquela época, o preço era bastante elevado, e precisávamos procurar alternativas. Ou seja, precisávamos encontrar uma maneira melhor de utilizar tanto o espaço nos data centers quanto os servidores físicos em que tudo isso estava instalado. Nossos engenheiros de sistema começaram uma grande pesquisa, na qual revisaram várias opções diferentes. Eles também consideraram sistemas de arquivos em cluster, como PolyCeph e Lustre. Havia problemas com desempenho e era uma operação bastante pesada. Desistimos. Tentamos montar todo o dataset via NFS em cada dispositivo, para assim escalar de alguma forma. A leitura também não funcionou bem, tentamos diferentes soluções de vários fornecedores.
E no final, decidimos usar o que chamamos de Storage Area Network.
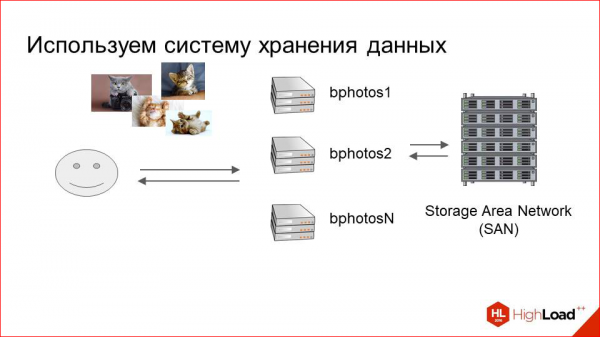
Estes são grandes SHD projetados para armazenar grandes volumes de dados. Eles consistem em prateleiras com discos que estão montadas em máquinas de entrega finais via fibra óptica. Assim, temos um pequeno pool de máquinas, e esses SHD, que são transparentes para nossa lógica de entrega, ou seja, para o nosso nginx ou qualquer outro, atendem às solicitações por essas fotos.
Essa solução tinha benefícios claros. É um SHD. Ele é voltado para armazenar fotos. Isso acaba sendo mais barato do que simplesmente configurar as máquinas com discos rígidos.
Um segundo benefício.
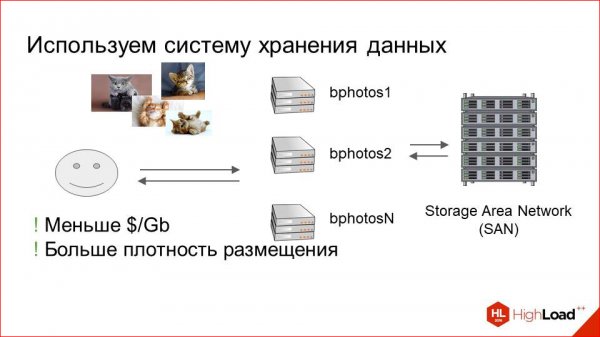
É que a capacidade aumentou muito, ou seja, conseguimos armazenar muito mais armazenamento em um espaço muito menor.
Mas houve desvantagens que se tornaram evidentes rapidamente. Com o aumento do número de usuários e da carga neste sistema, começaram a surgir problemas de desempenho. E o problema aqui é bastante óbvio — qualquer SHD destinado a armazenar muitas fotos em um pequeno volume tende a sofrer com leituras intensivas. Isso é realmente aplicável a qualquer armazenamento em nuvem e qualquer outra coisa. Atualmente, não existe armazenamento perfeito que seja infinitamente escalável, que você possa encher com qualquer coisa, e que suporte leituras muito bem. Especialmente leituras aleatórias.
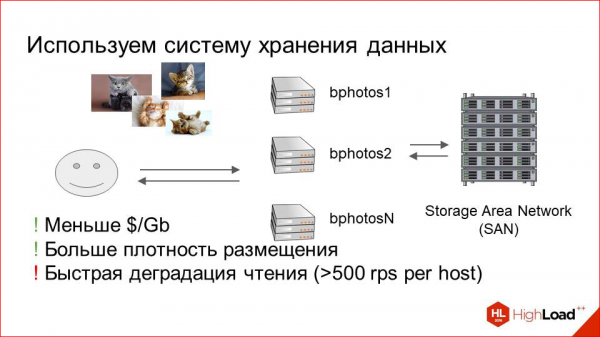
Como no caso das nossas fotos, porque as fotos são solicitadas de forma não sequencial, e isso afeta muito o seu desempenho.
Mesmo com os números de hoje, se tivermos mais de 500 RPS por imagens em uma máquina conectada ao armazenamento, já começam os problemas. E isso foi bastante ruim para nós, porque o número de usuários está crescendo, tudo deve piorar. Precisamos otimizar isso de alguma forma.
Para otimizar, na época decidimos, obviamente, olhar para o perfil de carga — o que realmente está acontecendo, o que precisa ser otimizado.
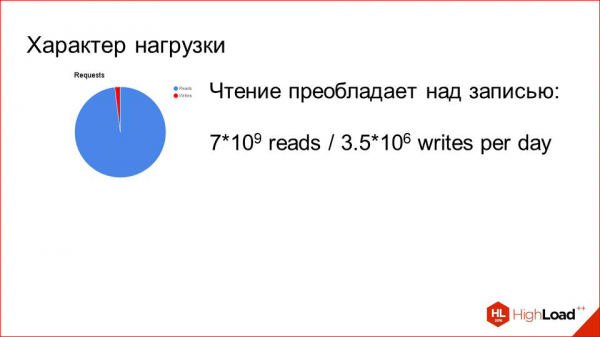
E aqui tudo joga a nosso favor.
Eu já mencionei no primeiro slide: temos 80 mil solicitações por segundo para leitura com apenas 3,5 milhões de uploads por dia. Ou seja, há uma diferença de três ordens de grandeza. É evidente que precisamos otimizar a leitura e praticamente está claro como.
Há mais um detalhe. A natureza do serviço é que a pessoa se registra, faz o upload de uma foto, depois começa a ver outras pessoas ativamente, curtir suas fotos, e é ativamente mostrado para outras pessoas. Em seguida, ela encontra um par ou não, dependendo de como as coisas se desenrolam, e por um tempo para de usar o serviço. Nesse momento, quando ela está usando, suas fotos são muito populares — são muito procuradas, vistas por muitas pessoas. Assim que ela para de fazer isso, rapidamente ela sai desse intenso destaque para outras pessoas, como antes, e suas fotos praticamente não são mais solicitadas.
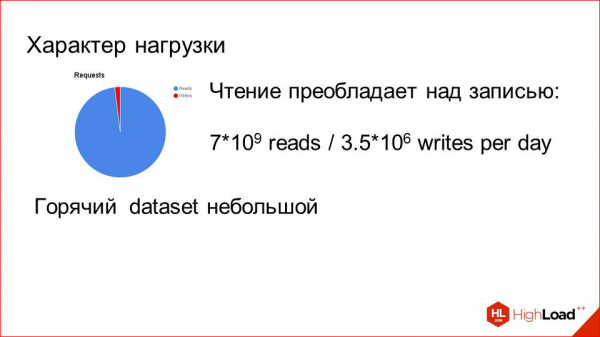
Ou seja, temos um conjunto de dados muito pequeno e quente. Mas, ao mesmo tempo, há uma quantidade significativa de solicitações. E uma solução obviamente adequada aqui é adicionar cache.
O cache com LRU resolverá todos os nossos problemas. O que fazemos?
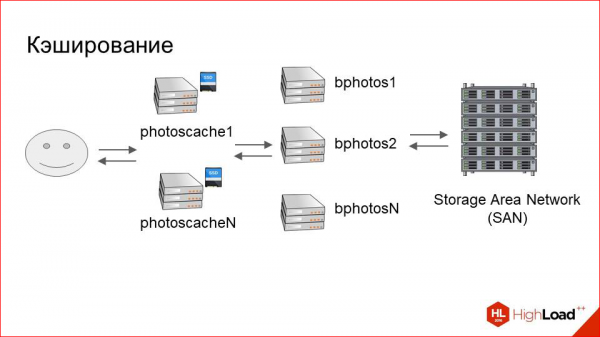
Adicionamos um cluster relativamente pequeno, que chamamos de fotocache (photoscache), antes do nosso grande cluster de armazenamento. Isso, na verdade, é apenas um proxy de cache.
Como isso funciona internamente? Aqui está nosso usuário, aqui está o armazenamento. Tudo como antes. O que acrescentamos entre eles?
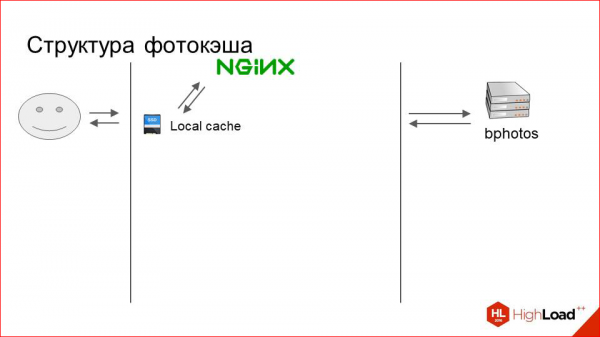
É simplesmente uma máquina com um disco local físico que é rápido. É um SSD, por exemplo. E nesse disco armazenamos algum cache local.
Como isso se parece? O usuário envia um pedido por uma foto. O NGINX procura primeiro no cache local. Se não encontrar, faz um proxy_pass para nosso armazenamento, baixa a foto de lá e a entrega ao usuário.
Mas isso é bastante simples e não está claro o que acontece lá dentro. Funciona mais ou menos assim.
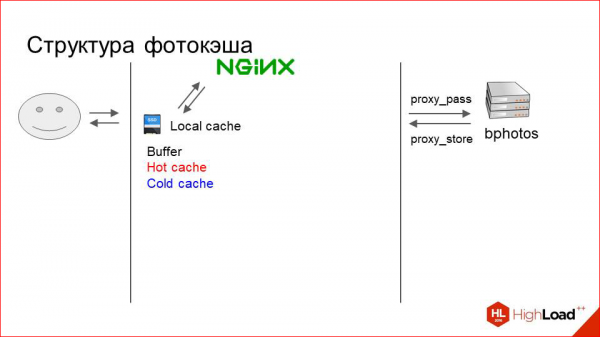
O cache é logicamente dividido em três camadas. Quando digo ‘três camadas’, isso não significa que há um sistema complicado. Não, é simplesmente, em termos gerais, três diretórios no sistema de arquivos:
- Este é o buffer, onde as fotos recém-carregadas do proxy vão parar.
- Este é o cache quente, onde estão armazenadas as fotos que estão sendo ativamente solicitadas agora.
- E o cache frio, para onde as fotos são gradualmente empurradas do quente, quando recebem menos solicitações.
Para que isso funcione, precisamos gerenciar esse cache de alguma forma, precisamos mover fotos nele etc. Esse também é um processo bastante primitivo.
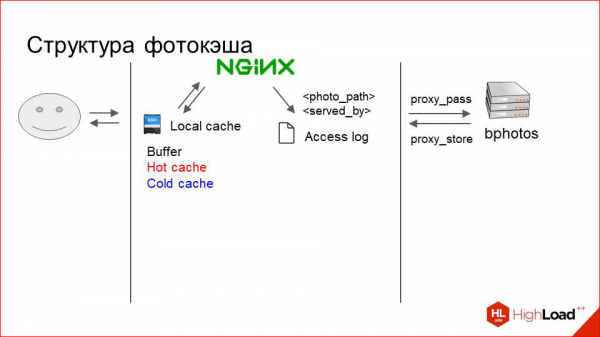
O Nginx simplesmente registra no RAMDisk access.log para cada solicitação, onde indica o caminho da foto que está servindo (caminho relativo, naturalmente) e qual seção a está servindo. Ou seja, pode estar escrito "foto 1" e depois um buffer, cache quente, cache frio ou proxy.
Dependendo disso, precisamos de alguma forma decidir o que fazer com a foto.
Em cada máquina, temos um pequeno daemon que lê constantemente esse log e mantém as estatísticas sobre o uso das fotos em sua memória.
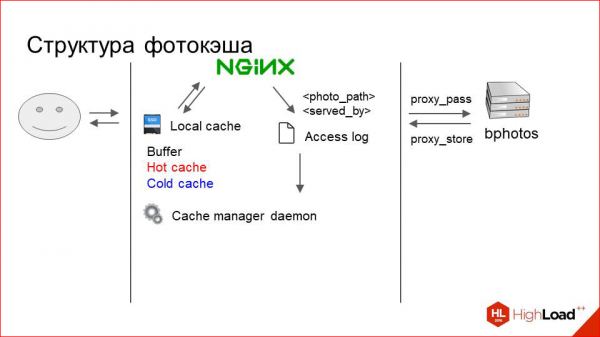
Ele simplesmente coleta lá, mantém contadores e periodicamente faz o seguinte. As fotos que são ativamente solicitadas, que recebem muitas requisições, ele move para o cache quente, onde quer que estejam.
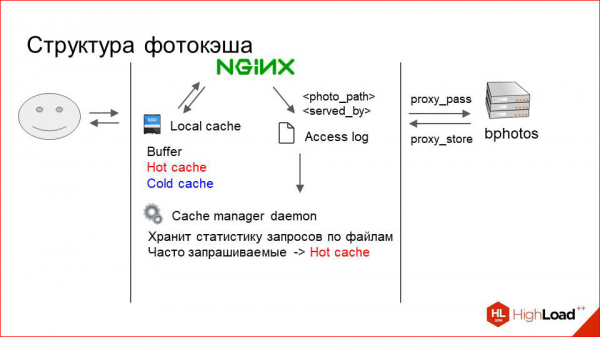
As fotos que são solicitadas raramente e começaram a ser solicitadas com menos frequência, ele gradualmente empurra do cache quente para o frio.
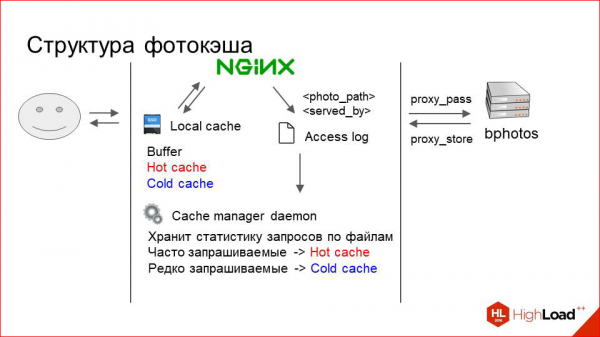
E quando o espaço no cache acaba, começamos a deletar tudo do cache frio indiscriminadamente. E isso, aliás, funciona muito bem.
Para que a foto seja armazenada imediatamente durante o proxy para o buffer, usamos a diretiva proxy_store e o buffer - que também é um RAMDisk, ou seja, para o usuário isso funciona muito rapidamente. Isso diz respeito às entranhas do próprio servidor de cache.
Resta a questão de como distribuir as requisições entre esses servidores.
Suponha que temos um cluster de vinte máquinas de armazenamento e três servidores de cache (foi assim que aconteceu).
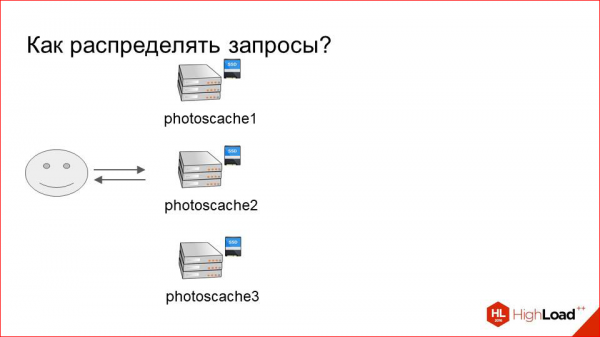
Precisamos de alguma forma determinar quais requisições buscam quais fotos e para onde direcioná-las.
A opção mais simples é o Round Robin. Ou fazer isso aleatoriamente?
Isso, evidentemente, tem uma série de desvantagens, porque estaremos utilizando o cache de forma muito ineficiente nessa situação. As requisições cairão em máquinas aleatórias: aqui foi armazenada, na vizinha já não há. E tudo isso funcionará, se funcionar, de forma muito ruim. Mesmo com um número reduzido de máquinas no cluster.
Precisamos de alguma forma de identificar claramente em qual servidor enviar cada requisição.
Há um jeito simples. Pegamos o hash da URL ou o hash da nossa chave de sharding que está na URL e o dividimos inteiramente pelo número de servidores. Vai funcionar? Vai.
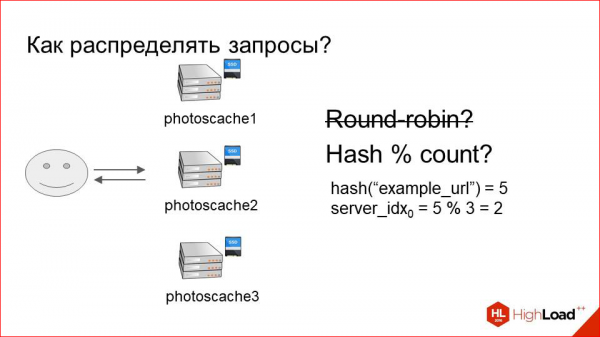
Ou seja, temos um request cem por cento garantido, por exemplo, para algum "example_url" sempre será direcionado para o servidor com índice "2", e o cache será constantemente utilizado da melhor forma possível.
Mas surge um problema com o re-sharding nesse esquema. Re-sharding — o que quero dizer é a alteração no número de servidores.
Vamos supor que nosso cluster de cache parou de conseguir lidar, e decidimos adicionar mais uma máquina.
Estamos adicionando.
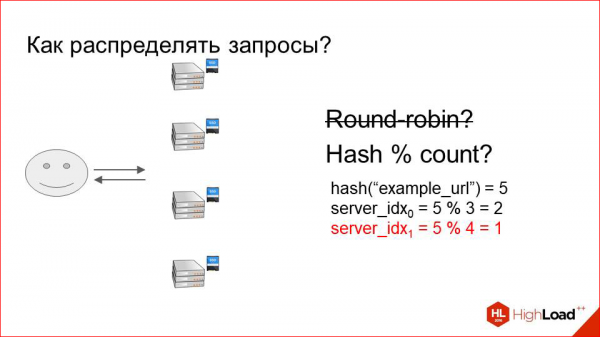
Agora temos tudo dividido não por três, mas por quatro. Assim, praticamente todas as chaves que tínhamos, praticamente todos os URLs agora vivem em outros servidores. Todo o cache foi invalidado instantaneamente. Todos os requests inundaram nosso cluster de armazenamento, ele começou a falhar, houve uma recusa de serviço e usuários insatisfeitos. Não queremos que isso aconteça.
Essa opção também não nos serve.
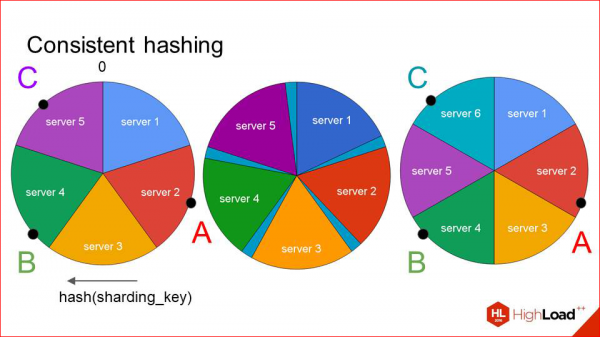
Então, o que devemos fazer? Precisamos de alguma forma de usar o cache de maneira eficaz, sempre direcionando um request para o mesmo servidor, mas ao mesmo tempo ser resilientes ao re-sharding. E existe uma solução, que não é exatamente complicada. Chama-se hashing consistente.
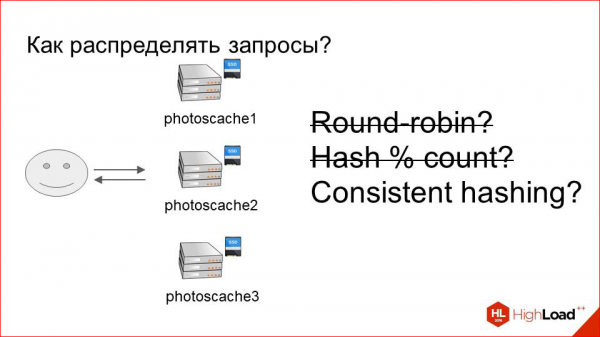
Como isso funciona?
Pegamos alguma função da chave de sharding e dispersamos todos os seus valores em uma circunferência. Ou seja, no ponto 0 temos os seus valores mínimos e máximos convergindo. Depois, colocamos todos os nossos servidores nessa mesma circunferência de maneira mais ou menos assim:
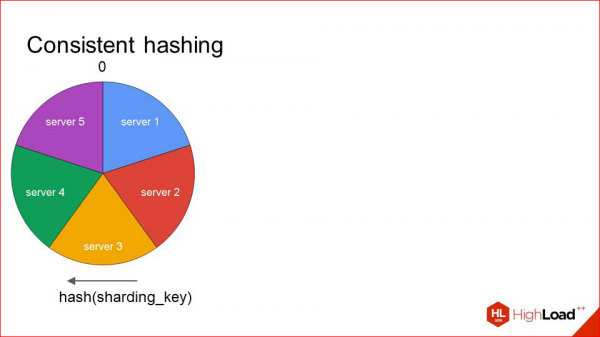
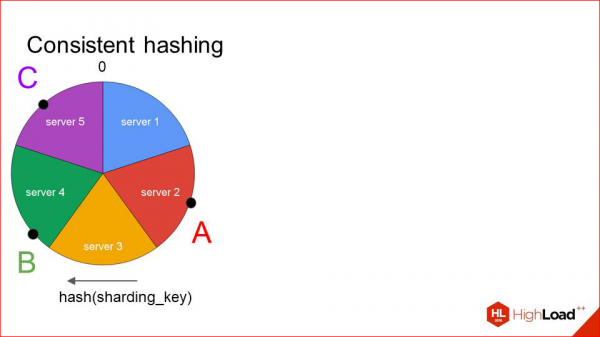
Cada servidor é determinado por um ponto, e o setor que vai até ele, no sentido horário, é atendido por esse host. Quando recebemos requests, vemos imediatamente que, por exemplo, o request A — tem um hash assim — e é atendido pelo servidor 2. O request B — pelo servidor 3. E assim por diante.
O que acontece nessa situação durante o re-sharding?
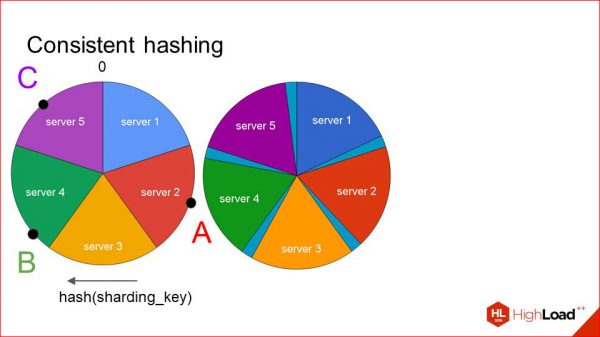
Não invalidamos todo o cache, como antes, e não deslocamos todas as chaves, mas deslocamos cada setor por uma pequena distância de modo que, para ocupar o espaço liberado, digamos assim, caberá nosso sexto servidor, que queremos adicionar, e o colocamos lá.
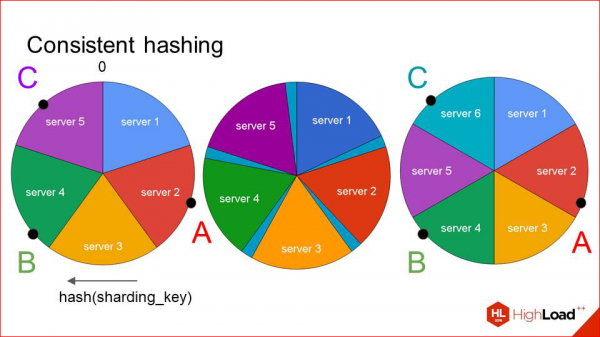
Claro, em tal situação, as chaves também sofrem. Mas elas se deslocam muito menos do que antes. E vemos que nossas duas primeiras chaves permaneceram em seus servidores, enquanto o servidor de cache mudou apenas para a última chave. Isso funciona de maneira bastante eficiente, e se você adicionar novos hosts de forma incremental, não há um grande problema. Você adiciona aos poucos, espera até que o cache seja preenchido novamente, e tudo funciona bem.
A única dúvida que resta é sobre as falhas. Suponhamos que um de nossos servidores tenha ido para o saco.
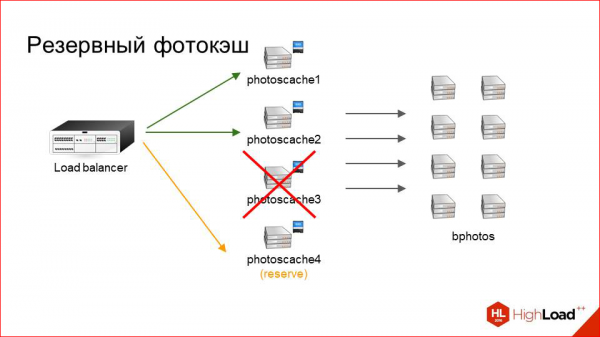
E nós não gostaríamos de regenerar esse mapa nesse momento, invalidar parte do cache e assim por diante, se, por exemplo, a máquina reiniciou e precisamos atender às solicitações. Mantemos simplesmente um cache fotográfico de reserva em cada local, que atua como substituto para qualquer máquina que esteja fora de operação no momento. E se, de repente, um servidor se tornar indisponível, o tráfego vai para lá. Naturalmente, não temos cache lá, ou seja, ele está frio, mas, pelo menos, as solicitações dos usuários são processadas. Se isso for um intervalo curto, lidamos com isso tranquilamente. Apenas haverá uma carga maior no storage. Se o intervalo for longo, já podemos tomar a decisão — remover esse servidor do mapa ou não, ou talvez substituí-lo por outro.
Isso em relação ao sistema de cache. Vamos ver os resultados.
À primeira vista, não há nada complicado aqui. Mas esse método de gerenciamento do cache nos deu uma taxa de acerto de cerca de 98%. Ou seja, dessas 80 mil solicitações por segundo, apenas 1600 chegam aos storages, e isso é uma carga completamente normal, eles lidam com isso tranquilamente, sempre temos uma reserva.
Colocamos esses servidores em três de nossos data centers e obtivemos três pontos de presença — Praga, Miami e Hong Kong.
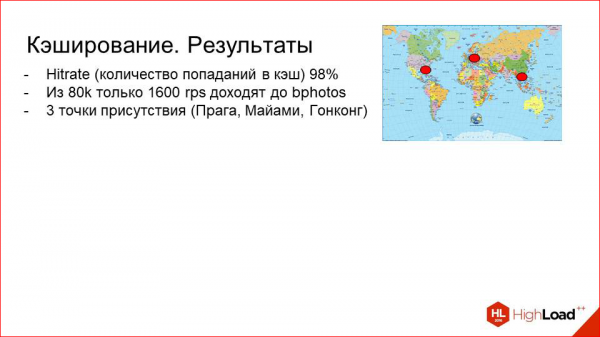
Assim, eles estão mais ou menos localizados perto de cada um de nossos mercados-alvo.
E como um bônus agradável, recebemos esse proxy de cache, no qual o CPU está, na verdade, ocioso, porque para fornecer conteúdo, não é tanto necessário. E lá, com NGINX + Lua, implementamos muita lógica utilitária.
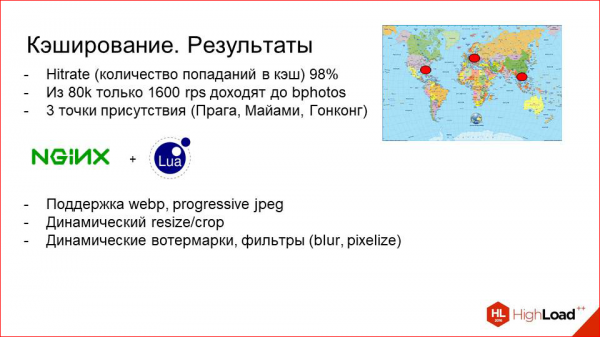
Por exemplo, podemos experimentar com webp ou jpeg progressivo (são formatos modernos e eficazes), ver como isso afeta o tráfego, tomar algumas decisões, habilitar para determinados países, etc.; fazer redimensionamento dinâmico ou crop das fotos em tempo real.
Esse é um bom caso de uso, quando você tem, por exemplo, um aplicativo móvel que mostra fotos, e o aplicativo móvel não quer gastar CPU do cliente para solicitar uma grande fotografia e redimensioná-la para algum tamanho a fim de colocá-la na visualização. Podemos simplesmente indicar dinamicamente na URL alguns parâmetros em UPort, e o cache de fotos redimensionará a foto automaticamente. Em geral, ele escolherá o tamanho que temos fisicamente no disco, o mais próximo do solicitado, e o redimensionará nas coordenadas específicas.
Aliás, disponibilizamos gravações em vídeo dos últimos cinco anos da conferência de desenvolvedores de sistemas de alta carga. . Assista, estude, compartilhe e inscreva-se no .
Além disso, podemos adicionar muita lógica de produto. Por exemplo, podemos adicionar diferentes marcas d'água com base nos parâmetros da URL, podemos desfocar fotos, borrá-las ou pixelizá-las. Isso é quando queremos mostrar a foto de uma pessoa, mas não queremos mostrar seu rosto, e isso funciona bem, tudo isso está implementado aqui.
O que obtivemos? Obtivemos três pontos de presença, uma boa taxa de acerto, e ao mesmo tempo não temos CPU ociosa nessas máquinas. Agora ele se tornou, sem dúvida, mais importante do que antes. Precisamos colocar máquinas mais potentes, mas vale a pena.
Quanto à entrega das fotos, tudo isso é bastante claro e óbvio. Eu acho que não estou trazendo nenhuma novidade, funciona assim em praticamente qualquer CDN.
E, provavelmente, o ouvinte experiente pode ter se perguntado: por que simplesmente não trocar tudo para CDN? Seria aproximadamente a mesma coisa, todos os CDNs modernos sabem fazer isso. E há várias razões para isso.
Primeiro — são as fotos.
Este é um dos pontos-chave da nossa infraestrutura, e precisamos ter o máximo de controle sobre elas. Se for uma solução de um fornecedor externo, e você não tiver controle sobre isso, será bastante difícil lidar com isso quando você tiver um grande conjunto de dados e um fluxo muito elevado de solicitações de usuários.
Vou dar um exemplo. Atualmente, em nossa infraestrutura, podemos, por exemplo, em caso de problemas ou toques subterrâneos, acessar a máquina, debugar lá, por assim dizer. Podemos adicionar a coleta de algumas métricas que só nos interessam, podemos experimentar de alguma forma, observar como isso afeta os gráficos e assim por diante. Atualmente, estamos coletando muitas estatísticas sobre este cluster de cache. E periodicamente olhamos para isso e analisamos longamente algumas anomalias. Se estivesse do lado do CDN, seria muito mais difícil controlar. Ou, por exemplo, se ocorrer algum acidente, sabemos o que aconteceu, sabemos como lidar com isso e como superá-lo. Essa é a primeira conclusão.
A segunda conclusão também é, em grande parte, histórica, porque o sistema tem evoluído há muito tempo, e muitos requisitos de negócios diferentes surgiram em várias etapas, e nem sempre se encaixam na concepção do CDN.
E um ponto que se segue do anterior –
É que nos caches de fotos temos muita lógica específica que nem sempre pode ser adicionada a pedido. É pouco provável que algum CDN adicione alguma coisa personalizada por solicitação. Por exemplo, criptografia de URLs, se você não quer que o cliente possa mudar algo. Quer mudar a URL no servidor e criptografá-la, e depois passar aqui alguns parâmetros dinâmicos.
Qual conclusão se impõe? No nosso caso, o CDN não é uma boa alternativa.
E no seu caso, se você tiver alguns requisitos de negócios específicos, pode implementar tranquilamente o que eu mostrei. E isso funcionará muito bem com um perfil de carga semelhante.
Mas se você tiver uma solução geral, e a tarefa não for muito específica, você pode tranquilamente usar o CDN. Ou se o tempo e os recursos forem muito mais importantes para você do que o controle.
E os CDNs modernos têm praticamente tudo o que eu acabei de lhe contar. Com exceção de algumas funcionalidades.
Isso se refere à entrega de fotos.
Vamos agora um pouco à frente em nossa retrospectiva e falar sobre armazenamento.
O ano de 2013 estava passando.
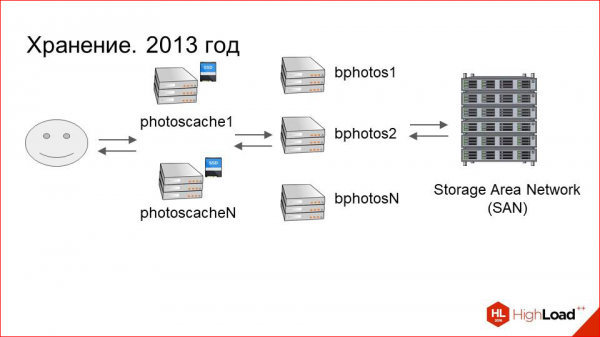
Os servidores de cache foram adicionados, e os problemas de desempenho desapareceram. Tudo está bem. O conjunto de dados está crescendo. Em 2013, tínhamos cerca de 80 servidores conectados aos storages, e aproximadamente 40 servidores de cache em cada DC. Isso equivale a 560 terabytes de dados em cada DC, ou seja, cerca de um petabyte no total.
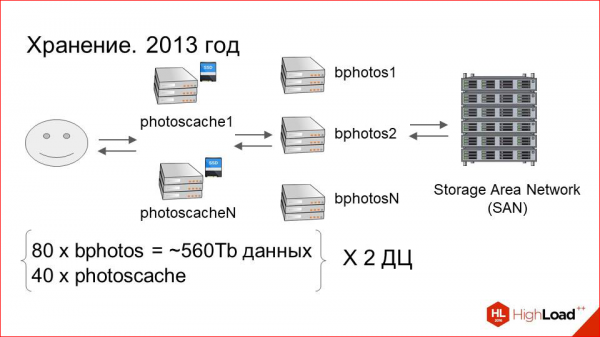
E com o crescimento do conjunto de dados, os custos de operação começaram a aumentar significativamente. Em que isso se manifestava?
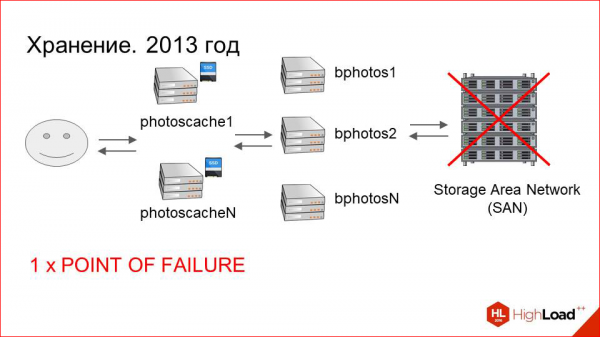
Nesse esquema, que está desenhado — com o SAN, as máquinas conectadas a ele e os caches — há muitos pontos de falha. Se com a falha dos servidores de cache já conseguimos nos adaptar, onde tudo é relativamente previsível e compreensível, o lado do storage era muito pior.
Primeiro, a própria Rede de Armazenamento (SAN) pode falhar.
Em segundo lugar, ela está conectada por fibra ótica às máquinas finais. Podem haver problemas com as placas ópticas, switches.
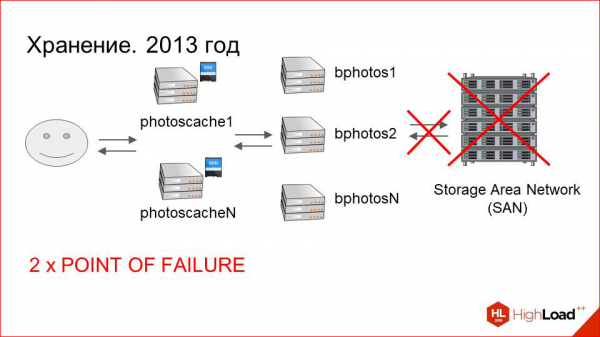
Claro, não são tantos quanto com o próprio SAN, mas, ainda assim, são pontos de falha.
Depois, a própria máquina que está conectada ao storage. Ela também pode falhar.
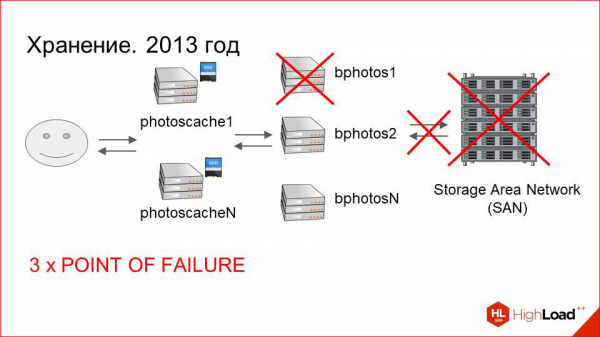
Portanto, temos três pontos de falha.
Além disso, além dos pontos de falha, a manutenção dos storage é pesada.
É um sistema complexo e de múltiplos componentes, e os engenheiros de sistemas às vezes têm dificuldade com ele.
E o último e mais importante ponto. Se ocorrer uma falha em qualquer um desses três pontos, temos uma probabilidade não nula de perder os dados do usuário, pois o sistema de arquivos pode se corromper.
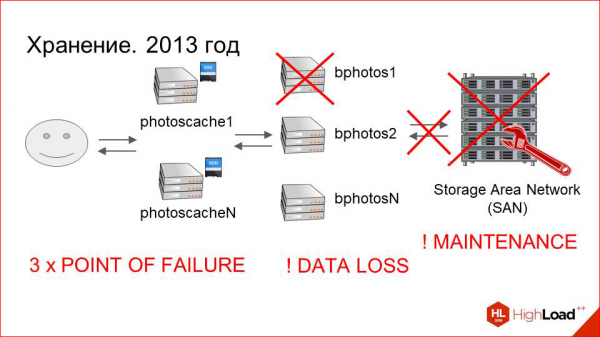
Suponhamos que o sistema de arquivos esteja corrompido. Sua recuperação leva, em primeiro lugar, muito tempo — pode demorar uma semana com um grande volume de dados. E, em segundo lugar, provavelmente acabaremos com uma quantidade de arquivos incompreensíveis, os quais precisarão ser de alguma forma vinculados às fotos dos usuários. E corremos o risco de perder dados. O risco é bastante alto. E quanto mais frequentes essas situações ocorrem, e quanto mais problemas surgem em toda essa cadeia, maior é esse risco.
Era preciso fazer algo a respeito. E decidimos que deveríamos simplesmente fazer backup dos dados. Essa é na verdade uma solução óbvia e boa. O que fizemos?
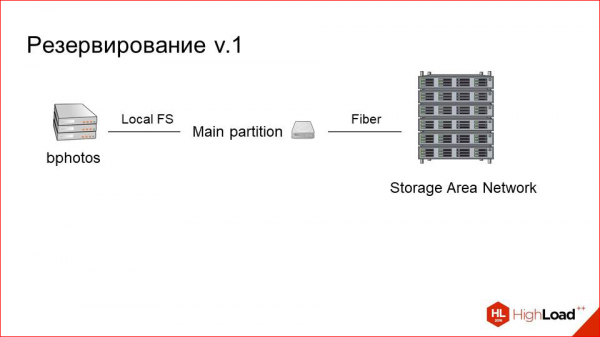
Este era o nosso servidor que estava conectado ao storage anteriormente. É uma única partição principal, é simplesmente um dispositivo de bloco, que na verdade representa um mount em um storage remoto por fibra ótica.
Nós simplesmente adicionamos uma segunda partição.
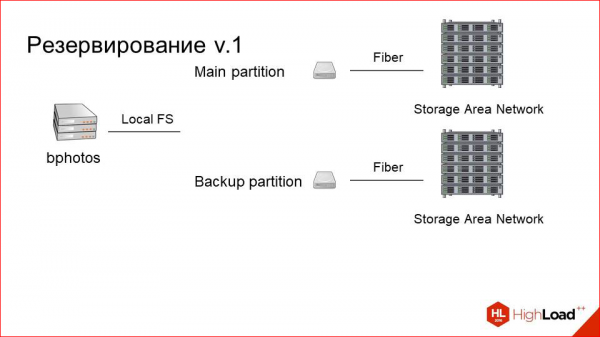
Colocamos um segundo storage ao lado (felizmente, isso não é tão caro) e o chamamos de seção de backup. Ele também está conectado por fibra óptica e está na mesma máquina. Mas precisamos de uma maneira de sincronizar os dados entre eles.
Aqui, simplesmente fazemos uma fila assíncrona ao lado.
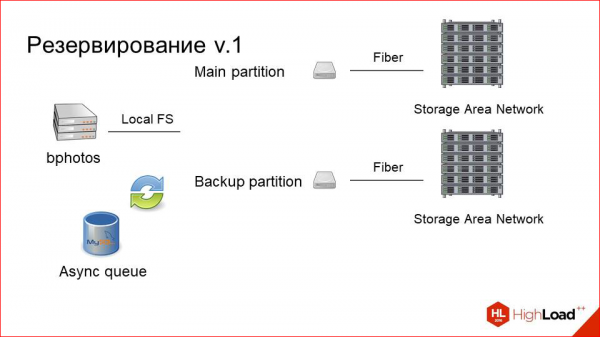
Ela não está muito carregada. Sabemos que temos poucas entradas. A fila é apenas uma tabela no MySQL, na qual escrevemos linhas do tipo "preciso fazer backup desta foto". A cada alteração ou upload, copiamos da seção principal para o backup de forma assíncrona ou simplesmente com algum worker em segundo plano.
E assim temos sempre duas seções consistentes. Mesmo que uma parte deste sistema falhe, sempre podemos trocar a seção principal pelo backup, e tudo continuará funcionando.
Mas devido a isso, a carga de leitura aumenta bastante, pois além dos clientes que leem da seção principal, porque eles primeiro visualizam a foto lá (ela é mais recente), e então procuram no backup, se não a encontraram (mas isso já é feito pelo NGINX), nossa própria sistema de backup agora também lê da seção principal. Não é que isso seja um gargalo, mas não queríamos aumentar a carga desnecessariamente.
E adicionamos um terceiro disco, que é um pequeno SSD, e o chamamos de buffer.
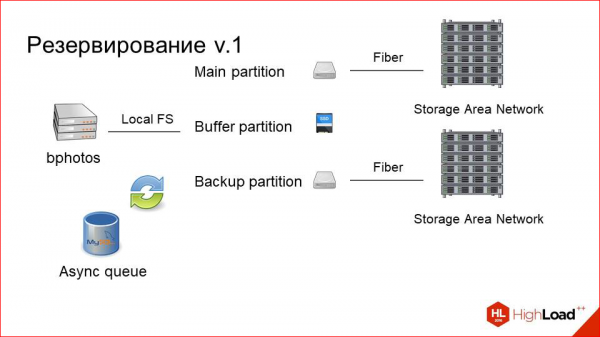
Como isso funciona agora.
O usuário faz upload da foto para o buffer, em seguida, um evento é enviado para a fila informando que ela precisa ser copiada para as duas seções. Ela é copiada, e a foto fica por algum tempo (digamos, um dia) no buffer, e só então é purgada. Isso melhora muito a experiência do usuário, porque o usuário envia a foto e, geralmente, logo em seguida começam a surgir requests, ou ele mesmo atualiza a página. Mas tudo depende da aplicação que faz o upload.
Ou, por exemplo, outras pessoas que começaram a visualizar logo enviam requests para essa foto. No cache, ela ainda não está, o primeiro request ocorre muito rapidamente. Basicamente, é como no cache de fotos. O storage lento não participa disso. E quando ela for purgada em um dia, ou já estará cacheada em nossa camada de cache, ou provavelmente não será mais necessária. Ou seja, a experiência do usuário melhorou muito por causa dessas manipulações simples.
E, o mais importante: paramos de perder dados.
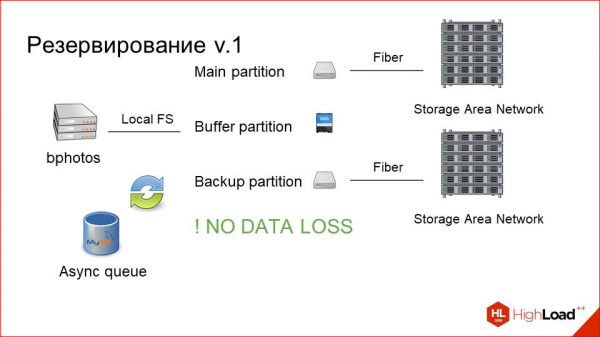
De certa forma, paramos potencialmente perder dados, porque na verdade não os perdemos. Mas havia um risco. Vemos que essa solução, claro, é boa, mas é um pouco parecida com o alívio dos sintomas do problema, em vez de resolvê-lo completamente. E alguns problemas ainda permanecem aqui.
Em primeiro lugar, este é um ponto de falha na forma do próprio host físico, no qual toda essa maquinaria opera, e ele não desapareceu.
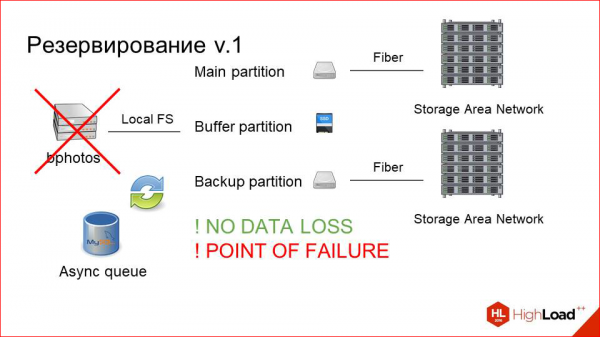
Em segundo lugar, ainda existem problemas com os SANs, sua manutenção pesada, etc. Isso não era um fator crítico, mas queria-se experimentar viver sem isso.
E fizemos a terceira versão (na verdade, a segunda) — uma versão de backup. Como isso se parecia?
Isso era o que havia –
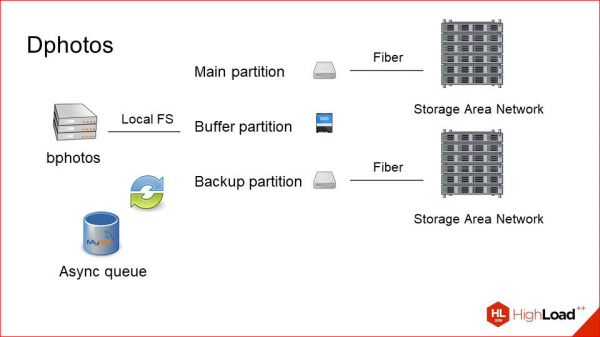
Nossas principais preocupações são com o fato de que este é um host físico.
Primeiro, estamos eliminando os SANs, porque queremos experimentar, queremos tentar usar apenas discos rígidos locais.
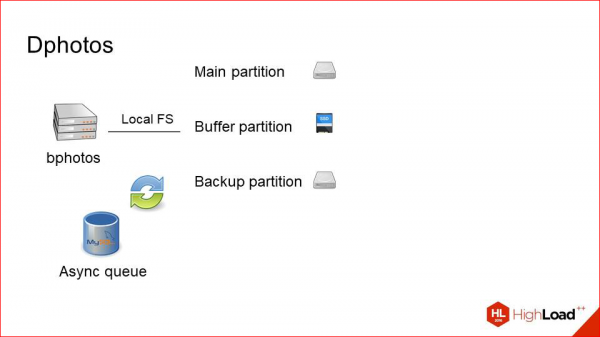
Isso já é 2014-2015, e na época a situação com os discos e sua capacidade em um host melhorou bastante. Decidimos, por que não tentar.
E então simplesmente pegamos nossa partição de backup e a transferimos fisicamente para uma máquina separada.
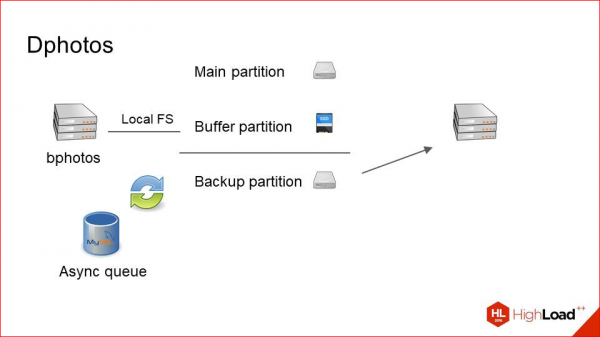
Dessa forma, obtemos esse esquema. Temos duas máquinas que armazenam conjuntos de dados idênticos. Elas se fazem backup mutuamente e sincronizam os dados pela rede através de uma fila assíncrona no mesmo MySQL.
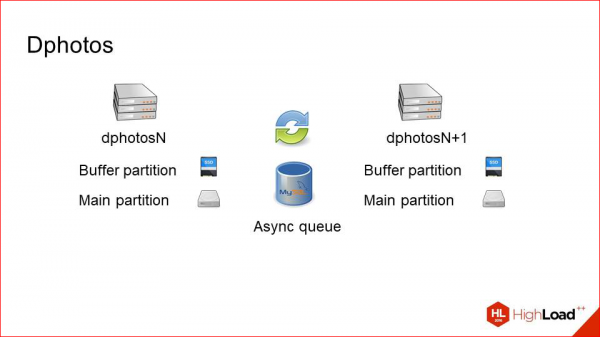
Por que isso funciona bem — porque temos poucas gravações. Ou seja, se a gravação fosse comparável à leitura, talvez tivéssemos alguma sobrecarga de rede e problemas. Há poucas gravações, muitas leituras — esse método funciona bem, ou seja, copiamo fotos entre esses dois servidores bem raramente.
Como isso funciona, se olharmos um pouco mais de perto.
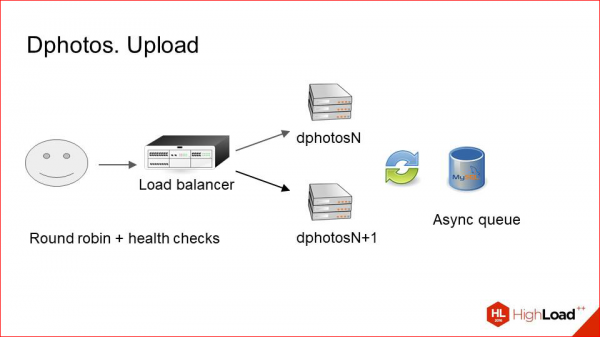
Upload. O balanceador simplesmente escolhe hosts aleatórios com pares e faz o upload para eles. Ao mesmo tempo, ele obviamente realiza verificações de saúde, garantindo que a máquina não fique fora de serviço. Ou seja, ele faz upload das fotos apenas para um servidor funcionando, e depois, através de uma fila assíncrona, tudo isso é copiado para seu vizinho. O upload é extremamente simples.
A tarefa é um pouco mais complexa.
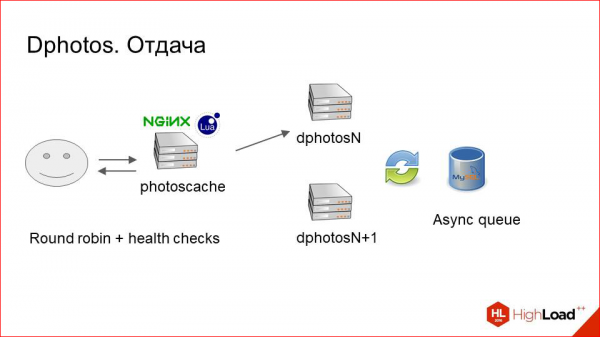
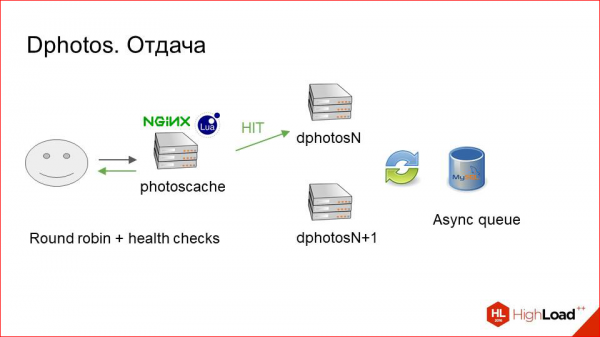
Aqui, Lua nos ajudou, porque é um pouco difícil implementar essa lógica no NGINX vanilla. Primeiro, fazemos uma requisição ao primeiro servidor, verificamos se a foto está lá, porque ela pode ter sido enviada, por exemplo, para o vizinho, e ainda não chegou aqui. Se a foto estiver lá, isso é bom. Nós a entregamos imediatamente ao cliente e, possivelmente, fazemos cache.
Se não estiver, fazemos uma requisição ao vizinho e garantimos que a recebemos de lá.
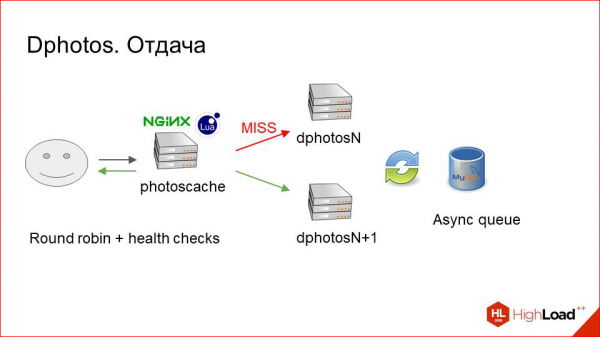
Assim, podemos novamente dizer: pode haver problemas de performance, porque as constantes idas e vindas — a foto foi enviada, aqui não está, fazemos duas requisições em vez de uma, isso deve funcionar lentamente.
Na nossa situação, isso não funciona lentamente.
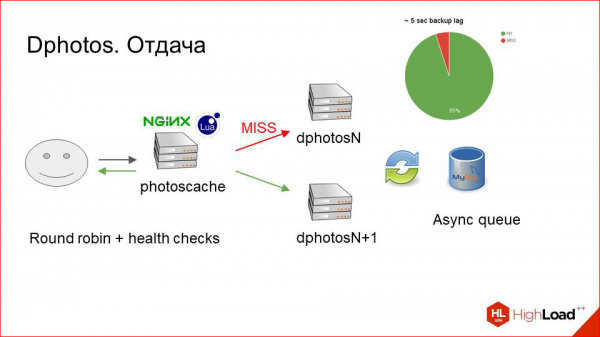
Estamos coletando uma série de métricas desse sistema, e a taxa de acertos desse mecanismo é em torno de 95%. Ou seja, o atraso desse backup é pequeno, e graças a isso, quase garantidamente, após a foto ser carregada, a pegamos na primeira vez e não precisamos ir a lugar nenhum duas vezes.
Assim, o que mais conseguimos, e que é muito legal?
Antes, tínhamos um principal volume de backup, e líamos dele sequencialmente. Ou seja, sempre buscávamos primeiro no principal e depois no backup. Isso era uma operação.
Agora nós utilizamos a leitura de duas máquinas ao mesmo tempo. Distribuímos as requisições em Round Robin. Em uma pequena porcentagem de casos, fazemos duas requisições. Mas, em geral, agora temos o dobro de capacidade de leitura do que tínhamos antes. E a carga diminuiu bastante, tanto nas máquinas que fazem a entrega quanto no armazenamento, que também tínhamos na época.
Quanto à tolerância a falhas. Na verdade, isso pelo que estávamos lutando principalmente. A tolerância a falhas aqui saiu fantástica.
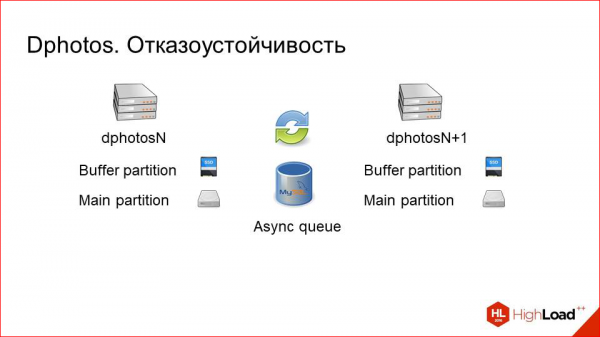
Uma máquina falha.
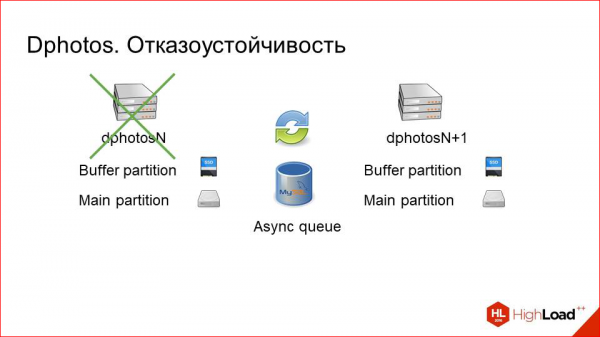
Sem problemas! O engenheiro de sistema pode até não acordar à noite, pode esperar até de manhã, não há nada de sério que aconteça.
Se a fila falhar mesmo com essa máquina quebrada, também não há problemas, simplesmente os logs vão se acumulando primeiro na máquina ativa e depois vão para a fila, e depois para a máquina que será reativada em algum momento.
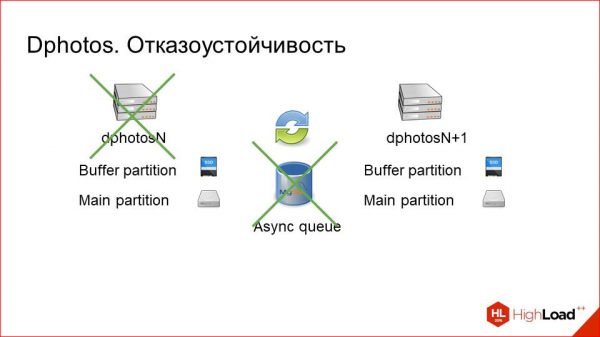
O mesmo se aplica à manutenção. Nós simplesmente desligamos uma das máquinas, a retiramos manualmente de todos os pools, ela para de receber tráfego, fazemos alguma manutenção, fazemos algumas correções e, depois disso, a reintegramos ao sistema. Este backup é recuperado rapidamente. Ou seja, um dia de inatividade de uma máquina é compensado em questão de minutos. Isso é realmente muito pouco. Com a alta disponibilidade, como já mencionei, tudo funciona muito bem.
Quais conclusões podemos tirar desse esquema de redundância?
Conseguimos alta disponibilidade.
Exploração simples. Como as máquinas possuem discos rígidos locais, isso é muito mais conveniente do ponto de vista da operação para os engenheiros que trabalham com isso.
Obtivemos um dobro na capacidade de leitura.
Esse é um ótimo bônus em relação à alta disponibilidade.
Mas também há problemas. Agora, temos um desenvolvimento muito mais complexo de algumas funções relacionadas a isso, porque o sistema se tornou 100% eventualmente consistente.
Devemos, por exemplo, em algum job em segundo plano, sempre pensar: 'Em qual servidor estamos rodando?' 'Temos certeza de que aqui está a imagem atual?' E assim por diante. Isso, naturalmente, tudo está encapsulado em wrappers e é transparente para o programador que escreve a lógica de negócios. No entanto, isso criou uma camada complexa. Mas estamos dispostos a conviver com isso em troca dos benefícios que obtivemos.
E aqui novamente surge um certo conflito.
No início, eu disse que armazenar tudo em discos rígidos locais é ruim. E agora estou dizendo que gostamos disso.
Sim, de fato, com o tempo a situação mudou bastante, e agora essa abordagem trouxe muitas vantagens. Primeiro, conseguimos uma operação muito mais simples.
Em segundo lugar, isso é mais eficiente, porque não temos aqueles controladores automáticos, conexão com prateleiras de discos.
Lá existem enormes maquinários, enquanto aqui são apenas alguns discos que estão montados localmente na máquina em RAID.
Mas também existem desvantagens.
Isso é aproximadamente 1,5 vezes mais caro do que usar SANs, mesmo com os preços atuais. Portanto, decidimos não converter todo o nosso grande cluster para máquinas com discos rígidos locais e optamos por manter uma solução híbrida.
Cerca de metade das máquinas que temos funciona com discos rígidos (bem, não exatamente metade – cerca de 30%, talvez). A parte restante consiste em máquinas mais antigas, que usavam um esquema de backup anterior. Nós apenas reconfiguramos, pois não precisamos de dados novos ou de qualquer outra coisa, apenas movemos os mounts de um host físico para dois.
Assim, conseguimos um grande aumento na leitura e ampliamos nossa capacidade. Se antes montávamos um storage em uma máquina, agora montamos quatro em um único par, por exemplo. E isso funciona bem.
Vamos fazer um breve resumo do que conseguimos, pelo que lutamos e se conseguimos.
Resultados
Temos usuários – no total, 33 milhões.
Temos três pontos de presença – Praga, Miami, Hong Kong.
Neles, há uma camada de cache que consiste em máquinas com discos locais rápidos (SSD), onde uma simples configuração com NGINX, seu access.log e demônios em Python processam e gerenciam o cache.
Se desejar, no seu projeto, se as fotos não forem tão críticas quanto para nós, ou se o equilíbrio entre controle e velocidade de desenvolvimento e consumo de recursos estiver a seu favor, então você pode facilmente substituí-lo por um CDN, que hoje em dia faz isso muito bem.
A seguir, temos a camada de armazenamento, onde temos clusters de pares de máquinas que se reservam mutuamente, com arquivos sendo copiados assíncronamente de uma para outra a cada alteração.
Uma parte dessas máquinas trabalha com discos rígidos locais.
Outra parte dessas máquinas está conectada a SANs.
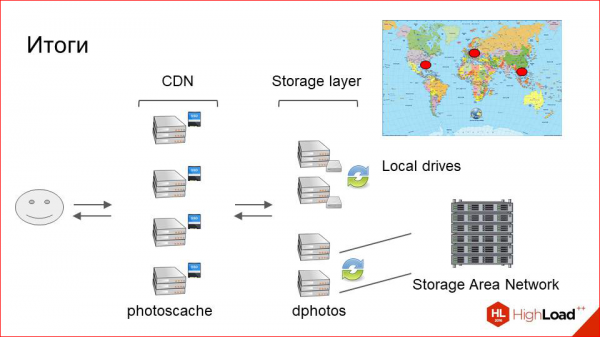
E, por um lado, isso é mais conveniente em termos de operação e um pouco mais eficiente, por outro lado, é prático em termos de densidade de alocação e custo por gigabyte.
Este é um breve resumo da arquitetura do que conseguimos e como isso tudo evoluiu.
Mais alguns conselhos do chefe, bem simples.
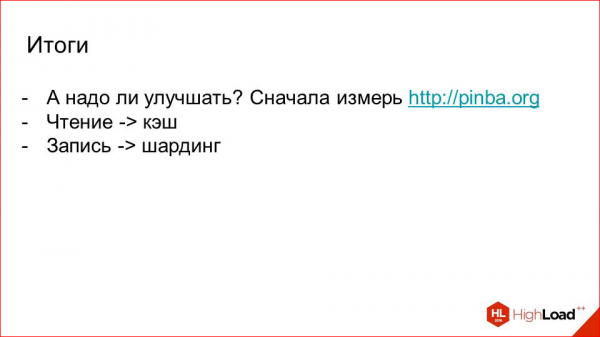
Primeiro, se você decidir que precisa urgentemente melhorar toda a sua infraestrutura de fotos, meça primeiro, pois talvez não seja necessário melhorar nada.
Vou dar um exemplo. Temos um cluster de máquinas que fornece fotos de anexos em chats, e lá ainda funciona um esquema de 2009, e ninguém sofre por isso. Todos estão satisfeitos, todos gostam.
Para medir, comece por definir um conjunto de métricas, analise-as e então decida o que não está funcionando e o que precisa ser melhorado. Para isso, temos uma ferramenta incrível chamada Pinba.
Ela permite coletar estatísticas do NGINX de forma detalhada para cada requisição e códigos de resposta, e a distribuição de tempos — tudo o que você precisar. Possui integrações com várias plataformas de análise, permitindo que você visualize tudo de forma clara.
Primeiro medimos — depois melhoramos.
A seguir. Otimizamos a leitura com cache, e a gravação com sharding, mas isso é um ponto óbvio.
Em seguida. Se você está apenas começando a construir seu sistema, é muito melhor tratar fotos como arquivos imutáveis. Isso evita uma série de problemas relacionados à invalidação do cache e à lógica que deve encontrar a versão correta da foto, entre outros.
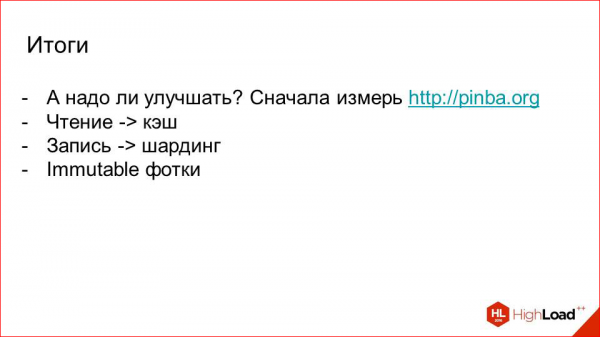
Suponha que você carregou uma foto, depois a girou; faça com que isso gere um arquivo fisicamente diferente. Ou seja, não tente economizar um pouco de espaço gravando no mesmo arquivo e alterando a versão. Isso sempre traz complicações e muitas dores de cabeça depois.
Próximo ponto. Sobre redimensionamento em tempo real.
Anteriormente, quando os usuários enviavam uma foto, criávamos diversos tamanhos para todas as situações, para diferentes clientes, e eles todos eram armazenados no disco. Agora, desistimos disso.
Deixamos apenas três tamanhos principais: pequeno, médio e grande. Todo o resto é redimensionado a partir do tamanho mais próximo que foi solicitado no Uport, apenas fazemos um downscale e entregamos ao usuário.
O custo do CPU da camada de cache acaba sendo muito mais barato do que se estivermos constantemente regenerando esses tamanhos em cada armazenamento. Suponha que queiramos adicionar um novo; isso pode levar um mês — rodar um script em todos os lugares que faça esse trabalho com cuidado, sem derrubar o cluster. Ou seja, se houver a opção de escolher, é melhor manter o menor número possível de tamanhos físicos, mas garantir algum tipo de distribuição, digamos, três. E todo o resto, apenas redimensionar em tempo real com módulos prontos. Isso agora é muito fácil e acessível.
E um backup assíncrono incremental — isso é uma boa prática.
Como nossa prática mostrou, esse tipo de esquema funciona muito bem para a cópia atrasada de arquivos alterados.
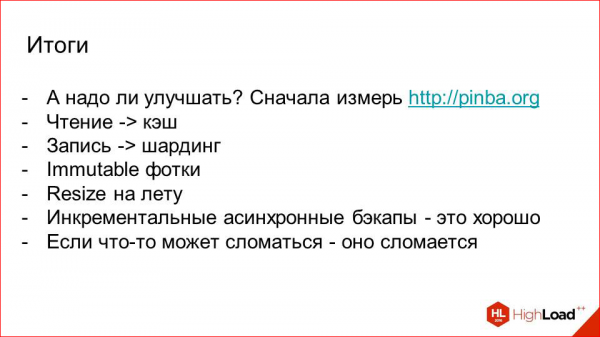
O último ponto também é óbvio. Se sua infraestrutura não tem esses problemas no momento, mas há algo que pode falhar, com certeza isso acontecerá quando houver uma leve pressão extra. Portanto, é melhor pensar nisso com antecedência e evitar problemas mais tarde. Isso é tudo.
Contatos
»
»
Esta apresentação é a transcrição de uma das melhores palestras na conferência de desenvolvedores de sistemas de alta carga . Faltam menos de um mês para a conferência HighLoad++ 2017.
Já temos , e a programação está sendo ativamente formada.
Este ano, continuamos explorando o tema de arquiteturas e escalabilidade:
- / Игорь Васильев
- / Дмитрий Егоров
- / Анатолий Пласковский
- / Роман Шеховцов, Алексей Громатчиков
- / Филипп Дельгядо
Alguns desses materiais também são utilizados por nós no curso online de desenvolvimento de sistemas de alta carga — uma série de e-mails, artigos, materiais e vídeos especialmente selecionados. Já temos mais de 30 materiais únicos em nosso manual. Junte-se a nós!
Fonte: habr.com
