

por St-Pete
Olá a todos! Sou Mons Anderson, arquiteto de plataforma , vou contar como construímos nosso armazenamento S3, como ele funciona, quais soluções se mostraram eficazes e quais mudaríamos se tivéssemos que iniciar esse projeto do zero hoje.
Este artigo foi preparado com base em uma apresentação na por Mail.ru Cloud Solutions & Tarantool. Neste artigo, vamos falar sobre:
- como o armazenamento Mail.ru foi estruturado, em cima do qual construímos o armazenamento S3;
- o que adicionamos para criar o Mail.ru Cloud Storage;
- como funciona o modelo de armazenamento de objetos e quais passos foram dados para a produção;
- sobre as melhorias do sistema de produção: failover e escalabilidade;
- como implementamos sharding e resharding;
- e também sobre o trabalho com certificados SSL.
Se você não quiser ler, pode .
Como o armazenamento Mail.ru foi estruturado, em cima do qual construímos o armazenamento S3
O desenvolvimento do nosso S3 começou em cima do armazenamento da Nuvem Mail.ru, então é importante explicar como ele é estruturado e o que consegue fazer.
O armazenamento da nuvem Mail.ru consiste em servidores com discos. Em média, um servidor de storage moderno possui 36 discos de 12 a 14 terabytes. Antes, os discos eram menores, mas em três anos, as capacidades dos discos aumentaram e hoje isso representa quase meio petabyte de dados brutos.
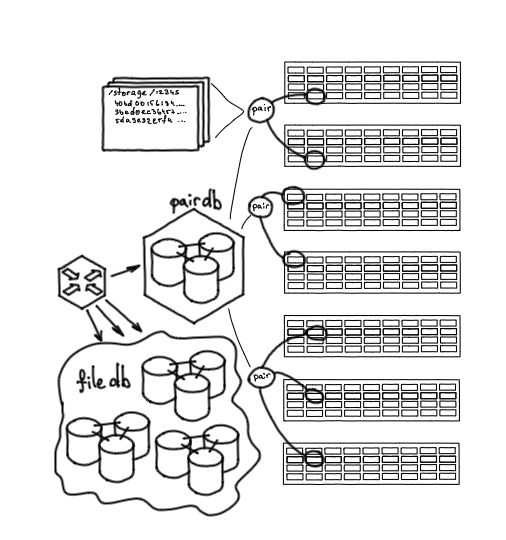
Os discos de diferentes servidores de armazenamento são agrupados em chamadas "duplas" (pair). Uma dupla é uma unidade única de armazenamento de arquivos. Essencialmente, é um disco montado em uma determinada partição em um caminho específico, onde podem residir arquivos identificados por hashes.
Uma dupla é uma denominação histórica que se manteve até hoje, embora atualmente em uma dupla não sejam necessariamente apenas dois discos. Podem haver três discos, bem como várias armazenagens híbridas, como 3/2.
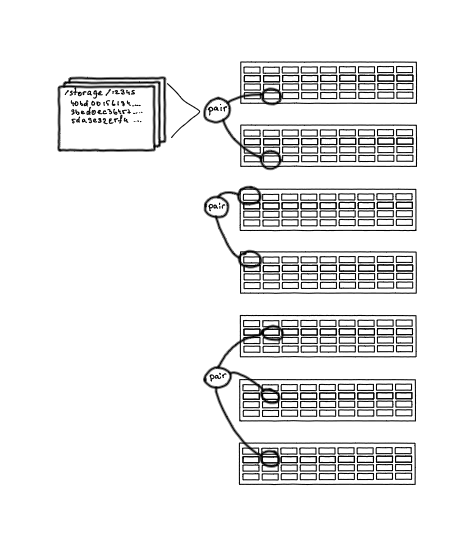
Duplas (pair) — unidades de armazenamento de objetos
Todas as duplas são armazenadas no PairDB — um aplicativo baseado em Tarantool. Todos os bancos em nosso armazenamento, desde os primeiros, são Tarantool; não utilizamos outros bancos.
PairDB armazena todas as duplas, seus estados, espaço livre, capacidades de falha, últimos erros. Além disso, pode verificar as duplas, atualizar seu estado, checar se estão funcionando ou não. Ou seja, o PairDB fornece uma visão geral do estado de todos os discos do nosso sistema.
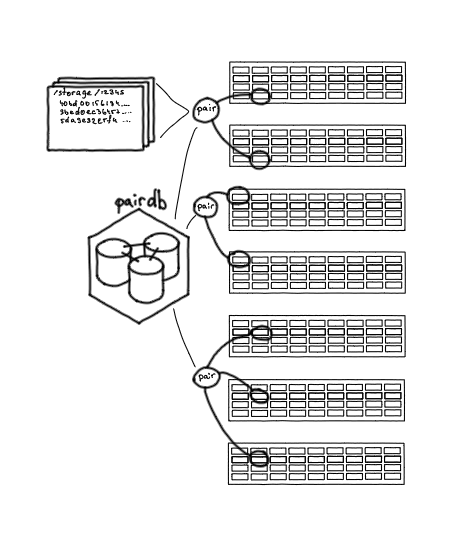
Pair DB: banco de dados com o estado das duplas
Os pares armazenam arquivos e, para saber em qual par está cada arquivo, precisamos de mais um banco de dados — FileDB. Ele armazena o mapeamento, a definição de correspondência: esse arquivo está armazenado nesse par, além de um pequeno número de atributos necessários.
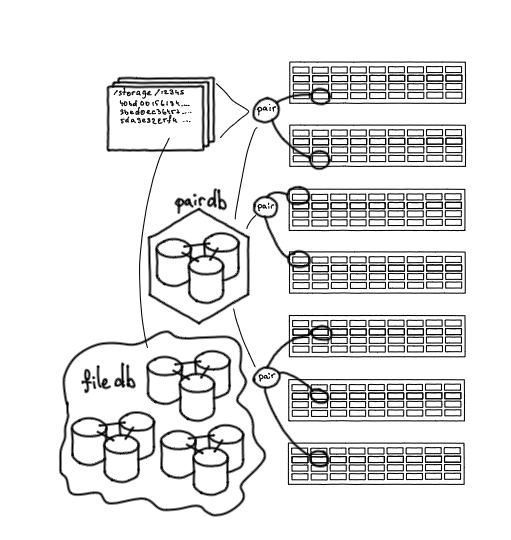 File DB: o lugar onde o arquivo é armazenado
Outro elo importante é o serviço Nylon, um roteador para trabalhar com bancos de dados. Ele é o único ponto de entrada e permite trabalhar através de uma interface única tanto com PairDB quanto com FileDB. É um serviço sem estado, realiza o balanceamento de requisições, entende a qual shard do FileDB deve dirigir-se, sabe quais pares estão ativos e quais não estão.
Nylon: roteador para trabalhar com bancos de dados
Além disso, é necessário de alguma forma inserir conteúdo no armazenamento. Para isso, existe um serviço — Streamer. Ele fornece dois métodos HTTP: método PUT, para enviar conteúdo ao armazenamento, e método GET, para recuperá-lo. O HTTP é um protocolo bastante popular e conveniente para a transferência de dados.
Quando nos dirigimos ao Streamer, ele se comunica com o PairDB através do Nylon, descobre em qual par é possível enviar o arquivo, e então transmite os dados via WebDAV para esse par.
Na essência, qualquer servidor de armazenamento é composto por nginx mais discos montados em caminhos específicos. Podemos usar o Streamer para enviar um arquivo para o armazenamento, deletá-lo, renomeá-lo ou verificar sua integridade. Ou seja, é uma interface conveniente para interação de baixo nível com o armazenamento.
Streamer: ponto de entrada no armazenamento
O que adicionamos para criar o armazenamento S3
Assim, examinamos a estrutura básica do armazenamento no momento em que decidimos lançar o armazenamento S3. Usando o método PUT, podíamos inserir qualquer conteúdo e receber como identificador desses dados um hash. Com esse identificador, poderíamos posteriormente voltar e recuperar o arquivo original. Mas isso não é suficiente para implementar o S3. No protocolo S3, além do próprio armazenamento de objetos, existem:
- armazenamento de metadados — propriedades adicionais dos objetos;
- organização de acesso aos objetos via HTTP;
- agrupamento de objetos em coleções — buckets;
- Endpoint HTTP-S3. O S3 organiza os dados em estruturas específicas — buckets, cada um dos quais fornece um ponto de entrada para o armazenamento de arquivos.
Para implementar essa lógica, foi necessário um serviço separado. Também queríamos antecipar a arquitetura para o crescimento futuro do serviço com escalabilidade linear.
Os primeiros componentes
Um daemon que implementa a API S3. Esta é a padrão API S3 da Amazon, que suporta operações em XML para metadados e permite a transferência direta de conteúdo. Não precisávamos reinventar a roda, tudo já está descrito e documentado.
Também colocamos o Nginx diante do serviço. Usamos para terminação SSL, balanceamento de carga, além de alguma lógica em Lua (métricas, logging e tracing).
Para armazenar metadados S3, também escolhemos o Tarantool. Na primeira versão, o daemon S3 acessava essa base para metadados enquanto o conteúdo era armazenado em um grande repositório através do Streamer.
Nginx + API S3 + metadados
Modelo de objeto de armazenamento
Vamos ver como funciona o S3. O usuário pode criar um bucket — uma coleção de objetos. O bucket é acessado pelo nome do host e é um subdomínio do serviço. Dentro do bucket, o usuário pode criar objetos. O identificador do objeto será a URL. O conteúdo do objeto é um blob, um array de dados binários que vamos armazenar no repositório. O objeto também possui atributos: nome — a própria URL, ACL (lista de controle de acesso), outros atributos adicionais ou arbitrários — tudo isso é armazenado nos metadados.
O esquema normalizado desses dados pode parecer assim: existem projetos que possuem buckets, que possuem objetos, e os objetos podem ser compostos. Como uma forma de upload, os objetos podem ser carregados em partes, e há duas tabelas auxiliares para o upload: uploads e chunks. Além disso, os projetos têm credenciais de acesso e faturamento.
Esquema de dados
Como estávamos criando um serviço B2B com acesso pago, esse esquema precisava de faturamento.
O serviço de faturamento também foi implementado no Tarantool.
Desenvolvimentos do armazenamento S3: etapas para produção
Já temos um modelo funcional que pode ser usado: os objetos e metadados estavam armazenados, mas para a produção faltavam alguns detalhes.
Em primeiro lugar, temos o sistema de rate limiting. Se lançarmos o serviço sem ele, poderíamos sobrecarregar de forma imprevisível alguma parte do sistema durante picos de carga. O rate limit deve funcionar da seguinte forma: qualquer requisição S3 chega a um host específico, esse host é o identificador do bucket, e o bucket pertence a um determinado cliente. Precisamos definir uma função para o bucket que permita calcular o rate limit.
Além disso, o sistema de rate limiting deve ser suficientemente eficiente para suportar a carga que chega ao S3.
Aqui, novamente usamos o Tarantool. Os rate limits são um cluster de 21 instâncias, com as instâncias divididas em grupos, distribuídas em três nós físicos e unidas em um grande cluster topológico. As alterações de configuração são automaticamente aplicadas por meio dele: rate limits, padrões e configurações são definidos. Cada bucket é atendido estritamente por uma única instância. Quando uma requisição para um bucket específico chega, calculamos a instância responsável por esse bucket. Dentro desse nó, é feito o cálculo da taxa atual de acessos por meio de um algoritmo semelhante ao Token Bucket. Em seguida, o sistema de rate limiting, com base nos indicadores atuais de carga e nas propriedades definidas para o bucket específico, determina se a requisição pode ser atendida ou não. A verificação dos limites é realizada na fase inicial da execução da requisição S3, protegendo todos os outros elementos do sistema contra sobrecarga.
Além disso, sob carga, é bastante difícil operar sem um cache. No S3, espera-se um acesso repetido aos mesmos objetos, ou seja, é um armazenamento quente. Em condições normais, o acesso a um único arquivo é gerenciado por toda a cadeia: Streamer, FileDB, PairDB, Storage. Mas ao acessarmos um arquivo repetidamente, otimizamos o acesso a esse conteúdo utilizando um cache local.
O cache é em camadas e implementado com o nginx, unidades locais, SSD e discos de RAM. Aqui não usamos o Tarantool, pois é mais conveniente servir objetos a partir do sistema de arquivos, permitindo a realização de tiering do cache. Além disso, temos objetos grandes com um tamanho máximo de 32 gigabytes, e no Tarantool apenas objetos pequenos podem ser armazenados em cache.
Este foi o primeiro sistema com o qual iniciamos, que tinha uma capacidade calculada, suficiente para pesquisa e compreensão do produto, para garantir que ele funcionaria.
Aprimoramentos do sistema em produção: failover e escalabilidade
O sistema já estava em operação, e no início nós negligenciamos alguns aspectos - era necessário adicionar failover e escalabilidade.
Nosso daemon S3 buscava metadados pelo protocolo Tarantool. Substituímos o banco de dados original pelo Tarantool, que atuava como um roteador proxy para as solicitações de metadados. Do ponto de vista do aplicativo que implementa a API, nada mudou - ele continuou a acessar o banco de dados pelo protocolo Tarantool, mas o roteador pôde fornecer um failover ativo. Isso nos permitiu verificar a disponibilidade do nó, gerenciar interrupções durante as transições e falhas, e assim por diante. O aplicativo em si, no entanto, não foi modificado.
Saiba mais sobre como implementamos a fragmentação
A próxima questão que tivemos que considerar foi a fragmentação. O sistema cresceu, o número de objetos aumentou e era preciso garantir possibilidades para o crescimento futuro.
Voltando ao esquema de dados: temos projetos, buckets, credenciais e faturamento. Estes são objetos que, com alta probabilidade, não ultrapassarão os limites de uma única instância, nem em volume, nem em requisições, no futuro próximo. Portanto, não faz sentido fragmentá-los, e os movemos para uma instância separada, que permanecerá não fragmentada. Isso permite uma gestão mais consistente dos projetos e buckets, já que temos um único ponto não fragmentado.
Além disso, no esquema existem objetos que crescem linearmente - inicialmente eram centenas de milhares, agora seu número chega a bilhões. Esses objetos e suas partes precisavam ser movidos para um cluster fragmentado.
Dividimos o esquema, mas os objetos precisam trabalhar com os buckets: cada objeto sempre pertence a um bucket específico, e o ACL opera nesse bucket. Portanto, para cada shard com objetos, mantemos uma cópia sombra de cada bucket. Além disso, durante a modificação dos objetos e execução das solicitações, é necessário contabilizar o volume para realizar a cobrança, então cada shard possui contadores de faturamento.
Também adicionamos mais algumas tabelas e componentes:
- lixeira, para eliminar antigos projetos que são excluídos ou congelados;
- fila para tarefas em segundo plano, ou seja, o armazenamento principal pode executar tarefas em segundo plano que precisam ser feitas no cluster;
- suporte ao ciclo de vida — um mecanismo que permite trabalhar com objetos e gerenciar seu ciclo de vida.
Como parte dos dados foi movida para shards, precisávamos de um proxy de shard. Poderíamos ter reutilizado o roteador para essa função, mas um proxy de shard separado, responsável apenas pelo shard dos dados, permite que o roteador acesse os dados em geral, sem se preocupar com shard.
Vou explicar separadamente por que não utilizamos uma solução pronta, mas quisemos criar uma função de shard personalizada.
Vamos ver como ela é estruturada. Temos 256 shards disponíveis. Para cada bucket, alocamos um intervalo usando uma função consistente. É simples — assim como você determina a atribuição a um shard usando uma função consistente, você determina o shard inicial e aloca um intervalo:
f(bucket, shards) = subconjunto
Ou seja, se pegarmos um bucket, podemos dizer que ele e seus dados estarão sempre em um subconjunto específico de todos os shards. Isso permite reduzir a influência de alguns buckets sobre outros e simplifica a execução de consultas map-reduce, quando é necessário, por exemplo, listar objetos de um bucket. Para isso, é preciso interrogar todos os shards onde esses objetos estão armazenados. Se os objetos estivessem em todos os shards, qualquer listagem afetaria todo o sistema, mas aqui afeta apenas um subconjunto específico.
Além disso, cada objeto pertence a um bucket específico, portanto, quando acessamos um objeto, estamos acessando um objeto pelo nome em um bucket específico. Ou seja, podemos definir uma função para o objeto não a partir de todo o intervalo de shards disponíveis, mas apenas a partir do subconjunto do seu bucket:
f(object, subset) = shard
Pegamos um objeto específico e, como argumentos da função, passamos não todos os shards, mas o subconjunto do seu bucket — e obtemos o shard específico.
Assim, o sharding está implementado, existe um proxy de sharding. O que resta é que o roteador e o banco de metadados acessem o proxy de sharding. Por exemplo, para criar objetos de cópias sombra — quando criamos um bucket, o armazenamento principal deve criar um representante desse bucket em todos os shards onde ele deve estar presente.
Como implementamos o resharding
O maior problema do sharding é o resharding. Era importante para nós fazê-lo sem downtime, pois o sistema já estava em produção. Vou mostrar como resolvemos o problema por meio de uma tarefa semelhante de migração de dados ao vivo de um projeto para outro.
Abaixo está o diagrama do nosso cluster, que foi criado após a implementação do sharding. Temos nginx, API S3, roteador, banco de dados primário com projetos, proxy shard e, diretamente, shards.
Acima, eu deixei de lado o fato de que em um certo momento do projeto havia uma necessidade de produto: "Lançar mais um armazenamento, Icebox, como Hotbox, mas para dados frios". Essencialmente, é um armazenamento semelhante, mas com URLs diferentes e sem caches.
O Icebox foi utilizado menos do que o Hotbox, então ele ficou bastante tempo sem qualquer sharding. No final, decidimos descontinuá-lo e unir Hotbox e Icebox em um único serviço, apenas dividindo as classes de armazenamento.
Os buckets nos armazenamentos não se sobrepunham, eram facilmente mescláveis e transferíveis, mas os clientes usavam ambos os armazenamentos, o que significava que precisávamos resolver o problema de falta de downtime. Não podíamos simplesmente desligar e copiar. Fizemos a migração em várias etapas.
Primeiro, sincronizamos os armazenamentos primários. Tínhamos Tarantool e podíamos, ao criar um objeto, fazer o seguinte:
- um pedido de criação de bucket chega ao banco, por exemplo, no Hotbox;
- o Tarantool verifica em outro banco (neste caso, no Icebox) se tal bucket não existe;
- se o bucket existir, o banco informa que não pode ser criado, e ele se sincronizou como existente.

Sincronização de buckets
No armazenamento que deveria receber todos os dados, introduzimos para projetos e buckets um sinalizador que indicava onde esse objeto estava armazenado. Ele poderia estar armazenado localmente, ou seja, no Hotbox, no Icebox - neste caso, no novo armazenamento não havia dados para ele, ou poderia estar em estado de migração.
Se um projeto ou bucket tinha o sinalizador Migrating, durante a migração o pedido era executado primeiro no novo armazenamento, onde os dados deveriam estar, e se não estivessem lá, os pedidos eram redirecionados para o armazenamento alternativo.
Depois, mudamos o tráfego. Como a API poderia atender tanto os pedidos do Icebox quanto os do Hotbox, conseguimos mudar o tráfego sem downtime, simplesmente transferindo os hosts e adicionando os registros apropriados no Nginx.
Após o redirecionamento do tráfego, o Nginx e a API da Icebox puderam ser removidos.
Em seguida, removemos o nginx da Icebox e a API S3 — e tudo funcionou.
Depois, iniciamos um processo de migração em segundo plano que opera dentro do banco de dados — percorre todos os projetos e seus buckets, marca-os como Migrating, transfere os dados e, ao concluir a transferência, define o status como Local.
Após a transferência de dados, não precisamos mais do armazenamento antigo, e removemos as partes restantes do sistema antigo, assim como removemos do código o suporte ao status de migração.
Da mesma forma, foi realizada a resharding do armazenamento antigo para o shard:
- Marcamos todos os buckets como
Non-sharded. Todas as solicitações para esses buckets foram direcionadas ao armazenamento original, não shard. - Novos buckets foram criados imediatamente com o status
Sharded. - Um a um, pegávamos os buckets, marcávamos o status como
Migratinge transferíamos os dados.
As solicitações foram atendidas da seguinte maneira:
- Lemos no novo, depois no antigo.
- Criamos apenas no novo.
- Atualizamos de forma bifásica: se não houver no novo, transferimos do antigo para o novo, depois atualizamos.
Trabalho com certificados SSL
Na frente, usamos Nginx. Neste caso, não é um Nginx comum, mas OpenResty, Nginx com suporte a LuaJIT.
Mais uma parte do sistema — trabalho com certificados SSL. No armazenamento S3, você pode definir seu próprio domínio para acessar um bucket específico, apenas usando CNAME. Mas atualmente não se pode ter HTTPS: um domínio próprio implica em um certificado SSL próprio.
Como mencionei, o Nginx é responsável pelo balanceamento e pela terminação SSL. Neste caso, não é um Nginx comum, mas OpenResty, Nginx com suporte a LuaJIT.
Isso nos permitiu ensinar nosso Nginx a entregar certificados arbitrários de maneira bastante simples. Além disso, precisávamos fornecer certificados de forma dinâmica (sem a necessidade de especificá-los no arquivo de configuração). Utilizamos a extensão ssl_certificate_by_lua, que permite ler o certificado de uma fonte arbitrária durante o handshake TLS. Como repositório de certificados, também utilizamos o Tarantool: isso permite gerenciar os certificados externamente e garante uma entrega extremamente rápida.
Um daemon separado também foi implementado, cuja tarefa é atualizar regularmente os certificados emitidos pelo Let's Encrypt.
O que eu manteria e o que faria diferente se estivesse desenvolvendo o armazenamento do zero
O que deveria ter sido usado desde o início
Sharding desde o início. Fomos confrontados com muitos problemas devido à resharding. Ele é fácil de implementar, mas se você está começando projetos que precisam escalar, é melhor usar um cluster shardado desde o início, mesmo que com um número mínimo de nós. A implementação de sharding no início é quase gratuita em comparação com a implementação de sharding em um sistema em produção.
Trabalhando com Tarantool através de balanceadores. Atualmente, conectamos todas as novas bases de dados ao sistema através de balanceadores. Isso permite expandir a funcionalidade e alcançar maior resistência a falhas.
Auto-failover. Eu teria instalado todas as ferramentas necessárias para o auto-failover, pois as primeiras falhas após o lançamento estavam relacionadas à sua ausência. Após a experiência com o S3, todos os produtos subsequentes foram lançados levando isso em consideração.
Recurso S3 "Versionamento". No início pareceu que essa funcionalidade não era muito demandada. Integrar essa possibilidade na arquitetura de um sistema em funcionamento é extremamente difícil.
Faturamento separado. A forma como integramos o faturamento em nosso sistema se mostrou adequada no início, mas posteriormente se tornou um obstáculo; teria sido melhor implementá-lo como um serviço completamente separado.
O que foi uma decisão acertada
Modelo de dados. A história mostrou que, à medida que o serviço se desenvolvia, estávamos bastante alinhados com o modelo de dados da Amazon, permitindo-nos implementar as mesmas funcionalidades que existem lá.
Esquema de sharding. Eu apoiaria o mesmo tipo de sharding por faixas em buckets, pois isso permite distribuir bem as requisições de diferentes buckets por um grande cluster.
Uso de Tarantool. Tarantool ajudou bastante no desenvolvimento e modificação do serviço; trabalhamos com dados facilmente, transformamos e shardamos o armazenamento sem a necessidade de subir para o nível da aplicação.
Esta apresentação foi feita pela primeira vez na por Mail.ru Cloud Solutions & Tarantool. Veja outras apresentações e inscreva-se para receber atualizações de eventos no Telegram .
Você também pode assistir minha antiga apresentação sobre S3 ou ler o artigo de um colega sobre armazenamento em bloco.
- .
- .
Fonte: habr.com
