

Nos dois primeiros artigos, abordei a questão da automação e esbocei seu framework; no segundo, fiz uma digressão sobre virtualização de redes, como uma primeira abordagem para a automação da configuração de serviços.
Agora é hora de desenhar o esquema da rede física.
Se você não é íntimo com o equipamento das redes de data center, eu recomendo fortemente começar com .
Todas as edições:
As práticas descritas nesta série devem ser aplicáveis a redes de qualquer tipo, em qualquer escala, com qualquer diversidade de fornecedores (não). No entanto, não é possível descrever um exemplo universal da aplicação dessas abordagens. Portanto, vou focar na arquitetura moderna da rede de data center: .
Faremos DCI sobre MPLS L3VPN.
Sobre a rede física, opera uma rede Overlay a partir do host (que pode ser VXLAN do OpenStack ou Tungsten Fabric ou qualquer outra que exija apenas conectividade IP básica da rede).
Nesse caso, teremos um cenário relativamente simples para automação, porque temos muito equipamento que se configura da mesma forma.
Vamos escolher um data center esférico no vácuo:
- Uma versão do design em todos os lugares.
- Dois fornecedores, formando duas camadas de rede.
- Um data center se parece com o outro como duas gotas d'água.
Conteúdo
- Topologia física
- Roteamento
- Plano IP
- Laboratório
- Conclusão
- Links Úteis
Digamos que nosso Provedor de Serviço LAN_DC irá, por exemplo, hospedar vídeos de treinamento sobre sobrevivência em elevadores presos.
Nas metrópoles, isso é extremamente popular, portanto, precisamos de muitas máquinas físicas.
Primeiro, descreverei a rede aproximadamente como gostaria que fosse vista. E depois simplificarei para o laboratório.
Topologia física
Localizações
A LAN_DC terá 6 data centers:
- Rússia (RU):
- Moscovo (msk)
- Kazan (kzn)
- Espanha (SP):
- Barcelona (bcn)
- Málaga (mlg)
- China (CN):
- Xangai (sha)
- Xi'an (sia)

Dentro do data center (Intra-DC)
Em todos os data centers, redes internas de conectividade idênticas, baseadas na topologia Clos.
O que são redes Clos e por que exatamente elas — em um artigo separado .
Em cada data center, há 10 racks com máquinas, elas serão numeradas como A, B, C E assim por diante.
Cada rack possui 30 máquinas. Elas não nos interessarão.
Além disso, em cada rack há um switch ao qual todas as máquinas estão conectadas — este é um Top of the Rack switch — ToR ou, em termos da fabric Clos, o chamaremos de Leaf.

Esquema geral da fabric.
Nomeá-los-emos de XXX-leafY, onde XXX — sigla de três letras para DC, a Y — número sequencial. Por exemplo, kzn-leaf11.
Em meus artigos, permitirei-me usar os termos Leaf e ToR de forma bastante livre, como sinônimos. No entanto, é preciso lembrar que isso não é exatamente correto.
ToR é um switch montado em rack ao qual as máquinas são conectadas.
Leaf é o papel de um dispositivo na rede física ou um switch de primeiro nível em termos de topologia Clos.
Ou seja, Leaf != ToR.
Portanto, um Leaf pode ser um switch EndofRaw, por exemplo.
No entanto, neste artigo, ainda me referirei a eles como sinônimos.
Cada switch ToR, por sua vez, está conectado a quatro switches agregadores superiores — Spine. Foi designado uma rack para os Spine no DC. Nomearemos de forma análoga: XXX-spineY.
Neste mesmo rack, haverá equipamentos de rede para conectividade entre os DCs — 2 roteadores com MPLS a bordo. Mas, no final das contas, são os mesmos ToRs. Ou seja, do ponto de vista dos switches Spine, não faz nenhuma diferença se é um ToR comum com máquinas conectadas ou um roteador para DCI — ambos encaminham da mesma forma.
Esses switches ToR especiais são chamados de Edge-leaf. Nomearemos de XXX-edgeY.
Assim será a aparência.
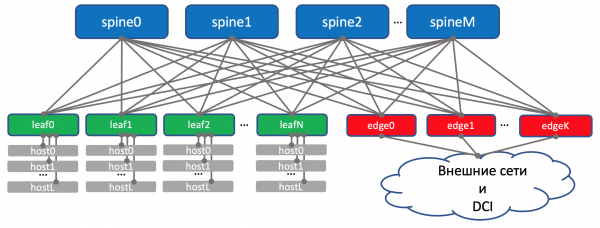
No diagrama acima, realmente coloquei edge e leaf no mesmo nível. nos acostumaram a considerar o uplink (daí o termo) como conexões para cima. E aqui, o ‘uplink’ DCI vai para baixo, o que quebra um pouco a lógica habitual para alguns. Nos casos de grandes redes, onde os data centers são divididos em unidades ainda menores — POD‘s (Point Of Delivery), são destacados Edge-POD‘s para DCI e saída para redes externas.
Para facilitar a percepção posteriormente, ainda desenharei Edge acima do Spine, mantendo em mente que não há inteligência no Spine e nenhuma diferença ao trabalhar com Leaf comum e com Edge-leaf (embora possam haver nuances, mas, de um modo geral, é isso).
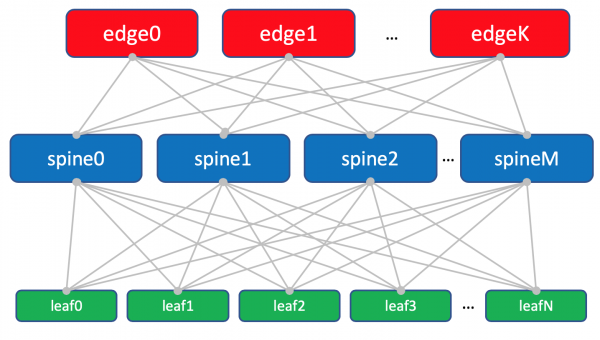
Diagrama da fábrica com Edge-leafs.
O trio Leaf, Spine e Edge forma a rede Underlay ou a fábrica.
A tarefa da fábrica de rede (leia-se Underlay), como já definimos em , é muito, muito simples — garantir conectividade IP entre máquinas, tanto dentro de um DC quanto entre eles.
Daí o nome fábrica para a rede, assim como a fábrica de comutação dentro de caixas de rede modulares, sobre a qual se pode ler mais em .
Na verdade, essa topologia é chamada de fábrica, porque fabric, em tradução, significa tecido. E é difícil discordar:
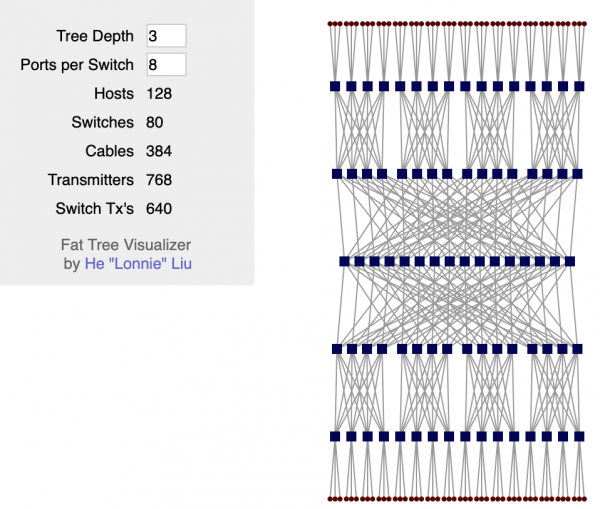
A fábrica é completamente L3. Nenhum VLAN, nenhuma Broadcast — temos programadores incríveis no LAN_DC que sabem criar aplicações que operam na paradigma L3, e as máquinas virtuais não requerem Live Migration mantendo o endereço IP.
E mais uma vez: a resposta para a pergunta sobre por que é fábrica e por que L3 está em uma seção separada. .
DCI — Data Center Interconnect (Inter-DC)
O DCI será organizado usando Edge-Leaf, ou seja, eles são nosso ponto de saída para a rede de backbone.
Para simplificar, vamos supor que os DCs estejam conectados por links diretos.
Excluiremos da análise a conectividade externa.
Estou ciente de que cada vez que removo algum componente, estou simplificando significativamente a rede. E na automação de nossa rede abstrata tudo funcionará bem, mas na real surgirão gambiarras.
É verdade. E ainda assim, o objetivo desta série é pensar e trabalhar nas abordagens, e não resolver heroicamente problemas inventados.
Nos Edge-Leaves, o underlay é colocado em VPN e transmitido através da rede MPLS (aquela ligação direta).
Assim, temos um diagrama de alto nível.

Roteamento
Para o roteamento dentro do DC, usaremos BGP.
Na rede MPLS, OSPF+LDP.
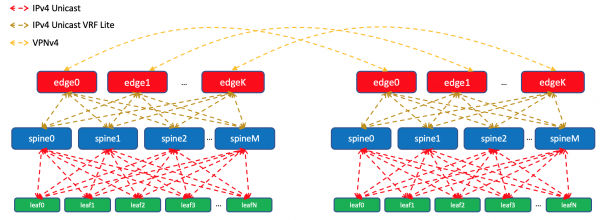
Para DCI, ou seja, organização da conectividade no underlay — BGP L3VPN sobre MPLS.
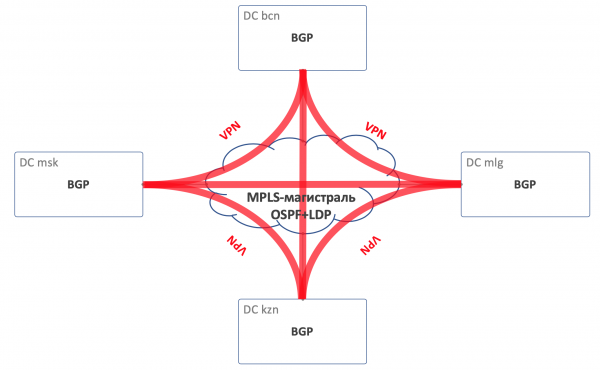
Diagrama geral de roteamento
Na fábrica, não há OSPF e ISIS (protocolo de roteamento proibido na Federação Russa).
E isso significa que não haverá Auto-discovery e cálculo de caminhos mais curtos — apenas configuração manual (na verdade automática — estamos falando de automação aqui) do protocolo, dos vizinhos e das políticas.
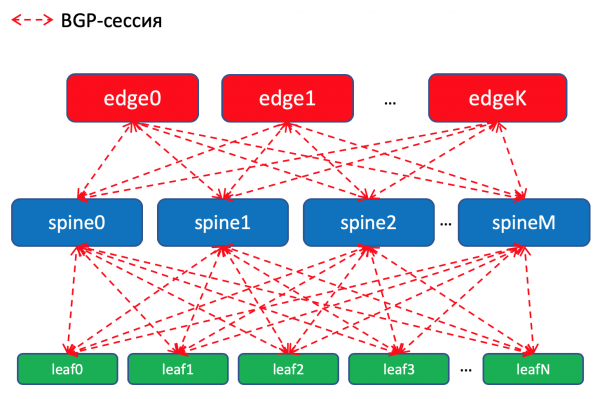
Diagrama de roteamento BGP dentro do DC
Por que BGP?
Há muito sobre isso do Facebook e da Arista que fala sobre como construir redes muito grandes de data centers utilizando BGP. Lê-se quase como uma obra de ficção, recomendo muito para uma noite relaxante.
E há também uma seção inteira no meu artigo dedicada a isso. Para onde estou .
Mas, mesmo assim, resumidamente, nenhum IGP é adequado para redes de grandes data centers, onde a contagem de dispositivos de rede vai para milhares.
Além disso, o uso de BGP em todo lugar permitirá não se dispersar no suporte a vários protocolos diferentes e a sincronização entre eles.
Colocando a mão no coração, na nossa fábrica, que provavelmente não irá crescer rapidamente, OSPF seria o suficiente. Isso é realmente um problema para megascale e titãs da nuvem. Mas vamos apenas imaginar por alguns episódios que precisamos disso e usaremos BGP, conforme desejou Pyotr Lapukhov.
Políticas de roteamento
Nos switches Leaf, importamos os prefixos do BGP a partir das interfaces Underlay das redes.
Teremos uma sessão BGP entre cada par de Leaf-Spine, na qual esses prefixos Underlay serão anunciados pela rede.
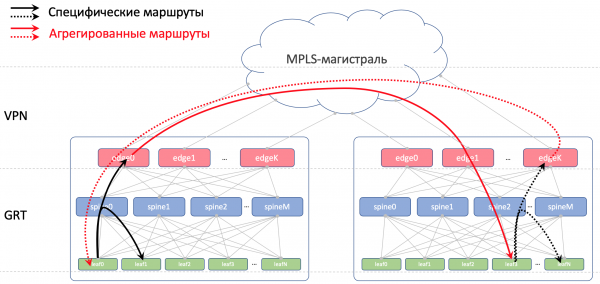
Dentro de um data center, distribuiremos as especificidades que importamos no ToR. Nos Edge-Leafs, vamos agregá-las e anunciá-las para data centers remotos, reduzindo até os ToRs. Ou seja, cada ToR saberá exatamente como chegar a outro ToR neste mesmo DC e onde está o ponto de entrada para chegar ao ToR em outro DC.
No DCI, as rotas serão transmitidas como VPNv4. Para isso, na interface Edge-Leaf em direção à fábrica, será colocado em VRF, chamaremos de UNDERLAY, e a vizinhança com Spine no Edge-Leaf será estabelecida dentro do VRF, enquanto entre os Edge-Leaves na família VPNv4.
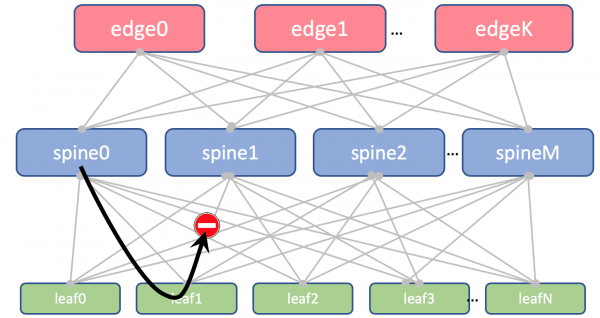
Além disso, vamos proibir o reanúncio de rotas recebidas dos spines, de volta para eles.
Nos Leaf e Spine, não importaremos Loopbacks. Precisaremos deles apenas para determinar o Router ID.
Mas nos Edge-Leafs, vamos importá-lo para o BGP Global. Entre os endereços Loopback, os Edge-Leafs estabelecerão sessões BGP na família IPv4 VPN entre si.
Entre os dispositivos EDGE teremos um backbone estendido sobre OSPF+LDP. Tudo em uma única zona. Configuração extremamente simples.
Essa é a visão geral da roteação.
BGP ASN
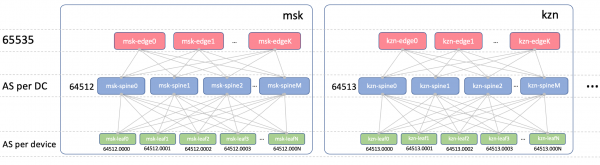
Edge-Leaf ASN
Nos Edge-Leafs, haverá um único ASN em todos os DCs. Isso é importante para que haja iBGP entre os Edge-Leafs, evitando complicações com eBGP. Que seja 65535. Na realidade, poderia ser o número de um AS público.
Spine ASN
Nos Spine, teremos um único ASN para cada DC. Vamos começar aqui com o primeiro número do intervalo de AS privados — 64512, 64513 e assim por diante.
Por que ASN em cada DC?
Vamos decompor essa questão em duas partes:
- Por que ASN idênticos em todos os spines de um DC?
- Por que diferentes em diferentes DCs?
Por que ASN idênticos em todos os spines de um DC
Assim será a aparência do AS-Path da rota Underlay no Edge-Leaf:
[leafX_ASN, spine_ASN, edge_ASN]
Ao tentar anunciá-la de volta ao Spine, ele irá descartá-la porque seu AS (Spine_AS) já está na lista.
No entanto, dentro do DC, estamos completamente satisfeitos que os roteiros Underlay, que chegam até o Edge, não consigam descer novamente. Toda a comunicação entre os hosts dentro do DC deve ocorrer no nível dos spines.
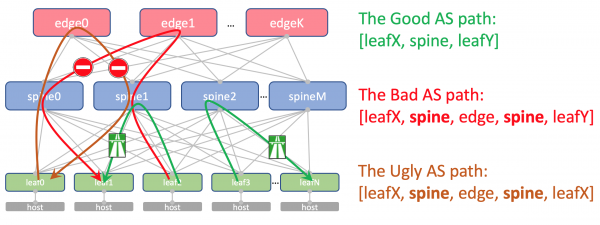
Por outro lado, os roteiros agregados de outros DCs, de qualquer forma, chegarão sem obstáculos aos ToRs — seu AS-Path terá apenas o ASN 65535 — o número AS dos Edge-Leaves, porque é exatamente neles que foram criados.
Por que diferentes em diferentes DCs
Teoricamente, pode ser necessário passar Loopbacks de algumas máquinas virtuais de serviço entre os DCs.
Por exemplo, um Route Reflector pode ser executado em um host ou (Virtual Network Gateway), que se conectará ao ToR via BGP e anunciará seu loopback, que deve estar acessível de todos os DCs.
Assim ficará seu AS-Path:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
E aqui não deve haver ASN repetidos.
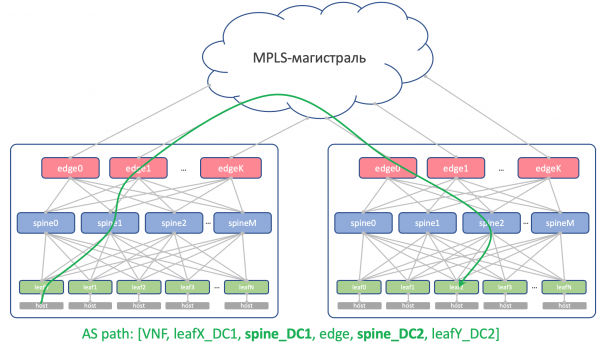
Ou seja, Spine_DC1 e Spine_DC2 devem ser diferentes, assim como leafX_DC1 e leafY_DC2, em que estamos chegando.
Como você deve saber, existem hacks que permitem aceitar rotas com ASN repetidos, apesar do mecanismo de prevenção de loops (allowas-in na Cisco). E isso tem até aplicações legítimas. Mas é uma vulnerabilidade potencial na estabilidade da rede. E eu pessoalmente caí nessa algumas vezes.
E se tivermos a oportunidade de não usar coisas perigosas, vamos aproveitá-la.
Leaf ASN
Teremos um ASN individual em cada switch Leaf em toda a rede.
Fazemos isso por razões mencionadas anteriormente: AS-Path sem loops, configuração de BGP sem backdoors.
Para que as rotas entre os Leafs passem sem obstáculos, o AS-Path deve ser assim:
[leafX_ASN, spine_ASN, leafY_ASN]
onde leafX_ASN e leafY_ASN devem ser diferentes.
Isso também é necessário para a situação com o anúncio do loopback VNF entre DCs:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Vamos usar um ASN de 4 bytes e gerá-lo com base no ASN do Spine e no número do switch Leaf, assim: Spine_ASN.0000X.
Esta é a situação com ASN.
Plano IP
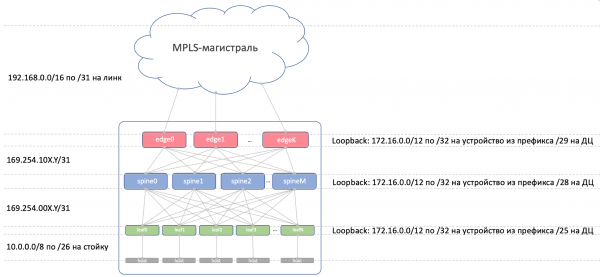
Basicamente, precisamos alocar endereços para as seguintes conexões:
- Endereços da rede Underlay entre o ToR e a máquina. Eles devem ser únicos em toda a rede para que qualquer máquina possa se conectar a qualquer outra. Idealmente, 10/8. Para cada rack, alocaremos um /26 com sobra. Vamos alocar um /19 por DC e /17 por região.
- Endereços de link entre Leaf/Tor e Spine.
Gostaríamos de atribuí-los de forma algorítmica, ou seja, calcular a partir dos nomes dos dispositivos que precisam ser conectados.
Que tal… 169.254.0.0/16.
Ou seja, 169.254.00X.Y/31, onde X — número do Spine, Y — rede P2P/31.
Isso permitirá operar até 128 racks e até 10 Spines no DC. Os endereços de link podem (e irão) se repetir de DC para DC. - A junção Spine — Edge-Leaf será organizada em sub-redes 169.254.10X.Y/31, onde igualmente X — número do Spine, Y — rede P2P/31.
- Os endereços de link do Edge-Leaf na rede MPLS. Aqui a situação é um pouco diferente — o ponto de conexão de todos os pedaços em um único bloco, portanto, não será possível reutilizar os mesmos endereços — precisamos escolher a próxima sub-rede livre. Portanto, tomaremos como base 192.168.0.0/16 e iremos extrair os endereços livres dela.
- Endereços Loopback. Vamos dedicar toda a faixa para eles 172.16.0.0/12.
- Leaf — por /25 no DC — os mesmos 128 racks. Vamos alocar /23 para a região.
- Spine — por /28 no DC — até 16 Spines. Vamos alocar /26 para a região.
- Edge-Leaf — por /29 no DC — até 8 dispositivos. Vamos alocar /27 para a região.
Se no DC não houver endereços disponíveis (e eles não irão — estamos almejando hiperescalabilidade), simplesmente alocamos o próximo bloco.
Este é o quadro da endereçamento IP.
Loopbacks:
Prefixo
Papel do dispositivo
Região
DC
172.16.0.0/23
“. A transição para o novo Unity 8 levará à descontinuação do suporte para áreas inteligentes (Scope) e à integração da nova interface de lançamento de aplicativos App Launcher. Futuramente, espera-se também a introdução do suporte completo ao ambiente para execução de aplicativos Android, baseado no trabalho do projeto
172.16.0.0/27
ru
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
ru
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
ru
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Prefixo
Região
DC
10.0.0.0/17
ru
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Laboratório
Dois fornecedores. Uma única rede. ADSM.
Juniper + Arista. Ubuntu. A velha boa Eva.
A quantidade de recursos na nossa maquininha no Mirana ainda é limitada, portanto, para fins práticos, usaremos uma rede simplificada ao máximo.
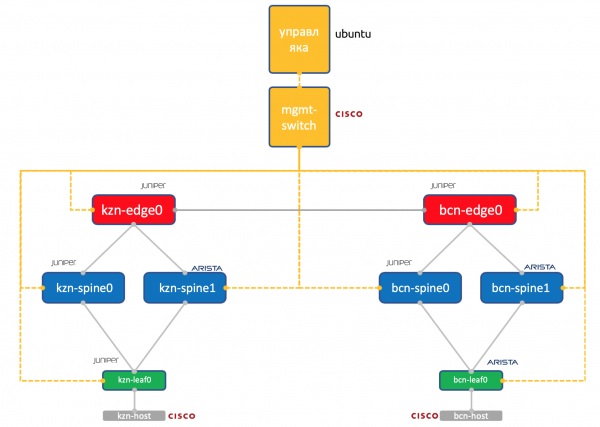
Dois data centers: Kazan e Barcelona.
- Dois spines em cada um: Juniper e Arista.
- Um tor (Leaf) em cada um — Juniper e Arista, com um host conectado (vamos usar o leve Cisco IOL para isso).
- Uma nó Edge-Leaf (até agora apenas Juniper).
- Um switch Cisco para governá-los todos.
- Além das caixas de rede, uma máquina virtual de controle foi iniciada. Sob gerenciamento do Ubuntu.
Ela tem acesso a todos os dispositivos, onde rodarão sistemas IPAM/DCIM, um conjunto de scripts Python, Ansible e qualquer outra coisa que possamos precisar.
de todos os dispositivos de rede, que estaremos tentando reproduzir com automação.
Conclusão
Está assim combinado? Fazer um resumo curto em cada artigo?
Assim, escolhemos Kloza dentro do DC, uma vez que esperamos muito tráfego East-West e queremos ECMP.
Dividimos a rede em física (underlay) e virtual (overlay). Sendo que o overlay começa no host — assim simplificamos os requisitos para o underlay.
Escolhemos o BGP como protocolo de roteamento para redes underlay devido à sua escalabilidade e flexibilidade nas políticas.
Teremos nós separados para a organização do DCI — Edge-leaf.
Na rede backbone, teremos OSPF+LDP.
O DCI será implementado com base em MPLS L3VPN.
Para links P2P, os endereços IP serão calculados de forma algorítmica com base nos nomes dos dispositivos.
Os loopbacks serão atribuídos com base na função dos dispositivos e sua localização sequencialmente.
Os prefixos underlay estarão apenas nos switches Leaf e serão atribuídos sequencialmente com base em sua localização.
Suponhamos que, neste momento, ainda não temos o equipamento instalado.
Portanto, nossos próximos passos serão registrar os equipamentos nos sistemas (IPAM, inventário), organizar o acesso, gerar a configuração e implantá-la.
No próximo artigo, vamos explorar o Netbox — um sistema de inventário e gerenciamento de espaço IP em DC.
Obrigado
- Agradecimentos a Andrei Glazkov aka @glazgoo pela revisão e ajustes.
- Agradecimentos a Alexander Klimenko aka @v00lk pela revisão e ajustes.
- Agradecimentos a Artyom Chernobay pela KDPV.
Fonte: habr.com
