

Olá a todos. Trabalho como administrador de sistemas sênior na OK e sou responsável pela operação estável do portal. Quero compartilhar como estabelecemos o processo de troca automática de discos e, em seguida, como removemos o administrador desse processo e o substituímos por um bot.
Este artigo é uma espécie de transliteração no HighLoad+ 2018
Estabelecimento do processo de troca de discos
Primeiro, alguns números
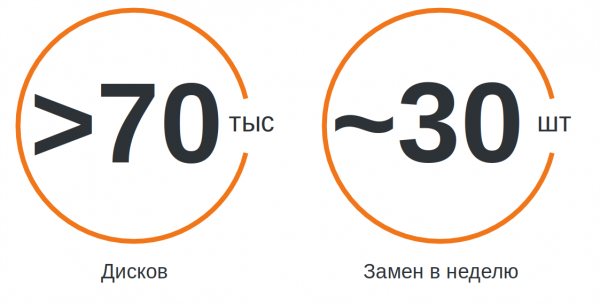
A OK é um gigante serviço utilizado por milhões de pessoas. Contamos com cerca de 7.000 servidores, localizados em 4 data centers diferentes. Esses servidores contêm mais de 70.000 discos. Se empilhássemos todos, obteríamos uma torre com mais de 1 km de altura.
Discos rígidos são o componente do servidor que mais falha. Com esse volume, precisamos trocar cerca de 30 discos por semana, e esse procedimento se tornou uma rotina bastante desagradável.
Incidentes
Em nossa empresa, implementamos uma gestão de incidentes completa. Registramos cada incidente no Jira, depois o resolvemos e analisamos. Se o incidente tiver efeito para os usuários, nos reunimos para pensar em como reagir mais rapidamente em tais casos, como reduzir o impacto e, claro, como prevenir recorrências.
Os drives não são exceção. Seu estado é monitorado pelo Zabbix. Monitoramos mensagens no Syslog em busca de erros de leitura/escrita, analisamos o estado de RAID HW/SW, e monitoramos o SMART, calculando o desgaste para SSDs.
Como os discos eram trocados antes
Quando um determinado gatilho acende no Zabbix, um incidente é criado no Jira e automaticamente designado para os engenheiros correspondentes nos data centers. Fazemos isso para todos os incidentes de hardware, ou seja, aqueles que exigem algum trabalho físico com o equipamento no data center.
O engenheiro do data center é a pessoa que resolve questões relacionadas ao hardware, responsável pela instalação, manutenção e desmontagem de servidores. Ao receber um ticket, o engenheiro inicia o trabalho. Nas estantes de discos, ele troca os discos por conta própria. Mas se não tiver acesso ao dispositivo necessário, o engenheiro solicita auxílio aos administradores de sistemas de plantão. Primeiro, é necessário retirar o disco da rotação. Para isso, são feitas as alterações necessárias no servidor, param-se os aplicativos e desmonta-se o disco.
O administrador de sistema de plantão durante o turno de trabalho é responsável pelo funcionamento de todo o portal. Ele investiga incidentes, realiza reparos e ajuda os desenvolvedores a executar pequenas tarefas. Ele não cuida apenas dos discos rígidos.
Anteriormente, os engenheiros do data center se comunicavam com o administrador de sistema pelo chat. Os engenheiros enviavam links para tickets do Jira, o administrador os revisava e mantinha um log de trabalho em algum caderno. Porém, para essas tarefas, os chats são inconvenientes: as informações não são estruturadas e se perdem rapidamente. Além disso, o administrador poderia se afastar do computador e demorar a responder às solicitações, enquanto o engenheiro aguardava ao lado do servidor com uma pilha de discos.
Mas o pior era que os administradores não conseguiam ver o panorama geral: quais eram os incidentes de disco existentes e onde poderiam surgir problemas potenciais. Isso ocorre porque transferimos todos os incidentes de hardware para os engenheiros. Sim, era possível exibir todos os incidentes no dashboard do administrador. Mas eram muitos, e o administrador era envolvido apenas em alguns deles.
Além disso, o engenheiro não conseguia definir corretamente as prioridades, pois não sabe a finalidade dos servidores específicos, nem como as informações estão distribuídas entre os dispositivos de armazenamento.
Novo procedimento de substituição
A primeira coisa que fizemos foi criar um novo tipo de incidente de disco, chamado 'HW-disco', e adicionamos campos para 'nome do dispositivo de bloco', 'tamanho' e 'tipo de disco', para que essas informações fossem salvas no ticket, evitando a necessidade de trocá-las constantemente pelo chat.
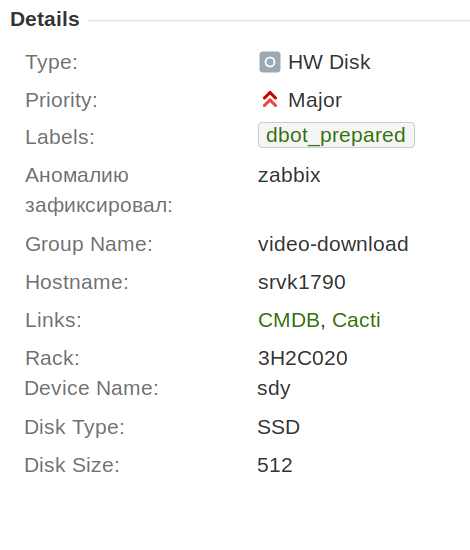
Além disso, concordamos que, dentro de um único incidente, mudaríamos apenas um disco. Isso simplificou significativamente o processo de automação, a coleta de estatísticas e o trabalho futuro.
Além disso, adicionamos um campo para 'administrador responsável'. Esse campo é automaticamente preenchido com o administrador de sistema de plantão. Isso é muito conveniente, pois agora o engenheiro sempre sabe quem é o responsável. Não é mais necessário consultar o calendário e procurar. Esse campo permitiu que os tickets que poderiam necessitar de sua ajuda fossem exibidos no dashboard do administrador.
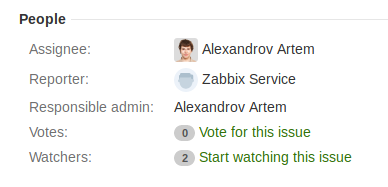
Para que todos os participantes se beneficiem ao máximo das inovações, criamos filtros e painéis e os apresentamos à equipe. Quando as pessoas compreendem as mudanças, não se distanciam delas como se fossem desnecessárias. É importante que o engenheiro saiba o número do rack onde o servidor está localizado, bem como o tamanho e tipo do disco. Para o administrador, é fundamental entender, em primeiro lugar, que grupo de servidores se trata e qual pode ser o efeito da substituição do disco.
A disponibilidade de campos e sua exibição é conveniente, mas isso não nos isentou da necessidade de usar chats. Para isso, tivemos que alterar o fluxo de trabalho.
Antes, ele era assim:
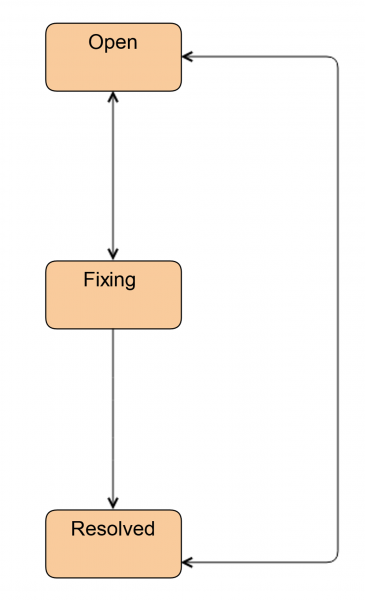
Hoje, os engenheiros continuam a trabalhar assim, quando não precisam da ajuda do administrador.
A primeira coisa que fizemos foi introduzir um novo status Investigate. Neste status, o ticket permanece enquanto o engenheiro ainda não decidiu se precisará do administrador ou não. Através deste status, o engenheiro pode transferir o ticket para o administrador. Além disso, usamos esse status para marcar tickets que requerem a substituição de um disco, mas o disco em si não está disponível no local. Isso pode ocorrer no caso de CDN e locais remotos.
Nós também adicionamos o status Pronto. O ticket é transferido para este status após a substituição do disco. Ou seja, tudo já foi feito, mas o RAID HW/SW no servidor ainda está sendo sincronizado. Isso pode levar bastante tempo.
Se um administrador é envolvido no trabalho, o esquema se torna um pouco mais complicado.
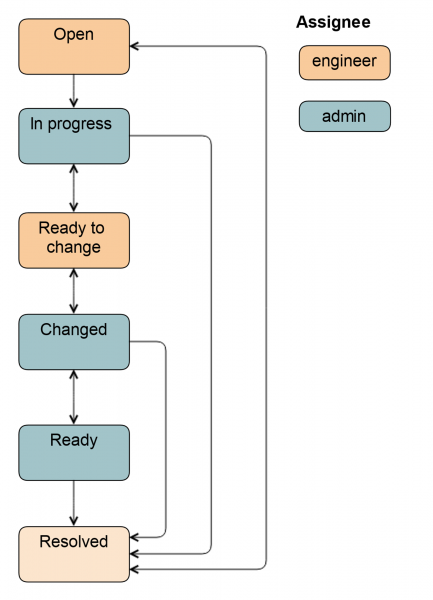
A partir do status Abrir , o ticket pode ser transferido tanto pelo administrador do sistema quanto pelo engenheiro. No status In progress , o administrador remove o disco da rotação, para que o engenheiro possa simplesmente removê-lo: ativa a iluminação, desmonta o disco, para aplicações, dependendo do grupo específico de servidores.
Em seguida, o ticket é transferido para Ready to change: isso sinaliza ao engenheiro que o disco pode ser removido. Todos os campos no Jira já estão preenchidos, e o engenheiro sabe qual é o tipo e o tamanho do disco. Essas informações são preenchidas automaticamente no status anterior ou pelo administrador.
Após a substituição do disco, o ticket é transferido para o status Changed. Verifica-se se o disco correto foi instalado, realiza-se a configuração, o aplicativo é iniciado e algumas tarefas de recuperação de dados são executadas. Além disso, o ticket pode ser transferido para o status Pronto, nesse caso, o responsável continuará sendo o administrador, pois ele introduziu o disco na rotação. O esquema completo é o seguinte.
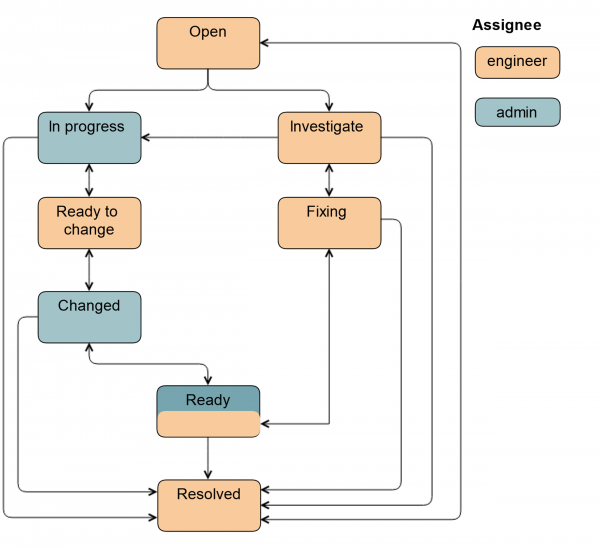
A adição de novos campos facilitou bastante a nossa vida. A equipe começou a trabalhar com informações estruturadas, ficou claro o que e em que etapa era necessário fazer. As prioridades tornaram-se muito mais relevantes, pois agora são definidas pelo administrador.
A necessidade de chats desapareceu. Claro, o administrador pode enviar uma mensagem para o engenheiro dizendo 'é necessário substituir isso mais rapidamente' ou 'já é noite, você consegue substituir?'. Mas já não conversamos diariamente nos chats sobre essas questões.
Os discos começaram a ser trocados em lotes. Se o administrador chega ao trabalho um pouco mais cedo e tem algum tempo livre, e nada ocorreu até então, ele pode preparar uma série de servidores para substituição: marcar os campos, remover os discos da rotação e passar a tarefa para o engenheiro. O engenheiro chega um pouco mais tarde ao data center, vê a tarefa, pega os dispositivos necessários do estoque e realiza a troca imediatamente. Como resultado, a velocidade de substituição aumentou.
Experiência adquirida na construção de Workflow
- Ao construir o procedimento, é necessário coletar informações de diferentes fontes.
Alguns dos nossos administradores não sabiam que o engenheiro trocava os discos sozinho. Alguns achavam que a sincronização do MD RAID era acompanhada pelos engenheiros, embora alguns deles nem tivessem acesso para isso. Alguns engenheiros seniores faziam isso, mas nem sempre, porque o processo não estava documentado em lugar algum. - O procedimento deve ser simples e claro.
É difícil para uma pessoa manter muitos passos na cabeça. Os status mais importantes e vizinhos no Jira devem ser destacados na tela principal. Podemos renomeá-los, por exemplo, chamamos 'In progress' de 'Pronto para mudar'. E os outros status podem ser escondidos em um menu suspenso, para que não fiquem chamando atenção. Mas é melhor não limitar as pessoas, dar a oportunidade de fazer a transição.
Explique o valor das inovações. Quando as pessoas entendem, elas aceitam melhor o novo procedimento. Para nós, era muito importante que as pessoas não apenas clicassem em todo o processo, mas seguissem por ele. Depois, construímos a automação com base nisso. - Aguarde, analise, compreenda.
Levamos cerca de um mês para estabelecer o procedimento, a implementação técnica, reuniões e discussões. E a implementação levou mais de três meses. Vi como as pessoas começaram a usar a nova funcionalidade aos poucos. Nos primeiros estágios, houve muito negativismo. Mas isso não dependia do procedimento em si, nem da sua implementação técnica. Por exemplo, um administrador usava não o Jira, mas o plugin Jira no Confluence, e algumas coisas não estavam disponíveis para ele. Mostramos o Jira para ele, e a produtividade do administrador aumentou tanto nas tarefas gerais quanto nas substituições de discos.
Automação da substituição de discos
Tentamos várias vezes automatizar a substituição de discos. Já tínhamos desenvolvido alguns scripts, mas todos funcionavam de forma interativa ou manual, exigindo execução. E só depois da implementação do novo procedimento percebemos que era exatamente isso que nos faltava.
Como agora o processo de substituição está dividido em etapas, cada uma com um responsável e uma lista de ações, podemos implementar a automação gradualmente, e não tudo de uma vez. Por exemplo, a etapa mais simples — Ready (verificação de sincronização RAID/dados) — pode ser facilmente delegada a um bot. Quando o bot se familiarizar um pouco, podemos lhe dar uma tarefa mais importante — inserir discos na rotação, entre outras.
Zoológico de configurações
Antes de falarmos sobre o bot, faremos uma breve excursão pelo nosso zoológico de instalações. Em primeiro lugar, isso se deve ao enorme tamanho da nossa infraestrutura. Em segundo lugar, tentamos adaptar a configuração de hardware ideal para cada serviço. Temos cerca de 20 modelos de RAID de hardware, principalmente LSI e Adaptec, mas também encontramos HP e DELL de várias versões. Cada controlador RAID tem sua própria utilidade de gerenciamento. O conjunto de comandos e as saídas podem variar de versão para versão em cada controlador RAID. Onde não se usa HW-RAID, pode haver mdraid.
Praticamente todas as novas instalações que fazemos são sem redundância de disco. Tentamos não usar mais RAID de hardware e software, pois fazemos a redundância dos nossos sistemas a nível de data centers e não de servidores. Mas, claro, há muitos servidores legados que precisam ser mantidos.
Em algum lugar, os discos em controladores RAID geram dispositivos raw, enquanto em outros, são usados JBOD. Existem configurações com um disco do sistema no servidor e, se ele precisar ser substituído, é necessário reinstalar o servidor com o sistema operacional e aplicativos, inclusive as mesmas versões, depois adicionar arquivos de configuração e executar os aplicativos. Também há muitos grupos de servidores onde a redundância é feita não no nível da subsistema de disco, mas diretamente nos próprios aplicativos.
No total, temos mais de 400 grupos únicos de servidores, onde cerca de 100 aplicativos diferentes estão em funcionamento. Para cobrir essa enorme variedade de opções, precisávamos de uma ferramenta de automação multifuncional. Preferencialmente com um DSL simples, para que pudesse ser mantido não apenas por quem o escreveu.
Escolhemos o Ansible porque é agentless: não era necessário preparar a infraestrutura, e a configuração inicial é rápida. Além disso, ele é escrito em Python, que é considerado padrão pela equipe.
Esquema geral
Vamos analisar o esquema geral de automação usando um exemplo de um incidente. O Zabbix detecta que o disco sdb falhou, um trigger é acionado e um ticket é criado no Jira. O administrador verifica, percebe que não é um duplicado nem um falso positivo, ou seja, o disco precisa ser trocado, e move o ticket para In progress.
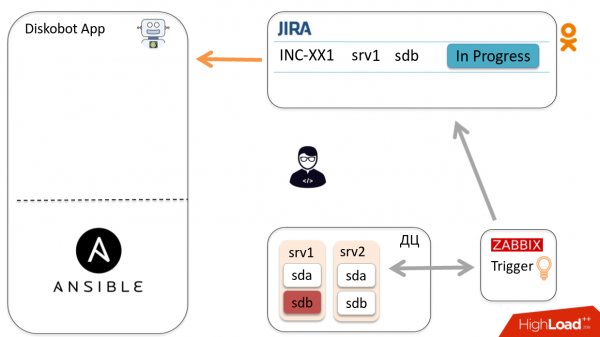
O aplicativo DiskoBot, escrito em Python, consulta periodicamente o Jira em busca de novos tickets. Ele nota que um novo ticket In progress foi criado, um thread correspondente é acionado, que executa o playbook no Ansible (isso é feito para cada status no Jira). Neste caso, o Prepare2change é acionado.
O Ansible é enviado para o host, retira o disco da rotação e reporta o status ao aplicativo através de Callbacks.
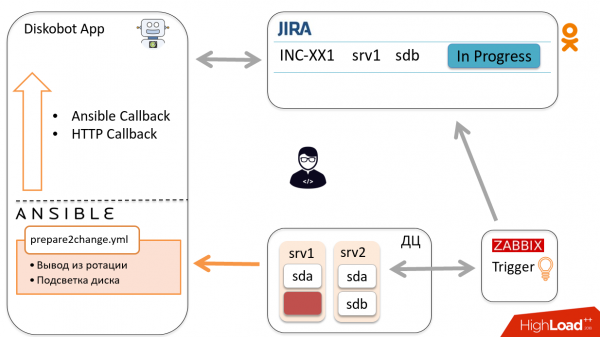
Como resultado, o bot automaticamente muda o ticket para Ready to change. O engenheiro recebe uma notificação e vai substituir o disco, após o que muda o ticket para Changed.
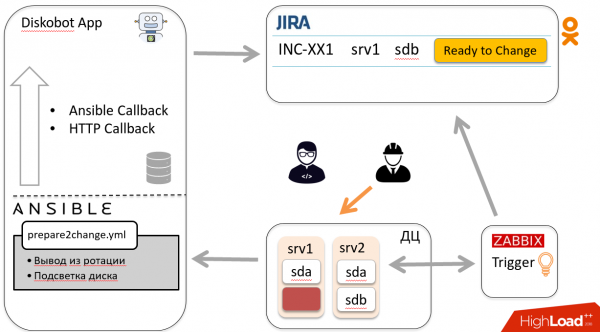
De acordo com o esquema descrito, o ticket volta para o bot, que aciona outro playbook, vai até o host e reintegra o disco na rotação. O bot fecha o ticket. Ura!
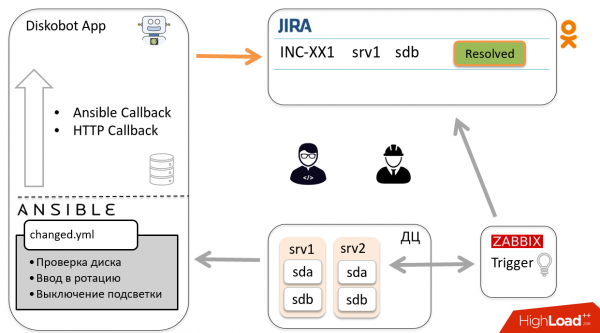
Agora vamos conversar sobre alguns componentes do sistema.
Diskobot
Este aplicativo é escrito em Python. Ele seleciona tickets do Jira com base em JQL. Dependendo do status do ticket, este é direcionado ao correspondente handler, que, por sua vez, aciona o playbook do Ansible correspondente ao status.
JQL e os intervalos de pesquisa são definidos no arquivo de configuração do aplicativo.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Por exemplo, entre os tickets no status Em progresso, são selecionados apenas aqueles nos quais os campos Disk size e Device name estão preenchidos. Device name é o nome do dispositivo de bloco necessário para a execução do playbook. Disk size é necessário para que o engenheiro saiba qual o tamanho do disco requerido.
Já entre os tickets com status Pronto, são filtrados os tickets com o rótulo dbot_ignore. Por falar nisso, usamos rótulos do Jira tanto para esse tipo de filtragem quanto para marcar duplicatas de tickets e coletar estatísticas.
Em caso de falha do playbook, o Jira atribui o rótulo dbot_failed, para que se possa investigar posteriormente.
Interação com o Ansible
O aplicativo interage com o Ansible através do . No playbook_executor, passamos o nome do arquivo e um conjunto de variáveis. Isso permite manter o projeto Ansible na forma de arquivos yml normais, em vez de descrevê-lo em código Python.
Além disso, no Ansible, através de *extra_vars*, são passados o nome do dispositivo de bloco, o status do ticket e também o callback_url, no qual está embutido o issue key — usado para callback em HTTP.
Para cada execução, gera-se um inventário temporário, composto por um único host e um grupo do qual esse host faz parte, para que se apliquem os group_vars.
Aqui está um exemplo de tarefa, na qual é implementado o callback HTTP.
Recebemos o resultado da execução dos playbooks através de callback(-s). Eles são de dois tipos:
- , que fornece dados sobre os resultados da execução do playbook. Nele estão descritas as tarefas que foram iniciadas, executadas com sucesso ou não. Esse callback é chamado ao final da execução do playbook.
- HTTP callback para obter informações durante a execução do playbook. Na tarefa do Ansible, realizamos uma solicitação POST/GET em direção ao nosso aplicativo.
Através dos HTTP callback(-s) são passadas as variáveis que foram definidas durante a execução do playbook e que desejamos armazenar e usar em execuções posteriores. Esses dados são gravados em sqlite.
Além disso, através do HTTP callback, deixamos comentários e modificamos o status do ticket.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Como muitas tarefas similares, nós a transferimos para um arquivo comum e incluímos quando necessário, para não repetir constantemente nos playbooks. Aqui figura o callback_url, onde estão embutidos o issue key e o host name. Quando o Ansible executa essa requisição POST, o bot entende que ela foi enviada dentro de determinado incidente.
Aqui está um exemplo de um playbook, no qual desmontamos um disco de um dispositivo MD:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Essa tarefa transforma o ticket do Jira no status "Pronto para alteração" e adiciona um comentário. Além disso, na variável mdam_data é mantida uma lista de dispositivos MD dos quais o disco foi removido, e em parted_info — um dump da partição do parted.
Quando o engenheiro inserir um novo disco, poderemos usar essas variáveis para restaurar o dump das partições, além de adicionar o disco nos dispositivos MD de onde ele foi removido.
Modo de verificação do Ansible
Ativar a automação foi assustador. Portanto, decidimos executar todos os playbooks no modo
, no qual o Ansible não executa nenhuma ação nos servidores, apenas as emula.
Esse tipo de execução passa por um módulo de callback separado, e o resultado da execução do playbook é salvo no Jira como um comentário.
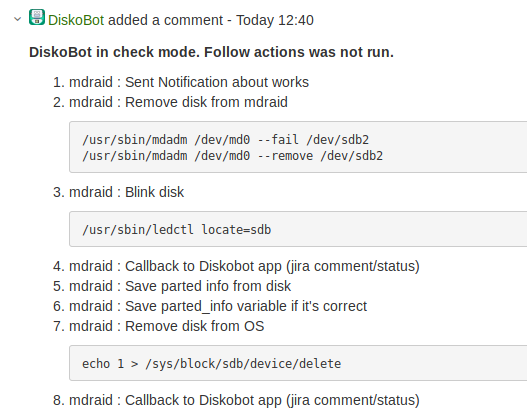
Em primeiro lugar, isso permitiu validar o funcionamento do bot e dos playbooks. Em segundo lugar, aumentou a confiança dos administradores no bot.
Quando conseguimos a validação e entendemos que poderíamos executar o Ansible não apenas no modo dry run, fizemos um botão Run Diskobot no Jira para executar o mesmo playbook com as mesmas variáveis no mesmo host, mas no modo normal.
Além disso, o botão é usado para reiniciar o playbook em caso de falha.
Estrutura dos Playbooks
Já mencionei que, dependendo do status do ticket do Jira, o bot executa diferentes playbooks.
Em primeiro lugar, isso torna a organização de entrada muito mais simples.
Em segundo lugar, em alguns casos isso é simplesmente necessário.
Por exemplo, ao substituir o disco do sistema, é necessário primeiro ir ao sistema de implantação, criar uma tarefa e, após a implantação correta, o servidor se tornará acessível via ssh, e podemos instalar o aplicativo nele. Se fizéssemos tudo isso em um único playbook, o Ansible não conseguiria executá-lo devido à indisponibilidade do host.
Usamos funções do Ansible para cada grupo de servidores. Aqui podemos ver como os playbooks estão organizados em um deles.
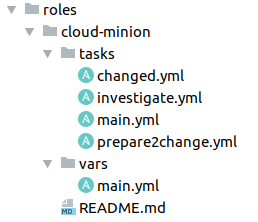
É conveniente, pois é imediatamente claro onde estão localizadas as tarefas. No arquivo main.yml, que é a entrada para o papel Ansible, podemos ter apenas uma inclusão pelo status do ticket ou tarefas gerais necessárias para todos, como passar por uma identificação ou obter um token.
Investigation.yml
Executado para tickets nos status Investigation e Open. O mais importante para este playbook é o nome do dispositivo de bloco. Esta informação nem sempre está disponível.
Para obtê-la, analisamos o resumo do Jira, o último valor do trigger do Zabbix. Pode conter o nome do dispositivo de bloco — aí temos sorte. Pode conter o ponto de montagem, — então precisamos ir ao servidor, fazer um parsing e calcular o disco necessário. O trigger também pode transmitir um endereço SCSI ou alguma outra informação. Mas pode acontecer que não haja nenhuma pista, e temos que analisar.
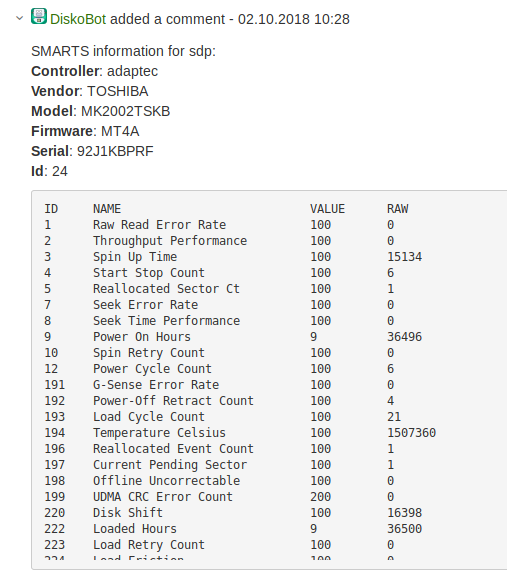
Depois de descobrir o nome do dispositivo de bloco, coletamos informações sobre o tipo e o tamanho do disco para preencher os campos no Jira. Também coletamos dados sobre o fornecedor, modelo, firmware, ID, SMART, e tudo isso é inserido no comentário no ticket do Jira. Agora o administrador e o engenheiro não precisam procurar esses dados. 🙂
prepare2change.yml
Retirando o disco da rotação, preparação para substituição. A etapa mais complicada e crítica. É aqui que podemos parar um aplicativo quando não deve ser parado. Ou retirar um disco que não tinha as réplicas, afetando assim os usuários e perdendo alguns dados. Aqui temos mais verificações e notificações no chat.
No caso mais simples, trata-se da remoção do disco do HW/MD RAID.
Em situações mais complexas (nos nossos sistemas de armazenamento), quando a redundância é realizada no nível do aplicativo, é necessário acessar o aplicativo via API, informar sobre a remoção do disco, desativá-lo e iniciar a recuperação.
Atualmente estamos migrando em massa para , e se o servidor é em nuvem, o Diskobot se comunica com a API da nuvem, informa que está prestes a trabalhar com este minúsculo — servidor onde os contêineres estão rodando — e pede "migre todos os contêineres deste minúsculo". E ao mesmo tempo ativa a iluminação do disco, para que o engenheiro veja imediatamente qual deve ser retirado.
changed.yml
Após a substituição do disco, primeiro verificamos sua disponibilidade.
Os engenheiros nem sempre instalam novos discos, por isso adicionamos uma verificação dos valores SMART que nos satisfazem.
Quais atributos estamos observandoContagem de Setores Re alocados (5) < 100
Contagem de Setores Pendentes Atuais (107) == 0
Se o disco não passar na verificação, o engenheiro é informado sobre a necessidade de troca. Se tudo estiver em ordem, a iluminação se apaga, a marcação é feita e o disco é colocado em rotação.
ready.yml
O caso mais simples: verificação da sincronização de RAID HW/SW ou o término da sincronização de dados no aplicativo.
API de aplicativos
Mencionei várias vezes que frequentemente um bot acessa a API de aplicativos. Claro, nem todos os aplicativos tinham os métodos necessários, então foi preciso desenvolvê-los. Aqui estão os métodos mais importantes que utilizamos:
- Status. Status do cluster ou disco, para entender se é possível trabalhá-lo;
- Iniciar/parar. Ativação-desativação do disco;
- Migrar/restaurar. Migração e recuperação de dados durante e após a substituição.
Experiência adquirida com Ansible
Eu realmente gosto do Ansible. Mas frequentemente, ao olhar para diferentes projetos de código aberto e ver como as pessoas escrevem playbooks, fico um pouco assustado. Interligações lógicas complexas de when/loop, falta de flexibilidade e idempotência devido ao uso frequente de shell/comando.
Decidimos simplificar ao máximo, aproveitando a modularidade do Ansible. No nível mais alto estão os playbooks, que podem ser escritos por qualquer administrador ou desenvolvedor externo que saiba um pouco sobre Ansible.
- name: Piscar disco
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Se alguma lógica for difícil de implementar em playbooks, a extraímos em um módulo ou filtro do Ansible. Os scripts podem ser escritos em Python ou em qualquer outro idioma.
Eles são fáceis e rápidos de escrever. Por exemplo, o módulo de iluminação do disco, cujo exemplo de uso foi dado acima, consiste em 265 linhas.
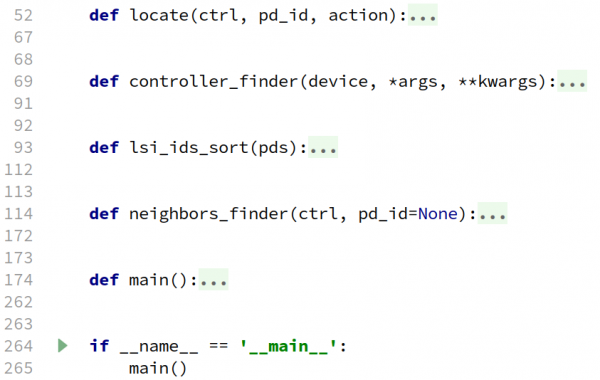
No nível mais baixo está a biblioteca. Para este projeto, escrevemos um aplicativo separado, uma espécie de abstração sobre RAID de hardware e software, que executa as solicitações correspondentes.
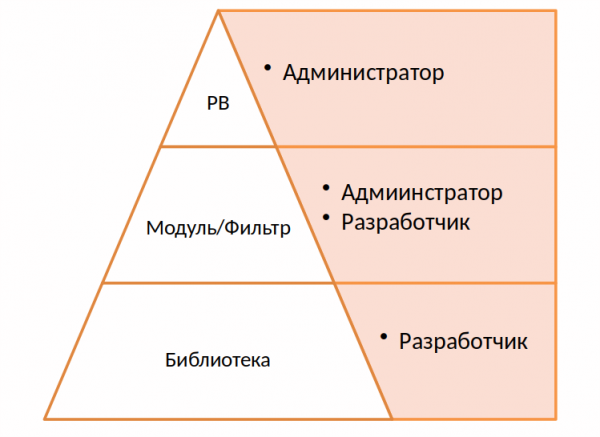
Os pontos fortes do Ansible são a simplicidade e os playbooks compreensíveis. Acredito que devemos aproveitar isso e não gerar arquivos yaml assustadores e uma enorme quantidade de condições, código em shell e loops.
Se você quiser repetir nossa experiência com a API do Ansible, tenha em mente duas coisas:
- Com o Playbook_executor, não é possível definir um timeout para o playbook. Existe um timeout para sessões SSH, mas não há timeout para o playbook. Se tentarmos desmontar um disco que não existe mais no sistema, o playbook será executado indefinidamente, por isso foi necessário envolvê-lo em um wrapper separado e finalizá-lo pelo timeout.
- O Ansible funciona com base em processos fork, portanto sua API não é thread-safe. Executamos todos os nossos playbooks de forma single-thread.
Como resultado, conseguimos automatizar a substituição de cerca de 80% dos discos. No geral, a velocidade de substituição dobrou. Hoje, o administrador apenas observa o incidente e decide se é necessário trocar o disco ou não, e então faz um único clique.
Mas agora começamos a enfrentar outro problema: alguns dos novos administradores não sabem como trocar os discos. 🙂
Fonte: habr.com
