

Este artigo ajudará a entender como funciona o balanceamento de carga no Kubernetes, o que acontece ao escalar conexões persistentes e por que é importante considerar o balanceamento do lado do cliente se você estiver usando HTTP/2, gRPC, RSockets, AMQP ou outros protocolos de longa duração.
Um pouco sobre como o tráfego é redistribuído no Kubernetes
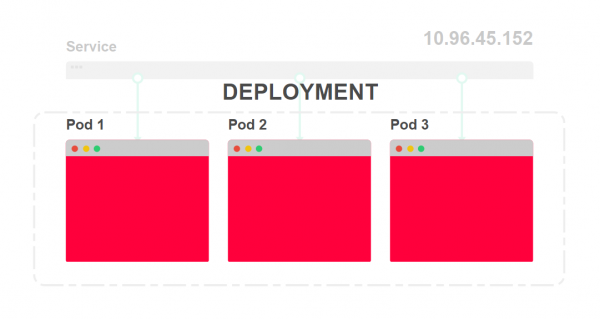
O Kubernetes fornece duas abstrações convenientes para a implantação de aplicações: serviços (Services) e implantações (Deployments).
As implantações descrevem como e quantas cópias de sua aplicação devem estar em execução a qualquer momento. Cada aplicação é implantada como um pod (Pod) e recebe um endereço IP.
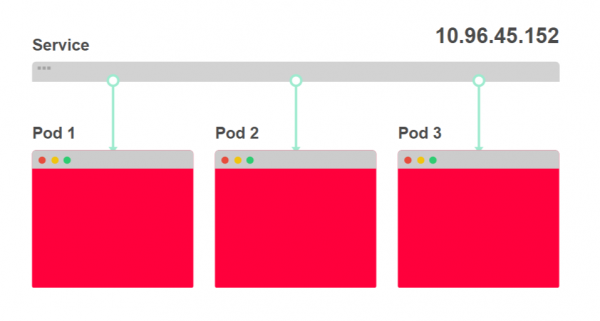
Os serviços funcionam de forma semelhante a um balanceador de carga. Eles são destinados a distribuir o tráfego entre múltiplos pods.
Vamos ver como isso se parece.
- No diagrama abaixo, você vê três instâncias de uma aplicação e um balanceador de carga:

- O balanceador de carga é chamado de serviço (Service) e recebe um endereço IP. Qualquer solicitação de entrada é redirecionada para um dos pods:

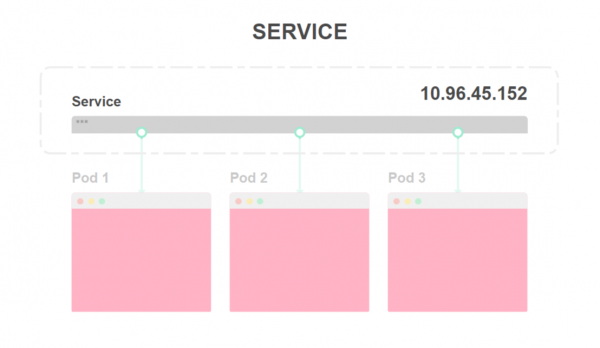
- O cenário de implantação define quantas instâncias da aplicação devem existir. Você praticamente nunca precisará implantar diretamente um pod:

- Cada pod recebe seu próprio endereço IP:

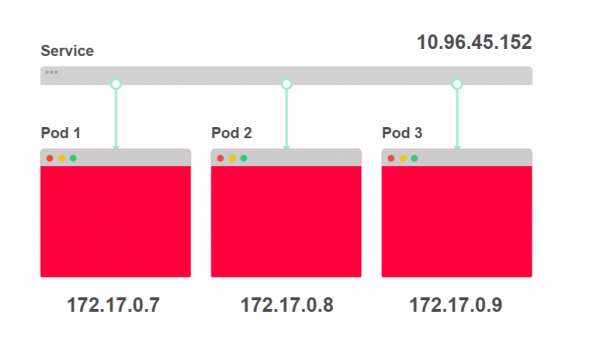
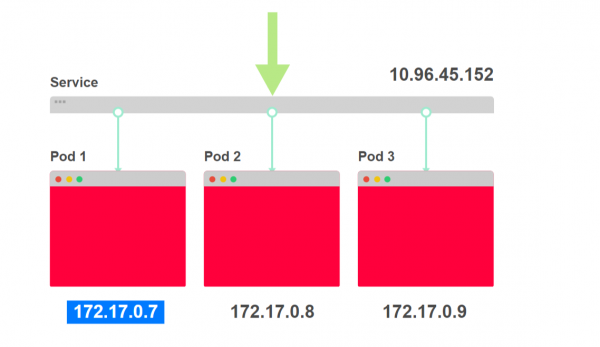
É útil considerar os serviços como um conjunto de endereços IP. Sempre que você acessa um serviço, um dos endereços IP é escolhido da lista e usado como endereço de destino.
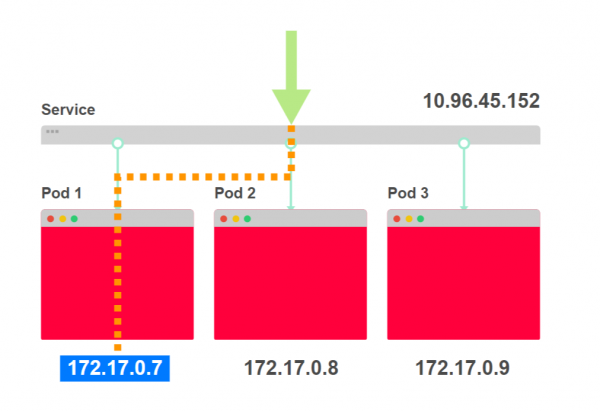
A aparência disso é a seguinte.
- Uma solicitação curl 10.96.45.152 ao serviço chega:

- O serviço escolhe um dos três endereços dos pods como ponto de destino:

- O tráfego é redirecionado para um pod específico:


Se sua aplicação consiste em um frontend e um backend, você terá tanto um serviço quanto uma implantação para cada um.
Quando o frontend faz uma solicitação ao backend, ele não precisa saber quantos pods estão atendendo o backend: pode haver um, dez ou cem.
Além disso, o frontend não sabe os endereços dos pods que atendem o backend.
Quando o frontend faz uma solicitação ao backend, ele usa o endereço IP do serviço do backend, que não muda.
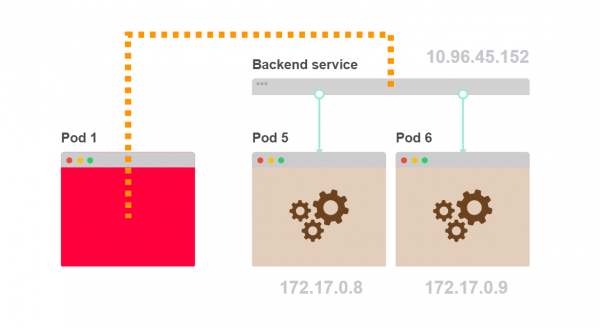
Veja como isso se parece.
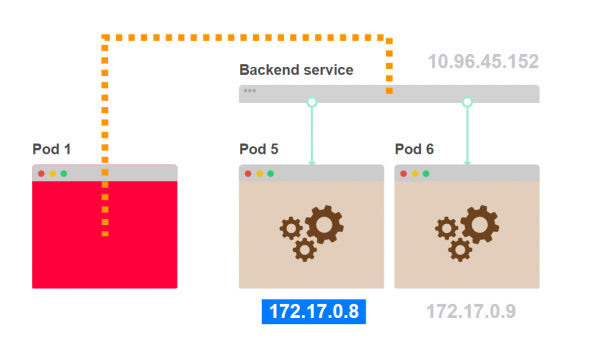
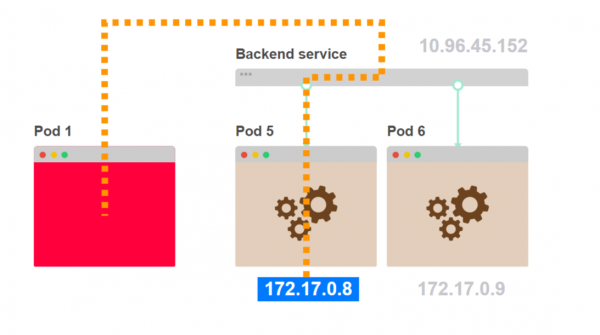
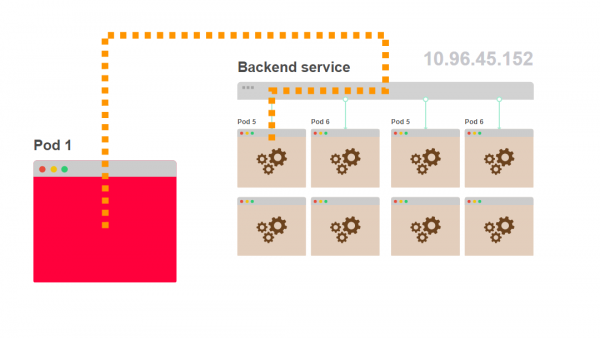
- O Pod 1 solicita um componente interno do backend. Em vez de escolher um pod específico do backend, ele faz a solicitação ao serviço:

- O serviço escolhe um dos pods de backend como endereço de destino:

- O tráfego vai do pod 1 para o pod 5, selecionado pelo serviço:

- O pod 1 não sabe quantos pods como o pod 5 estão escondidos atrás do serviço:

Mas como exatamente o serviço distribui as solicitações? Parece que está sendo usada a balanceamento round-robin? Vamos descobrir.
Balanceamento em serviços Kubernetes
Serviços Kubernetes não existem. Para o serviço, não há um processo ao qual um endereço IP e porta são atribuídos.
Você pode verificar isso acessando qualquer nó do cluster e executando o comando netstat -ntlp.
Você nem mesmo conseguirá encontrar o endereço IP atribuído ao serviço.
O endereço IP do serviço está localizado na camada de controle, no controlador, e está registrado no banco de dados — etcd. Esse mesmo endereço é usado por outro componente — kube-proxy.
O kube-proxy recebe a lista de endereços IP para todos os serviços e forma um conjunto de regras iptables em cada nó do cluster.
Essas regras dizem: "Se virmos o endereço IP do serviço, devemos modificar o endereço de destino da solicitação e enviá-la para um dos pods."
O endereço IP do serviço é usado apenas como ponto de entrada e não é gerenciado por nenhum processo que ouça esse endereço IP e porta.
Vamos dar uma olhada nisso.
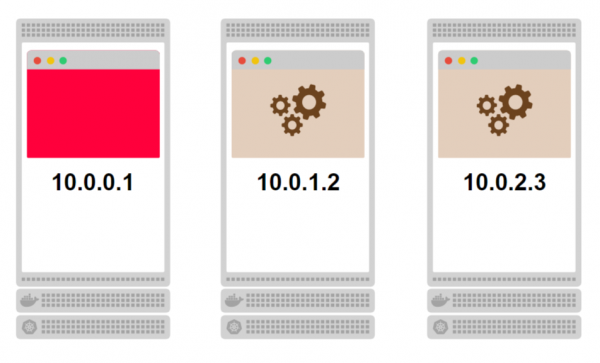
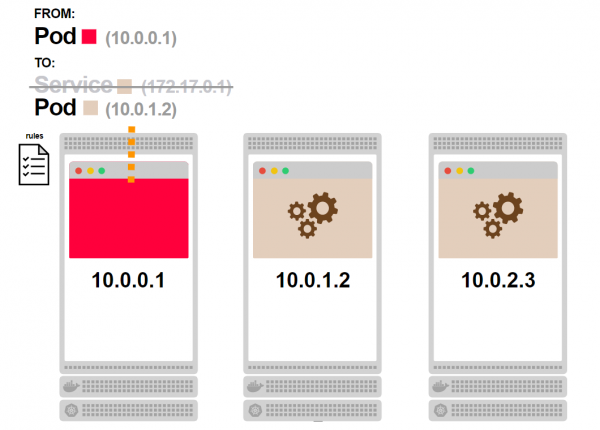
- Consideremos um cluster com três nós. Em cada nó, há pods:

- Os pods relacionados, coloridos em bege, fazem parte do serviço. Como o serviço não existe como um processo, ele é representado em cinza:

- O primeiro pod solicita o serviço e deve acessar um dos pods relacionados:

- Mas o serviço não existe, não há processo. Como isso funciona?

- Antes que a solicitação saia do nó, ela passa pelas regras iptables:

- As regras iptables reconhecem que o serviço não existe e substituem seu endereço IP por um dos endereços IP dos pods associados a esse serviço:

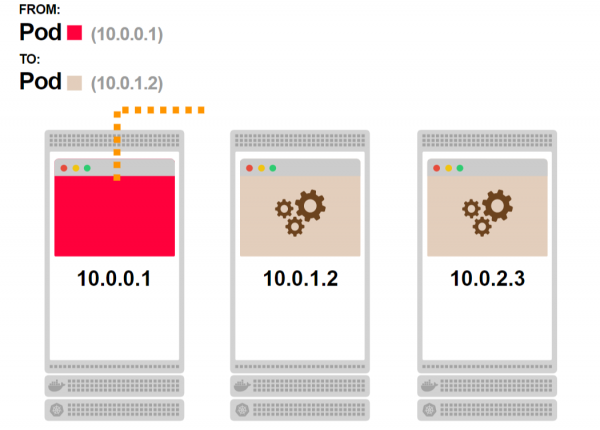
- A solicitação recebe um endereço IP válido como endereço de destino e é processada normalmente:
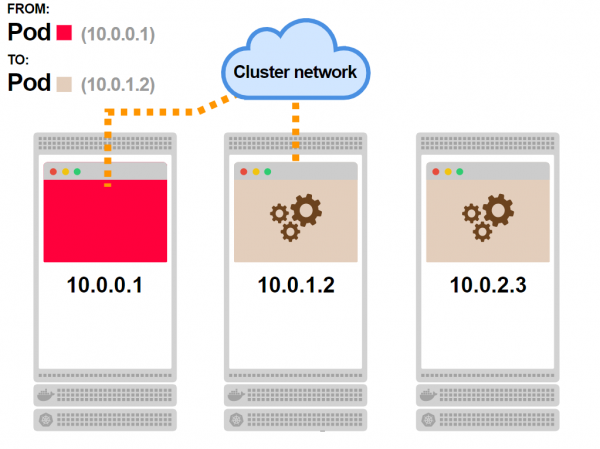
- Dependendo da topologia da rede, a solicitação, em última análise, chega ao pod:

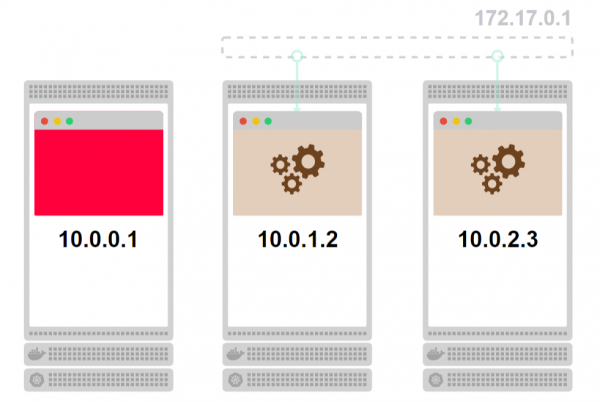
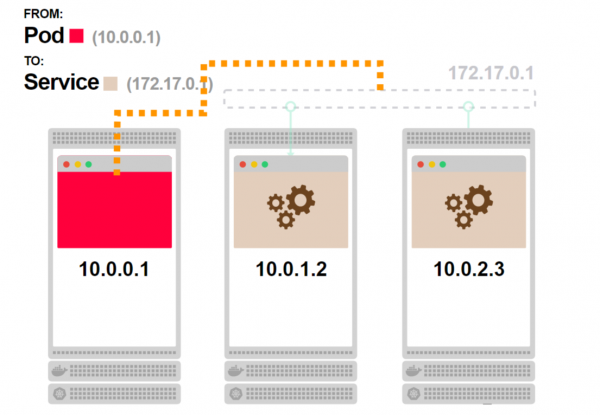
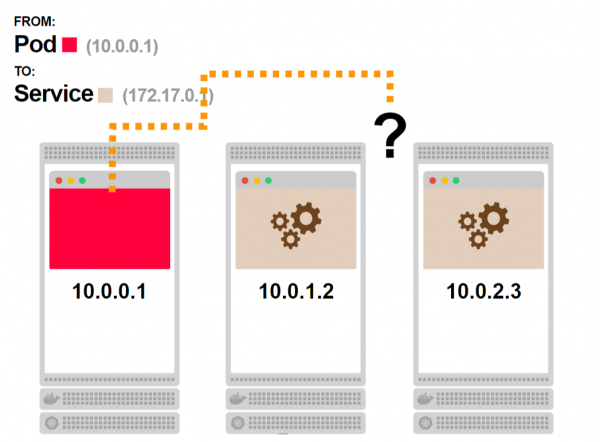
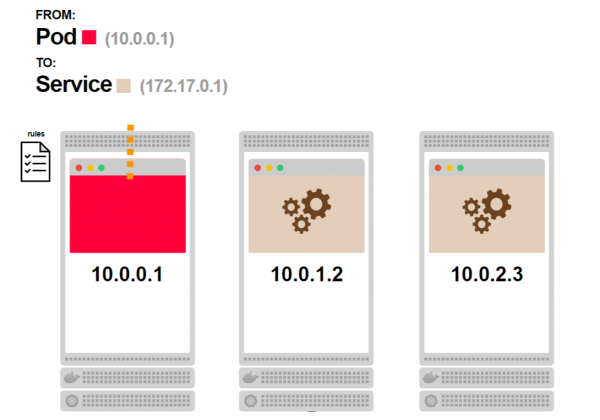
Os iptables conseguem balancear a carga?
Não, os iptables são usados para filtragem e não foram projetados para balanceamento.
No entanto, existe a possibilidade de escrever um conjunto de regras que funcione como .
E é exatamente isso que está implementado no Kubernetes.
Se você tem três pods, o kube-proxy escreverá as seguintes regras:
- Escolha o primeiro pod com probabilidade de 33%, caso contrário, passe para a próxima regra.
- Escolha o segundo pod com 50% de probabilidade, caso contrário, passe para a próxima regra.
- Escolha o terceiro pod.
Esse sistema faz com que cada pod seja escolhido com 33% de probabilidade.
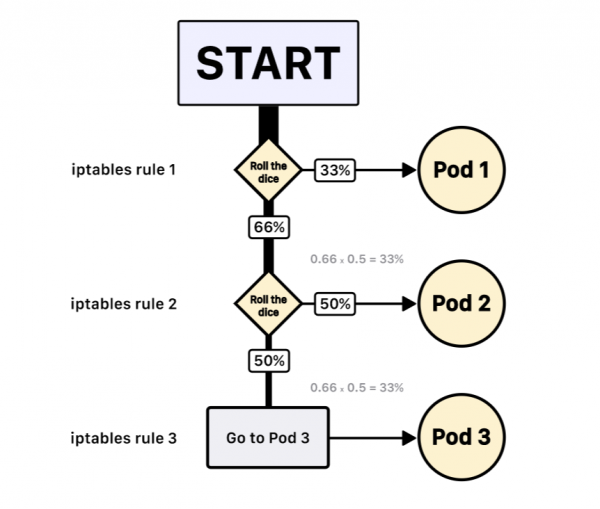
E não há garantia de que o pod 2 será escolhido em seguida após o pod 1.
Nota: iptables utiliza um módulo estatístico com distribuição aleatória. Assim, o algoritmo de balanceamento é baseado na seleção aleatória.
Agora que você entende como os serviços funcionam, vamos explorar cenários de operação mais interessantes.
Conexões de longa duração no Kubernetes não são escaláveis por padrão.
Cada requisição HTTP do frontend para o backend é atendida por uma conexão TCP separada, que é aberta e fechada.
Se o frontend envia 100 requisições por segundo para o backend, então 100 conexões TCP diferentes são abertas e fechadas.
É possível reduzir o tempo de processamento da requisição e a carga, abrindo uma única conexão TCP e utilizando-a para todas as requisições HTTP subsequentes.
O protocolo HTTP contém uma funcionalidade chamada keep-alive, ou reutilização de conexão. Nesse caso, uma única conexão TCP é usada para enviar e receber múltiplas requisições e respostas HTTP:
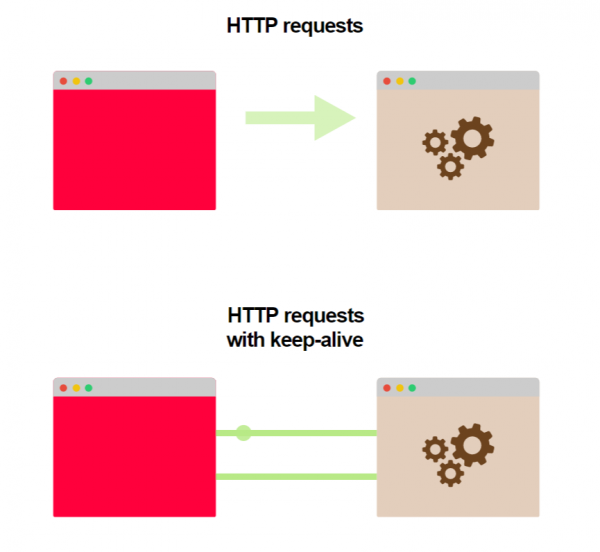
Essa funcionalidade não está habilitada por padrão: tanto o servidor quanto o cliente devem ser configurados adequadamente.
A configuração em si é simples e acessível para a maioria das linguagens de programação e ambientes.
Aqui estão alguns links para exemplos em diferentes linguagens:
O que acontece se usarmos keep-alive em um serviço Kubernetes?
Vamos supor que tanto o frontend quanto o backend suportem keep-alive.
Temos uma cópia do frontend e três instâncias do backend. O frontend faz a primeira requisição e abre uma conexão TCP para o backend. A requisição chega ao serviço, um dos pods do backend é escolhido como destino. O pod do backend envia a resposta, e o frontend a recebe.
Ao contrário da situação normal, onde a conexão TCP é fechada após a resposta ser recebida, agora ela permanece aberta para as próximas requisições HTTP.
O que acontecerá se o frontend enviar mais requisições para o backend?
Para encaminhar essas requisições, será utilizada a conexão TCP aberta; todas as requisições chegarão ao mesmo pod do backend que recebeu a primeira requisição.
O iptables não deve redirecionar o tráfego?
Não neste caso.
Quando uma conexão TCP é criada, ela passa pelas regras do iptables, que escolhem o pod específico do backend para onde o tráfego irá.
Como todas as solicitações subsequentes seguem pela conexão TCP já aberta, as regras do iptables não são mais chamadas.
Vamos ver como isso se parece.
- O primeiro pod envia uma solicitação ao serviço:

- Você já sabe o que acontecerá a seguir. O serviço não existe, mas existem regras do iptables que processarão a solicitação:
- Um dos pods do backend será escolhido como o endereço de destino:

- A solicitação chega ao pod. Neste momento, uma conexão TCP permanente entre os dois pods será estabelecida:

- Qualquer solicitação subsequente do primeiro pod irá pela conexão já estabelecida:

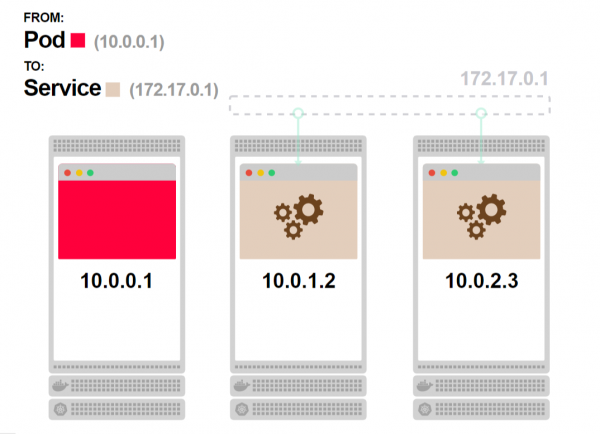
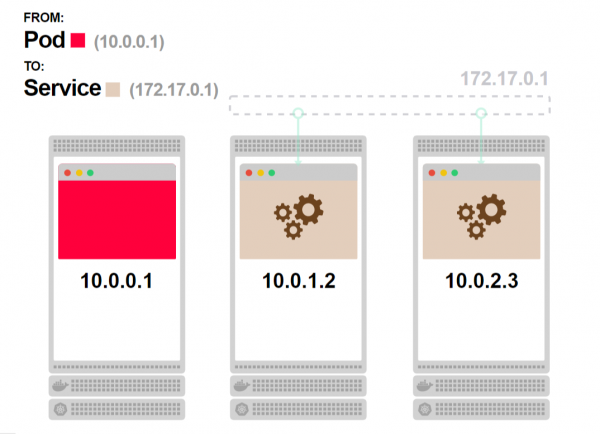
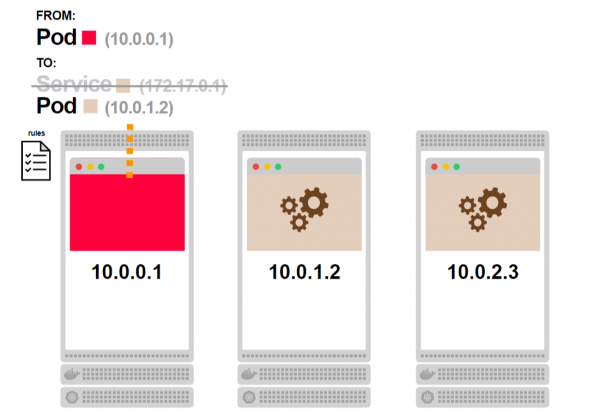
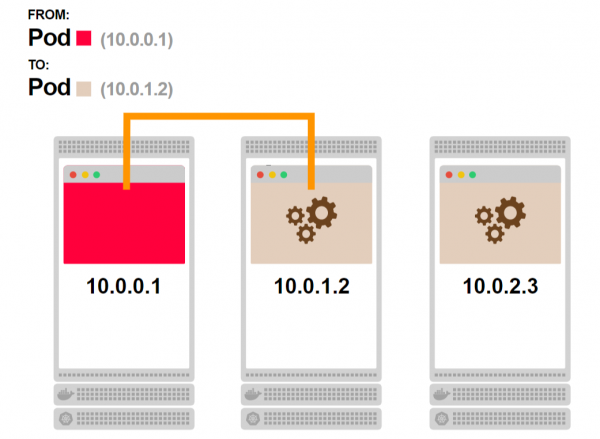
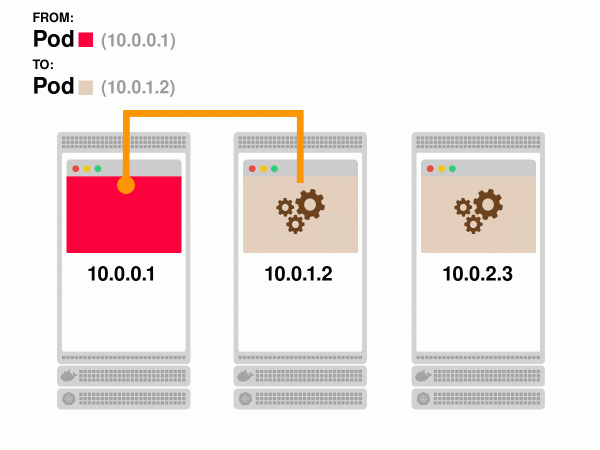
Como resultado, você obteve uma resposta mais rápida e maior largura de banda, mas perdeu a capacidade de escalar o backend.
Mesmo que você tenha dois pods no backend, com a conexão constante, o tráfego sempre será direcionado para um deles.
Isso pode ser corrigido?
Como o Kubernetes não sabe como balancear conexões permanentes, essa tarefa recai sobre você.
Os serviços são um conjunto de endereços IP e portas que chamamos de pontos finais.
Seu aplicativo pode obter a lista de pontos finais do serviço e decidir como distribuir as solicitações entre eles. É possível abrir uma conexão permanente com cada pod e balancear as solicitações entre essas conexões usando round-robin.
Ou implementar algoritmos de balanceamento .
O código no lado do cliente que é responsável pelo balanceamento deve seguir esta lógica:
- Obter a lista de pontos finais do serviço.
- Para cada ponto final, abrir uma conexão permanente.
- Quando for necessário fazer uma solicitação, usar uma das conexões abertas.
- Atualizar regularmente a lista de pontos finais, criar novas ou fechar antigas conexões permanentes em caso de alteração da lista.
Assim ficará.
- Em vez de o primeiro pod enviar uma solicitação ao serviço, você pode balancear as solicitações no lado do cliente:

- É necessário escrever um código que pergunte quais pods fazem parte do serviço:

- Assim que receber a lista, armazene-a no lado do cliente e use para conectar-se aos pods:

- Você mesmo é responsável pelo algoritmo de balanceamento de carga:
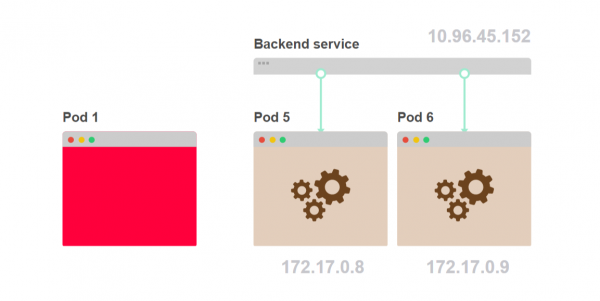
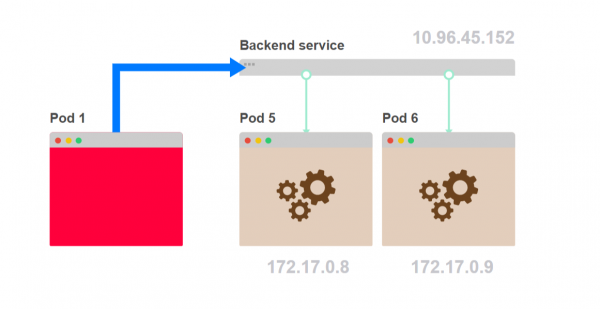
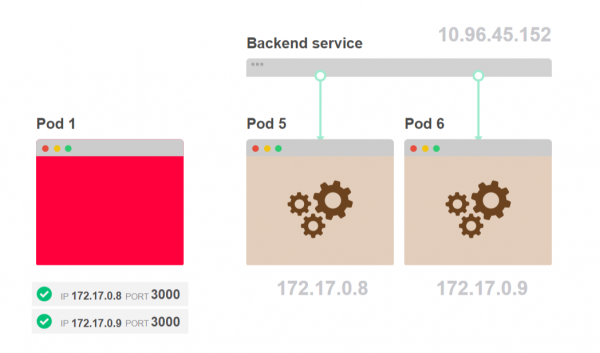
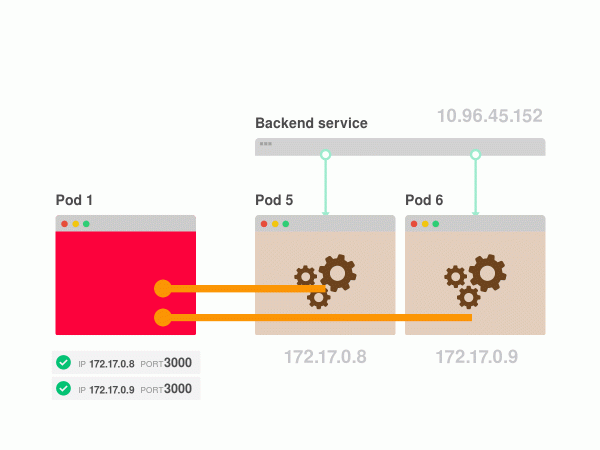
Agora surge a pergunta: esse problema se aplica apenas ao HTTP keep-alive?
Balanceamento de carga do lado do cliente
HTTP não é o único protocolo que pode usar conexões TCP persistentes.
Se sua aplicação utiliza um banco de dados, a conexão TCP não é aberta toda vez que você precisa executar uma consulta ou obter um documento do BD.
Em vez disso, uma conexão TCP persistente é aberta e utilizada com o banco de dados.
Se seu banco de dados está implantado no Kubernetes e o acesso é fornecido na forma de serviço, você encontrará os mesmos problemas descritos na seção anterior.
Uma réplica do banco de dados será mais carregada do que as outras. O Kube-proxy e o Kubernetes não ajudarão a balancear conexões. Você deve cuidar do balanceamento de consultas ao seu banco de dados.
Dependendo da biblioteca que você utiliza para se conectar ao BD, pode haver diferentes opções para resolver esse problema.
Abaixo está um exemplo de acesso ao cluster do banco de dados MySQL a partir do Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints =
/* obtenha os endpoints do Serviço */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Execute consultas ao banco de dados MySQL em cluster
Existem muitos outros protocolos que usam conexões TCP persistentes:
- WebSockets e WebSockets seguros
- HTTP/2
- gRPC
- RSockets
- AMQP
Você deve estar familiarizado com a maioria desses protocolos.
Mas se esses protocolos são tão populares, por que não há uma solução padronizada para balanceamento? Por que é necessária uma alteração na lógica do cliente? Existe uma solução nativa no Kubernetes?
Kube-proxy e iptables foram criados para cobrir a maioria dos cenários de uso padrão ao implantar no Kubernetes. Isso foi feito para conveniência.
Se você está usando um serviço web que fornece uma API REST, você teve sorte — nesse caso, conexões TCP persistentes não são usadas, e você pode usar qualquer serviço Kubernetes.
Mas assim que você começar a usar conexões TCP persistentes, terá que entender como distribuir uniformemente a carga entre os backends. Kubernetes não contém soluções prontas para isso.
No entanto, existem opções que podem ajudar.
Balanceamento de conexões de longa duração no Kubernetes
No Kubernetes, existem quatro tipos de serviços:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
Os três primeiros serviços funcionam com base em um endereço IP virtual, que é utilizado pelo kube-proxy para estabelecer regras de iptables. No entanto, a base fundamental de todos os serviços é o serviço do tipo headless.
O serviço headless não está associado a nenhum endereço IP e apenas fornece um mecanismo para obter uma lista de endereços IP e portas associados aos pods (pontos finais).
Todos os serviços são baseados no serviço headless.
O serviço ClusterIP é um serviço headless com algumas adições:
- A camada de controle atribui um endereço IP a ele.
- O kube-proxy cria as regras de iptables necessárias.
Assim, você pode ignorar o kube-proxy e usar diretamente a lista de pontos finais obtida do serviço headless para balanceamento de carga em sua aplicação.
Mas como adicionar tal lógica a todas as aplicações implantadas no cluster?
Se sua aplicação já estiver implantada, essa tarefa pode parecer impossível. No entanto, há uma alternativa.
O Service Mesh pode ajudar.
Você provavelmente já percebeu que a estratégia de balanceamento de carga do lado do cliente é bastante padrão.
Quando a aplicação é iniciada, ela:
- Obtém a lista de endereços IP do serviço.
- Abre e mantém um pool de conexões.
- Atualiza periodicamente o pool, adicionando ou removendo pontos finais.
Assim que a aplicação deseja fazer uma solicitação, ela:
- Escolhe uma conexão disponível usando alguma lógica (por exemplo, round-robin).
- Realiza a solicitação.
Esses passos funcionam tanto para conexões WebSockets, quanto para gRPC e AMQP.
Você pode extrair essa lógica para uma biblioteca separada e usá-la em suas aplicações.
No entanto, em vez disso, você pode usar meshes de serviços, como Istio ou Linkerd.
O Service Mesh complementa sua aplicação com um processo que:
- Busca automaticamente endereços IP de serviços.
- Verifica conexões, como WebSockets e gRPC.
- Balanceia solicitações usando o protocolo correto.
O Service Mesh ajuda a gerenciar o tráfego dentro do cluster, mas é bastante exigente em termos de recursos. Outras opções incluem o uso de bibliotecas de terceiros, como o Netflix Ribbon, ou proxies programáveis, como o Envoy.
O que acontece se ignorarmos questões de balanceamento?
Você pode não usar balanceamento de carga e ainda assim não notar nenhuma mudança. Vamos examinar alguns cenários de operação.
Se você tem mais clientes do que servidores, isso não é um problema tão grande.
Suponha que existam cinco clientes conectando-se a dois servidores. Mesmo sem balanceamento, ambos os servidores serão utilizados:
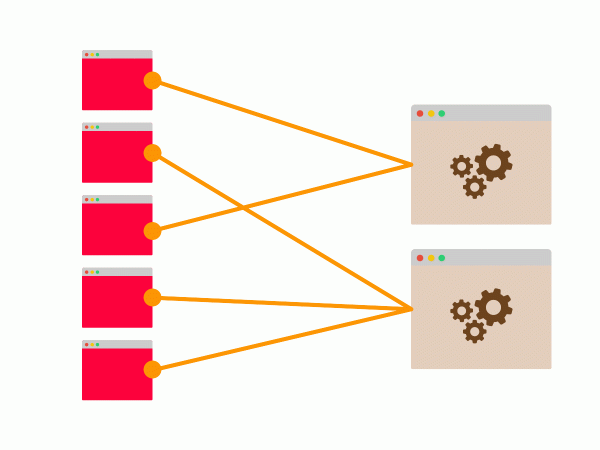
As conexões podem ser distribuídas de maneira desigual: pode ser que quatro clientes estejam conectados ao mesmo servidor, mas há uma boa chance de que ambos os servidores sejam utilizados.
O cenário oposto é o que é mais problemático.
Se você tem menos clientes e mais servidores, seus recursos podem não ser utilizados de forma adequada, levando a um possível gargalo.
Suponha que haja dois clientes e cinco servidores. No melhor dos casos, haverá duas conexões permanentes a dois dos cinco servidores.
Os demais servidores ficarão ociosos:
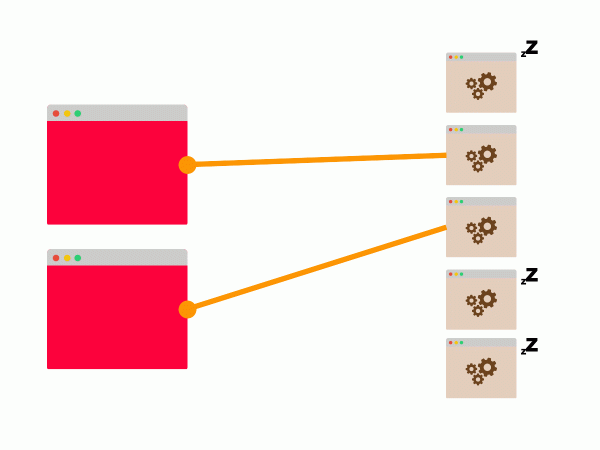
Se esses dois servidores não puderem lidar com o processamento das solicitações dos clientes, a escalabilidade horizontal não ajudará.
Conclusão
Os serviços Kubernetes são projetados para funcionar na maioria dos cenários padrão de aplicações web.
No entanto, assim que você começa a trabalhar com protocolos de aplicações que usam conexões TCP permanentes, como bancos de dados, gRPC ou WebSockets, os serviços já não são adequados. O Kubernetes não fornece mecanismos internos para balancear conexões TCP permanentes.
Isso significa que você deve escrever aplicações com a possibilidade de balanceamento do lado do cliente em mente.
A tradução foi preparada pela equipe .
O que mais ler sobre o assunto:
- .
- .
- .
Fonte: habr.com
