

Em grandes sistemas de nuvem, a questão do balanceamento automático ou equalização da carga sobre os recursos computacionais é especialmente crítica. A Tionix (desenvolvedora e operadora de serviços em nuvem, pertencente ao grupo Rostelecom) também se preocupou com essa questão.
E, uma vez que nossa plataforma principal de desenvolvimento é o OpenStack, e nós, como todas as pessoas, gostamos de facilitar as coisas, decidimos selecionar um módulo pronto que já esteja incluído na plataforma. Escolhemos o Watcher, que decidimos utilizar para nossas necessidades.
Primeiro, vamos esclarecer os termos e definições.
Termos e definições
O objetivo é o resultado final, legível por humanos, observado e mensurável, que deve ser alcançado. Para cada objetivo, há uma ou mais estratégias. Estrategia é a implementação de um algoritmo capaz de encontrar uma solução para o objetivo em questão.
Ação (Action) é uma tarefa elemental que altera o estado atual do recurso gerenciado no cluster OpenStack, como: migração de máquina virtual (migration), alteração do estado de energia do nó (change_node_power_state), alteração do estado do serviço nova (change_nova_service_state), alteração do flavor (resize), registro de mensagem NOP (nop), inatividade por um determinado período de tempo — pausa (sleep), migração de volume (volume_migrate).
Plano de Ação (Action Plan) é um fluxo específico de ações realizadas em uma determinada ordem para alcançar um Objetivo específico. O plano de ação também contém a eficácia geral avaliada com um conjunto de indicadores de desempenho. O plano de ação é gerado pelo Watcher após uma auditoria bem-sucedida, na qual a estratégia utilizada encontra uma solução para atingir o objetivo. O plano de ação consiste em uma lista de ações sequenciais.
Auditoria (Audit) é um pedido de otimização do cluster. A otimização é realizada para alcançar um único Objetivo nesse cluster. Para cada auditoria bem-sucedida, o Watcher gera um Plano de Ação.
Âmbito da Auditoria (Audit Scope) — é um conjunto de recursos no qual é realizada a auditoria (zona(s) de disponibilidade, agregadores de nós, nós computacionais individuais ou nós de armazenamento, etc.). A área de auditoria é definida em cada modelo. Se a área de auditoria não for especificada, a auditoria abrange todo o cluster.
Modelo de Auditoria (Audit Template) — é um conjunto salvo de configurações para iniciar a auditoria. Os modelos são necessários para executar auditorias repetidamente com as mesmas configurações. O modelo deve obrigatoriamente conter o objetivo da auditoria; caso as estratégias não sejam especificadas, as mais adequadas entre as existentes são escolhidas.
Cluster (Cluster) — é um conjunto de máquinas físicas que fornecem recursos computacionais, recursos de armazenamento e recursos de rede, gerenciados por um mesmo nó controlador do OpenStack.
Modelo de Dados do Cluster (Cluster Data Model, CDM) — é a representação lógica do estado atual e da topologia dos recursos gerenciados pelo cluster.
Indicador de Eficácia (Efficacy Indicator) — é um indicador que mostra como a solução desenvolvida com essa estratégia está sendo executada. Os indicadores de eficácia são específicos para cada objetivo e geralmente são usados para calcular a eficácia global do plano de ação final.
Especificação de Eficácia (Efficacy Specification) — é um conjunto de características específicas associadas a cada Objetivo, que define diferentes indicadores de eficácia que a estratégia, responsável por alcançar o respectivo objetivo, deve garantir em sua solução. Na verdade, cada solução proposta pela estratégia será verificada quanto à conformidade com a especificação antes que sua eficácia global seja calculada.
Motor de Pontuação (Scoring Engine) — é um arquivo executável que possui entradas claramente definidas, saídas claramente definidas e executa uma tarefa puramente matemática. Assim, o cálculo não depende do ambiente em que é executado — ele fornecerá o mesmo resultado em qualquer lugar.
Planejador Watcher (Watcher Planner) — parte do mecanismo de tomada de decisões do Watcher. Este módulo aceita um conjunto de ações geradas pela estratégia e cria um plano de fluxo de trabalho que determina como programar no tempo essas diferentes ações e quais são as pré-condições para cada ação.
Objetivos e estratégias do Watcher
O objetivo
Estratégias
Objetivo fictício
Estratégia Fictícia
Estratégia Fictícia usando Motores de Avaliação amostrais
Estratégia fictícia com redimensionamento
Economizando Energia
Estratégia de Economia de Energia
Consolidação de Servidores
Consolidação de Servidores Offline Básica
Estratégia de Consolidação de Carga de Trabalho em VM
Balanceamento de Carga de Trabalho
Estratégia de Migração de Balanceamento de Carga
Estratégia de Equilíbrio de Capacidade de Armazenamento
Estabilização da Carga de Trabalho
Vizinhos Barulhentos
Vizinhos Barulhentos
Otimização Térmica
Estratégia baseada na temperatura da saída
Otimização do Fluxo de Ar
Estratégia de migração de fluxo de ar uniforme
Manutenção de Hardware
Migração de Zona
Não classificado
Atuador
Objetivo fictício — objetivo reservado utilizado para testes (reserved goal that is used for testing purposes).
Estratégias relacionadas: Estratégia Fictícia, Estratégia Fictícia usando Motores de Avaliação amostrais e Estratégia fictícia com redimensionamento. A estratégia fictícia é uma estratégia usada para testes de integração através do Tempest. Esta estratégia não fornece nenhuma otimização útil, seu único objetivo é utilizar os testes Tempest.
Estratégia Fictícia usando Motores de Avaliação amostrais — a estratégia é semelhante à anterior, diferindo apenas pelo uso de um 'motor de avaliação' amostral que contabiliza usando métodos de aprendizado de máquina.
Estratégia fictícia com redimensionamento — a estratégia é semelhante à anterior, diferenciando-se apenas pelo uso de mudança de flavor (migração e redimensionamento).
Não é utilizada em produção.
Economizando Energia — minimizar o consumo de energia. A estratégia deste objetivo, Estratégia de Economia de Energia, em conjunto com a Estratégia de Consolidação de Carga de Trabalho em VM (Consolidação de Servidores), é capaz de executar funções de gerenciamento dinâmico de energia (DPM), economizando eletricidade por meio da consolidação dinâmica de cargas de trabalho, mesmo em períodos de baixa utilização dos recursos: máquinas virtuais são movidas para um número menor de nós e nós desnecessários são desligados. Após a consolidação, a estratégia sugere uma solução para ligar/desligar nós de acordo com parâmetros definidos: 'min_free_hosts_num' — número de nós livres ligados que aguardam carga e 'free_used_percent' — porcentagem de nós livres e ligados em relação ao número de nós ocupados por máquinas. Para que a estratégia funcione, o Ironic deve estar ativado e configurado para trabalhar com a ativação/desativação de energia nos nós.
Parâmetros da estratégia
parâmetro
o tipo
padrão
descrição
free_used_percent
Número
10.0
relação entre o número de nós computacionais livres e o número de nós computacionais com máquinas virtuais
min_free_hosts_num
Int
1
número mínimo de nós computacionais livres
Na nuvem, deve haver pelo menos dois nós. O método utilizado é a alteração do estado de energia do nó (change_node_power_state). A estratégia de coleta de métricas não é necessária.
Consolidação de Servidores — minimizar o número de nós computacionais (consolidação). Possui duas estratégias: Consolidação Offline Básica de Servidores e Estratégia de Consolidação de Carga de Trabalho de VM.
A estratégia Consolidação Offline Básica de Servidores minimiza o número total de servidores utilizados, assim como minimiza o número de migrações.
A estratégia básica exige as seguintes métricas:
métrica
serviço
plugins
comentário
compute.node.cpu.percent
none
cpu_util
none
Parâmetros da estratégia: migration_attempts — número de combinações para buscar potenciais candidatos para desligamento (por padrão, 0, sem restrições), period — intervalo de tempo em segundos para obter a agregação estática da fonte de dados de métricas (por padrão, 700).
Métodos utilizados: migração, alteração do estado do serviço nova (change_nova_service_state).
A Estratégia de Consolidação de Carga de Trabalho de VM é baseada em um algoritmo heurístico de primeiro adequado (first-fit), que foca na carga medida da CPU e tenta minimizar os nós que têm carga excessiva ou insuficiente, considerando as limitações de capacidade de recursos. Esta estratégia fornece uma solução que leva a um uso mais eficiente dos recursos do cluster, utilizando as seguintes quatro etapas:
- Fase de descarregamento — processamento de recursos sobrecarregados;
- Fase de consolidação — processamento de recursos subutilizados;
- Otimização da solução — redução no número de migrações;
- Desligamento de nós computacionais não utilizados.
A estratégia requer as seguintes métricas:
métrica
serviço
plugins
comentário
memory
none
disk.root.size
none
As seguintes métricas não são obrigatórias, mas aumentam a precisão da estratégia, se disponíveis:
métrica
serviço
plugins
comentário
memory.resident
none
cpu_util
none
Parâmetros da estratégia: period — intervalo de tempo em segundos para obter a agregação estática da fonte de dados de métricas (por padrão, 3600).
Utiliza os mesmos métodos que a estratégia anterior. Para mais informações .
Balanceamento de Carga de Trabalho — equilibrar a carga de trabalho entre os nós computacionais. O objetivo possui três estratégias: Estratégia de Migração de Equilíbrio de Carga de Trabalho, Estabilização de Carga de Trabalho, Estratégia de Equilíbrio de Capacidade de Armazenamento.
A estratégia de migração de balanceamento de carga de trabalho inicia migrações de máquinas virtuais com base na carga de trabalho das máquinas virtuais dos nós. A decisão de movimentar é tomada sempre que a % de utilização da CPU ou da RAM do nó excede o limite especificado. A máquina virtual movida deve aproximar o nó da carga de trabalho média de todos os nós.
Requisitos
- Uso de processadores físicos;
- Mínimo de dois nós computacionais físicos;
- Componente Ceilometer instalado e configurado — ceilometer-agent-compute, funcionando em cada nó computacional, e Ceilometer API, além da coleta das seguintes métricas:
métrica
serviço
plugins
comentário
cpu_util
none
memory.resident
none
Parâmetros da estratégia:
parâmetro
o tipo
padrão
descrição
metrics
String
‘cpu_util’
Métricas subjacentes: ‘cpu_util’, ‘memory.resident’.
threshold
Número
25.0
Limite de carga de trabalho para migração.
período
Número
300
Período total de tempo do Ceilometer.
Método utilizado — migração.
A estabilização da carga de trabalho — estratégia voltada para estabilizar a carga de trabalho usando migrações ao vivo. A estratégia é baseada em um algoritmo de desvio padrão e determina se há sobrecarga no cluster, reagindo a isso iniciando a migração de máquinas para estabilizar o cluster.
Requisitos
- Uso de processadores físicos;
- Mínimo de dois nós computacionais físicos;
- Componente Ceilometer instalado e configurado — ceilometer-agent-compute, funcionando em cada nó computacional, e Ceilometer API, além da coleta das seguintes métricas:
métrica
serviço
plugins
comentário
cpu_util
none
memory.resident
none
A estratégia de Balanceamento de Capacidade de Armazenamento (implementada a partir do Queens) — a estratégia move discos com base na carga dos pools do Cinder. A decisão de movimentar é tomada sempre que a taxa de utilização do pool excede o limite especificado. O disco movido deve aproximar o pool da carga média de todos os pools do Cinder.
Requisitos e limitações
- Mínimo de dois pools do Cinder;
- Capacidade de migração de discos.
- Modelo de dados do cluster — coletor do modelo de dados do cluster do Cinder.
Parâmetros da estratégia:
parâmetro
o tipo
padrão
descrição
volume_threshold
Número
80.0
Valor limite dos discos para balanceamento de volumes.
Método utilizado — migração de disco (volume_migrate).
Vizinhança Barulhenta — identificar e mover o "vizinho barulhento" — máquina virtual de baixa prioridade que afeta negativamente o desempenho de uma máquina virtual de alta prioridade em termos de IPC, utilizando excessivamente o Last Level Cache. Estrategia própria: Vizinhança Barulhenta (parâmetro de estratégia utilizado — cache_threshold (valor padrão — 35), quando o desempenho cai para o valor especificado, a migração é iniciada. Para o funcionamento da estratégia, são necessárias métricas de LLC (Last Level Cache), último servidor Intel com suporte a CMT, além da coleta das seguintes métricas:
métrica
serviço
plugins
comentário
cpu_l3_cache
none
Necessário Intel .
Modelo de dados do cluster (padrão): coletor de modelo de dados do cluster Nova. O método aplicado é a migração.
A operação com este objetivo através do Dashboard não está implementada na totalidade no Queens.
Otimização Térmica — otimizar o regime de temperatura. A temperatura na saída (ar expelido) é um dos sistemas de telemetria térmica mais importantes para medir o estado da carga térmica / operacional do servidor. Para o objetivo existe uma estratégia – estratégia baseada na temperatura da saída, que toma decisões sobre a transferência de cargas de trabalho para nós com regime de temperatura favorável (a temperatura na saída mais baixa), quando a temperatura na saída dos hosts de origem atinge um limite ajustável.
Para a operação da estratégia, é necessário um servidor com Intel Power Node Manager instalado e configurado. , além da coleta das seguintes métricas:
métrica
serviço
plugins
comentário
hardware.ipmi.node.outlet_temperature
IPMI
Parâmetros da estratégia:
parâmetro
o tipo
padrão
descrição
threshold
Número
35.0
Limite de temperatura para migração.
período
Número
30
Intervalo de tempo em segundos para obter agregação estatística da fonte de dados de métricas.
Método utilizado — migração.
Otimização do Fluxo de Ar — otimizar o modo de ventilação. A estratégia própria — Fluxo de Ar Uniforme usando migração ao vivo. A estratégia inicia a migração da máquina virtual sempre que o fluxo de ar do ventilador do servidor ultrapassa o limite especificado.
Para a operação da estratégia, são necessários:
- Hardware: nós de computação <com suporte a NodeManager 3.0;
- Mínimo de dois nós de computação;
- Componente ceilometer-agent-compute instalado e configurado em cada nó de computação e Ceilometer API, que pode relatar com sucesso métricas como fluxo de ar, energia do sistema, temperatura na entrada:
métrica
serviço
plugins
comentário
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
Para a operação da estratégia, é necessário um servidor com Intel Power Node Manager 3.0 ou versão posterior instalado e configurado.
Restrições: a concepção não é destinada à produção.
Recomenda-se usar este algoritmo com auditorias contínuas, pois em uma única iteração está prevista a migração de apenas uma máquina virtual.
Migrações ao vivo são possíveis.
Parâmetros da estratégia:
parâmetro
o tipo
padrão
descrição
threshold_airflow
Número
400.0
Limite de fluxo de ar para migração Unidade é 0.1CFM
threshold_inlet_t
Número
28.0
Limite de temperatura na entrada para a decisão de migração
threshold_power
Número
350.0
Limite de potência do sistema para a decisão de migração
período
Número
30
Intervalo de tempo em segundos para obter agregação estatística da fonte de dados de métricas.
Método utilizado — migração.
Manutenção de Hardware — manutenção de hardware. A estratégia relacionada a este objetivo é a migração de zona. Esta estratégia é uma ferramenta para migração automática eficaz e mínima de máquinas virtuais e discos, quando necessário realizar a manutenção do hardware. A estratégia estabelece um plano de ação com base em pesos: um conjunto de ações que possui um peso maior será agendado antes das outras. Existem dois parâmetros de configuração: pesos das ações (action_weights) e paralelização (parallelization).
Restrições: é necessário configurar os pesos das ações e a paralelização.
Parâmetros da estratégia:
parâmetro
o tipo
padrão
descrição
nós_de_cálculo
array
Nenhum
Nódulos de cálculo para migração.
pools_de_armazenamento
array
Nenhum
Nódulos de armazenamento para migração.
total_paralelo
inteiro
6
Número total de ações que devem ser executadas em paralelo.
paralelo_por_nó
inteiro
2
Número de ações executadas em paralelo para cada nó de cálculo.
paralelo_por_pool
inteiro
2
Número de ações executadas em paralelo para cada pool de armazenamento.
priority
objeto
Nenhum
Lista de prioridades para máquinas virtuais e discos.
com_volume_anexado
booleano
False
Falso — as máquinas virtuais serão transferidas após a transferência de todos os discos. Verdadeiro — as máquinas virtuais serão transferidas após a migração de todos os discos conectados.
Elementos do array de nós de cálculo:
parâmetro
o tipo
padrão
descrição
nó_src
string
Nenhum
Nó de cálculo de onde as máquinas virtuais estão sendo transferidas (obrigatório).
nó_dst
string
Nenhum
Nó de cálculo para o qual as máquinas virtuais estão sendo migradas.
Elementos do array de nós de armazenamento:
parâmetro
o tipo
padrão
descrição
pool_src
string
Nenhum
Pool de armazenamento de onde os discos estão sendo transferidos (obrigatório).
pool_dst
string
Nenhum
Pool de armazenamento para onde os discos estão sendo transferidos.
tipo_src
string
Nenhum
Tipo de disco de origem (obrigatório).
tipo_dst
string
Nenhum
Tipo de disco de destino (obrigatório).
Elementos de prioridade dos objetos:
parâmetro
o tipo
padrão
descrição
projeto
array
Nenhum
Nomes dos projetos.
nó_de_cálculo
array
Nenhum
Nomes dos nós de cálculo.
pool_de_armazenamento
array
Nenhum
Nomes dos pools de armazenamento.
cálculo
enum
Nenhum
Parâmetros da máquina virtual [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
storage
enum
Nenhum
Parâmetros dos discos [“size”, “created_at”].
Métodos utilizados — migração de máquinas virtuais, migração de discos.
Não classificado — um objetivo auxiliar usado para facilitar o processo de desenvolvimento da estratégia. Não contém especificações e pode ser usado sempre que a estratégia ainda não estiver vinculada a um objetivo existente. Este objetivo também pode ser usado como uma etapa de transição. A estratégia relacionada a este objetivo é o Atuador.
Criação de um novo objetivo.
Motor de Decisão do Watcher possui uma interface de plugin de "objetivo externo", que permite integrar um objetivo externo que pode ser alcançado através de uma estratégia.
Antes de criar um novo objetivo, é importante garantir que nenhum dos objetivos existentes atenda às suas necessidades.
Criar um novo plugin
Para criar um novo objetivo, você deve: estender a classe de objetivo, implementar o método da classe get_name() para retornar um identificador exclusivo do novo objetivo que deseja criar. Este identificador exclusivo deve corresponder ao nome do ponto de entrada que você declara posteriormente.
Em seguida, é necessário implementar o método da classe get_display_name() para retornar o nome de exibição traduzido do objetivo que você deseja criar (não use uma variável para retornar a string traduzida, para que ela possa ser automaticamente compilada pela ferramenta de tradução.).
Implemente o método da classe get_translatable_display_name(), para retornar a chave de tradução (na verdade, o nome de exibição em inglês) do seu novo objetivo. O valor retornado deve corresponder à string traduzida em get_display_name().
Implemente o seu método get_efficacy_specification(), para retornar a especificação de eficácia do seu objetivo. O método get_efficacy_specification() retorna uma instância de Unclassified(), fornecida pelo Watcher. Esta especificação de eficácia é útil no processo de desenvolvimento do seu objetivo, pois corresponde a uma especificação vazia.
→
Arquitetura do Watcher (saiba mais ).
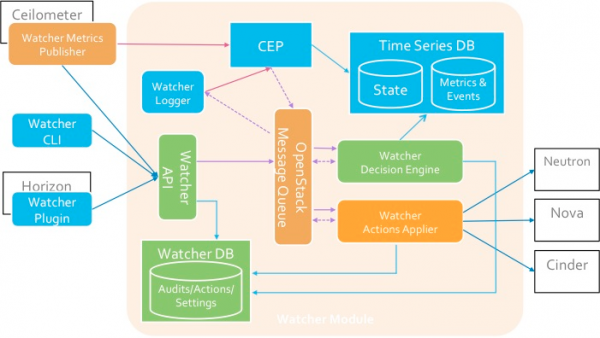
Componentes
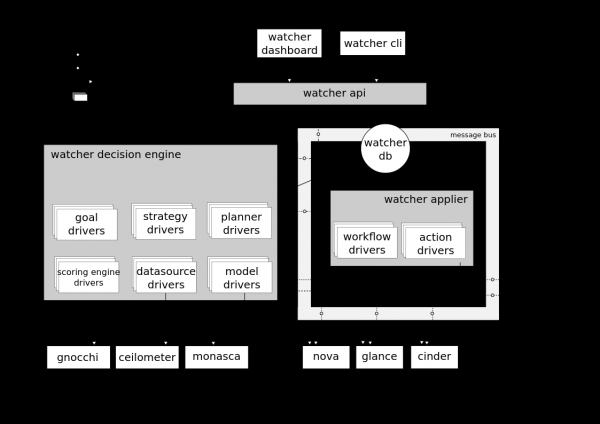
API do Watcher — componente que implementa a API REST fornecida pelo Watcher. Mecanismos de interação: CLI, plugin Horizon, SDK Python.
Banco de Dados do Watcher — banco de dados do Watcher.
Aplicador do Watcher — componente que implementa a execução do plano de ação criado pelo componente Motor de Decisão do Watcher.
Motor de Decisão do Watcher — componente responsável por calcular um conjunto de ações potenciais de otimização para a realização do objetivo de auditoria. Se a estratégia não for especificada, o componente escolhe a mais adequada por conta própria.
Publicador de Métricas do Watcher — componente que coleta e calcula algumas métricas ou eventos e os publica no ponto final CEP. A funcionalidade do componente também pode ser fornecida pelo publicador Ceilometer.
Motor de Processamento de Eventos Complexos (CEP) — motor de processamento complexo de eventos. Por motivos de desempenho, pode haver várias instâncias do CEP Engine funcionando simultaneamente, cada uma processando um tipo específico de métrica / evento. No sistema Watcher, o CEP inicia dois tipos de ações: — gravar os eventos / métricas correspondentes no banco de dados de séries temporais; — enviar os eventos correspondentes para o componente Watcher Decision Engine, quando esse evento pode impactar o resultado da estratégia de otimização atual, uma vez que o cluster Openstack não é um sistema estático.
A interação entre os componentes é feita pelo protocolo AMQP.
→
Esquema de interação com o Watcher
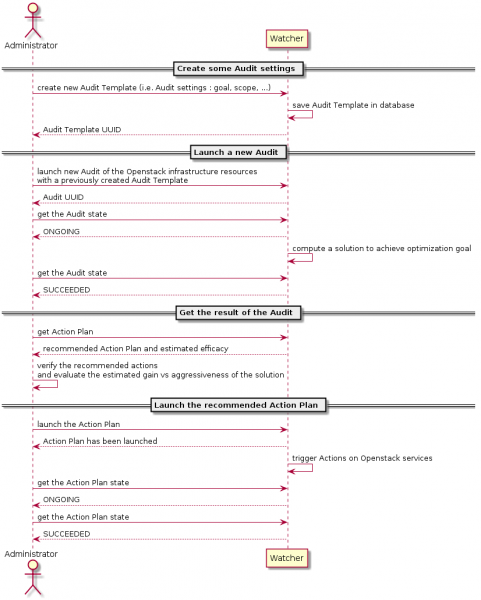
Resultados dos testes do Watcher
- Na página de Otimização — Planos de ação, aparece erro 500 (tanto na versão limpa do Queens quanto na configuração com módulos Tionix), ocorrendo apenas depois que a auditoria é iniciada e um plano de ação é gerado; a versão vazia abre normalmente.
- Na aba Detalhes da ação, apresenta erros, não é possível obter o objetivo e a estratégia da auditoria (tanto na versão limpa do Queens quanto na configuração com módulos Tionix).
- Auditorias com objetivo Dummy (testes) são criadas e executadas normalmente, os planos de ação são gerados.
- Auditorias com objetivo Unclassified não são criadas, pois o objetivo não é funcional e é destinado a ajustes intermediários durante a criação de novas estratégias.
- Auditorias com objetivo Balanceamento de Carga (estratégia de Equilíbrio de Capacidade de Armazenamento) são criadas com sucesso, no entanto, o plano de ação não é gerado. Não é necessária a otimização dos pools de armazenamento.
- Auditorias com objetivo Balanceamento de Carga (estratégia de Estratégia de Migração de Equilíbrio de Carga) são criadas com sucesso, no entanto, o plano de ação não é gerado.
- Auditorias com objetivo Balanceamento de Carga (estratégia de Estratégia de Estabilização de Carga) falham.
- Auditorias com objetivo Noisy Neighbor são criadas com sucesso, no entanto, o plano de ação não é gerado.
- Auditorias com objetivo Manutenção de Hardware são criadas com sucesso, o plano de ação é gerado de forma incompleta (os indicadores de desempenho são gerados, mas a lista de ações não é gerada).
- Ajustes nas configurações do nova.conf (na seção padrão compute_monitors = cpu.virt_driver) nos nós de computação e de controle não corrigem os erros.
- Auditorias com objetivo Consolidação de Servidores (estratégia Básica) também falham com erro.
- Auditorias com objetivo Consolidação de Servidores (estratégia de consolidação de carga de trabalho da VM) falham com erro. Nos logs, há erro na obtenção dos dados de origem. Discussão sobre o erro, em particular, .
Tentamos definir no arquivo de configuração do Watcher (não funcionou — resultando em erros em todas as páginas de Otimização, retornar ao conteúdo original do arquivo de configuração não corrige a situação):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Auditorias com o objetivo de Saving Energy estão falhando. A julgar pelos logs, o problema está mesmo na falta do Ironic, não funcionará sem o serviço baremetal.
- Auditorias com o objetivo de Thermal Optimization estão falhando. O traceback é o mesmo do Server Consolidation (estratégia de VM workload consolidation) (erro de dados de origem)
- Auditorias com o objetivo de Airflow Optimization estão falhando.
Também ocorrem os seguintes erros ao finalizar a auditoria. O traceback nos logs decision-engine.log (estado do cluster não definido).
→ Discussão do erro
Conclusão
O resultado de nossas investigações de dois meses é que, para obter um sistema de balanceamento de carga funcional, teremos que nos dedicar seriamente ao aprimoramento das ferramentas para a plataforma Openstack.
O Watcher se mostrou um produto sério e em rápido desenvolvimento, com um enorme potencial, para o uso pleno do qual será necessário um trabalho grande e sério.
Mas isso – em próximos artigos do ciclo.
Fonte: habr.com
