

KDB+, produto da empresa — é um banco de dados colunar altamente conhecido em nichos específicos, projetado para armazenar séries temporais e realizar cálculos analíticos baseados nelas. Originalmente, gozava (e ainda goza) de grande popularidade na indústria financeira — é utilizado por todos os 10 principais bancos de investimento e muitas renomadas hedge funds, bolsas de valores e outras organizações. Recentemente, a KX decidiu expandir sua base de clientes e agora oferece soluções em outras áreas onde há uma grande quantidade de dados, organizados por tempo ou de outra forma — telecomunicações, bioinformática, manufatura, etc. Eles também se tornaram parceiros da equipe Aston Martin Red Bull Racing na Fórmula 1, ajudando a coletar e processar dados de sensores dos carros e analisar testes em túneis de vento. Neste artigo, quero explicar quais características do KDB+ a tornam super eficiente, por que as empresas estão dispostas a gastar grandes quantias de dinheiro nela e, finalmente, por que isso realmente não é um banco de dados.
Neste artigo, tentarei explicar, em geral, o que é o KDB+, quais possibilidades e limitações ele possui, e qual é seu benefício para as empresas que desejam processar grandes volumes de dados. Não entrarei nos detalhes da implementação do KDB+ e de sua linguagem de programação Q. Ambos os temas são muito extensos e merecem artigos separados. Muitas informações sobre esses tópicos podem ser encontradas no site code.kx.com, incluindo o livro sobre Q — Q For Mortals (veja o link abaixo).
Alguns termos
- Banco de dados em memória. Um banco de dados que armazena dados na memória RAM para acelerar o acesso. As vantagens desse tipo de banco são evidentes, enquanto as desvantagens incluem a possibilidade de perda de dados e a necessidade de ter uma grande quantidade de memória no servidor.
- Banco de dados colunar. Um banco de dados onde os dados são armazenados por colunas, em vez de linha por linha. A principal vantagem desse tipo de banco é que os dados de uma única coluna são armazenados juntos no disco e na memória, o que acelera significativamente o acesso a eles. Não é necessário carregar colunas que não são utilizadas na consulta. A principal desvantagem é a dificuldade em modificar e excluir registros.
- Série temporal. Dados de coluna do tipo data ou hora. Geralmente, para esse tipo de dados, a ordenação temporal é importante para que seja fácil determinar qual registro precede ou segue o atual, ou para aplicar funções cujo resultado depende da ordem dos registros. Bancos de dados clássicos são construídos com um princípio completamente diferente — a representação de uma coleção de registros como um conjunto, onde a ordem dos registros, em princípio, não é definida.
- Vetor. No contexto do KDB+ — é uma lista de elementos de um único tipo atômico, por exemplo, números. Em outras palavras, um array de elementos. Arrays, ao contrário de listas, podem ser armazenados de forma compacta e processados usando instruções vetoriais do processador.
Histórico
A empresa KX foi fundada em 1993 por Arthur Whitney, que antes disso trabalhou no banco Morgan Stanley desenvolvendo a linguagem A+, um descendente do APL — uma linguagem muito original que, em seu tempo, foi popular no mundo financeiro. Naturalmente, na KX, Arthur continuou nesse espírito e criou a linguagem funcional vetorial K, guiado por ideias de minimalismo radical. Os programas em K parecem uma combinação desordenada de sinais de pontuação e símbolos especiais, onde o significado dos sinais e funções depende do contexto, e cada operação carrega muito mais significado do que em linguagens de programação convencionais. Devido a isso, um programa em K ocupa um espaço mínimo — algumas linhas podem substituir páginas de texto de uma linguagem prolixa como Java — e é uma implementação superconcentrada de um algoritmo.
Função em K que implementa a maior parte do gerador de parser LL1 de acordo com a gramática dada:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/:":1_r),"]";""]]}
Esta filosofia de eficiência extrema com o mínimo de movimento foi incorporada por Arthur no KDB+, que surgiu em 2003 (acho que agora está claro de onde vem a letra K no nome) e nada mais é do que um interpretador da quarta versão da linguagem K. Sobre o K, foi adicionada uma versão mais amigável para o usuário chamada Q. O Q também inclui suporte a um dialeto específico de SQL — QSQL, e no interpretador — suporte a tabelas, como um tipo de dado do sistema, ferramentas para trabalhar com tabelas na memória e no disco, e assim por diante.
Assim, do ponto de vista do usuário, o KDB+ é simplesmente um interpretador da linguagem Q com suporte a tabelas e expressões semelhantes ao SQL no estilo LINQ do C#. Essa é a principal diferença do KDB+ em relação a outros bancos de dados e a sua principal vantagem competitiva, que muitas vezes é esquecida. Não se trata de um banco de dados + uma linguagem auxiliar incapacitada, mas sim de uma linguagem de programação poderosa + suporte embutido para funções de banco de dados. Essa diferença desempenhará um papel crucial ao listar todas as vantagens do KDB+. Por exemplo...
Tamanho
Em termos modernos, o KDB+ tem um tamanho apenas microscópico. É, na verdade, um único arquivo executável com menos de um megabyte e um pequeno arquivo de texto com algumas funções do sistema. De fato, é menos de um megabyte, e as empresas pagam dezenas de milhares de dólares por ano por um único processador em um servidor por essa programação.
- Esse tamanho permite que o KDB+ funcione bem em qualquer hardware — desde microcomputadores Pi até servidores com terabytes de memória. Isso não afeta a funcionalidade; pelo contrário, o Q inicia instantaneamente, o que permite seu uso também como uma linguagem de script.
- Com esse tamanho, o interpretador Q cabe completamente no cache do processador, o que acelera a execução de programas.
- Com esse tamanho do arquivo executável, o processo do Q ocupa um espaço ínfimo na memória, podendo ser executado centenas de vezes. Ao mesmo tempo, quando necessário, o Q pode operar com dezenas ou centenas de gigabytes de memória dentro de um único processo.
Versatilidade
Q é ideal para uma variedade de tarefas. O processo Q pode funcionar como um banco de dados histórico e fornecer acesso rápido a terabytes de informações. Temos, por exemplo, dezenas de bancos de dados históricos, sendo que em alguns deles um dia de dados não comprimidos ocupa mais de 100 gigabytes. No entanto, com limites razoáveis, a consulta ao banco será realizada em dezenas a centenas de milissegundos. Em geral, temos um tempo limite universal de 30 segundos para consultas de usuários, e isso raramente é acionado.
Com a mesma facilidade, Q pode ser um banco de dados em memória. A adição de novos dados a tabelas na memória ocorre tão rapidamente que o fator limitante são as consultas dos usuários. Os dados nas tabelas são armazenados por colunas, de modo que qualquer operação em uma coluna usará o cache do processador ao máximo. Além disso, a KX procurou implementar todas as operações básicas, como aritméticas, por meio de instruções vetoriais do processador, maximizando sua velocidade. Q pode executar tarefas que não são comuns a bancos de dados — como processar dados em fluxo e calcular em 'tempo real' (com um atraso de dezenas de milissegundos a vários segundos, dependendo da tarefa) várias funções agregadoras para instrumentos financeiros em diferentes intervalos de tempo ou construir um modelo do impacto de uma transação no mercado e realizar seu perfilamento praticamente imediatamente após sua execução. Nessas tarefas, a maior latência de tempo geralmente é causada não pelo Q, mas pela necessidade de sincronizar dados de diferentes fontes. Alta velocidade é alcançada porque os dados e as funções que os processam estão no mesmo processo, e o processamento é reduzido à execução de várias expressões QSQL e junções que não são interpretadas, mas executadas em código binário.
Finalmente, no Q é possível escrever quaisquer processos de serviço. Por exemplo, processos de Gateway que automaticamente distribuem consultas de usuários entre os bancos e servidores necessários. O programador tem total liberdade para implementar qualquer algoritmo para balanceamento, priorização, tolerância a falhas, controle de acesso, cotas e, basicamente, o que desejar. O principal problema aqui é que será necessário implementar tudo isso por conta própria.
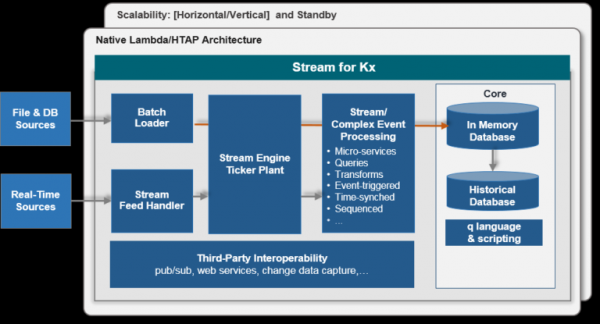
Como exemplo, vou listar os tipos de processos que temos. Todos eles são amplamente utilizados e funcionam em conjunto, integrando dezenas de diferentes bases, processando dados de várias fontes e atendendo centenas de usuários e aplicativos.
- Conectores (feedhandler) para fontes de dados. Esses processos normalmente utilizam bibliotecas externas, que são carregadas no Q. A interface C em Q é extremamente simples e permite criar facilmente funções proxy para qualquer biblioteca em C/C++. Q é rápido o suficiente para lidar, por exemplo, com o processamento de fluxos de mensagens FIX de todas as bolsas de valores europeias simultaneamente.
- Distribuidores de dados (tickerplant), que atuam como um elo intermediário entre os conectores e os consumidores. Simultaneamente, eles gravam os dados de entrada em um log binário especial, garantindo que os consumidores não percam dados durante desconexões ou reinicializações.
- Bancos de dados em memória (rdb). Esses bancos garantem acesso extremamente rápido a dados brutos e frescos, armazenando-os na memória. Normalmente, eles acumulam dados em tabelas ao longo do dia e os resetam à noite.
- Bancos de dados persistentes (pdb). Esses bancos asseguram a сохранение dos dados do dia atual em uma base histórica. Geralmente, ao contrário dos rdb, eles não mantêm dados na memória, mas utilizam um cache especial em disco durante o dia e copiam os dados para a base histórica à meia-noite.
- Bases de dados históricas (hdb). Esses bancos fornecem acesso a dados de dias, meses e anos anteriores. Seu tamanho (em dias) é limitado apenas pela capacidade dos discos rígidos. Os dados podem estar localizados em qualquer lugar, inclusive em discos diferentes para acelerar o acesso. Existe a possibilidade de compressão de dados, utilizando vários algoritmos à escolha. A estrutura do banco está bem documentada e é simples, com os dados armazenados em arquivos comuns por coluna, permitindo o processamento também por meio do sistema operacional.
- Bancos de dados com informações agregadas. Eles armazenam diversas agregações, normalmente agrupadas por nome do instrumento e intervalo de tempo. Os bancos de dados em memória atualizam seu estado a cada mensagem recebida, enquanto os históricos armazenam dados pré-calculados para acelerar o acesso a dados históricos.
- Finalmente, processos gateway, que atendem a aplicativos e usuários. Q permite implementar um processamento assíncrono completo de mensagens recebidas, distribuindo-as entre bancos de dados, verificando permissões de acesso e assim por diante. Vale ressaltar que as mensagens não são limitadas e, na maioria das vezes, não correspondem a expressões SQL, como ocorre em outros bancos de dados. Na maioria das vezes, a expressão SQL está oculta em uma função especial e é construída com base nos parâmetros solicitados pelo usuário — ocorre conversão de tempo, filtragem, dados são normalizados (por exemplo, o preço das ações é ajustado quando há pagamento de dividendos) e assim por diante.
Arquitetura típica para um tipo de dado:
Velocidade
Embora Q seja uma linguagem interpretada, também é uma linguagem vetorial. Isso significa que muitas funções embutidas, em particular, as aritméticas, aceitam argumentos de qualquer forma — números, vetores, matrizes, listas, e espera-se que o programador implemente o programa como operações em arrays. Em tal linguagem, se você somar dois vetores com um milhão de elementos, já não importa que a linguagem seja interpretada, a soma será realizada por uma função binária superotimizada. Como a maior parte do tempo em programas em Q é gasta em operações com tabelas que utilizam essas funções vetorizadas básicas, o resultado é uma velocidade de operação bastante respeitável, permitindo processar um enorme volume de dados mesmo em um único processo. Isso se assemelha a bibliotecas matemáticas em Python — embora o próprio Python seja uma linguagem relativamente lenta, há muitas bibliotecas excelentes como numpy, que permitem processar dados numéricos na velocidade de uma linguagem compilada (por sinal, o numpy ideologicamente se aproxima do Q).
Além disso, a KX se dedicou muito ao design das tabelas e à otimização do trabalho com elas. Em primeiro lugar, vários tipos de índices são suportados, que são oferecidos por funções incorporadas e podem ser aplicados não apenas às colunas das tabelas, mas também a quaisquer vetores — agrupamento, ordenação, atributo de exclusividade e agrupamento especial para bancos de dados históricos. O índice é aplicado de forma simples e é corrigido automaticamente ao adicionar elementos à coluna/vetor. Os índices podem ser aplicados com sucesso nas colunas das tabelas tanto na memória quanto no disco. Ao executar uma consulta QSQL, os índices são utilizados automaticamente, se possível. Em segundo lugar, o trabalho com dados históricos é feito através do mecanismo de mapeamento de arquivos do sistema operacional (memory map). Grandes tabelas nunca são carregadas na memória; em vez disso, as colunas necessárias são mapeadas diretamente na memória, e apenas a parte delas que é de fato necessária (ajudando nesse processo, entre outras coisas, estão os índices) é carregada. Para o programador, não há diferença se os dados estão na memória ou não, o mecanismo de trabalho com mmap é completamente oculto nas entranhas do Q.
O KDB+ é um banco de dados não relacional; as tabelas podem conter dados arbitrários, e a ordem das linhas na tabela não muda com a adição de novos elementos e pode e deve ser utilizada ao escrever consultas. Essa característica é crucial para trabalhar com séries temporais (dados de bolsas de valores, telemetria, logs de eventos), pois, se os dados estão ordenados por tempo, o usuário não precisa aplicar nenhum truque SQL para encontrar a primeira ou a última linha em termos de tempo na tabela, ou N linhas, ou determinar qual linha segue a N-ésima linha, e assim por diante. Além disso, os joins das tabelas são simplificados; por exemplo, encontrar a última cotação para 16.000 negociações da VOD.L (Vodafone) em uma tabela de 500 milhões de itens leva cerca de um segundo no disco e uma dezena de milissegundos na memória.
Um exemplo de join temporal — a tabela de cotações é mapeada na memória, portanto, não é necessário especificar VOD.L no where; o índice na coluna sym é usado implicitamente, assim como o fato de que os dados estão ordenados por tempo. Quase todos os joins no Q são funções comuns, e não parte da expressão select:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Por fim, vale a pena mencionar que os engenheiros da KX, começando pelo próprio Arthur Whitney, são realmente obcecados pela eficiência e fazem todo o possível para extrair o máximo das funcionalidades padrão do Q e otimizar os padrões de uso mais frequentes.
Resultado
KDB+ é popular entre as empresas, principalmente devido à sua excepcional versatilidade — serve igualmente bem como um banco de dados em memória e como um banco para armazenamento de terabytes de dados históricos, além de funcionar como uma plataforma para análise de dados. A velocidade de processamento é alta e há economia de recursos, pois o tratamento dos dados ocorre diretamente no banco de dados. Uma linguagem de programação completa, integrada às funções do banco, permite implementar em uma única plataforma todo o conjunto necessário de processos — desde a aquisição de dados até o processamento de solicitações dos usuários.
Informações adicionais
Desvantagens
Uma desvantagem significativa do KDB+/Q é a alta barreira de entrada. A linguagem possui uma sintaxe estranha, algumas funções são fortemente sobrecarregadas (o valor, por exemplo, possui cerca de 11 variantes de uso). O mais importante é que exige uma abordagem radicalmente diferente na escrita de programas. Na linguagem vetorial, é necessário pensar constantemente em termos de transformações de arrays, todas as iterações devem ser realizadas por meio de várias opções de funções map/reduce (que são chamadas de advérbios no Q), nunca tentando economizar substituindo operações vetoriais por operações atômicas. Por exemplo, para encontrar o índice da N-ésima ocorrência de um elemento em um array, deve-se escrever:
1. (where element=vector)[N]
embora isso pareça muito ineficiente segundo os padrões de C/Java (= cria um vetor booleano, onde retorna os índices dos elementos verdadeiros nele). No entanto, essa notação torna o sentido da expressão mais clara, e utiliza-se operações vetoriais rápidas em vez de atômicas lentas. A diferença conceitual entre uma linguagem vetorial e as demais é comparável à diferença entre os abordagens imperativas e funcionais na programação, e é preciso estar preparado para isso.
Alguns usuários também ficam insatisfeitos com o QSQL. A questão é que ele apenas se assemelha ao SQL verdadeiro. Na prática, é apenas um interpretador de expressões semelhantes ao SQL, que não suporta a otimização de consultas. O usuário deve escrever consultas otimizadas por conta própria, utilizando Q, algo para o qual muitos não estão preparados. Por outro lado, claro, é sempre possível escrever uma consulta otimizada por conta própria, sem depender de uma caixa-preta otimizadora.
Como ponto positivo, o livro sobre Q — Q For Mortals está disponível gratuitamente em , e lá também estão reunidos muitos outros materiais úteis.
Outro grande ponto negativo é o custo da licença. Isso pode chegar a dezenas de milhares de dólares por ano por um CPU. Apenas grandes empresas podem arcar com tais despesas. Recentemente, a KX tornou a política de licenciamento mais flexível e oferece a possibilidade de pagar apenas pelo tempo de uso ou alugar o KDB+ na nuvem do Google e da Amazon. Além disso, a KX oferece para download (versão de 32 bits ou 64 bits sob solicitação).
Concorrentes
Existem várias bases de dados especializadas construídas sobre princípios semelhantes — colunar, em memória, orientadas para grandes volumes de dados. O problema é que são especificamente bases de dados especializadas. Um exemplo marcante é o Clickhouse. Esta base de dados possui um princípio de armazenamento de dados em disco e construção de índice muito semelhante ao do KDB+, e realiza alguns tipos de consulta até mais rapidamente que o KDB+, embora não de forma significativa. Mas mesmo como base de dados, o Clickhouse é mais especializado que o KDB+ — análise web vs séries temporais arbitrárias (essa diferença é muito importante — por causa dela, por exemplo, no Clickhouse não há como utilizar a ordenação dos registros). Mas, o principal, é que o Clickhouse não possui a universalidade do KDB+, que é uma linguagem que permite processar dados diretamente na base, sem precisar carregá-los previamente em um aplicativo separado, construindo expressões SQL arbitrárias, aplicando funções arbitrárias nas consultas, criando processos não relacionados à execução de funções de uma base histórica. Portanto, é difícil comparar o KDB+ com outras bases de dados, elas podem ser melhores em cenários de uso específicos ou simplesmente melhores quando se trata de tarefas clássicas de bases de dados, mas não conheço outra ferramenta tão eficaz e universal para o processamento de dados temporais.
Integração com Python
Para facilitar o trabalho com KDB+ para pessoas que não estão familiarizadas com a tecnologia, a KX criou bibliotecas para uma integração estreita com Python dentro de um único processo. É possível chamar qualquer função Python a partir do Q, e vice-versa — chamar qualquer função Q a partir do Python (em particular expressões QSQL). As bibliotecas convertem os dados do formato de uma linguagem para o formato da outra conforme necessário (por eficiência, nem sempre). Em última análise, o Q e o Python vivem em um tão estreito simbiótico que as fronteiras entre eles se desfazem. Como resultado, o programador, de um lado, tem acesso completo a inúmeras bibliotecas úteis do Python, e, de outro lado, obtém uma base rápida integrada ao Python para trabalhar com grandes dados, o que é especialmente útil para quem está envolvido em aprendizado de máquina ou modelagem.
Trabalhando com Q no Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Links
Site da empresa —
Site para desenvolvedores —
Livro Q For Mortals (em inglês) —
Artigos sobre aplicações do KDB+/Q por funcionários da kx —
Fonte: habr.com
