

Então, você está coletando métricas. Assim como nós. Também coletamos métricas. Claro, as necessárias para o negócio. Hoje, falaremos sobre o primeiro elo do nosso sistema de monitoramento — um servidor de agregação compatível com statsd. , por que o escrevemos e por que abandonamos o brubeck.
A partir de nossos artigos anteriores (, ) você pode descobrir que, até certo tempo, coletávamos as etiquetas por meio de . Ele foi escrito em C. Do ponto de vista do código — simples como um palito (isso é importante quando você deseja contribuir) e, o mais importante, lida com nossos volumes de 2 milhões de métricas por segundo (MPS) no pico, sem grandes problemas. A documentação afirma o suporte a 4 milhões de MPS com um asterisco. Isso significa que você atingirá o número declarado se configurar corretamente a rede no Linux. (Não sabemos quantos MPS podem ser obtidos se a rede for deixada como está). Apesar dessas vantagens, tivemos algumas sérias reclamações sobre o brubeck.
Reclamação 1. Github — o desenvolvedor do projeto — parou de suportá-lo: publicar patches e correções, aceitar nossos e (não apenas nossos) PRs. Nos últimos meses (desde fevereiro-março de 2018) a atividade foi retomada, mas antes disso houve quase 2 anos de completo silêncio. Além disso, o projeto é desenvolvido , o que pode se tornar um sério obstáculo para a implementação de novas funcionalidades.
Reclamação 2. Precisão dos cálculos. O Brubeck coleta apenas 65536 valores para a agregação. No nosso caso, para algumas métricas, durante o período de agregação (30 seg), pode chegar muito mais valores (1.527.392 no pico). Como resultado dessa amostragem, os valores máximos e mínimos parecem inúteis. Por exemplo, assim:
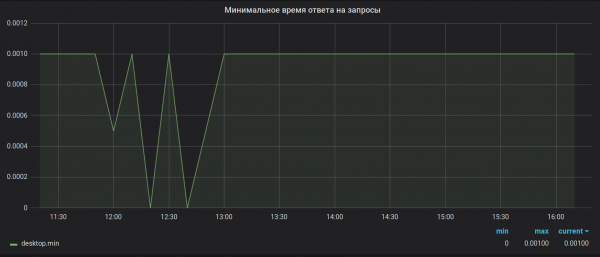
Como foi
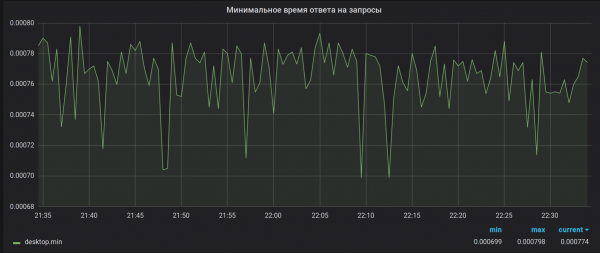
Como deveria ser
Pelo mesmo motivo, as somas são consideradas incorretas. Adicione a isso o bug de estouro do float de 32 bits, que envia o servidor para um segfault ao receber uma métrica que, à primeira vista, parece inofensiva, e a situação se torna ainda pior. O bug, a propósito, não foi corrigido.
E, finalmente, Reclamação X. No momento da redação deste artigo, estamos prontos para apresentá-lo a todas as 14 implementações funcionais do statsd que conseguimos encontrar. Vamos imaginar que uma infraestrutura específica cresceu tanto que aceitar 4 milhões de MPS já não é suficiente. Ou pode ser que ainda não tenha crescido, mas as métricas para você já são tão importantes que até mesmo breves falhas de 2 a 3 minutos nos gráficos podem se tornar críticas e provocar crises de depressão insuperáveis nos gerentes. Como tratar a depressão é uma tarefa ingrata, são necessárias soluções técnicas.
Em primeiro lugar, tolerância a falhas, para que um problema repentino no servidor não cause um apocalipse zumbi psiquiátrico no escritório. Em segundo lugar, escalabilidade, para que possamos aceitar mais de 4 milhões de MPS sem ter que aprofundar no stack de rede do Linux e possamos crescer "horizontalmente" para os tamanhos necessários.
Como tínhamos uma margem para escalabilidade, decidimos começar pela tolerância a falhas. "Oh! Tolerância a falhas! Isso é fácil, nós sabemos fazer isso", pensamos, e lançamos 2 servidores, levantando em cada um uma cópia do brubeck. Para isso, tivemos que copiar o tráfego com métricas para ambos os servidores e até mesmo escrever para isso . Este problema de tolerância a falhas foi resolvido, mas... não muito bem. No início, tudo parecia ótimo: cada brubeck coleta sua própria versão da agregação, escreve dados no Graphite a cada 30 segundos, sobrescrevendo o intervalo anterior (isso acontece do lado do Graphite). Se um servidor falhar, sempre temos o segundo com sua própria cópia dos dados agregados. Mas eis o problema: se um servidor falha, aparece uma "serra" nos gráficos. Isso ocorre porque os intervalos de 30 segundos do brubeck não estão sincronizados, e no momento da falha, um deles não é sobrescrito. No momento em que o segundo servidor é iniciado, o mesmo acontece. É bastante aceitável, mas gostaríamos de algo melhor! O problema da escalabilidade também não desapareceu. Todas as métricas ainda estão "voando" para um servidor único, e, portanto, estamos limitados aos mesmos 2 a 4 milhões de MPS, dependendo da capacidade da rede.
Se pensarmos um pouco sobre o problema e ao mesmo tempo cavarmos a neve com uma pá, pode nos ocorrer uma ideia óbvia: precisamos de um statsd que funcione em modo distribuído. Ou seja, um que implemente a sincronização entre nós em termos de tempo e métricas. "Claro, uma solução assim deve existir", dissemos nós e fomos pesquisar.... E nada encontramos. Após revisar a documentação de diferentes statsd ( até 11.12.2017), não encontramos nada. Aparentemente, nem os desenvolvedores nem os usuários dessas soluções ainda se depararam com UM NÚMERO TÃO GRANDE de métricas, caso contrário, eles teriam inventado algo.
E então nos lembramos do statsd "brinquedo" — bioyino, que escrevemos no hackathon apenas por diversão (o nome do projeto foi gerado por um script antes do início do hackathon) e percebemos que precisaríamos urgentemente do nosso próprio statsd. Por quê?
- porque no mundo há muito poucos clones de statsd,
- porque é possível garantir a confiabilidade e escalabilidade desejadas ou próximas ao desejado (incluindo a sincronização de métricas agregadas entre os servidores e resolver o problema de conflitos durante o envio),
- porque podemos contar as métricas com mais precisão do que o brubeck,
- porque podemos coletar estatísticas mais detalhadas, que o brubeck praticamente não nos fornecia,
- porque surgiu a chance de programar nosso próprio hyperperformancedistributedsystemapplication, que não irá repetir completamente a arquitetura de outro hyperperform... novamento bem-sucedido.
Em que escrever? Claro, em Rust. Por quê?
- porque já havia um protótipo da solução,
- porque o autor do artigo já sabia Rust e estava ansioso para escrever algo para produção com a possibilidade de disponibilizá-lo em open-source,
- porque linguagens com GC não são adequadas para a natureza do tráfego recebido (praticamente em tempo real) e as pausas do GC são praticamente inadmissíveis,
- porque precisamos de máxima performance, comparável ao C
- porque Rust nos fornece concorrência sem medo, e ao começar a escrever isso em C/C++, teríamos acumulado ainda mais vulnerabilidades, estouros de buffer, condições de corrida e outras palavras assustadoras.
Houve também um argumento contra o Rust. A empresa não tinha experiência na criação de projetos em Rust, e atualmente não planejamos usá-lo em nosso projeto principal. Portanto, havia sérias preocupações de que nada funcionaria, mas decidimos arriscar e tentar.
O tempo passou...
Finalmente, após várias tentativas sem sucesso, a primeira versão funcional estava pronta. O que conseguimos? Conseguimos algo assim.
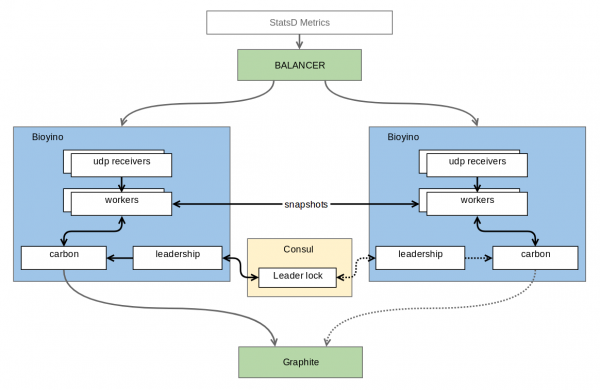
Cada nó recebe seu próprio conjunto de métricas e acumula-as, sem agregar métricas para aqueles tipos que exigiriam seu conjunto completo para a agregação final. Os nós estão conectados entre si por meio de um protocolo de bloqueio distribuído, que permite escolher entre eles aquele único (aqui choramos) que é digno de enviar métricas ao Grande. Neste momento, esse problema é resolvido por meio de , mas no futuro as ambições do autor se estendem até Raft, onde aquele digno será, claro, o nó-líder do consenso. Além do consenso, os nós costumam (por padrão, uma vez por segundo) enviar aos seus vizinhos as partes das métricas pré-agregadas que conseguiram coletar durante esse segundo. Assim, a escalabilidade e a resistência a falhas são mantidas - cada um dos nós ainda mantém seu conjunto completo de métricas, mas as métricas são enviadas já agregadas, via TCP e com codificação em um protocolo binário, portanto, os custos com duplicação em comparação ao UDP são significativamente reduzidos. Apesar da grande quantidade de métricas recebidas, a acumulação requer muito pouca memória e ainda menos CPU. Para nossas métricas bem comprimíveis, isso representa apenas algumas dezenas de megabytes de dados. Como bônus adicional, obtemos a ausência de regravações desnecessárias de dados no Graphite, como aconteceu com o burbeck.
Os pacotes UDP com métricas são distribuídos entre os nós no equipamento de rede através de um simples Round Robin. Naturalmente, o hardware de rede não analisa o conteúdo dos pacotes e, portanto, pode suportar muito mais do que 4M de pacotes por segundo, sem mencionar as métricas, sobre as quais não sabe nada. Considerando que as métricas não chegam uma por uma em cada pacote, não prevemos problemas de desempenho aqui. Em caso de queda do servidor, o dispositivo de rede detecta rapidamente (dentro de 1-2 segundos) esse fato e remove o servidor com problemas da rotação. Como resultado, é possível ativar e desativar nós passivos (ou seja, que não são líderes) quase sem notar quedas nos gráficos. O máximo que perdemos é uma parte das métricas recebidas no último segundo. A perda/desligamento/mudança repentina do líder ainda vai desenhar uma anomalia insignificante (o intervalo de 30 segundos ainda está desincronizado), mas, com a comunicação entre os nós, é possível minimizar esses problemas, por exemplo, enviando pacotes de sincronização.
Um pouco sobre a estrutura interna. O aplicativo, claro, é multithread, mas a arquitetura de threads é diferente da utilizada no brubeck. As threads em brubeck são idênticas - cada uma delas é responsável simultaneamente pela coleta de informações e pela agregação. No bioyino, as threads de trabalho (workers) são divididas em dois grupos: responsáveis pela rede e responsáveis pela agregação. Essa divisão permite gerenciar o aplicativo de maneira mais flexível, dependendo do tipo de métrica: onde é necessária uma agregação intensiva, podem ser adicionados mais agregadores, onde há muito tráfego de rede - aumentar o número de threads de rede. No momento, em nossos servidores, temos 8 threads de rede e 4 de agregação.
A parte responsável pela agregação é bastante monótona. Os buffers preenchidos com threads de rede são distribuídos entre as threads de contagem, onde são analisados e agregados. Medições são fornecidas sob demanda para envio para outros nós. Tudo isso, incluindo a transferência de dados entre os nós e a interação com o Consul, é executado de forma assíncrona e opera no framework .
O desenvolvimento da parte de rede responsável pela recepção das métricas gerou muito mais problemas. A principal tarefa de separar os fluxos de rede em entidades distintas era reduzir o tempo que o fluxo gastava não na leitura de dados do socket. As opções utilizando UDP assíncrono e o recvmsg normal foram rapidamente descartadas: a primeira consome muitos ciclos de CPU em espaço do usuário para processar eventos, a segunda exige muitas trocas de contexto. Portanto, atualmente é utilizado com buffers grandes (e, senhores oficiais, esses buffers não são algo trivial!). O suporte ao UDP normal é mantido para casos não críticos, onde o recvmmsg não é necessário. No modo multimensagem, conseguimos alcançar o principal objetivo: a grande maioria do tempo, o fluxo de rede está limpando a fila do sistema operacional — lendo dados do socket e transferindo-os para o buffer de espaço do usuário, apenas ocasionalmente mudando para entregar o buffer preenchido aos agregadores. A fila no socket praticamente não se acumula, e o número de pacotes descartados quase não cresce.
Nota
Nas configurações padrão, o tamanho do buffer é definido como suficientemente grande. Se você decidir testar o servidor por conta própria, pode perceber que após enviar uma pequena quantidade de métricas, elas não chegam ao Graphite, permanecendo no buffer do fluxo de rede. Para trabalhar com um número reduzido de métricas, é preciso definir valores menores para bufsize e task-queue-size no arquivo de configuração.
Por fim — alguns gráficos para os amantes de gráficos.
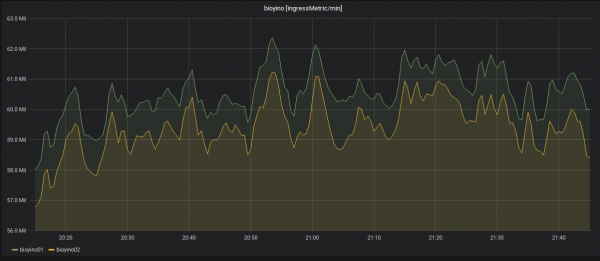
Estatísticas do número de métricas recebidas por servidor: mais de 2 milhões de MPS.
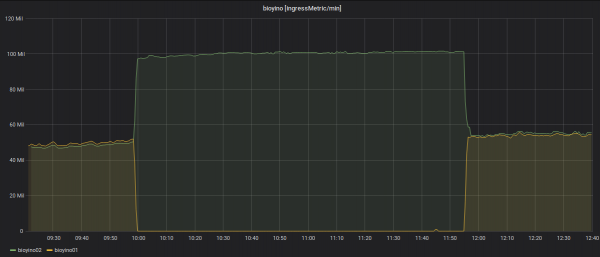
Desconexão de um dos nós e realocação das métricas recebidas.
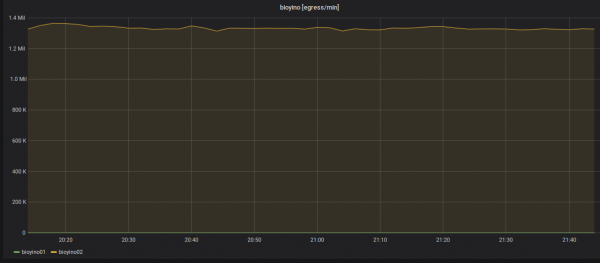
Estatísticas das métricas enviadas: sempre apenas um nó envia — o raidboss.
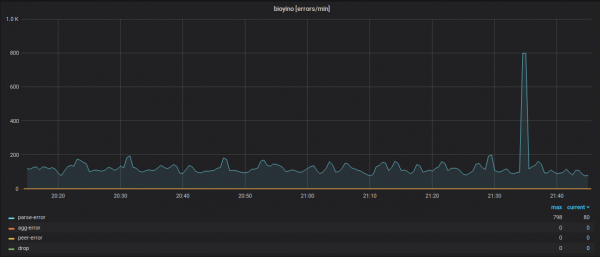
Estatísticas de operação de cada nó levando em conta os erros em vários módulos do sistema.
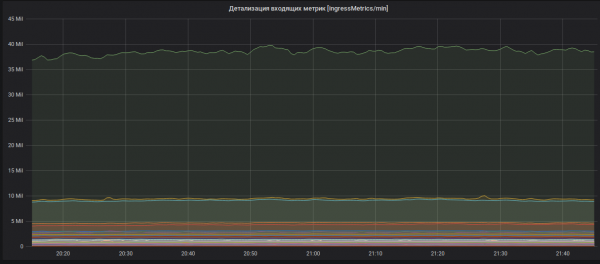
Detalhamento das métricas recebidas (nomes das métricas ocultados).
O que planejamos fazer com tudo isso a seguir? Claro, escrever código, bl…! O projeto foi inicialmente concebido como open-source e permanecerá assim durante toda a sua vida. Nos planos mais próximos — transição para uma versão própria do Raft, mudança do protocolo peer para um mais portável, adição de estatísticas internas adicionais, novos tipos de métricas, correção de erros e outras melhorias.
Claro, todos os que desejam ajudar no desenvolvimento do projeto são bem-vindos: criem PR, Issues, responderemos e ajustaremos sempre que possível, etc.
E, como se diz, that's all folks, comprem nossos elefantes!
Fonte: habr.com
