

No outono de 2019, ocorreu um evento tão esperado na equipe do iOS da Cloud Mail.ru. A principal base de dados para armazenamento persistente do estado do aplicativo tornou-se bastante exótica para o mundo móvel. (LMDB). Abaixo, oferecemos uma revisão detalhada em quatro partes. Primeiro, falaremos sobre as razões para essa escolha não trivial e difícil. Em seguida, analisaremos os três pilares da arquitetura do LMDB: arquivos mapeados na memória, B+-tree, e a abordagem copy-on-write para implementar transacionalidade e multiversionamento. Finalmente, para finalizar - uma parte prática. Nela, veremos como projetar e implementar um esquema de banco de dados com várias tabelas, incluindo uma tabela de índices.
Conteúdo
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivação para a implementação
Uma vez, em 2015, nos preocupamos em medir com que frequência a interface do nosso aplicativo apresentava lag. Fizemos isso não à toa. Começaram a aumentar as reclamações de que, às vezes, o aplicativo deixava de responder às ações do usuário: os botões não eram pressionados, as listas não rolavam, etc. Sobre a mecânica das medições, na AvitoTech, por isso aqui apresento apenas a ordem de grandeza.
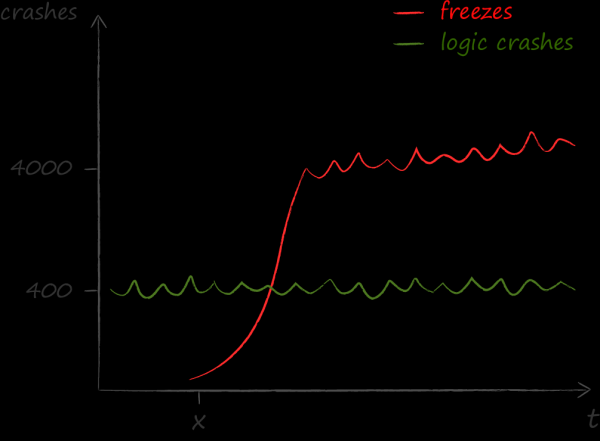
Os resultados das medições foram um balde de água fria para nós. Descobrimos que os problemas causados por travamentos eram muito mais numerosos do que quaisquer outros. Se antes dessa compreensão, o principal indicador técnico de qualidade era o 'crash free', depois, o foco para 'freeze free'.
Construímos e realizamos e de suas causas, e ficou claro quem era o principal inimigo — a lógica de negócios pesada, executada na thread principal do aplicativo. A reação natural a essa situação foi um ardente desejo de redistribuí-la em threads de trabalho. Para resolver essa tarefa de forma sistemática, recorremos a uma arquitetura multithreading com base em atores leves. Dediquei no Twitter coletivo e . No contexto da narrativa atual, quero destacar aqueles aspectos da solução que influenciaram a escolha do banco de dados.
O modelo de ator da organização do sistema pressupõe que a multithreading se torna sua segunda essência. Os objetos do modelo costumam cruzar as fronteiras das threads. E eles fazem isso não ocasionalmente e em alguns lugares, mas praticamente constantemente e em toda parte.
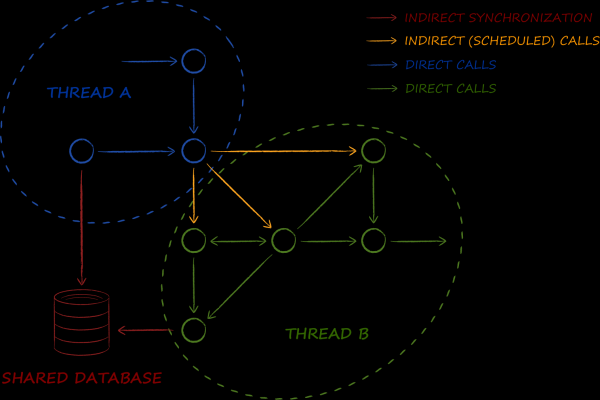
O banco de dados é um dos componentes fundamentais do esquema apresentado. Sua principal tarefa é implementar o macropadrão . Se no mundo empresarial ele é usado para organizar a sincronização de dados entre serviços, então, no caso da arquitetura de atores, é entre threads. Assim, precisávamos de um banco de dados cuja operação em um ambiente multithread não cause nem mesmo dificuldades mínimas. Em particular, isso significa que os objetos obtidos dele devem ser, no mínimo, seguros para threads e, idealmente, imutáveis. Como se sabe, os últimos podem ser usados simultaneamente por várias threads, sem recorrer a qualquer tipo de bloqueio, o que tem um impacto positivo no desempenho.
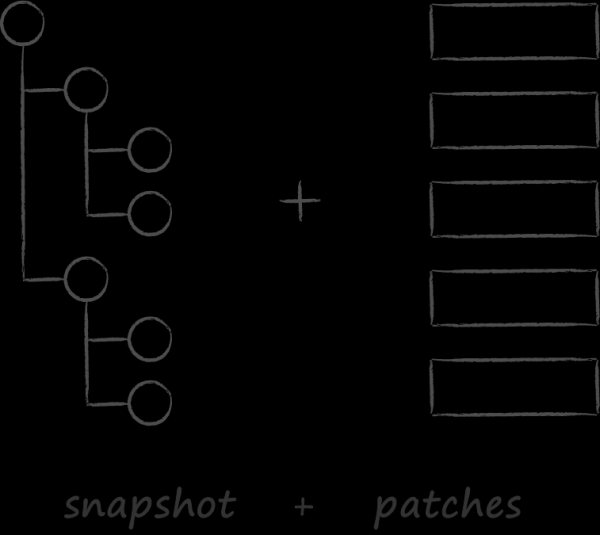 O segundo fator significativo que influenciou a escolha do banco de dados foi nossa API em nuvem. Ela foi inspirada na abordagem de sincronização adotada pelo git. Assim como ele, nós visamos , que para clientes em nuvem parece mais do que adequado. Supunhamos que eles descarregariam o estado completo da nuvem apenas uma vez e, em seguida, a sincronização ocorreria na esmagadora maioria dos casos por meio da aplicação de alterações. Infelizmente, essa possibilidade ainda está apenas na zona teórica, e na prática, os clientes não aprenderam a trabalhar com patches. Existem várias razões objetivas para isso, que, para não prolongar a introdução, deixaremos de lado. No entanto, agora o que nos interessa mais são as lições sobre o que acontece quando a API disse "A", e seu consumidor não disse "B".
Assim, se você imaginar o git, que ao executar o comando pull, em vez de aplicar patches a um snapshot local, compara seu estado completo com o estado completo do servidor, terá uma ideia bastante precisa de como ocorre a sincronização em clientes na nuvem. Não é difícil perceber que, para executar isso, é necessário alocar na memória duas árvores DOM com metainformações sobre todos os arquivos no servidor e localmente. Portanto, se o usuário armazena 500 mil arquivos na nuvem, para sua sincronização será necessário recriar e destruir duas árvores com 1 milhão de nós. E cada nó é um agregado que contém um gráfico de subobjetos. Nesse contexto, os resultados do perfilamento foram esperados. Ficou claro que, mesmo sem considerar a algoritmia de mesclagem, o próprio procedimento de criação e posterior destruição de uma grande quantidade de pequenos objetos gera custos. A situação se complica ainda mais pelo fato de que a operação básica de sincronização está incluída em uma grande variedade de cenários de uso. Assim, registramos o segundo critério importante na escolha de um banco de dados: a possibilidade de implementar operações CRUD sem alocação dinâmica de objetos.
Outros requisitos são mais tradicionais e sua lista completa é a seguinte.
- Segurança de thread.
- Multiprocessamento. Impulsionado pelo desejo de usar a mesma instância do banco de dados para sincronizar o estado não apenas entre threads, mas também entre o aplicativo principal e as extensões do iOS.
- A possibilidade de representar entidades armazenadas como objetos imutáveis.
- Ausência de alocações dinâmicas em operações CRUD.
- Suporte a transações com propriedades básicas : atomicidade, consistência, isolamento e durabilidade.
- Velocidade nos casos de uso mais populares.
Uma boa escolha com esse conjunto de requisitos era e ainda é o SQLite. No entanto, ao explorar alternativas, encontrei um livro . Sob a sua direção, foi escrito um benchmark comparando a velocidade de operação com diferentes bancos de dados no contexto de cenários de nuvem reais. O resultado superou as expectativas mais ousadas. Nos casos mais populares — obter um cursor para uma lista ordenada de todos os arquivos e uma lista ordenada de todos os arquivos para um diretório específico — o LMDB provou ser 10 vezes mais rápido que o SQLite. A escolha se tornou óbvia.
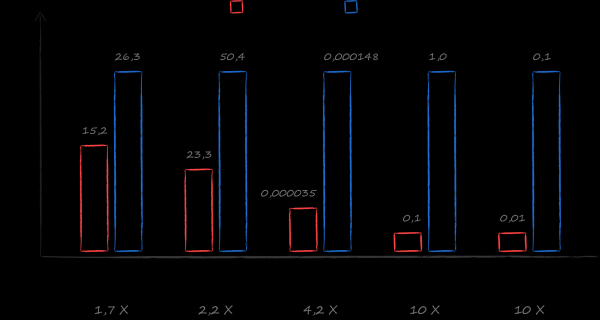
2. Posicionamento do LMDB
O LMDB é uma biblioteca muito pequena (apenas 10K linhas), que implementa a camada fundamental mais baixa do banco de dados — o armazenamento.
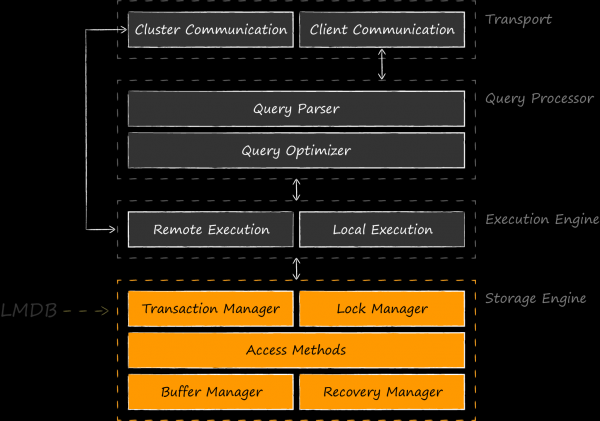
O esquema apresentado mostra que comparar o LMDB com o SQLite, que também implementa níveis mais altos, não é essencialmente mais correto do que comparar o SQLite com o Core Data. Como concorrentes à altura, seria mais justo propor motores de armazenamento semelhantes — BerkeleyDB, LevelDB, Sophia, RocksDB, entre outros. Existem até desenvolvimentos onde o LMDB atua como um componente de storage engine para o SQLite. O primeiro experimento desse tipo ocorreu em 2012. pelo autor do LMDB . , que se revelou tão intrigante que sua iniciativa foi abraçada por entusiastas OSS, e encontrou continuidade com . Em janeiro de 2020, o autor deste projeto, Den Shearer, apresentou-o no LinuxConfAu. A principal aplicação do LMDB se dá como motor para bancos de dados aplicacionais. Sua criação deve-se aos desenvolvedores
OpenLDAP btree «The Lightning Memory-mapped Database» yleo «O motor LMDB — um campeão especial» MDBX correções de bugs. .
optou por preferiu seu SQLite para armazenar índices.
O mecanismo ganhou destaque também no mundo do desenvolvimento móvel. As evidências de seu uso podem no cliente iOS do Telegram. O LinkedIn foi ainda mais longe e escolheu o LMDB como armazenamento padrão para o framework de cache de dados doméstico Rocket Data, como mencionado em seu artigo de 2016.
O LMDB luta com sucesso por um lugar ao sol no nicho deixado pelo BerkeleyDB após sua aquisição pela Oracle. A biblioteca é apreciada por sua velocidade e confiabilidade, mesmo em comparação com alternativas semelhantes. Como se sabe, não existem almoços grátis, e é importante destacar o trade-off que se deverá enfrentar ao escolher entre LMDB e SQLite. O diagrama acima ilustra claramente como a velocidade aprimorada é alcançada. Primeiro, não pagamos por camadas adicionais de abstração sobre o armazenamento em disco. É claro que, em uma boa arquitetura, não conseguimos evitar essas camadas, e elas inevitavelmente aparecerão no código do aplicativo, porém serão muito mais leves. Elas não incluirão funcionalidades que não são necessárias para o aplicativo específico, como suporte a consultas na linguagem SQL. Em segundo lugar, há a possibilidade de implementar de forma otimizada o mapeamento das operações de aplicativo em consultas para o armazenamento em disco. Se o SQLite parte das necessidades médias de um aplicativo médio, você, como desenvolvedor de aplicativo, está bem ciente dos principais cenários de carga. Uma solução mais eficiente terá um custo mais alto tanto para o desenvolvimento da solução inicial quanto para seu suporte posterior.
3. Os Três Pilares do LMDB
Olhando para o LMDB de uma perspectiva ampla, é hora de descer mais a fundo. As próximas três seções estarão dedicadas à análise dos principais pilares sobre os quais a arquitetura do armazenamento se sustenta:
- Arquivos mapeados na memória como um mecanismo de interação com o disco e sincronização de estruturas de dados internas.
- Árvore B+ como organização da estrutura dos dados armazenados.
- Copy-on-write como abordagem para garantir as propriedades ACID das transações e a múltipla versão.
3.1. Pilares nº 1. Arquivos mapeados na memória
Os arquivos mapeados em memória são um elemento arquitetônico tão importante que eles até aparecem no nome do armazenamento. Questões de cache e sincronização de acesso às informações armazenadas são inteiramente deixadas para o sistema operacional. O LMDB não contém nenhum cache. Esta é uma decisão consciente do autor, pois a leitura de dados diretamente dos arquivos mapeados permite cortar muitas arestas na implementação do mecanismo. Abaixo, apresento uma lista não exaustiva de alguns deles.
- Manter a consistência dos dados no armazenamento ao trabalhar com vários processos se torna responsabilidade do sistema operacional. Na próxima seção, essa mecânica será discutida em detalhes e com ilustrações.
- A ausência de caches livra completamente o LMDB dos custos relacionados a alocações dinâmicas. Ler dados na prática representa posicionar um ponteiro no endereço correto na memória virtual e nada mais. Pode parecer fantasia, mas no código-fonte do armazenamento, todas as chamadas a salloc estão concentradas na função de configuração do armazenamento.
- A ausência de caches também significa a ausência de bloqueios relacionados à sincronização de seu acesso. Leitores, que podem existir em quantidade arbitrária simultaneamente, não encontram nenhum mutex em seu caminho para os dados. Isso proporciona uma velocidade de leitura com escalabilidade linear ideal em relação ao número de CPUs. No LMDB, apenas as operações de modificação estão sujeitas à sincronização. Neste contexto, só pode haver um escritor por vez.
- O mínimo de lógica de cache e sincronização livra o código de erros extremamente complexos relacionados ao trabalho em um ambiente multithread. Na conferência Usenix OSDI 2014, houve duas pesquisas interessantes sobre bancos de dados: e . Delas, é possível extrair informações sobre a confiabilidade sem precedentes do LMDB, bem como sobre a implementação praticamente impecável das propriedades ACID das transações, que supera a mesma no SQLite.
- O minimalismo do LMDB permite que a representação de código em máquina seja totalmente armazenada no cache L1 do processador, resultando nas características de velocidade decorrentes disso.
Infelizmente, a situação no iOS com arquivos mapeados em memória não é tão favorável quanto gostaríamos. Para discutir as desvantagens associadas de maneira mais informada, é necessário lembrar os princípios gerais de implementação desse mecanismo nos sistemas operacionais.
Informações gerais sobre arquivos mapeados em memória
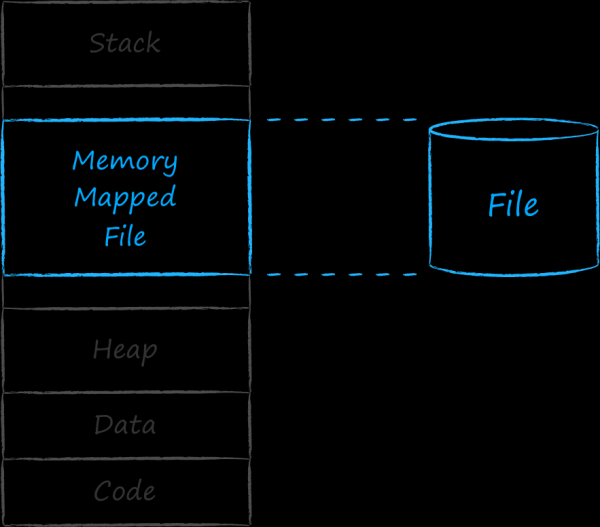 A cada aplicativo executável, o sistema operacional associa uma entidade chamada processo. Cada processo recebe um intervalo contínuo de endereços, onde coloca tudo o que precisa para funcionar. Nos endereços mais baixos, ficam as seções com código e dados e recursos codificados. Em seguida, há um bloco crescente de espaço de endereços dinâmico, bem conhecido por nós como heap. Nele, residem os endereços de entidades que surgem durante a execução do programa. No topo, há uma área de memória utilizada pela pilha do aplicativo. Esta cresce e encolhe, ou seja, seu tamanho também possui uma natureza dinâmica. Para que a pilha e o heap não se sobreponham e não se atrapalhem, eles são separados em extremidades diferentes do espaço de endereços. Entre as duas seções dinâmicas, na parte superior e inferior, existe um espaço vazio. Os endereços nesta seção intermediária são utilizados pelo sistema operacional para associar as mais diversas entidades ao processo. Em particular, ele pode associar um conjunto contínuo de endereços a um arquivo no disco. Esse arquivo é chamado de mapeado em memória.
O espaço de endereços alocado ao processo é enorme. Teoricamente, a quantidade de endereços é limitada apenas pelo tamanho do ponteiro, que é determinado pela arquitetura do sistema. Se a memória física fosse mapeada 1 a 1, o primeiro processo consumiria toda a RAM, e a multitarefa não poderia ser considerada.
No entanto, pela nossa experiência, sabemos que os sistemas operacionais modernos podem executar simultaneamente quantos processos forem necessários. Isso é possível porque eles apenas alocam memória para os processos no papel, enquanto na prática carregam na memória física apenas a parte que é exigida aqui e agora. Portanto, a memória associada ao processo é chamada de virtual.
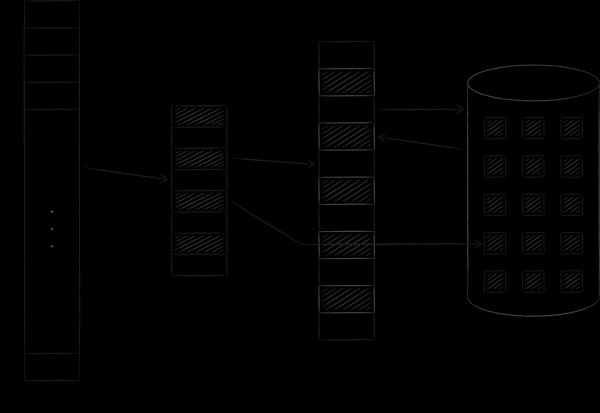
O sistema operacional organiza a memória virtual e física em páginas de tamanho definido. Assim que uma determinada página da memória virtual é solicitada, o sistema operacional a carrega para a memória física e estabelece a correspondência entre elas em uma tabela especial. Se não houver espaços livres, uma das páginas previamente carregadas é copiada para o disco e a solicitada ocupa seu lugar. Este procedimento, ao qual voltaremos em breve, é chamado de swapping. A figura abaixo ilustra o processo descrito. Nela, a página A com o endereço 0 foi carregada e alocada na página da memória principal com o endereço 4. Esse fato foi refletido na tabela de correspondências na célula número 0.
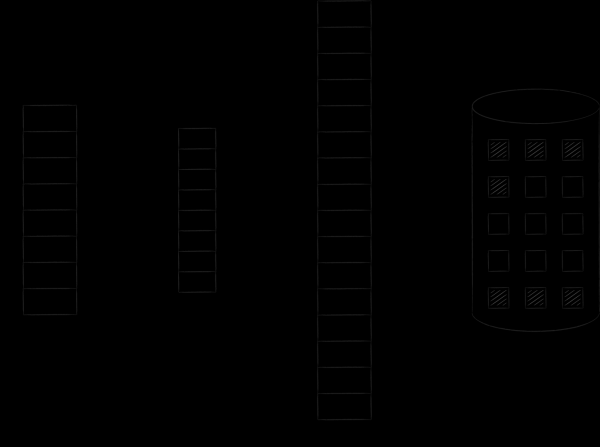
A história dos arquivos exibidos na memória é exatamente a mesma. Logicamente, eles supostamente estão continuamente e totalmente alocados no espaço de endereços virtuais. Contudo, na memória física, eles entram página por página e apenas sob demanda. As modificações dessas páginas são sincronizadas com o arquivo no disco. Assim, é possível realizar a entrada/saída de arquivos, simplesmente trabalhando com bytes na memória — todas as alterações serão automaticamente transferidas pelo núcleo do sistema operacional para o arquivo original.
A imagem abaixo demonstra como o LMDB sincroniza seu estado ao trabalhar com um banco de dados a partir de diferentes processos. Mapeando a memória virtual de diferentes processos em um mesmo arquivo, na prática, obrigamos o sistema operacional a sincronizar transitivamente certos blocos de seus espaços de endereços, que são observados pelo LMDB.
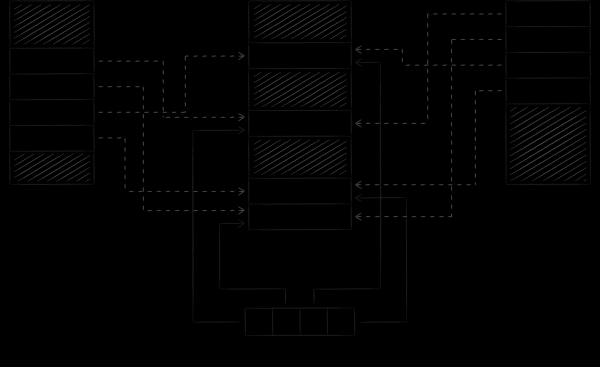
Um detalhe importante é que o LMDB, por padrão, modifica o arquivo de dados através do mecanismo de chamada de sistema write, enquanto o próprio arquivo é mapeado em modo somente leitura. Essa abordagem tem duas consequências importantes.
A primeira consequência é comum a todos os sistemas operacionais. Sua essência está na adição de proteção contra danos acidentais ao banco de dados causados por código incorreto. Como sabemos, as instruções executáveis de um processo têm liberdade para acessar dados de qualquer lugar em seu espaço de endereçamento. Ao mesmo tempo, como acabamos de lembrar, mapear um arquivo no modo de leitura e gravação significa que qualquer instrução pode também modificá-lo. Se isso ocorrer por engano, tentando, por exemplo, sobrescrever um elemento de um array usando um índice inexistente, ela pode acidentalmente alterar o arquivo mapeado para esse endereço, resultando em corrupção do banco de dados. Se o arquivo estiver mapeado em modo somente leitura, a tentativa de modificar o espaço de endereçamento correspondente resultará em uma falha do programa com um sinal. SIGSEGV, e o arquivo permanecerá íntegro.
A segunda consequência é especificamente para iOS. Nem o autor, nem quaisquer outras fontes mencionam isso explicitamente, mas sem ela, o LMDB não seria utilizável neste sistema operacional móvel. A próxima seção é dedicada a sua discussão.
Especificidade dos arquivos mapeados em memória no iOS
Em 2018, na WWDC, houve uma apresentação notável . Nele, é explicado que, no iOS, todas as páginas em memória física pertencem a um dos 3 tipos: dirty, compressed e clean.
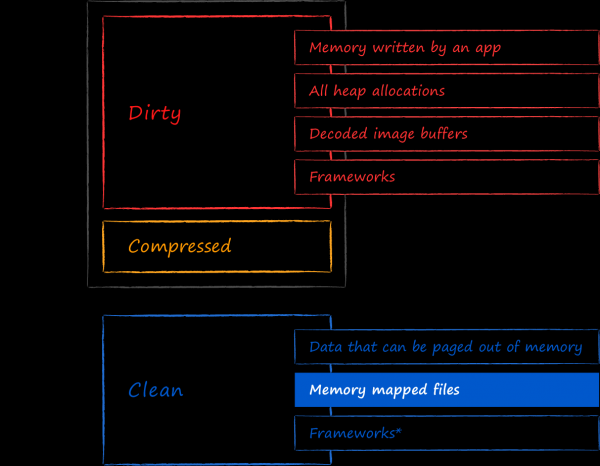
Memória limpa é o conjunto de páginas que podem ser descarregadas da memória física sem dor. Os dados contidos nelas podem ser recarregados, se necessário, de suas fontes originais. Arquivos mapeados em memória como somente leitura se enquadram nesta categoria. O iOS não tem medo de descarregar a qualquer momento páginas mapeadas para arquivos da memória, uma vez que estão garantidamente sincronizadas com os arquivos no disco.
Na memória suja, entram todas as páginas modificadas, independentemente de onde estavam originalmente. Em particular, arquivos mapeados em memória que foram alterados através de gravação na memória virtual associada a eles serão classificados dessa forma. Ao abrir o LMDB com a flag MDB_WRITEMAP, após fazer alterações, isso pode ser verificado pessoalmente.
Assim que o aplicativo começa a ocupar muita memória física, o iOS sujeita suas páginas dirty à compressão. A soma da memória ocupada pelas páginas dirty e comprimidas constitui a chamada memória footprint do aplicativo. Ao atingir um certo valor limite, o demônio do sistema OOM killer intervém e força o encerramento do processo. Essa é uma particularidade do iOS em comparação com sistemas operacionais de desktop. Ao contrário deles, a redução da memória footprint por meio de swap de páginas da memória física para o disco não é prevista no iOS. As razões para isso são apenas especulativas. Talvez o processo intensivo de mover páginas para o disco e de volta seja muito dispendioso em termos de energia para dispositivos móveis, ou o iOS economiza recursos de regravação de células em discos SSD, ou talvez os projetistas não estivessem satisfeitos com o desempenho geral do sistema, onde tudo fica constantemente trocando. De qualquer forma, o fato permanece.
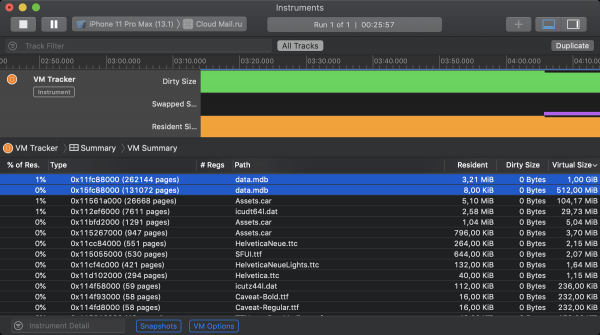
A boa notícia, já mencionada anteriormente, é que o LMDB, por padrão, não utiliza o mecanismo mmap para atualizar arquivos. Isso significa que os dados mapeados são classificados pelo iOS como memória limpa e não contribuem para a memória footprint. Isso pode ser confirmado com a ferramenta Xcode chamada VM Tracker. Na captura de tela abaixo, está exibido o estado da memória virtual do aplicativo Nuvem do iOS durante a operação. No início, foram inicializados 2 instâncias do LMDB. A primeira teve permissão para mapear seu arquivo em 1GiB de memória virtual, enquanto a segunda teve 512MiB. Apesar de ambos os repositórios ocuparem um determinado volume de memória residente, nenhum deles contribui para o tamanho dirty.
E agora é hora das más notícias. Devido ao mecanismo de swap em sistemas operacionais de desktop de 64 bits, cada processo pode ocupar tanto espaço de endereço virtual quanto permitir o espaço livre no disco rígido para seu potencial swap. A substituição do swapping pela compressão no iOS reduz radicalmente o máximo teórico. Agora todos os processos ativos precisam caber na memória principal (ou seja, RAM), e todos os que não couberem estão sujeitos a encerramento forçado. Isso é afirmado tanto na seção mencionada acima , quanto em . Como consequência, o iOS limita rigidamente o tamanho da memória disponível para alocação por mmap. Aqui está É possível observar os limites empíricos dos volumes de memória que conseguiram ser alocados em diferentes dispositivos com a ajuda dessa chamada de sistema. Nos modelos mais modernos de smartphones iOS, foram disponibilizados 2 gigabytes, enquanto nas versões mais avançadas do iPad, foram 4. Na prática, claro, é necessário se basear nos modelos mais antigos suportados, onde a situação é bem mais preocupante. Pior ainda, ao olhar o estado da memória do aplicativo no VM Tracker, pode-se descobrir que o LMDB não é o único que compete pela memória mapeada. Boas fatias são consumidas por alocadores de sistema, arquivos de recursos, frameworks para trabalhar com imagens e outros predadores menores.
Após os experimentos na Nuvem, chegamos aos seguintes valores de compromisso para a memória alocada do LMDB: 384 megabytes para dispositivos de 32 bits e 768 para dispositivos de 64 bits. Após consumida essa quantidade, qualquer operação modificadora começa a ser encerrada com o código MDB_MAP_FULL. Esses erros são observados em nosso monitoramento, mas são relativamente poucos a ponto de podermos ignorá-los neste estágio.
Uma razão não óbvia para o consumo excessivo de memória pelo armazenamento pode ser transações de longa duração. Para entender como esses dois fenômenos estão relacionados, vamos considerar os outros dois pilares do LMDB.
3.2. Pilar nº 2. Árvore B+-
Para emular tabelas sobre um armazenamento key-value, é necessário que sua API possua as seguintes operações:
- Inserção de um novo elemento.
- Busca de um elemento com uma chave específica.
- Remoção de um elemento.
- Iteração sobre intervalos de chaves em ordem de classificação.
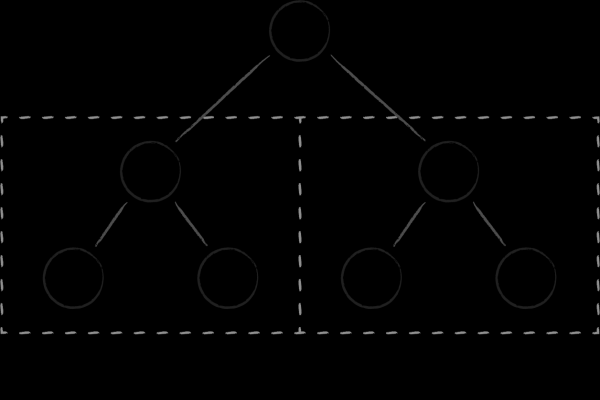 A estrutura de dados mais simples que permite facilmente implementar todas as quatro operações é a árvore de busca binária. Cada nó representa uma chave, dividindo todo o subconjunto de chaves filhas em duas subárvores. À esquerda estão aquelas que são menores que a chave do pai, e à direita, as que são maiores. A obtenção de um conjunto ordenado de chaves é alcançada por meio de uma das travessias clássicas da árvore.
As árvores binárias têm duas desvantagens fundamentais que impedem sua eficácia como estruturas de dados em disco. Em primeiro lugar, o grau de equilíbrio delas é imprevisível. Há um risco considerável de obter árvores nas quais a altura dos diferentes ramos pode variar bastante, o que deteriora significativamente a complexidade algorítmica da busca em comparação com o esperado. Em segundo lugar, a abundância de referências cruzadas entre os nós prejudica a localidade na memória. Nós próximos (em termos de conexões entre eles) podem estar em páginas completamente diferentes na memória virtual. Como consequência, mesmo para uma simples travessia de alguns nós adjacentes na árvore, pode ser necessário acessar um número comparável de páginas. Isso é um problema mesmo quando discutimos a eficiência das árvores binárias como estruturas de dados em memória, já que a rotação constante de páginas no cache do processador não é barata. Quando se trata de uma elevação frequente das páginas relacionadas aos nós a partir do disco, a situação torna-se ainda mais .
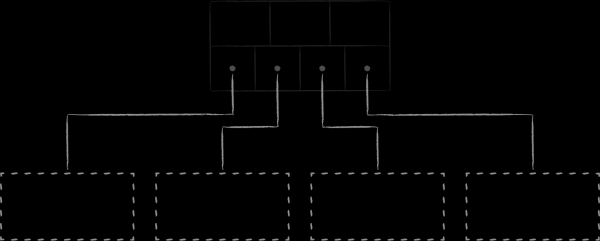 As B-árvores, sendo uma evolução das árvores binárias, resolvem os problemas mencionados no parágrafo anterior. Primeiro, elas são auto-balanceáveis. Em segundo lugar, cada nó divide um conjunto de chaves filhas não em 2, mas em M subconjuntos ordenados, sendo que o número M pode ser bastante grande, na ordem de centenas ou até milhares.
Como resultado:
- Em cada nó há uma grande quantidade de chaves já ordenadas, resultando em árvores muito rasas.
- A árvore adquire a propriedade de localidade de colocação na memória, uma vez que chaves próximas em valor se localizam naturalmente próximas umas das outras em um ou nos nós vizinhos.
- A quantidade de nós transitórios diminui ao descer pela árvore durante a operação de busca.
- A quantidade de nós alvo lidos diminui em consultas range, pois cada um deles já contém uma grande quantidade de chaves ordenadas.
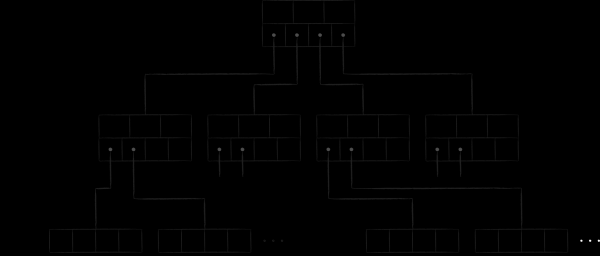
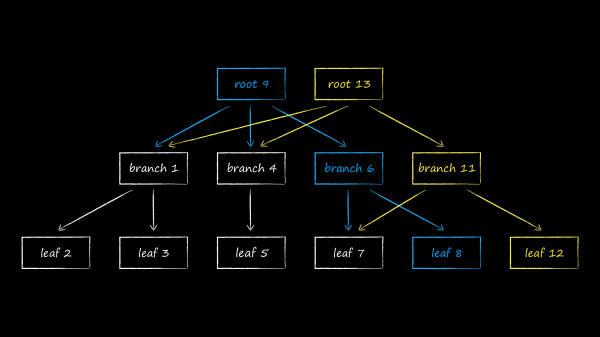
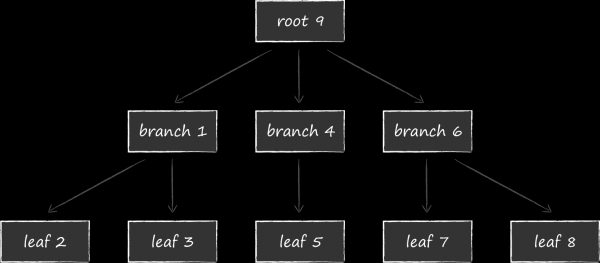
No LMDB, para o armazenamento de dados, é utilizada uma das variações da B-árvore chamada B+-árvore. No diagrama acima estão representados três tipos de nós que podem existir nela:
- No topo está a raiz (root). Ela materializa nada menos que o conceito de banco de dados dentro do armazenamento. Dentro de uma instância do LMDB, é possível criar vários bancos de dados, compartilhando entre si o espaço de endereço virtual mapeado. Cada um deles começa com sua própria raiz.
- No nível mais baixo, estão as folhas (leaf). Somente elas contêm os pares chave-valor armazenados no banco de dados. Vale ressaltar que essa é a peculiaridade das árvores B+-árvores. Enquanto uma árvore B convencional armazena partes de valor nos nós de todos os níveis, a variação B+ faz isso apenas no nível mais baixo. Com isso em mente, vamos nos referir ao subtipo da árvore utilizada no LMDB simplesmente como árvore B.
- Entre a raiz e as folhas, há 0 ou mais níveis técnicos com nós de navegação (branch). A função deles é dividir o conjunto ordenado de chaves entre as folhas.
Fisicamente, os nós são blocos de memória de comprimento predefinido. Seu tamanho é múltiplo do tamanho das páginas de memória no sistema operacional, como mencionamos anteriormente. Abaixo está a estrutura do nó. No cabeçalho, há metainformações, a mais óbvia delas para este exemplo sendo a soma de verificação. Em seguida, vem a informação sobre os deslocamentos que indicam onde estão as células com dados. Os dados podem ser chaves, se estivermos falando sobre nós de navegação, ou pares chave-valor completos no caso das folhas. Mais detalhes sobre a estrutura das páginas podem ser encontrados no trabalho .
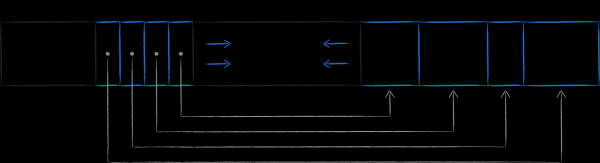
Depois de compreender o conteúdo interno dos nós-páginas, a árvore B do LMDB será representada de forma simplificada da seguinte maneira.
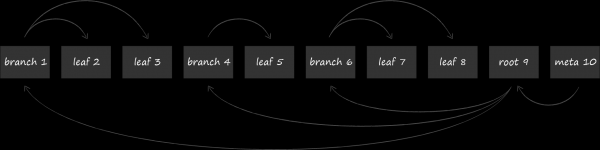
As páginas com nós são organizadas sequencialmente no disco. Páginas com números maiores estão mais próximas do final do arquivo. A chamada página meta (meta page) contém informações sobre os deslocamentos que permitem encontrar as raízes de todas as árvores. Ao abrir um arquivo, o LMDB escaneia a página do final para o começo em busca de uma página meta válida, e através dela encontra os bancos de dados existentes.
Agora, tendo uma compreensão da estrutura lógica e física da organização dos dados, podemos passar para a discussão do terceiro pilar do LMDB. É por meio dele que todas as modificações no armazenamento ocorrem de forma transacional e isolada umas das outras, conferindo à base de dados um atributo de multi-versionamento.
3.3. Pilar Nº 3. Copy-on-write
Algumas operações com as árvores B pressupõem a realização de uma série de mudanças em seus nós. Um exemplo disso é a adição de uma nova chave a um nó que já alcançou a máxima capacidade. Nesse caso, é necessário, em primeiro lugar, dividir o nó em dois, e em segundo lugar, adicionar uma referência ao novo nó filho desmembrado em seu pai. Este procedimento é potencialmente muito perigoso. Se, por qualquer motivo (falha, falta de energia, etc.), apenas parte das mudanças da série for realizada, a árvore ficará em um estado inconsistente.
Uma das soluções tradicionais para garantir que uma base de dados seja resistente a falhas é a adição, junto à árvore B, de uma estrutura de dados em disco adicional — o log de transações, conhecido também como write-ahead log (WAL). Ele é um arquivo em que, antes de qualquer modificação à própria árvore B, a operação prevista é registrada. Assim, se durante a auto-diagnose for detectada corrupção de dados, a base de dados consulta o log para se corrigir.
O LMDB escolheu um método diferente para garantir resistência a falhas, chamado copy-on-write. Sua essência é que, em vez de atualizar os dados numa página existente, ela primeiro copia completamente essa página e realiza todas as modificações na cópia.
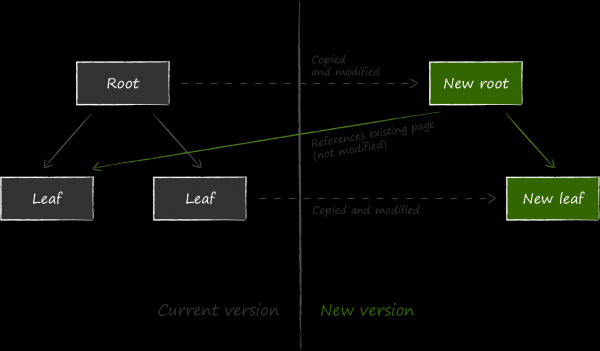
Em seguida, para que os dados atualizados sejam acessíveis, é necessário alterar a referência para o nó agora atualizado no nó pai relativo a ele. Como isso também requer modificação, ele também é copiado previamente. O processo continua de forma recursiva até a raiz. Por fim, os dados na página de meta são alterados.
Se durante o procedimento de atualização ocorrer uma interrupção inesperada do processo, uma nova meta-página poderá não ser criada ou não será gravada no disco até o final, resultando em uma soma de verificação incorreta. Em ambos os casos, as novas páginas serão inacessíveis, enquanto as antigas não serão afetadas. Isso isenta o LMDB da necessidade de manter um write ahead log para garantir a consistência dos dados. A estrutura de armazenamento de dados no disco descrita acima também cumpre essa função. A ausência de um log de transações explícito é uma das características do LMDB que proporciona alta velocidade de leitura dos dados.
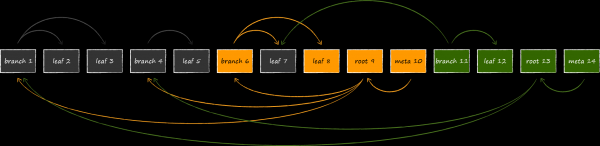
A estrutura resultante chamada B-tree somente para anexação garante naturalmente a isolação de transações e a multiversionamento. No LMDB, cada transação aberta é associada ao nó raiz da árvore mais atual. Enquanto a transação não for concluída, as páginas da árvore associada nunca serão alteradas ou reutilizadas para novas versões de dados. Assim, é possível trabalhar indefinidamente com o mesmo conjunto de dados que era relevante no momento da abertura da transação, mesmo que o armazenamento continue a ser ativamente atualizado. É isso que caracteriza o multiversionamento, tornando o LMDB uma fonte ideal de dados para todos nós. UICollectionViewAo abrir uma transação, não é necessário aumentar o consumo de memória do aplicativo, correndo para buscar dados relevantes em alguma estrutura in-memory, com medo de ficar na pior. Essa característica diferencia positivamente o LMDB do SQLite, que não pode se gabar de tal isolação total. Ao abrir duas transações no último e remover um registro em uma delas, esse mesmo registro não poderá ser acessado na segunda transação restante.
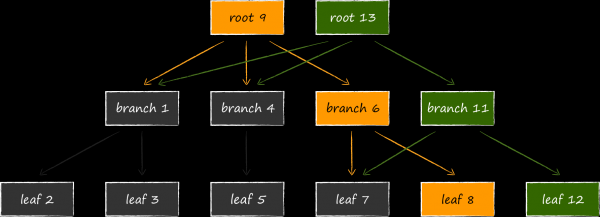
O lado oposto da moeda é o potencialmente muito maior consumo de memória virtual. O slide ilustra como será a estrutura do banco de dados se ocorrer a modificação simultânea com 3 transações abertas de leitura, observando diferentes versões do banco de dados. Como o LMDB não pode reutilizar nós acessíveis a partir das raízes associadas às transações ativas, o armazenamento não tem escolha a não ser alocar na memória uma quarta raiz e, mais uma vez, clonar as páginas modificáveis sob ela.
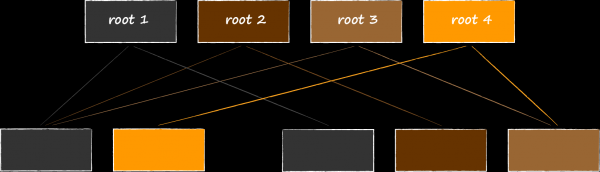
Aqui não seria demais lembrar da seção sobre arquivos mapeados em memória. Embora o consumo adicional de memória virtual não deva nos preocupar muito, já que não contribui para a pegada de memória da aplicação, foi observado que o iOS é bastante econômico na alocação dela, e não podemos, como no servidor ou desktop, simplesmente fornecer ao LMDB uma região de 1 terabyte sem considerar essa particularidade. Sempre que possível, devemos tentar manter o tempo de vida das transações o mais curto possível.
4. Projetando o esquema de dados sobre a API key-value
Começaremos a análise da API examinando as abstrações básicas fornecidas pelo LMDB: ambiente e bancos de dados, chaves e valores, transações e cursores.
Nota sobre listagens de código
Todas as funções na API pública do LMDB retornam o resultado do seu trabalho na forma de um código de erro, mas em todas as listagens subsequentes essa verificação foi omitida em prol da concisão. Na prática, usamos nosso Wrapper C++ , onde os erros se materializam na forma de exceções C++.
Como a forma mais rápida de integrar o LMDB em um projeto para iOS ou macOS, sugiro meu CocoaPod .
4.1. Abstrações básicas
Ambiente (environment)
Estrutura MDB_env é o repositório do estado interno do LMDB. A família de funções com o prefixo mdb_env permite configurar algumas de suas propriedades. No caso mais simples, a inicialização do motor é feita da seguinte forma.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);No aplicativo Cloud Mail.ru, alteramos os valores padrão apenas de dois parâmetros.
O primeiro deles é o tamanho do espaço de endereços virtuais no qual o arquivo de armazenamento é mapeado. Infelizmente, mesmo em um mesmo dispositivo, o valor específico pode variar significativamente de uma execução para outra. Para levar em conta essa particularidade do iOS, o tamanho máximo do armazenamento é ajustado dinamicamente. Começando de um certo valor, ele é sucessivamente reduzido pela metade até que a função mdb_env_open retorne um resultado diferente de ENOMEM. Teoricamente, existe um caminho oposto — primeiro alocar um mínimo de memória para o mecanismo e, então, ao receber erros MDB_MAP_FULL, aumentá-la. No entanto, esse caminho é muito mais complicado. A razão é que o procedimento de realocação de memória (remap) através da função mdb_env_set_map_size invalida todas as entidades (cursors, transactions, keys e values) obtidas do mecanismo anteriormente. Considerar essa mudança de eventos no código tornará sua implementação significativamente mais complexa. Se, no entanto, a memória virtual é muito valiosa para você, pode ser um motivo para observar o fork que foi muito adiante , onde entre as funcionalidades declaradas está o "ajuste automático do tamanho do banco de dados em tempo real".
O segundo parâmetro, cujo valor padrão não nos serviu, regula a mecânica de garantia de segurança de threads. Infelizmente, pelo menos no iOS 10, existem problemas com o suporte ao armazenamento local de threads. Por causa disso, no exemplo acima, o armazenamento é aberto com a flag MDB_NOTLS. Além disso, foi necessário também da wrapper em C++ , para remover variáveis com esse atributo dela.
Bancos de dados
O banco de dados representa uma instância separada de uma Árvore B, sobre a qual falamos acima. Sua abertura ocorre dentro de uma transação, o que inicialmente pode parecer um pouco estranho.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);De fato, uma transação no LMDB é uma entidade de armazenamento, e não de um banco de dados específico. Essa concepção permite operações atômicas sobre entidades localizadas em diferentes bancos de dados. Teoricamente, isso abre a possibilidade de modelar tabelas na forma de diferentes bancos, mas eu, na época, segui um caminho diferente, que está detalhado abaixo.
Chaves e valores
Estrutura MDB_val modela um conceito de chave e valor. O armazenamento não tem a menor ideia sobre sua semântica. Para ele, uma coisa ou outra é apenas um array de bytes de tamanho definido. O tamanho máximo da chave é 512 bytes.
typedef struct MDB_val {
    size_t mv_size;
    void *mv_data;
} MDB_val;
Usando um comparador, o armazenamento ordena as chaves em ordem crescente. Se não for substituído por um próprio, o padrão será utilizado, que as classifica byte a byte em ordem lexicográfica.
Transações
O sistema de transações é descrito em detalhes na , por isso aqui repito brevemente suas principais características:
- Suporte a todas as propriedades básicas : atomicidade, consistência, isolamento e durabilidade. Não posso deixar de notar que, na parte de durabilidade, há um bug no macOS e iOS que foi corrigido no MDBX. Você pode ler mais em sua .
- A abordagem para multithreading é descrita como "um único escritor / múltiplos leitores". Os escritores se bloqueiam entre si, mas não bloqueiam os leitores. Os leitores não bloqueiam nem os escritores, nem uns aos outros.
- Suporte a transações aninhadas.
- Suporte a multiversionamento.
O multiversionamento no LMDB é tão bom que quero demonstrá-lo em ação. No código abaixo, é visível que cada transação trabalha exatamente com a versão do banco de dados que estava atual em sua abertura, sendo completamente isolada de todas as alterações subsequentes. A inicialização do armazenamento e a adição de um registro de teste não apresentam nada de interessante, por isso esses rituais foram deixados em spoiler.
Adicionando um registro de teste
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Abrindo 2 transações, cada uma delas observando
// a versão do banco de dados com um único registro.
mdb_txn_begin(env, NULL, 0, &txn1); // leitura-escrita
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // somente leitura
// Dentro da primeira transação, removemos o registro existente do banco de dados.
mdb_del(txn1, dbi, &key, NULL);
// Confirmamos a exclusão.
mdb_txn_commit(txn1);
// Abrindo a terceira transação, que observa a
// versão atual do banco de dados, onde o registro já não existe.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Verificamos se o registro com a chave procurada já não existe.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Finalizamos a transação.
mdb_txn_abort(txn3);
// Verificamos se na segunda transação, aberta no momento
// da existência do registro no banco de dados, ele ainda pode ser encontrado pela chave.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Checamos se a chave retornou dados válidos, e não qualquer lixo.
assert(*(int *)val.mv_data == 997);
// Finalizamos a transação, que opera com uma base de dados
// desatualizada, mas consistente.
mdb_txn_abort(txn2);Recomendo opcionalmente tentar fazer um truque semelhante com SQLite e ver o que acontece.
A multiversão traz benefícios muito agradáveis para a vida do desenvolvedor iOS. Com esse recurso, é possível regular facilmente e de maneira descontraída a velocidade de atualização da fonte de dados para formulários na tela, levando em conta a experiência do usuário. Por exemplo, vamos considerar um recurso do aplicativo Mail.ru Cloud de carregamento automático de conteúdo da galeria de mídia do sistema. Com uma boa conexão, o cliente pode enviar várias fotos ao servidor por segundo. Se, após cada upload, atualizarmos UICollectionView o conteúdo de mídia na nuvem do usuário, podemos esquecer os 60 fps e o scroll suave durante esse processo. Para evitar atualizações de tela frequentes, é necessário limitar de alguma forma a velocidade de alteração dos dados na base UICollectionViewDataSource.
Se a base de dados não suporta multi-versionamento e permite trabalhar apenas com o estado atual, para criar um instantâneo estável no tempo dos dados, é necessário fazer uma cópia dele em alguma estrutura de dados in-memory ou em uma tabela temporária. Qualquer uma dessas abordagens é bastante onerosa. No caso de um armazenamento in-memory, temos despesas tanto de memória, geradas pelo armazenamento de objetos construídos, quanto de tempo, relacionadas a transformações ORM excessivas. Quanto à tabela temporária, isso é um prazer ainda mais caro, que só faz sentido em casos não triviais.
O multi-versionamento do LMDB resolve a questão de manter uma fonte de dados estável de forma muito elegante. Basta abrir uma transação e voilà - enquanto não a finalizarmos, o conjunto de dados está garantidamente fixo. A lógica da velocidade de sua atualização agora está completamente nas mãos da camada de apresentação, sem despesas significativas de recursos.
Cursori
Cursori fornecem um mecanismo para a iteração ordenada sobre pares chave-valor através da travessia de uma árvore B. Sem eles, seria impossível modelar eficientemente tabelas em um banco de dados, que é o que iremos abordar.
4.2. Modelagem de Tabelas
A propriedade de ordenação das chaves permite construir, sobre abstrações básicas, algo de alto nível como uma tabela. Vamos considerar esse processo usando como exemplo a tabela principal de um cliente na nuvem, onde estão armazenadas as informações sobre todos os arquivos e pastas do usuário.
Esquema da Tabela
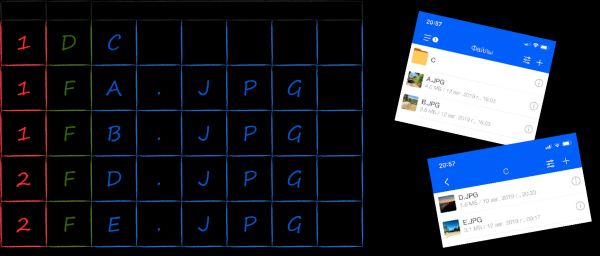
Um dos cenários comuns para os quais a estrutura da tabela com uma árvore de pastas deve ser otimizada é a extração de todos os elementos localizados dentro de um diretório específico. Um bom modelo de organização de dados para consultas eficientes desse tipo é . Para sua implementação sobre um armazenamento chave-valor, é necessário ordenar as chaves de arquivos e pastas de forma que elas sejam agrupadas com base na pertença ao diretório pai. Além disso, para exibir o conteúdo do diretório de uma maneira que seja familiar para o usuário do Windows (primeiro pastas, depois arquivos, e ambos ordenados alfabeticamente), é necessário incluir nos dados da chave campos adicionais correspondentes.
A imagem abaixo mostra como, a partir da tarefa definida, a representação das chaves pode parecer um array de bytes. Inicialmente, são colocados os bytes com o identificador do diretório pai (vermelhos), em seguida, com o tipo (verdes) e, por último, com o nome (azuis). Ao serem ordenados pelo comparador padrão do LMDB em ordem lexicográfica, eles ficam dispostos da maneira necessária. A iteração sequencial das chaves com o mesmo prefixo vermelho nos fornece os valores relacionados na sequência em que devem ser apresentados na interface do usuário (à direita), sem necessidade de um processamento adicional.
Serialização de chaves e valores
Existem muitos métodos de serialização de objetos. Como não tínhamos nenhum requisito além da velocidade, escolhemos o mais rápido possível — um dump da memória ocupada pela instância da estrutura da linguagem C. Assim, a chave do elemento do diretório pode ser modelada pela seguinte estrutura. NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Para armazenar NodeKey no armazenamento é necessário posicionar o ponteiro para os dados no endereço de início da estrutura e calcular seu tamanho com a função MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
No primeiro capítulo sobre critérios de escolha de banco de dados, mencionei a minimização de alocações dinâmicas nas operações de CRUD como um fator importante. O código da funçãoserialize mostra como, no caso do LMDB, essas alocações podem ser completamente evitadas ao inserir novas entradas no banco de dados. Os arrays de bytes recebidos do servidor são inicialmente transformados em estruturas em pilha e, em seguida, são despejados trivialmente no armazenamento. Levando em conta que dentro do LMDB também não há alocações dinâmicas, pode-se ter uma situação fantástica para os padrões do iOS — utilizar memória de pilha durante todo o caminho com os dados, da rede até o disco! Ordenação de chaves com um comparador binário
Ordenação de chaves com um comparador binário
A ordem das chaves é definida por uma função especial chamada comparação. Como o mecanismo não sabe nada sobre a semântica dos bytes contidos, o comparador padrão não tem outra escolha a não ser ordenar as chaves em ordem lexicográfica, recorrendo à comparação byte a byte. Usá-lo para ordenar estruturas é semelhante a fazer a barba com um machado. No entanto, em casos simples, acho esse método aceitável. A alternativa é descrita logo abaixo, e aqui notarei alguns obstáculos ao longo do caminho.
A primeira coisa que você deve lembrar é a representação na memória dos tipos de dados primitivos. Assim, em todos os dispositivos Apple, variáveis inteiras são armazenadas no formato . Isso significa que o byte menos significativo estará à esquerda, e não será possível ordenar números inteiros usando a comparação byte a byte. Por exemplo, tentar fazer isso com um conjunto de números de 0 a 511 resultará no seguinte resultado.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Para resolver esse problema, os números inteiros devem ser armazenados na chave em um formato adequado para o comparador byte a byte. A conversão necessária pode ser feita com funções da família hton* (em particular, htons para números de dois bytes do exemplo).
O formato de representação de strings na programação é, como sabemos, toda uma . Se a semântica das strings e a codificação utilizada para sua representação na memória implicam que um símbolo pode ocupar mais de um byte, é melhor desistir da ideia de usar o comparador padrão.
A segunda coisa a ter em mente é os dos campos de estruturas pelo compilador. Devido a isso, podem surgir bytes com valores lixo na memória entre os campos, o que, claro, quebra a ordenação byte a byte. Para eliminar o lixo, é necessário declarar os campos em uma ordem específica, mantendo em mente as regras de alinhamento, ou usar o atributo packed.
A ordenação das chaves por um comparador externo
A lógica de comparação de chaves pode acabar sendo muito complexa para um comparador binário. Uma das muitas razões é a presença de campos técnicos dentro das estruturas. Vou ilustrar sua ocorrência com o exemplo da chave que já conhecemos para o elemento do diretório.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Apesar de toda a sua simplicidade, na grande maioria dos casos, ele consome memória em excesso. O buffer para nomes ocupa 256 bytes, enquanto, em média, os nomes de arquivos e pastas raramente ultrapassam 20-30 caracteres.
Uma das técnicas padrão para otimizar o tamanho da gravação consiste em "aparar" o tamanho real. Sua essência é que o conteúdo de todos os campos de comprimento variável é armazenado no buffer no final da estrutura, e seus comprimentos ficam em variáveis separadas. De acordo com essa abordagem, a chave NodeKey é transformada da seguinte forma.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Em seguida, ao serializar, o tamanho dos dados indicado não é MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } de toda a estrutura, mas o tamanho de todos os campos de comprimento fixo mais o tamanho da parte realmente utilizada do buffer.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Como resultado da refatoração realizada, obtivemos uma economia significativa de espaço ocupado pelas chaves. No entanto, devido ao campo técnico nameLength, o comparador binário padrão não é mais adequado para comparar chaves. Se não o substituirmos pelo nosso, o comprimento do nome será um fator mais prioritário na ordenação do que o próprio nome.
O LMDB permite definir uma função de comparação de chaves para cada banco de dados. Isso é feito através da função mdb_set_compare antes da abertura. Por razões óbvias, não pode ser alterada durante toda a vida do banco de dados. O comparador recebe duas chaves em formato binário, e retorna o resultado da comparação: menor (-1), maior (1) ou iguais (0). O pseudocódigo para NodeKey parece assim.
int compare(MDB_val * const a, MDB_val * const b) {
NodeKey * const aKey = (NodeKey * const)a->mv_data;
NodeKey * const bKey = (NodeKey * const)b->mv_data;
return // ...
}Enquanto todas as chaves no banco de dados forem do mesmo tipo, a conversão incondicional de sua representação em bytes para o tipo da estrutura de chave aplicada é válida. Há um detalhe, mas será discutido mais abaixo na seção 'Leitura de registros'.
Serialização de valores
As chaves dos registros armazenados no LMDB operam de forma extremamente intensa. A comparação entre elas ocorre durante qualquer operação aplicada, e a velocidade do comparador afeta o desempenho de toda a solução. Em um mundo ideal, um comparador binário padrão seria suficiente para a comparação das chaves, mas se for necessário usar um próprio, a deserialização das chaves deve ser tão rápida quanto possível.
A parte valor (value) do registro não é de grande interesse para o banco de dados. Sua conversão de representação em bytes para objeto ocorre apenas quando é realmente necessária para o código aplicativo, por exemplo, para sua exibição na tela. Como isso acontece relativamente raramente, as exigências de velocidade dessa operação não são tão críticas, e podemos nos concentrar muito mais na conveniência em sua implementação. Por exemplo, utilizamos NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};No entanto, há casos em que o desempenho é realmente importante. Por exemplo, ao salvar metadados sobre a estrutura de arquivos da nuvem do usuário, utilizamos o mesmo dump de memória dos objetos. A peculiaridade da tarefa de formação de sua representação serializada é o fato de que os elementos do diretório são modelados por uma hierarquia de classes.
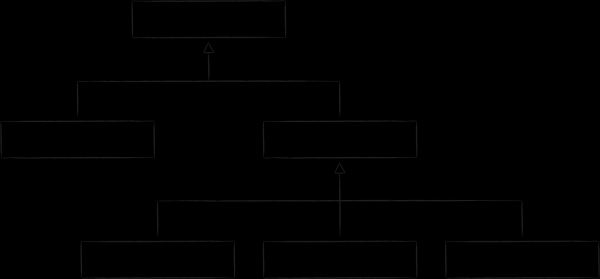
Para sua implementação na linguagem C, campos específicos dos filhos são extraídos para estruturas separadas, e sua relação com a base é estabelecida por meio de um campo do tipo union. O conteúdo atual da união é definido por um atributo técnico chamado type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Adicionar e atualizar registros
As chaves e valores serializados podem ser adicionados ao armazenamento. Para isso, usamos a função mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);Na fase de configuração, pode-se permitir ou proibir que o armazenamento mantenha várias entradas com a mesma chave. Se a duplicação de chaves for proibida, ao inserir uma entrada, pode-se determinar se é permitido atualizar uma entrada já existente ou não. Se a sobrescrição pode ocorrer apenas devido a um erro no código, é possível se proteger disso, definindo uma flag. NOOVERWRITE.
Leitura de entradas
Para leitura de entradas no LMDB, a função destinada é mdb_get. Se o par chave-valor foi previamente representado por estruturas despejadas, o procedimento se apresenta da seguinte forma.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}O trecho apresentado mostra como a serialização através do despejo de estruturas permite eliminar alocações dinâmicas não apenas na gravação, mas também na leitura de dados. O ponteiro obtido da função mdb_get aponta exatamente para o endereço da memória virtual onde o banco de dados armazena a representação em bytes do objeto. Na prática, temos algo como um ORM, oferecendo um desempenho de leitura de dados muito alto praticamente sem custo. Apesar de toda a beleza da abordagem, é importante lembrar de algumas particularidades associadas a ela.
- Para a transação somente leitura, o ponteiro para a estrutura-valor permanecerá validado apenas até que a transação seja encerrada. Como mencionado anteriormente, as páginas da árvore B que contêm o objeto, graças ao princípio de copy-on-write, permanecem inalteradas enquanto há pelo menos uma transação referenciando-as. Ao mesmo tempo, assim que a última transação relacionada a elas é concluída, as páginas podem ser reutilizadas para novos dados. Se for necessário que os objetos sobrevivam à transação que os gerou, eles ainda precisarão ser copiados.
- Para a transação de leitura e gravação, o ponteiro para a estrutura-valor obtida será válido apenas até a primeira operação de modificação (gravação ou exclusão de dados).
- Apesar de a estrutura
NodeValuenão ser totalmente funcional, mas reduzida (veja a seção "Ordenação de chaves por um comparador externo"), pode-se acessar seus campos através do ponteiro. O principal é não desreferenciá-lo! - De forma alguma se deve modificar a estrutura através do ponteiro obtido. Todas as alterações devem ser feitas apenas através do método
mdb_put. No entanto, mesmo com todo o desejo de fazê-lo, isso não será possível, uma vez que a área de memória onde essa estrutura reside está mapeada em modo somente leitura. - Remapear o arquivo para o espaço de endereço do processo com o objetivo, por exemplo, de aumentar o tamanho máximo do armazenamento com a função
mdb_env_set_map_sizeinvalida completamente todas as transações e as entidades relacionadas, em geral, e os ponteiros para objetos lidos, em particular.
Por fim, mais uma característica é tão traiçoeira que revelar sua essência não se encaixa apenas em mais um ponto. No capítulo sobre a árvore B, eu trouxe um esquema sobre como suas páginas são organizadas na memória. Desse esquema, conclui-se que o endereço do início do buffer com os dados serializados pode ser absolutamente arbitrário. Por causa disso, o ponteiro para eles, obtido na estrutura MDB_val e convertido em um ponteiro para a estrutura, resulta geralmente desalinhado. Ao mesmo tempo, as arquiteturas de alguns chips (no caso do iOS, o armv7) exigem que o endereço de quaisquer dados seja múltiplo do tamanho da palavra da máquina ou, em outras palavras, da bitness do sistema (para o armv7 — são 32 bits). Em outras palavras, uma operação como *(int *foo)0x800002 é tratada como um desvio e resulta em um crash com o veredicto EXC_ARM_DA_ALIGN. Para evitar um destino tão triste, existem duas maneiras.
A primeira consiste em copiar os dados preliminarmente para uma estrutura já alinhada. Por exemplo, em um comparador personalizado, isso se refletiria da seguinte maneira.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return \/\/ ...
}
O caminho alternativo é notificar previamente o compilador de que as estruturas com chave e valor podem não estar alinhadas usando o atributo aligned(1). No ARM, o mesmo efeito pode ser obtido com o atributo packed. Considerando que isso também ajuda na otimização do espaço ocupado pela estrutura, esse método parece mais preferível, mesmo que aumente o custo das operações de acesso aos dados.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Consultas de intervalo
Para iterar sobre um grupo de registros no LMDB, existe uma abstração de cursor. Vamos examinar como trabalhar com ele usando a tabela de metadados do usuário em nuvem que já conhecemos.
Ao exibir a lista de arquivos em um diretório, é necessário encontrar todas as chaves associadas aos seus arquivos e pastas filhas. Nas seções anteriores, nós ordenamos as chaves NodeKey dessa forma, para que elas sejam, em primeiro lugar, organizadas pelo identificador do diretório pai. Assim, tecnicamente, a tarefa de obter o conteúdo da pasta se resume a posicionar o cursor no limite superior do grupo de chaves com um prefixo definido, e em seguida iterar até o limite inferior.
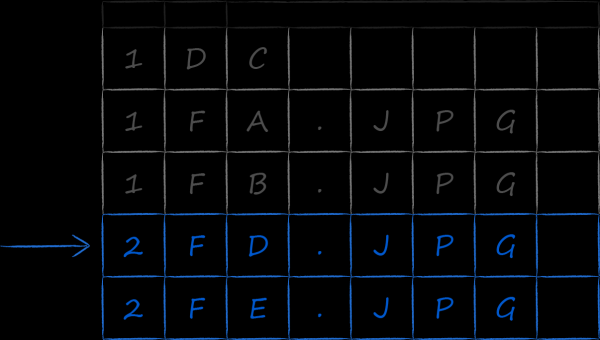
É possível encontrar o limite superior "na marra", fazendo uma busca sequencial. Para isso, o cursor é posicionado no início de toda a lista de chaves no banco de dados e, em seguida, incrementado até que encontre uma chave com o identificador do diretório pai. Essa abordagem tem 2 desvantagens óbvias:
- A complexidade linear da busca, embora, como é sabido, em árvores em geral, e em árvores B, em particular, isso possa ser feito em tempo logarítmico.
- Levanta-se desnecessariamente todas as páginas do arquivo para a memória principal, o que é extremamente caro.
Felizmente, a API do LMDB oferece uma maneira eficiente de posicionar inicialmente o cursor. Para isso, é necessário formar uma chave cuja valor seja certamente menor ou igual à chave localizada no limite superior do intervalo. Por exemplo, aplicando-se à lista na figura acima, podemos criar uma chave onde o campo parentId seja igual a 2, com todos os outros preenchidos com zeros. Essa chave parcialmente preenchida é fornecida como entrada para a função mdb_cursor_get especificando a operação MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Se o limite superior do grupo de chaves for encontrado, então, continuamos a iterar por ele até que encontramos uma chave diferente parentId, ou até que as chaves se esgotem.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// processando...
} while (MDB_NOTFOUND != rc && // checar fim da tabela
IsTargetKey(key)); // checar fim do grupo de chavesÉ agradável notar que, ao iterar usando mdb_cursor_get, obtemos não apenas a chave, mas também o valor. Se for necessário verificar os campos da parte value do registro para cumprir as condições de seleção, eles estão facilmente acessíveis sem movimentos adicionais.
4.3. Modelagem de relações entre tabelas
Até o momento, conseguimos abordar todos os aspectos do design e trabalho com um banco de dados de tabela única. Pode-se dizer que uma tabela é um conjunto de registros classificados, consistindo em pares de chave-valor do mesmo tipo. Se representarmos a chave como um retângulo e o valor associado como um paralelepípedo, teremos um esquema visual do banco de dados.

No entanto, na vida real, é raro conseguir evitar um esforço maior. Muitas vezes, um banco de dados precisa, em primeiro lugar, ter várias tabelas e, em segundo lugar, realizar seleções de forma diferente da chave primária. As questões sobre sua criação e interligação são abordadas nesta última seção.
Tabelas de índice
No aplicativo em nuvem, há uma seção "Galeria". Nela, é exibido o conteúdo de mídia de toda a nuvem, classificado pela data. Para uma implementação ideal dessa seleção, ao lado da tabela principal, é necessário criar outra com um novo tipo de chaves. Elas conterão um campo com a data de criação do arquivo, que servirá como o principal critério de ordenação. Como as novas chaves se referem aos mesmos dados que as chaves da tabela principal, elas são chamadas de índices. Na imagem abaixo, elas estão destacadas em laranja.
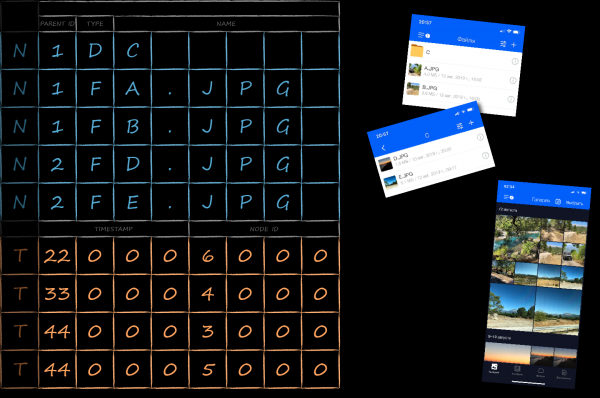
Para separar as chaves de diferentes tabelas dentro de um mesmo banco de dados, foi adicionado a todas elas um campo técnico adicional chamado tableId. Fazendo dele o mais prioritário para ordenação, conseguiremos agrupar as chaves primeiro por tabelas e, dentro das tabelas, de acordo com suas próprias regras.
A chave de índice refere-se aos mesmos dados que a primária. Implementar essa propriedade de forma direta, associando uma cópia da parte value da chave primária, não é otimizado a partir de vários pontos de vista:
- Do ponto de vista do espaço ocupado, considerando que os metadados podem ser bastante extensos.
- Do ponto de vista do desempenho, já que, ao atualizar os metadados, as nodos precisarão reescrever em duas chaves.
- Do ponto de vista do suporte ao código, assim que esquecemos de atualizar os dados de uma das chaves, geramos um bug difícil de detectar, de inconsistência de dados no armazenamento.
A seguir, vamos analisar como eliminar essas deficiências.
Organização de relacionamentos entre tabelas
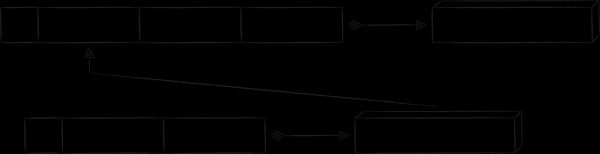
Para conectar a tabela de índices com a principal, o padrão adequado é «chave como valor». Como o próprio nome sugere, como parte do value, a entrada de índice utiliza uma cópia do valor da chave primária. Essa abordagem minimiza todas as deficiências mencionadas acima relacionadas ao armazenamento da cópia da parte value do registro primário. O único custo é que, para obter o valor pela chave de índice, é necessário fazer 2 consultas ao banco de dados em vez de uma. O diagrama resultante do banco de dados é como mostrado abaixo.
Outro padrão de organização de relacionamento entre tabelas é «chave redundante». Sua essência é adicionar atributos extras à chave, que não são necessários para ordenação, mas para recriar a chave relacionada. No aplicativo Mail.ru Cloud, existem exemplos reais de seu uso, mas para evitar uma imersão profunda em contextos específicos de frameworks iOS, apresentarei um exemplo fictício, mas mais compreensível.
Nos clientes móveis em nuvem, há uma página que exibe todos os arquivos e pastas que o usuário compartilhou com outras pessoas. Como há relativamente poucos desses arquivos, e há muitas informações específicas sobre a publicização (quem tem acesso, com quais permissões, etc.), não será racional sobrecarregar a parte value do registro na tabela principal com essas informações. Porém, se quisermos exibir esses arquivos offline, será necessário armazená-las em algum lugar. Uma solução natural é criar uma tabela separada para isso. No diagrama abaixo, sua chave tem o prefixo «P», e o placeholder «propname» pode ser substituído por um valor mais específico «informações públicas».
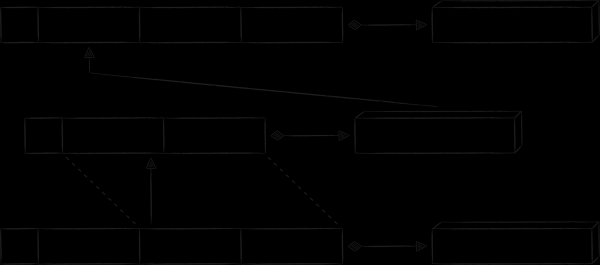
Todos os metadados exclusivos, para os quais foi criada a nova tabela, são colocados na parte value do registro. Ao mesmo tempo, não é desejável duplicar os dados sobre arquivos e pastas que já estão armazenados na tabela principal. Em vez disso, dados redundantes na forma dos campos "node ID" e "timestamp" são adicionados à chave "P". Graças a eles, é possível construir uma chave de índice, a partir da qual se obtém a chave primária, e finalmente, obter os metadados do nó.
Conclusão
Avaliamo os resultados da implementação do LMDB de forma positiva. Após sua implementação, o número de travamentos do aplicativo diminuiu em 30%.
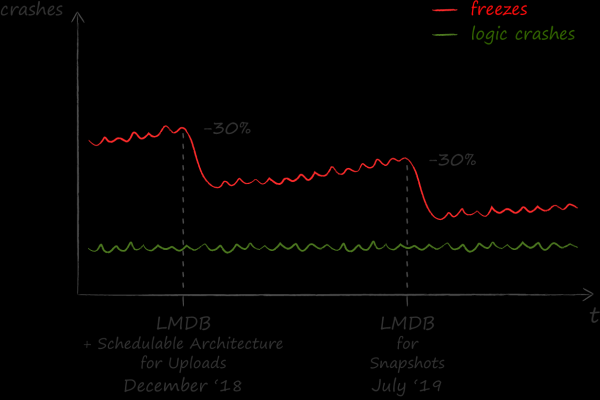
Os resultados do trabalho realizado também foram bem recebidos fora da equipe do iOS. Atualmente, uma das principais seções "Arquivos" no aplicativo para Android também passou a usar o LMDB, e outras partes estão se preparando para isso. A linguagem C, na qual o armazenamento key-value foi implementado, serviu como um bom apoio para inicialmente criar a camada de aplicação ao redor dele de forma multiplataforma em C++. Para integrar fluente a biblioteca C++ resultante com o código da plataforma em Objective-C e Kotlin, foi utilizado um gerador de código. do Dropbox, mas isso já é outra história.
Fonte: habr.com
