

Frequentemente, as pessoas que entram na área de Ciência de Dados têm expectativas não muito realistas sobre o que as aguarda. Muitas pensam que agora começarão a programar redes neurais incríveis, a criar assistentes de voz como o Homem de Ferro ou a vencer em todos os mercados financeiros.
Mas o trabalho Dados de Cientista está ligado a dados, e um dos momentos mais importantes e que consomem tempo é o processamento dos dados antes de apresentá-los a uma rede neural ou de analisá-los de uma maneira específica.
Neste artigo, nossa equipe descreverá como processar dados de forma fácil e rápida, com instruções passo a passo e código. Tentamos tornar o código bastante flexível para que ele possa ser aplicado a diferentes conjuntos de dados.
Muitos profissionais podem não encontrar nada de extraordinário neste artigo, mas os iniciantes poderão aprender algo novo, e todos aqueles que sempre sonharam em ter um notebook separado para o processamento rápido e estruturado de dados podem copiar o código e adaptá-lo a suas necessidades, ou
Recebemos um dataset. O que fazer a seguir?
Então, o padrão: precisamos entender com o que lidamos, a visão geral. Para isso, usamos o pandas para simplesmente identificar diferentes tipos de dados.
import pandas as pd #importamos pandas
import numpy as np  #importamos numpy
df = pd.read_csv("AB_NYC_2019.csv") #leia o dataset e grave na variável df
df.head(3) #observamos as primeiras 3 linhas para entender como os valores se parecem 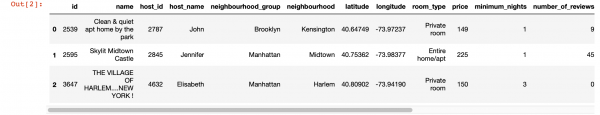
df.info() #Exibimos informações sobre as colunas 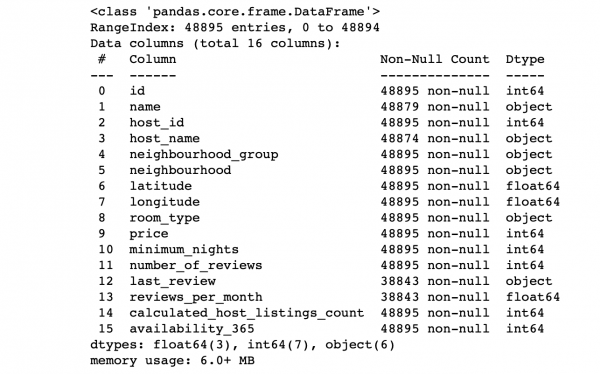
Observamos os valores das colunas:
- O número de linhas em cada coluna corresponde ao total de linhas?
- Qual é a essência dos dados em cada coluna?
- Qual coluna queremos tornar o alvo para fazer previsões?
As respostas a essas perguntas permitirão analisar o dataset e esboçar um plano para as próximas ações.
Além disso, para uma visão mais profunda dos valores em cada coluna, podemos utilizar a função describe() do pandas. O problema dessa função é que ela não fornece informações sobre colunas com valores de string. Esses dados veremos mais tarde.
df.describe() 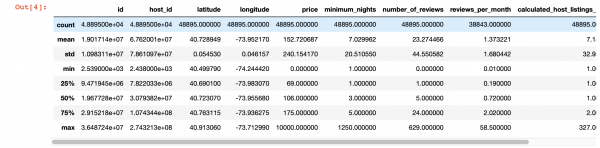
Visualização mágica
Vamos observar onde não temos valores:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 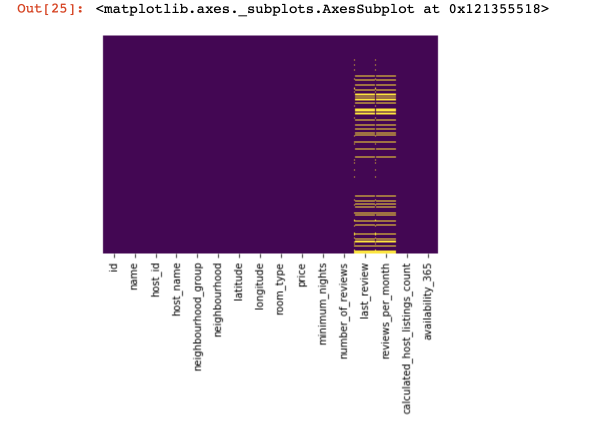
Este foi um pequeno olhar geral, agora vamos começar com coisas mais interessantes.
Vamos tentar encontrar e, se possível, remover as colunas que têm apenas um valor em todas as linhas (elas não afetarão o resultado):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] # Reescrevemos o dataset, mantendo apenas as colunas com mais de um valor único
Agora, vamos proteger a nós mesmos e o sucesso do nosso projeto de linhas duplicadas (linhas que contêm as mesmas informações na mesma ordem que uma das linhas existentes):
df.drop_duplicates(inplace=True) # Fazemos isso, se considerarmos necessário.
                                 # Em alguns projetos, não é aconselhável remover esses dados desde o início.
Dividimos o dataset em dois: um com valores qualitativos e outro com valores quantitativos
Aqui precisamos fazer uma pequena ressalva: se as linhas com dados ausentes nos dados qualitativos e quantitativos não se correlacionam fortemente, será necessário decidir o que vamos sacrificar — todas as linhas com dados ausentes, apenas uma parte delas ou colunas específicas. Se as linhas se correlacionam, temos total liberdade para dividir o dataset em dois. Caso contrário, primeiro precisamos lidar com as linhas em que os dados ausentes em qualitativos e quantitativos não se correlacionam, e só então dividir o dataset em dois.
df_numerical = df.select_dtypes(include = [np.number])
df_categorical = df.select_dtypes(exclude = [np.number])
Fazemos isso para facilitar o processamento desses dois tipos diferentes de dados — posteriormente, entenderemos o quanto isso simplifica nossa vida.
Trabalhando com dados quantitativos
A primeira coisa que devemos fazer é verificar se não existem 'colunas espiãs' nos dados quantitativos. Chamamos essas colunas assim porque elas se passam por dados quantitativos, mas funcionam como dados qualitativos.
Como podemos identificá-las? Claro, tudo depende da natureza dos dados que você está analisando, mas normalmente essas colunas podem ter poucos dados únicos (na faixa de 3-10 valores únicos).
print(df_numerical.nunique())Depois de identificarmos as colunas espiãs, moveremos elas dos dados quantitativos para os qualitativos:
spy_columns = df_numerical[['coluna1', 'coluna2', 'coluna3']]# selecionamos colunas espiãs e gravamos em um dataframe separado
df_numerical.drop(labels=['coluna1', 'coluna2', 'coluna3'], axis=1, inplace=True)# removemos essas colunas dos dados numéricos
df_categorical.insert(1, 'coluna1', spy_columns['coluna1']) # adicionamos a primeira coluna-espia aos dados qualitativos
df_categorical.insert(1, 'coluna2', spy_columns['coluna2']) # adicionamos a segunda coluna-espia aos dados qualitativos
df_categorical.insert(1, 'coluna3', spy_columns['coluna3']) # adicionamos a terceira coluna-espia aos dados qualitativos
Finalmente, separamos completamente os dados numéricos dos qualitativos e agora podemos trabalhar adequadamente com eles. Primeiro, precisamos entender onde temos valores ausentes (NaN, e em alguns casos 0 serão considerados valores ausentes).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
Neste estágio, é importante entender em quais colunas os zeros podem significar valores ausentes: isso está relacionado com a forma como os dados foram coletados? Ou isso pode estar relacionado aos valores dos dados? Precisamos responder a essas perguntas em cada caso específico.
Portanto, se decidirmos que os dados podem estar ausentes onde há zeros, devemos substituir os zeros por NaN para facilitar o trabalho posterior com esses dados perdidos:
df_numerical[["coluna 1", "coluna 2"]] = df_numerical[["coluna 1", "coluna 2"].replace(0, nan)Agora, vamos ver onde temos dados ausentes:
sns.heatmap(df_numerical.isnull(), yticklabels=False, cbar=False, cmap='viridis') # Também pode-se usar df_numerical.info() 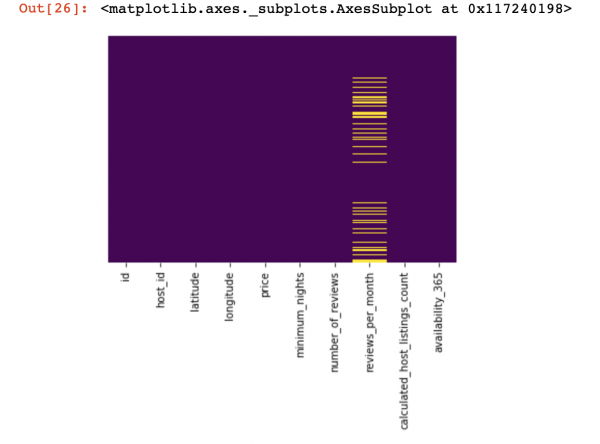
Aqui devem estar marcados em amarelo os valores dentro das colunas que estão ausentes. E o mais interessante agora — como lidar com esses valores? Excluir linhas com esses valores ou colunas? Ou preencher esses valores ausentes com outros?
Aqui está um esquema aproximado que pode ajudá-lo a decidir o que pode ser feito com valores ausentes:
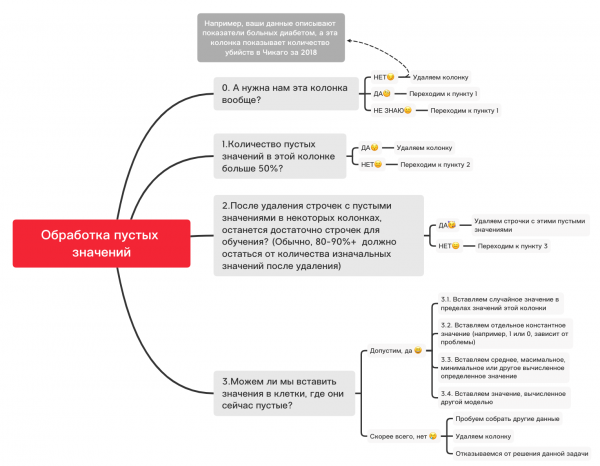
0. Excluímos colunas desnecessárias
df_numerical.drop(labels=["coluna1", "coluna2"], axis=1, inplace=True)1. A quantidade de valores ausentes nesta coluna é superior a 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["coluna1", "coluna2"], axis=1, inplace=True)# Excluímos se alguma coluna tiver mais de 50 valores ausentes2. Excluímos linhas com valores ausentes
df_numerical.dropna(inplace=True) # Remove rows with empty values if there are enough data left for training3.1. Insert a random value
import random # import random
df_numerical["coluna"].fillna(lambda x: random.choice(df[df[column] != np.nan]["coluna"]), inplace=True) # insert random values into empty cells of the table
3.2. Insert a constant value
from sklearn.impute import SimpleImputer # import SimpleImputer to help insert values
imputer = SimpleImputer(strategy='constant', fill_value="") # insert a specific value using SimpleImputer
df_numerical[["nova_coluna1", 'nova_coluna2', 'nova_coluna3']] = imputer.fit_transform(df_numerical[['coluna1', 'coluna2', 'coluna3']]) # apply this to our table
df_numerical.drop(labels=["coluna1", "coluna2", "coluna3"], axis=1, inplace=True) # remove columns with old values
3.3. Insert the mean or most frequent value
from sklearn.impute import SimpleImputer # import SimpleImputer to help insert values
imputer = SimpleImputer(strategy='mean', missing_values=np.nan) # instead of mean, you can also use most_frequent
df_numerical[["nova_coluna1", 'nova_coluna2', 'nova_coluna3']] = imputer.fit_transform(df_numerical[['coluna1', 'coluna2', 'coluna3']]) # apply this to our table
df_numerical.drop(labels=["coluna1", "coluna2", "coluna3"], axis=1, inplace=True) # remove columns with old values
3.4. Insert a value computed by another model
Sometimes values can be computed using regression models, leveraging models from the sklearn library or other similar libraries. Our team will dedicate a separate article on how this can be done in the near future.
So, for now, the narrative about quantitative data will be interrupted, as there are many other nuances about how to best conduct data preparation and preprocessing for different tasks, and the basic elements for quantitative data have been covered in this article. Now it's time to return to qualitative data, which we separated a few steps back from quantitative. You can modify this notebook however you like, adapting it for different tasks so that data preprocessing goes very quickly!
Dados qualitativos
Principalmente, para dados qualitativos utiliza-se o método de One-hot encoding, para formatá-los de string (ou objeto) em número. Antes de passar para este ponto, vamos usar o esquema e o código acima para entender os valores ausentes.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 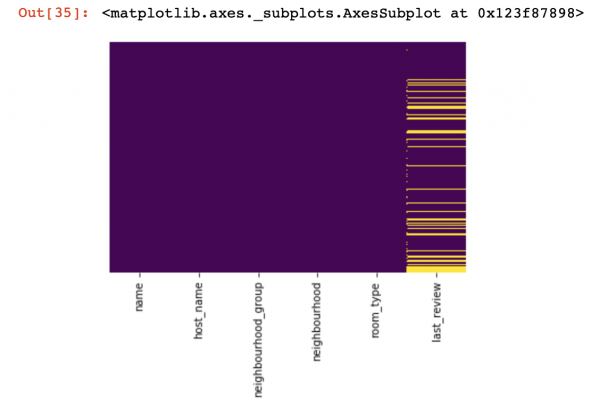
0. Excluímos colunas desnecessárias
df_categorical.drop(labels=["coluna1","coluna2"], axis=1, inplace=True)1. A quantidade de valores ausentes nesta coluna é superior a 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["coluna1","coluna2"], axis=1, inplace=True) #Remove se alguma coluna
#tiver mais de 50% de valores ausentes2. Excluímos linhas com valores ausentes
df_categorical.dropna(inplace=True) #Remove linhas com valores ausentes,
                                   #se ainda restar dados suficientes para o treinamento
3.1. Insert a random value
import random
df_categorical["coluna"].fillna(lambda x: random.choice(df[df[column] != np.nan]["coluna"]), inplace=True)
3.2. Insert a constant value
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nova_coluna1", 'nova_coluna2', 'nova_coluna3']] = imputer.fit_transform(df_categorical[['coluna1', 'coluna2', 'coluna3']])
df_categorical.drop(labels=["coluna1","coluna2","coluna3"], axis=1, inplace=True)
Assim, finalmente entendemos os valores ausentes nos dados qualitativos. Agora é hora de realizar o one-hot encoding para os valores que existem em seu banco de dados. Este método é frequentemente utilizado para que seu algoritmo possa aprender com os dados qualitativos.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["coluna1", "coluna2", "coluna3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Assim, finalmente terminamos de processar separadamente os dados qualitativos e quantitativos — é hora de mesclá-los novamente.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Depois de juntar os datasets em um só, por fim, podemos utilizar a transformação de dados com o MinMaxScaler da biblioteca sklearn. Isso fará com que nossos valores fiquem entre 0 e 1, o que ajudará no treinamento do modelo no futuro.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Estes dados agora estão prontos para tudo — redes neurais, algoritmos de ML padrão, etc!
Neste artigo, não abordamos o tratamento de dados relacionados a séries temporais, pois para esses dados devem ser utilizadas técnicas de processamento um pouco diferentes, dependendo da sua tarefa. No futuro, nossa equipe dedicará um artigo separado a este tema, e esperamos que ele traga algo interessante, novo e útil para a sua vida, assim como este.
Fonte: habr.com
