

Olá a todos! Meu nome é Dmitry Samsonov, eu sou o administrador de sistemas sênior no «Одноклассниках». Temos mais de 7 mil servidores físicos, 11 mil contêineres em nossa nuvem e 200 aplicativos que, em diversas configurações, formam 700 clusters diferentes. A grande maioria dos servidores opera sob CentOS 7.
Em 14 de agosto de 2018, foi publicada a informação sobre a vulnerabilidade FragmentSmack
() e SegmentSmack (). São vulnerabilidades com vetor de ataque de rede e uma pontuação bastante alta (7.5), que pode levar a uma negação de serviço (DoS) devido à exaustão de recursos (CPU). Naquele momento, ainda não havia sido proposta uma correção para o FragmentSmack, e, além disso, ela foi lançada significativamente depois da publicação das informações sobre a vulnerabilidade. Para resolver o SegmentSmack, foi recomendado atualizar o kernel. O próprio pacote de atualização foi lançado no mesmo dia; bastava instalá-lo.
Não, não somos contra atualizar o kernel! No entanto, existem nuances...
Como atualizamos o kernel em produção
Na verdade, não é nada complicado:
- Baixar os pacotes;
- Instalá-los em um número de servidores (incluindo servidores que hospedam nossa nuvem);
- Certificar-se de que nada quebrou;
- Assegurar-se de que todas as configurações padrão do kernel foram aplicadas sem erros;
- Aguarde alguns dias;
- Verifique as métricas dos servidores;
- Mudar o deploy de novos servidores para o novo kernel;
- Atualizar todos os servidores por data centers (um data center de cada vez, para minimizar o impacto para os usuários em caso de problemas);
- Reiniciar todos os servidores.
Repetir para todos os ramos de kernels que temos. Até o momento, isso é:
- CentOS 7 3.10 padrão — para a maioria dos servidores comuns;
- Vanilla 4.19 — para nosso , porque precisamos de BFQ, BBR, etc.;
- Elrepo kernel-ml 5.2 — para , porque o 4.19 antes se comportava de maneira instável, e as mesmas funcionalidades são necessárias.
Como você poderia imaginar, o que mais consome tempo é reiniciar milhares de servidores. Como nem todas as vulnerabilidades são críticas para todos os servidores, reiniciamos apenas aqueles que estão acessíveis diretamente pela internet. Na nuvem, para não limitar a flexibilidade, não vinculamos os contêineres acessíveis externamente a servidores específicos com um novo núcleo, mas reiniciamos todos os hosts sem exceção. Felizmente, o procedimento lá é mais simples do que com servidores comuns. Por exemplo, contêineres sem estado podem simplesmente se mover para outro servidor durante o reboot.
No entanto, ainda há muito trabalho a ser feito, que pode levar algumas semanas e, em caso de problemas com a nova versão, até vários meses. Os criminosos cibernéticos entendem isso muito bem, por isso é necessário ter um plano "B".
FragmentSmack/SçekmentSmack. Workaround
Felizmente, para algumas vulnerabilidades, esse plano "B" existe e é chamado de Workaround. Na maioria das vezes, isso envolve alterar as configurações do núcleo/aplicações, que permitem minimizar o efeito potencial ou eliminar completamente a exploração das vulnerabilidades.
No caso de FragmentSmack/SçekmentSmack o seguinte Workaround:
«É possível alterar os valores padrão de 4MB e 3MB em net.ipv4.ipfrag_high_thresh e net.ipv4.ipfrag_low_thresh (e seus análogos para ipv6 net.ipv6.ipfrag_high_thresh e net.ipv6.ipfrag_low_thresh) para 256 kB e 192 kB, respectivamente, ou ainda mais baixos. Testes mostram de uma redução pequena a significativa no uso da CPU durante um ataque, dependendo do hardware, configurações e condições. No entanto, pode haver um impacto na performance devido ao ipfrag_high_thresh=262144 bytes, pois apenas dois fragmentos de 64K podem caber na fila de remontagem ao mesmo tempo. Por exemplo, há um risco de que aplicações que trabalham com grandes pacotes UDP apresentem falhas.».
Os próprios parâmetros estão descritos da seguinte forma:
ipfrag_high_thresh - NÚMERO LONGO
     Memória máxima utilizada para reconstituir fragmentos de IP.
ipfrag_low_thresh - NÚMERO INTEIRO LONGO
     Memória máxima usada para reassemblar fragmentos IP antes que o kernel
     comece a remover filas de fragmentos incompletas para liberar recursos.
     O kernel ainda aceita novos fragmentos para desfragmentação.
Não temos serviços de produção com grandes UDP. No LAN, o tráfego fragmentado está ausente, no WAN existe, mas não de forma significativa. Nada indica que não podemos implementar o Workaround!
FragmentSmack/SçekmentSmack. Primeiro Sangue
O primeiro problema que enfrentamos foi que os contêineres em nuvem às vezes aplicavam novas configurações apenas parcialmente (apenas ipfrag_low_thresh) e, em alguns casos, não aplicavam nada — simplesmente falhavam ao iniciar. Não conseguimos reproduzir o problema de forma consistente (todas as configurações eram aplicadas manualmente sem dificuldades). Entender por que o contêiner falha na inicialização também não é simples: nenhum erro foi detectado. Uma coisa era certa: reverter as configurações resolve o problema de falha dos contêineres.
Por que não é suficiente aplicar Sysctl no host? O contêiner vive em seu próprio Namespace de rede dedicado, portanto, pelo menos dentro do contêiner pode diferir do host.
Como exatamente as configurações de Sysctl são aplicadas no contêiner? Como temos contêineres não privilegiados, não é possível alterar qualquer configuração de Sysctl ao entrar no próprio contêiner — simplesmente não há permissões suficientes. Para iniciar os contêineres, nossa nuvem utilizava Docker (naquele momento, já ). Os parâmetros do novo contêiner, incluindo as configurações de Sysctl necessárias, eram passados ao Docker via API.
Durante a análise das versões, descobrimos que a API do Docker não retornava todos os erros (pelo menos, na versão 1.10). Ao tentar iniciar o contêiner via “docker run”, finalmente vimos algo:
write /proc/sys/net/ipv4/ipfrag_high_thresh: argumento inválido docker: Resposta de erro do daemon: Não é possível iniciar o contêiner <...>: [9] Erro do sistema: não foi possível sincronizar com o processo do contêiner.
O valor do parâmetro é inválido. Mas por quê? E por que ele é inválido apenas às vezes? Descobrimos que o Docker não garante a ordem de aplicação dos parâmetros de Sysctl (a última versão verificada — 1.13.1), então, às vezes, ipfrag_high_thresh tentava ser definido como 256K, enquanto ipfrag_low_thresh ainda era 3M, ou seja, o limite superior era inferior ao limite inferior, o que causava o erro.
Naquele momento, já vínhamos utilizando nosso próprio mecanismo de reconfiguração do contêiner após a inicialização (frozen contêiner através de e execução de comandos no namespace do contêiner via ), e adicionamos a parte de configuração dos parâmetros de Sysctl a isso. O problema foi resolvido.
FragmentSmack/SegmentSmack. A primeira sangue 2
Assim que começamos a entender a aplicação do Workaround na nuvem, recebemos as primeiras reclamações raras dos usuários. Naquele momento, já se passavam algumas semanas desde o início da aplicação do Workaround nos primeiros servidores. A investigação inicial mostrou que as reclamações estavam concentradas em serviços específicos e não em todos os servidores desses serviços. O problema voltou a ter uma natureza bastante indefinida.
Em primeiro lugar, claro, tentamos reverter as configurações do Sysctl, mas isso não teve efeito. Diversas manipulações nas configurações do servidor e do aplicativo também não ajudaram. Um reboot ajudou. O reboot para Linux é tão antinatural quanto era normal trabalhar com Windows nos velhos tempos. No entanto, funcionou, e atribuímos tudo a um "bug no kernel" durante a aplicação das novas configurações no Sysctl. Que ingenuidade...
Três semanas depois, o problema voltou a ocorrer. A configuração desses servidores era bastante simples: Nginx em modo proxy/balanceador. O tráfego era baixo. Uma nova informação: o número de erros 504 nos clientes aumenta a cada dia (). O gráfico mostra o número de erros 504 por dia para este serviço:
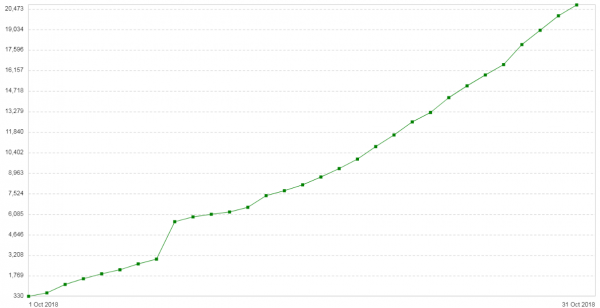
Todos os erros referem-se ao mesmo backend — aquele que está na nuvem. O gráfico de consumo de memória para fragmentos de pacotes neste backend parecia o seguinte:
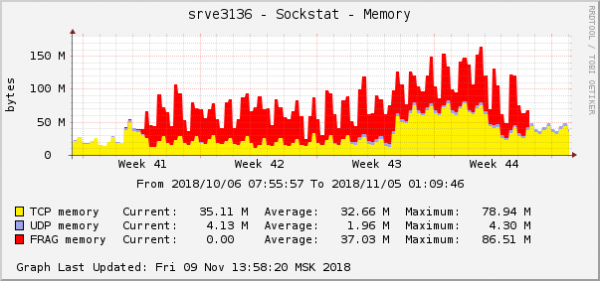
Este é um dos sinais mais evidentes do problema nos gráficos do sistema operacional. Na nuvem, durante esse mesmo período, outro problema de rede com as configurações de QoS (Traffic Control) foi corrigido. O gráfico de consumo de memória para fragmentos de pacotes parecia exatamente assim:
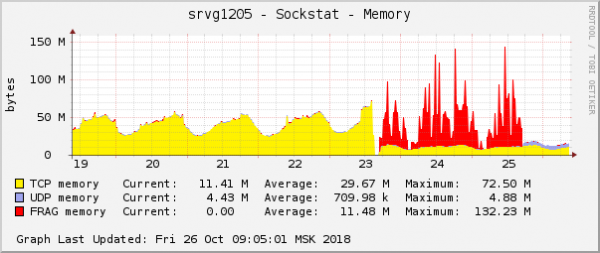
A suposição era simples: se nos gráficos eles parecem iguais, a causa também é a mesma. Além disso, problemas com esse tipo de memória ocorrem extremamente raramente.
A essência do problema corrigido era que utilizamos no QoS o escalonador de pacotes fq com as configurações padrão. Por padrão, para uma conexão, ele permite enfileirar 100 pacotes, e algumas conexões, em situações de falta de banda, começaram a encher a fila até o limite. Nesse caso, os pacotes são descartados. Nas estatísticas do tc (tc -s qdisc) isso é visível assim:
qdisc fq 2c6c: pai 1:2c6c limite 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Enviados 454701676345 bytes 491683359 pkt (descartados 464545, limites excedidos 0 requeues 0)
  backlog 0b 0p requeues 0
   1024 flows (1021 inativos, 0 limitados)
   0 gc, 0 alta prioridade, 0 limitado, 464545 flows_plimit
«464545 flows_plimit» refere-se aos pacotes descartados devido ao exceder o limite de fila de uma conexão, enquanto «dropped 464545» representa a soma de todos os pacotes descartados desse agendador. Após aumentar o comprimento da fila para 1 mil e reiniciar os containers, o problema deixou de ocorrer. Agora é possível relaxar na cadeira e tomar um smoothie.
FragmentSmack/SegmentSmack. A última gota de sangue.
Primeiramente, alguns meses após o anúncio das vulnerabilidades no kernel, finalmente foi lançado um patch para o FragmentSmack (lembrando que, junto com o anúncio em agosto, saiu um patch apenas para o SegmentSmack), o que proporcionou a oportunidade de abandonar a solução alternativa que nos causou muitos problemas. Durante esse tempo, já havíamos migrado parte dos servidores para o novo kernel, e agora precisávamos começar do zero. Por que atualizamos o kernel sem esperar pelo patch do FragmentSmack? O fato é que o processo de proteção contra essas vulnerabilidades coincidiu (e se fundiu) com o processo de atualização do próprio CentOS (que leva ainda mais tempo do que atualizar apenas o kernel). Além disso, o SegmentSmack é uma vulnerabilidade mais perigosa, e o patch para ele apareceu imediatamente, então havia sentido em qualquer caso. No entanto, simplesmente atualizar o kernel no CentOS não era viável, porque a vulnerabilidade do FragmentSmack, que surgiu na época do CentOS 7.5, só foi corrigida na versão 7.6, portanto tivemos que suspender a atualização para 7.5 e recomeçar tudo com a atualização para 7.6. Coisas assim acontecem.
Em segundo lugar, tivemos algumas queixas raras de usuários sobre problemas. Agora sabemos com certeza que todas estão relacionadas ao upload de arquivos dos clientes em alguns dos nossos servidores. Vale ressaltar que, por meio desses servidores, houve uma quantidade muito pequena de uploads em comparação ao total.
Como lembramos do relato acima, o rollback do Sysctl não ajudou. O reinício ajudou, mas apenas temporariamente.
Suspeitas sobre o Sysctl não foram descartadas, mas dessa vez era necessário coletar o máximo de informações possível. Também faltava bastante a capacidade de reproduzir o problema de upload no cliente, para estudar de forma mais precisa o que estava acontecendo.
A análise de todas as estatísticas e logs disponíveis não nos aproximou da compreensão do que estava acontecendo. Precisávamos urgentemente da capacidade de reproduzir o problema para 'tocar' numa conexão específica. Finalmente, os desenvolvedores em uma versão especial do aplicativo conseguiram reproduzir de forma estável os problemas em um dispositivo de teste ao se conectarem via Wi-Fi. Isso foi um avanço na investigação. O cliente se conectava ao Nginx, que fazia o proxy para o backend, que era nosso aplicativo em Java.
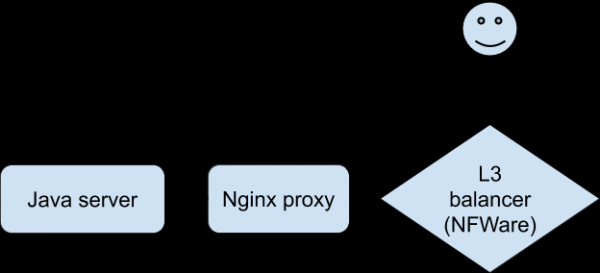
O diálogo em caso de problemas foi o seguinte (registrado do lado do proxy Nginx):
- Cliente: solicitação para obter informações sobre o download do arquivo.
- Servidor Java: resposta.
- Cliente: POST com o arquivo.
- Servidor Java: erro.
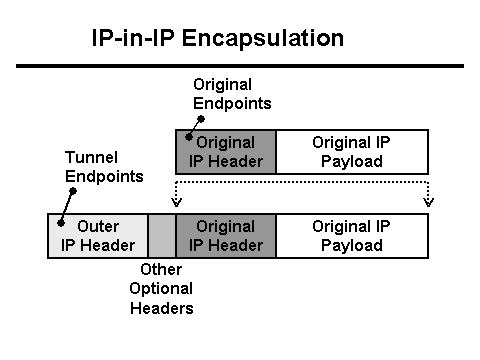
O servidor Java, por sua vez, registra no log que recebeu 0 bytes de dados do cliente, enquanto o proxy Nginx informa que a solicitação demorou mais de 30 segundos (30 segundos é o tempo limite do aplicativo cliente). Por que o tempo limite e por que 0 bytes? Do ponto de vista do HTTP, tudo está funcionando como deveria, mas o POST com o arquivo parece estar desaparecendo da rede. E desaparece entre o cliente e o Nginx. É hora de nos armarmos com Tcpdump! Mas antes precisamos entender a configuração da rede. O proxy Nginx está atrás de um balanceador L3. . Um tunneling é utilizado para entregar pacotes do balanceador L3 ao servidor, adicionando seus próprios cabeçalhos aos pacotes:
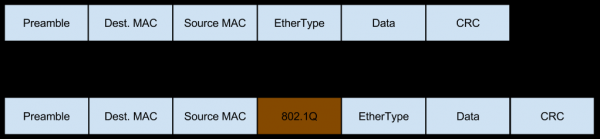
Além disso, a rede para esse servidor chega na forma de tráfego VLAN etiquetado, que também adiciona seus campos nos pacotes:
E esse tráfego pode ser fragmentado (aquele pequeno percentual de tráfego fragmentado que mencionamos na avaliação de riscos do Workaround), o que também altera o conteúdo dos cabeçalhos:
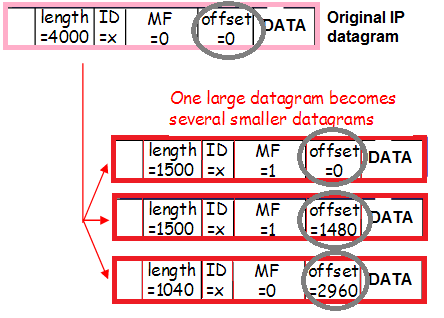
Mais uma vez: os pacotes estão encapsulados com uma etiqueta VLAN, encapsulados em um túnel, fragmentados. Para entender melhor como isso acontece, vamos acompanhar o caminho do pacote do cliente até o proxy Nginx.
- O pacote chega ao balanceador L3. Para o roteamento adequado dentro do data center, o pacote é encapsulado no túnel e enviado à placa de rede.
- Como o pacote + cabeçalhos do túnel não cabem na MTU, o pacote é cortado em fragmentos e enviado pela rede.
- O switch após o balanceador L3, ao receber o pacote, acrescenta a ele a etiqueta VLAN e envia adiante.
- O switch antes do proxy Nginx vê (com base nas configurações da porta) que o servidor está esperando um pacote encapsulado em Vlan, então o envia como está, sem remover a tag Vlan.
- O Linux recebe fragmentos de pacotes individuais e os une em um único grande pacote.
- Em seguida, o pacote chega à interface Vlan, onde a primeira camada — o encapsulamento Vlan — é removida.
- Depois, o Linux o envia para a interface Tunnel, onde outra camada — o encapsulamento Tunnel — é removida.
A dificuldade é transmitir tudo isso em forma de parâmetros para o tcpdump.
Começamos pelo fim: existem pacotes IP limpos (sem cabeçalhos extras) dos clientes, com o encapsulamento vlan e tunnel removidos?
tcpdump host
Não, tais pacotes não estavam no servidor. Portanto, o problema deve estar anterior. Existem pacotes apenas com o encapsulamento Vlan removido?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx é o endereço IP do cliente em formato hexadecimal.
32:4 é o endereço e o comprimento do campo onde o IP SCR está registrado no pacote Tunnel.
O endereço do campo teve que ser encontrado por tentativa e erro, pois na internet mencionam 40, 44, 50, 54, mas o endereço IP não estava lá. Também é possível olhar um dos pacotes em hexadecimal (o parâmetro -xx ou -XX no tcpdump) e contar o endereço do IP que você conhece.
Existem fragmentos de pacotes sem o encapsulamento Vlan e Tunnel removidos?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Esta mágica nos mostrará todos os fragmentos, incluindo o último. Provavelmente, também é possível filtrar por IP, mas eu não tentei, pois não havia muitos desses pacotes e eu consegui facilmente encontrar os necessários no fluxo geral. Aqui estão eles:
14:02:58.471063 Em 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), comprimento 1516: (tos 0x0, ttl 63, id 53652, deslocamento 0, flags [+], proto IPIP (4), comprimento 1500)
     11.11.11.11 > 22.22.22.22: ip truncado - 20 bytes ausentes! (tos 0x0, ttl 50, id 57750, deslocamento 0, flags [DF], proto TCP (6), comprimento 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, opções [nop,nop,TS val 11660691 ecr 2998165860], comprimento 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), length 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), length 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Estes são dois fragmentos de um pacote (mesmo ID 53652) com uma fotografia (é possível ver a palavra Exif no primeiro pacote). O problema claramente está na montagem, pois nesse nível os pacotes estão presentes, mas não na forma montada nos dumps. Finalmente, isso tem comprovação documental!
O decodificador de pacotes não encontrou problemas que impedissem a montagem. Tentei aqui: . Primeiro, ao tentar enviar algo, o decodificador não aceitava o formato do pacote. Descobriu-se que havia dois octetos extras entre Srcmac e Ethertype (que não pertenciam às informações dos fragmentos). Após a remoção, o decodificador funcionou. No entanto, não apresentou problemas.
Não importa como olhemos, além da Sysctl mencionada, nada mais foi encontrado. Precisávamos encontrar uma maneira de identificar servidores problemáticos, para entender a escala e decidir sobre as próximas ações. Rapidamente encontramos o contador necessário:
netstat -s | grep "packet reassembles failed”
Esse mesmo contador está no snmpd sob OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«O número de falhas detectadas pelo algoritmo de reassembly de IP (por qualquer razão: expirado, erros, etc.).»
Entre o grupo de servidores onde o problema foi estudado, em dois esse contador aumentava mais rapidamente, em dois — mais lentamente, e em outros dois não aumentava de forma alguma. A comparação da dinâmica desse contador com a dinâmica de erros HTTP no servidor Java revelou uma correlação. Portanto, o contador poderia ser colocado em monitoramento.
A presença de um indicador confiável de problemas é muito importante, pois permite determinar com precisão se o rollback da Sysctl ajuda, já que, como sabemos pela narrativa anterior, não é possível perceber isso imediatamente pelo aplicativo. Esse indicador permitiria identificar todos os pontos problemáticos em produção antes que os usuários o notassem.
Após o rollback da Sysctl, os erros de monitoramento pararam, provando assim que a causa dos problemas foi identificada e que o rollback foi eficaz.
Revertemos as configurações de fragmentação em outros servidores, onde um novo monitoramento foi ativado, e em alguns casos alocamos até mais memória para fragmentos do que antes era o padrão (isso se referia a estatísticas udp, cuja perda parcial não era perceptível no geral).
As questões mais importantes
Por que nossos pacotes estão sendo fragmentados no balanceador L3? A maioria dos pacotes que chegam dos usuários aos balanceadores são SYN e ACK. O tamanho desses pacotes é pequeno. Mas como a proporção desses pacotes é muito alta, não notamos a presença de pacotes maiores que começaram a ser fragmentados.
A causa foi um script de configuração que quebrado. em servidores com interfaces Vlan (havia muito poucos servidores com tráfego marcado em produção na época). Advmss permite transmitir ao cliente a informação de que os pacotes enviados para nós devem ser menores, para que, após a anexação dos cabeçalhos do túnel, não precisem ser fragmentados.
Por que o revert do Sysctl não ajudou, enquanto o reboot ajudou? O revert do Sysctl alterava a quantidade de memória disponível para agregação de pacotes. Ao mesmo tempo, aparentemente, o fato de a memória destinada a fragmentos estar cheia causava a lentidão das conexões, resultando em fragmentos sendo demorados na fila. Ou seja, o processo ficava preso em um loop.
O reboot zerava a memória e tudo voltava ao normal.
Poderia ter sido evitado o Workaround? Sim, mas haveria um grande risco de deixar os usuários sem suporte em caso de ataque. Claro, a aplicação do Workaround resultou em diversos problemas, incluindo lentidão em um dos serviços para os usuários, mas acreditamos que as ações foram justificadas.
Um grande agradecimento a Andrey Timofeev () pela ajuda na investigação, e a Alexey Krenев () — pelo trabalho titânico na atualização do Centos e dos kernels nos servidores. Um processo que, neste caso, teve que ser iniciado várias vezes, o que o prolongou por muitos meses.
Fonte: habr.com
