

Os Filtros de Pacotes de Berkeley (BPF) são uma tecnologia do núcleo Linux que não sai das capas das publicações técnicas em inglês há vários anos. Conferências estão cheias de apresentações sobre o uso e desenvolvimento do BPF. David Miller, mantenedor do subsistema de rede do Linux, chama sua apresentação na Linux Plumbers 2018 (XDP – é uma das opções de uso do BPF). Brendan Gregg faz apresentações intituladas . Toke Høiland-Jørgensen , que o núcleo agora é um microkernel. Thomas Graf promove a ideia de que .
Ainda não há uma descrição sistemática do BPF no Habr, portanto, nesta série de artigos, tentarei contar a história da tecnologia, descrever a arquitetura e as ferramentas de desenvolvimento, delinear áreas de aplicação e práticas de uso do BPF. Neste artigo, inicial, conto a história e a arquitetura do BPF clássico, além de revelar os segredos dos princípios de funcionamento tcpdump, seccomp, strace, e muito mais.
O desenvolvimento do BPF é controlado pela comunidade de redes Linux, e as principais aplicações existentes do BPF estão relacionadas a redes e, portanto, com a permissão de , eu nomeei a série "BPF para os menores", em homenagem à grande série .
Um breve curso de história do BPF (c)
A tecnologia BPF moderna é uma versão aprimorada e expandida da antiga tecnologia com o mesmo nome, atualmente chamada, para evitar confusões, de BPF clássico. Com base no BPF clássico, foram criadas a famosa utilidade tcpdump, um mecanismo seccomp, assim como o menos conhecido módulo xt_bpf para iptables e o classificador cls_bpf. No Linux moderno, programas BPF clássicos são automaticamente traduzidos para uma nova forma, no entanto, do ponto de vista do usuário, a API permaneceu a mesma e novas aplicações do BPF clássico, como veremos neste artigo, ainda estão presentes. Por essa razão, e também porque seguir a história do desenvolvimento do BPF clássico no Linux deixará mais claro como e por que ele evoluiu para sua forma moderna, decidi começar com um artigo sobre o BPF clássico.
No final da década de 1980, engenheiros do famoso Lawrence Berkeley Laboratory se interessaram em como filtrar pacotes de rede de forma eficaz no hardware da época. A ideia básica de filtragem, originalmente implementada na tecnologia CSPF (CMU/Stanford Packet Filter), consistia em descartar pacotes desnecessários o mais cedo possível, ou seja, no espaço do núcleo, uma vez que isso evita a cópia de dados desnecessários para o espaço do usuário. Para garantir a segurança da execução do código do usuário no espaço do núcleo, foi utilizada uma máquina virtual — uma sandbox.
No entanto, as máquinas virtuais para os filtros existentes foram projetadas para operar em máquinas com arquitetura de pilha e não funcionaram tão eficientemente em novas máquinas RISC. Como resultado, engenheiros do Berkeley Labs desenvolveram uma nova tecnologia chamada BPF (Berkeley Packet Filters), cuja arquitetura de máquina virtual foi projetada com base no processador Motorola 6502 — um trabalhador árduo de produtos tão conhecidos como ou . A nova máquina virtual aumentou a performance dos filtros em dezenas de vezes em comparação com as soluções existentes.
Arquitetura da máquina BPF
Vamos conhecer a arquitetura funcionalmente, analisando exemplos. No entanto, antes de tudo, devemos mencionar que a máquina tinha dois registradores de 32 bits disponíveis para o usuário, um acumulador A e um registrador índice X, 64 bytes de memória (16 palavras) acessíveis para leitura e gravação, e um pequeno conjunto de instruções para trabalhar com esses objetos. Nos programas também estavam disponíveis instruções de salto para implementar expressões condicionais, mas para garantir a finalização oportuna do programa, os saltos podiam ser feitos apenas para frente, ou seja, era proibido criar laços.
O esquema geral de execução da máquina é o seguinte. O usuário cria um programa para a arquitetura BPF e, através de algum mecanismo do núcleo (por exemplo, uma chamada de sistema), carrega e conecta o programa a algum gerador de eventos no núcleo (por exemplo, um evento é a chegada de um novo pacote na placa de rede). Quando ocorre um evento, o núcleo executa o programa (por exemplo, em um interpretador), enquanto a memória da máquina corresponde algum da região de memória do núcleo (por exemplo, os dados do pacote recebido).
O que foi dito acima será suficiente para começarmos a analisar exemplos: vamos nos familiarizar com o sistema e o formato dos comandos conforme necessário. Se você quiser estudar imediatamente o sistema de comandos da máquina virtual e aprender sobre todas as suas capacidades, pode ler o artigo original. e/ou a primeira metade do arquivo da documentação do núcleo. Além disso, você pode estudar a apresentação , onde McCanne, um dos autores do BPF, fala sobre a história da sua criação. libpcap.
Vamos passar a examinar todos os exemplos relevantes de aplicação do BPF clássico no Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
O desenvolvimento do BPF ocorreu paralelamente ao desenvolvimento da interface para filtragem de pacotes — a conhecida ferramenta tcpdump. E, como este é o exemplo mais antigo e mais conhecido de uso do BPF clássico, disponível em muitos sistemas operacionais, é por aqui que começaremos nosso estudo da tecnologia.
(Todos os exemplos neste artigo foram executados no Linux 5.6.0-rc6. A saída de alguns comandos foi editada para maior legibilidade.)
Exemplo: observando pacotes IPv6
Suponhamos que queremos verificar todos os pacotes IPv6 na interface eth0. Para isso, podemos executar o programa tcpdump com um filtro simples ip6:
$ sudo tcpdump -i eth0 ip6Ao mesmo tempo, tcpdump compilará o filtro ip6 em bytecode da arquitetura BPF e enviará para o núcleo (ver detalhes na seção ). O filtro carregado será executado para cada pacote que passar pela interface eth0. Se o filtro retornar um valor diferente de zero n, então n bytes do pacote serão copiados para o espaço do usuário e veremos isso na saída. tcpdump.
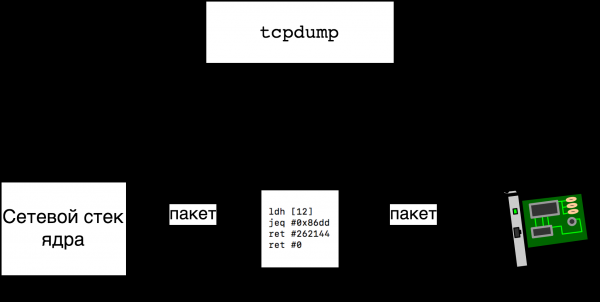
Descobrimos que podemos facilmente saber qual bytecode foi enviado ao núcleo tcpdump usando o próprio tcpdump, se o executarmos com a opção -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Na linha zero, estamos executando o comando ldh [12], que se traduz como “carregar no registrador A half-word (16 bits), localizado no endereço 12” e a única questão é — que memória estamos endereçando? A resposta é que no endereço x começa o (x+1)-o byte do pacote de rede sendo analisado. Estamos lendo pacotes da interface Ethernet eth0, e isso , que o pacote parece da seguinte forma (para simplificar, vamos considerar que não há tags VLAN no pacote):
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
Assim, após a execução do comando ldh [12] no registrador A teremos o campo Ether Type — o tipo do pacote transmitido neste quadro Ethernet. Na linha 1, comparamos o conteúdo do registrador A (tipo do pacote) com 0x86dd, e isso o tipo IPv6 que nos interessa. Na linha 1, além do comando de comparação, há mais duas colunas — jt 2 e jf 3 — rótulos para os quais devemos saltar em caso de sucesso na comparação (A == 0x86dd) e falha. Assim, em caso de sucesso (IPv6), vamos para a linha 2, e em caso de falha — para a linha 3. Na linha 3, o programa termina com o código 0 (não copie o pacote), na linha 2 o programa termina com o código 262144 (copie-me no máximo 256 kilobytes do pacote).
Um exemplo mais complexo: observamos os pacotes TCP na porta de destino
Vamos ver como fica o filtro que copia todos os pacotes TCP com a porta de destino 666. Vamos considerar o caso IPv4, já que o caso IPv6 é mais simples. Após estudar este exemplo, você pode como exercício estudar o filtro para IPv6 (ip6 and tcp dst port 666) e o filtro para o caso geral (tcp dst port 666). Assim, o filtro que nos interessa tem a seguinte aparência:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
O que fazem as linhas 0 e 1 já sabemos. Na linha 2, já verificamos que é um pacote IPv4 (Ether Type = 0x800) e carregamos no registrador A o 24º byte do pacote. Nosso pacote parece
       14            8      1     1
|cabeçalho ethernet|campos ip|ttl|protocolo|...
e significa que estamos carregando no registrador A o campo Protocolo do cabeçalho IP, o que faz sentido, pois só queremos copiar pacotes TCP. Comparamos o Protocolo com 0x6 () na linha 3.
Nas linhas 4 e 5, carregamos palavras na posição 20, e com o comando jset verificamos se um dos três — na máscara informada jset os três bits mais significativos estão limpos. Dois dos três bits nos dizem se o pacote é parte de um pacote IP fragmentado, e se sim, se é o último fragmento. O terceiro bit é reservado e deve ser igual a zero. Não queremos verificar pacotes entrecortados ou corrompidos, por isso checamos os três bits.
A linha 6 é a mais interessante neste listagem. A expressão ldxb 4*([14]&0xf) significa que estamos carregando para o registrador X os quatro bits menos significativos do décimo quinto byte do pacote, multiplicados por 4. Os quatro bits menos significativos do décimo quinto byte são o campo do cabeçalho IPv4, onde é armazenado o comprimento do cabeçalho em palavras, por isso precisamos multiplicar depois por 4. Curiosamente, a expressão 4*([14]&0xf) é uma designação de um esquema especial de endereçamento, que só pode ser usado dessa forma e apenas para o registrador X, ou seja, não podemos dizer nem ldb 4*([14]&0xf) nem ldxb 5*([14]&0xf) (podemos apenas indicar um outro offset, por exemplo, ldxb 4*([16]&0xf)). É claro que esse esquema de endereçamento foi adicionado ao BPF exatamente para obter em X (registrador índice) o comprimento do cabeçalho IPv4.
Assim, na linha 7 estamos tentando carregar meia palavra, do endereço (X+16). Lembrando que 14 bytes ocupam o cabeçalho Ethernet, e X contém o comprimento do cabeçalho IPv4, entendemos que em A carregamos a porta de destino TCP:
       14           X           2             2
|cabeçalho ethernet|cabeçalho ip|porta de origem|porta de destino|
Finalmente, na linha 8 estamos comparando a porta de destino com o valor buscado e nas linhas 9 ou 10 retornamos o resultado - copiar o pacote ou não.
Tcpdump: carregamento
Nos exemplos anteriores, não nos detivemos em como exatamente carregamos o código de byte BPF no núcleo para filtrar pacotes. De forma geral, tcpdump portado para muitos sistemas e para trabalhar com filtros usa a biblioteca . Resumindo, para aplicar um filtro na interface usando libpcap, precisamos fazer o seguinte:
- criar um descritor do tipo
pcap_ta partir do nome da interface: , - ativar a interface: ,
- compilar o filtro: ,
- conectar o filtro: .
Para ver como a função pcap_setfilter está implementada no Linux, usamos strace (algumas linhas foram removidas):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Nas duas primeiras linhas da saída, criamos para ler todos os quadros Ethernet e o vinculamos à interface eth0. A partir do , sabemos que o filtro ip consistirá de quatro instruções BPF, e na terceira linha vemos como, utilizando a opção da chamada de sistema setsockopt Estamos carregando e conectando um filtro de comprimento 4. Este é o nosso filtro.
Vale ressaltar que, no BPF clássico, o carregamento e a conexão do filtro sempre ocorre como uma operação atômica, enquanto na nova versão do BPF, o carregamento do programa e a vinculação ao gerador de eventos são separados por tempo.
A verdade oculta
Uma versão um pouco mais completa da saída é assim:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Recurso temporariamente indisponível)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Como mencionado acima, estamos carregando e conectando nosso filtro ao socket na linha 5, mas o que acontece nas linhas 3 e 4? Acontece que isso libpcap cuida de nós — para que na saída do nosso filtro não sejam capturados pacotes que não a satisfaçam, a biblioteca um filtro fictício ret #0 (descartar todos os pacotes), coloca o socket em modo não bloqueante e tenta ler todos os pacotes que poderiam ter restado dos filtros anteriores.
Portanto, para filtrar pacotes no Linux usando o BPF clássico, é necessário ter um filtro na forma de uma estrutura do tipo struct sock_fprog e um socket aberto, após o que o filtro pode ser anexado ao socket usando uma chamada de sistema setsockopt.
É interessante que o filtro pode ser conectado a qualquer socket, não apenas ao raw. Aqui está um programa que corta tudo, exceto os dois primeiros bytes de todos os datagramas UDP recebidos. (Os comentários foram adicionados no código para não sobrecarregar o artigo.)
Mais detalhes sobre o uso setsockopt para conectar filtros podem ser vistos em , e sobre como escrever seus próprios filtros do tipo struct sock_fprog sem ajuda tcpdump vamos falar na seção .
BPF clássico e o século XXI
O BPF foi incorporado ao Linux em 1997 e por muito tempo permaneceu como um trabalhador confiável libpcap sem mudanças significativas (mudanças específicas do Linux, é claro, , mas elas não mudaram o quadro global). Os primeiros sinais significativos de que o BPF iria evoluir apareceram em 2011, quando Eric Dumazet propôs , adicionando ao núcleo um Just In Time Compiler — um tradutor para converter bytecode BPF em código nativo. x86_64 O compilador JIT foi o primeiro na cadeia de mudanças: em 2012,
a capacidade de escrever filtros para , usando o BPF, em janeiro de 2013 foi um módulo módulo xt_bpf, permitindo escrever regras para iptables usando BPF, e em outubro de 2013 houve também um módulo cls_bpf, que permite escrever classificadores de tráfego usando BPF.
Em breve, veremos todos esses exemplos com mais detalhes, mas, primeiro, será útil aprender a escrever e compilar programas arbitrários para BPF, uma vez que as funcionalidades fornecidas pela biblioteca libpcap são limitadas (um exemplo simples: um filtro gerado libpcap pode retornar apenas dois valores — 0 ou 0x40000) ou, como no caso do seccomp, não são aplicáveis.
Programando BPF com as próprias mãos
Vamos nos familiarizar com o formato binário das instruções BPF, que é bem simples:
   16    8    8     32
| código | jt | jf |  k  |
Cada instrução ocupa 64 bits, onde os primeiros 16 bits são o código da operação, seguidos por dois offsets de oito bits, jt e jf, e 32 bits para o argumento K, cujo destino varia de acordo com o comando. Por exemplo, o comando ret, que finaliza a execução do programa, possui o código 6, e o valor retornado é obtido a partir da constante K. Em C, uma instrução BPF é representada por uma estrutura
struct sock_filter {
        __u16   código;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
e um programa completo — por uma estrutura
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Dessa forma, já podemos escrever programas (os códigos das instruções sabemos, por exemplo, a partir de ). Assim será a aparência do filtro ip6 do :
struct sock_filter código[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(código),
        .filter = código,
};
O programa prog pode ser legalmente utilizado na chamada
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Escrever programas em forma de códigos de máquina não é muito conveniente, mas às vezes é necessário (por exemplo, para depuração, criação de testes unitários, escrita de artigos no Habr, etc.). Para facilitar, no arquivo <linux/filter.h> são definidos macros auxiliares — o mesmo exemplo acima poderia ser reescrito como
struct sock_filter código[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
No entanto, essa opção também não é muito conveniente. Assim pensaram os programadores do kernel Linux, e por isso, na diretório do kernel, pode-se encontrar um montador e um depurador para trabalhar com o BPF clássico.
A linguagem de montagem é muito semelhante à saída de depuração tcpdump, mas, além disso, podemos indicar rótulos simbólicos. Por exemplo, aqui está um programa que descarta todos os pacotes, exceto TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Por padrão, o assemblador gera código no formato , ,..., para nosso exemplo com TCP teremos
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Para conveniência dos programadores em C, pode-se usar outro formato de saída:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28, 0, 0, 0x0000000c },
{ 0x15, 0, 3, 0x00000800 },
{ 0x30, 0, 0, 0x00000017 },
{ 0x15, 0, 1, 0x00000006 },
{ 0x06, 0, 0, 0xffffffff },
{ 0x06, 0, 0, 0000000000 },
Esse texto pode ser copiado na definição da estrutura do tipo struct sock_filter, como fizemos no início desta seção.
Extensões do Linux e netsniff-ng
Além das instruções padrão do BPF, o Linux e tools/bpf/bpf_asm também suportam . Principalmente, as instruções servem para acessar os campos da estrutura struct sk_buff, que descreve o pacote de rede no núcleo. No entanto, há também instruções auxiliares de outro tipo, como por exemplo ldw cpu carregará no registrador A o resultado da execução da função do núcleo raw_smp_processor_id().Na nova versão do BPF, essas extensões não padrão foram ampliadas para oferecer aos programas um conjunto de kernel helpers para acesso à memória, estruturas e geração de eventos.) Aqui está um exemplo interessante de um filtro, no qual copiamos para o espaço do usuário apenas os cabeçalhos dos pacotes, usando a extensão poff, deslocamento do payload:
ld poff
ret a
As extensões BPF não poderão ser utilizadas em tcpdump, mas isso é uma boa oportunidade para conhecer o pacote de utilidades , que, entre outras coisas, contém um programa avançado netsniff-ng, que, além da filtragem com BPF, também inclui um gerador de tráfego eficiente, e um montador BPF mais avançado chamado tools/bpf/bpf_asmbpfc. O pacote contém documentação bastante detalhada, consulte também os links no final do artigo.Portanto, já sabemos escrever programas BPF de complexidade arbitrária e estamos prontos para olhar novos exemplos, o primeiro dos quais é a tecnologia seccomp, que permite, através de filtros BPF, controlar o conjunto de argumentos de chamadas de sistema disponíveis para este processo e seus descendentes.
seccomp
A primeira versão do seccomp foi adicionada ao núcleo em 2005 e não gozou de grande popularidade, pois oferecia apenas uma única possibilidade — restringir o conjunto de chamadas de sistema disponíveis para o processo, do seguinte modo:
read write, exit, sigreturn e , e o processo que violasse as regras era terminado por meio de, e o processo que violou as regras era eliminado por meio de SIGKILL. No entanto, em 2012, o seccomp recebeu a capacidade de usar filtros BPF, permitindo a definição de múltiplas chamadas de sistema permitidas e até mesmo a execução de verificações em seus argumentos. (Curiosamente, um dos primeiros usuários dessa funcionalidade foi o Chrome, e atualmente pessoas do Chrome estão desenvolvendo o mecanismo KRSI, baseado em uma nova versão do BPF que permite a personalização dos Módulos de Segurança do Linux.) Links para documentação adicional podem ser encontrados no final do artigo.
Vale ressaltar que já existem artigos no Habr sobre o uso do seccomp, e pode ser que alguém queira lê-los antes (ou em vez) de ler as próximas seções. No artigo são apresentados exemplos de uso do seccomp, tanto da versão de 2007 quanto da versão utilizando BPF (filtros gerados com a ajuda da libseccomp), é discutida a relação do seccomp com o Docker, bem como fornecidas muitas referências úteis. No artigo é discutido, entre outras coisas, como adicionar listas negras ou listas brancas de chamadas de sistema para demônios gerenciados pelo systemd.
A seguir, veremos como escrever e carregar filtros para seccomp em C puro e com a ajuda da biblioteca libseccomp e quais são os prós e contras de cada opção, e por último, veremos como o seccomp é utilizado pelo programa strace.
Escrevendo e carregando filtros para seccomp
Já sabemos como escrever programas BPF e, portanto, inicialmente veremos a interface de programação do seccomp. Um filtro pode ser instalado no nível de processo, sendo que todos os processos filhos herdarão as restrições. Isso é feito através da chamada de sistema :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)onde &filter — é um ponteiro para a estrutura que já conhecemos struct sock_fprog, ou seja, um programa BPF.
Mas o que diferencia programas para seccomp de programas para sockets? O contexto transmitido. No caso de sockets, uma área de memória contendo o pacote era passada, enquanto no caso do seccomp, nos é passada uma estrutura do tipo
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Aqui nr — é o número da chamada de sistema que está sendo invocada, arch — a arquitetura atual (sobre isso abaixo), args — até seis argumentos da chamada de sistema, e instruction_pointer — é um ponteiro para uma instrução no espaço do usuário que fez a chamada do sistema. Portanto, por exemplo, para carregar o número da chamada do sistema no registrador A devemos dizer
ldw [0]Para programas seccomp, existem outras peculiaridades, como o fato de que o acesso ao contexto só pode ser feito com alinhamento de 32 bits e não se pode carregar uma palavra ou byte — ao tentar carregar o filtro ldh [0] a chamada do sistema seccomp retornará EINVAL. A verificação dos filtros carregados é realizada pela função do núcleo. (De forma engraçada, no commit original que adicionou a funcionalidade seccomp, esqueceram-se de adicionar a permissão para usar a instrução mod (módulo) e agora ela não está disponível para programas BPF do seccomp, já que sua adição ABI.)
Basicamente, já sabemos tudo o que precisamos para escrever e ler programas seccomp. Normalmente, a lógica do programa é estruturada como uma lista branca ou negra de chamadas do sistema, por exemplo, o programa
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
verifica a lista negra de quatro chamadas do sistema com os números 304, 176, 239, 279. O que são essas chamadas do sistema? Não podemos dizer com certeza, pois não sabemos para qual arquitetura o programa foi escrito. Portanto, os autores do seccomp começar todos os programas com a verificação da arquitetura (a arquitetura atual é indicada no contexto como um campo arch da estrutura struct seccomp_data). Com a verificação da arquitetura, o exemplo começaria como:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
e então nossos números de chamadas do sistema teriam valores definidos.
Escrevendo e carregando filtros para seccomp usando libseccomp
Escrever filtros em códigos de máquina ou para montagem BPF permite ter controle total sobre o resultado, mas ao mesmo tempo, às vezes é preferível ter um código portável e/ou legível. Isso é facilitado pela biblioteca , que fornece uma interface padrão para escrever filtros negros ou brancos.
Vamos, por exemplo, escrever um programa que executa um arquivo binário escolhido pelo usuário, estabelecendo, previamente, uma lista negra de chamadas do sistema da (o programa é simplificado para maior legibilidade, a versão completa pode ser encontrada ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Inicialmente, devemos definir um array sys_numbers a partir de 40+ números de chamadas de sistema para bloqueio. Em seguida, inicializamos o contexto ctx e dizemos à biblioteca que queremos permitir (SCMP_ACT_ALLOW) todas as chamadas de sistema por padrão (construir listas negras é mais simples). Em seguida, uma a uma, adicionamos todas as chamadas de sistema da lista negra. Em resposta a uma chamada de sistema da lista, pedimos SCMP_ACT_TRAP, nesse caso, o seccomp enviará um sinal ao processo SIGSYS com uma descrição de qual chamada de sistema violou as regras. Finalmente, carregamos o programa no núcleo usando seccomp_load, que compilará o programa e o conectará ao processo usando a chamada de sistema seccomp(2).
Para uma compilação bem-sucedida, o programa precisa ser vinculado à biblioteca libseccomp, por exemplo:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Exemplo de execução bem-sucedida:
$ ./seccomp_lib echo ok
ok
Exemplo de chamada de sistema bloqueada:
$ sudo ./seccomp_lib mount -t bpf bpf /tmp
Chamada de sistema inválida
Usaremos strace, para saber mais detalhes:
$ sudo strace -e seccomp ./seccomp_lib mount -t bpf bpf /tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ morto por SIGSYS (core dump) +++
Chamada de sistema inválida
de onde podemos saber que o programa foi encerrado devido ao uso de uma chamada de sistema proibida mount(2).
No total, escrevemos um filtro usando a biblioteca libseccomp, condensando código não trivial em quatro linhas. No exemplo acima, na presença de um grande número de chamadas de sistema, o tempo de execução pode diminuir significativamente, pois a verificação é apenas uma lista de comparações. Para otimização, recentemente um patch foi , que adiciona suporte ao atributo de filtro SCMP_FLTATR_CTL_OPTIMIZE. Se você definir esse atributo como 2, o filtro será transformado em um programa de busca binária.
Se quiser ver como os filtros de busca binária são construídos, dê uma olhada em , que gera tais programas em assembly BPF a partir de um conjunto de números de chamadas de sistema, por exemplo:
$ echo 1 3 6 8 13 | ./generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Nada substancialmente mais rápido pode ser escrito, pois programas BPF não podem realizar saltos condicionais (não podemos fazer, por exemplo, jmp A ou jmp [label+X]) e, portanto, todos os saltos são estáticos.
seccomp e strace
Todo mundo conhece a utilidade strace uma ferramenta indispensável para investigar o comportamento de processos no Linux. No entanto, muitos também estão cientes dos ao utilizar essa ferramenta. A questão é que strace é implementada por meio de ptrace(2), e nesse mecanismo não podemos especificar em qual conjunto de chamadas de sistema precisamos interromper o processo, ou seja, por exemplo, os comandos
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
e
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
levam aproximadamente o mesmo tempo, embora no segundo caso queiramos rastrear apenas uma chamada de sistema.
A nova opção --seccomp-bpf, adicionada na strace versão 5.3, permite acelerar o processo várias vezes e o tempo de inicialização sob rastreamento de uma chamada de sistema já é comparável ao tempo de uma inicialização normal:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Aqui, claro, há um pequeno engano no fato de que estamos rastreando não a chamada de sistema principal desse comando. Se estivermos rastreando, por exemplo, newfsstat, então strace ele seria igualmente lento, como sem --seccomp-bpf.)
Como essa opção funciona? Sem ela strace se conecta ao processo e o inicia usando PTRACE_SYSCALL. Quando o processo controlado executa (qualquer) chamada de sistema, o controle é transferido strace, que observa os argumentos da chamada de sistema e a executa através de PTRACE_SYSCALL. Após algum tempo, o processo concluí a chamada de sistema e ao sair dela o controle é novamente transferido strace, que observa os valores de retorno e inicia o processo usando PTRACE_SYSCALL, e assim por diante.
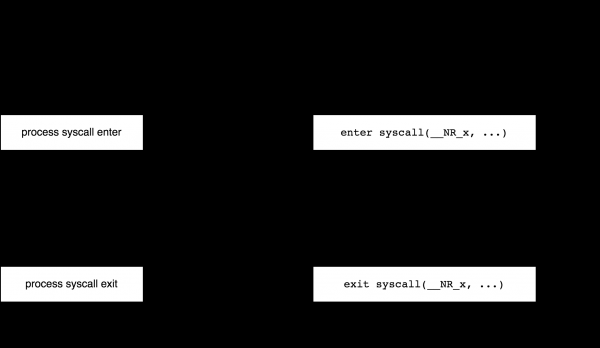
Com o seccomp, no entanto, esse processo pode ser otimizado exatamente da maneira que gostaríamos. Ou seja, se quisermos observar apenas a chamada de sistema X, podemos escrever um filtro BPF que para X retorna o valor SECCOMP_RET_TRACE, e para chamadas que não nos interessam — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
Nesse caso strace inicialmente inicia o processo como PTRACE_CONT, em cada chamada de sistema, nosso filtro é acionado, se a chamada de sistema não X, o processo continua a execução, mas se isto X, então o seccomp transmitirá o controle strace, que observará os argumentos e iniciará o processo como PTRACE_SYSCALL (já que o seccomp não pode executar um programa ao sair de uma chamada de sistema). Quando a chamada de sistema retornar, strace reiniciará o processo usando PTRACE_CONT e aguardará novas mensagens do seccomp.
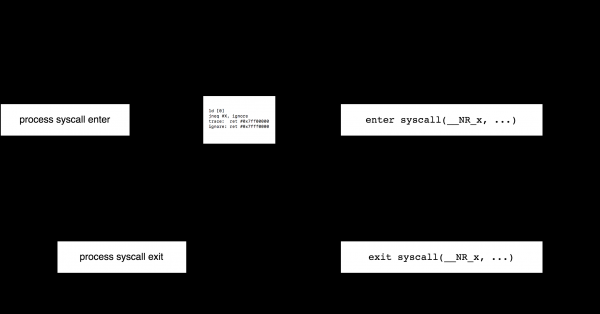
Ao usar a opção --seccomp-bpf existem duas restrições. Primeiro, não será possível anexar a um processo já existente (opção -p programa strace), uma vez que isso não é suportado pelo seccomp. Em segundo lugar, não há como não observar processos filhos, pois os filtros seccomp são herdados por todos os processos filhos sem a possibilidade de desativá-los.
Um pouco mais de detalhes sobre como isso strace funciona com seccomp pode ser encontrado em . Para nós, o fato mais interessante é que o BPF clássico na forma do seccomp ainda é utilizado.
xt_bpf
Agora vamos voltar ao mundo das redes.
História: há muito tempo, em 2007, no núcleo foi módulo xt_u32 para netfilter. Foi escrito por analogia com um classificador de tráfego ainda mais antigo, cls_u32 e permitia escrever regras binárias arbitrárias para iptables usando as seguintes operações simples: carregar 32 bits do pacote e realizar um conjunto de operações aritméticas. Por exemplo,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Carrega 32 bits do cabeçalho IP, começando com um deslocamento de 6, e aplica uma máscara 0xFF (pegando o byte menos significativo). Este é o campo protocol do cabeçalho IP e o comparamos com 1 (ICMP). Em uma única regra, é possível combinar muitas verificações, além disso, é possível realizar o operador @ — ir X bytes para a direita. Por exemplo, a regra
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"verifica se o Número de Sequência TCP 0x29. Não vou entrar em mais detalhes, pois já está claro que escrever essas regras manualmente não é muito conveniente. No artigo , há vários links com exemplos de uso e geração de regras para xt_u32. Veja também os links no final deste artigo.
A partir de 2013, em vez do módulo xt_u32 pode-se usar um módulo baseado em BPF. xt_bpfPara quem leu até aqui, já deve estar claro o princípio de funcionamento: executar bytecode BPF como regras do iptables. Para criar uma nova regra, você pode fazer assim:
iptables -A INPUT -m bpf --bytecode -j LOGaqui <байткод> — este é o código no formato de saída do montador bpf_asm por padrão, por exemplo,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
Neste exemplo, estamos filtrando todos os pacotes UDP. O contexto para o programa BPF no módulo xt_bpf, claro, refere-se aos dados do pacote, no caso do iptables — ao início do cabeçalho IPv4. O valor retornado do programa BPF , onde falso significa que o pacote não correspondia.
É claro que o módulo xt_bpf suporta filtros mais complexos do que no exemplo acima. Vamos dar uma olhada em exemplos reais da empresa Cloudflare. Até recentemente, eles usavam o módulo xt_bpf para proteção contra ataques DDoS. No artigo eles explicam como (e por que) geram filtros BPF e publicam links para um conjunto de utilitários para criar esses filtros. Por exemplo, usando a ferramenta bpfgen você pode criar um programa BPF que combina uma solicitação DNS para o nome habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
No programa, primeiro carregamos no registrador X o endereço do início da string x04habrx03comx00 dentro do datagrama UDP e depois verificamos a solicitação: 0x04686162 "x04hab" etc.
Um pouco depois, a Cloudflare publicou o código do compilador p0f -> BPF. No artigo eles explicam o que é p0f e como converter as assinaturas p0f em BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
Atualmente, a Cloudflare não utiliza mais xt_bpf, pois migraram para o XDP — uma das variantes do uso da nova versão do BPF, veja .
cls_bpf
O último exemplo de uso clássico do BPF no núcleo é um classificador cls_bpf para o subsistema de controle de tráfego no Linux, adicionado ao Linux no final de 2013 e que conceitualmente substituiu o antigo cls_u32.
No entanto, não vamos descrever o funcionamento agora cls_bpf, pois em termos de conhecimento sobre o BPF clássico, isso não nos ajudará — já nos familiarizamos com toda a funcionalidade. Além disso, em artigos subsequentes que falam sobre o BPF Estendido, iremos nos deparar com esse classificador mais de uma vez.
Outra razão para não falar sobre o uso do BPF clássico com cls_bpf é que, comparado ao BPF Estendido, neste caso a área de aplicação é drasticamente limitada: programas clássicos não podem alterar o conteúdo dos pacotes e não podem manter estado entre chamadas.
Assim, chegou a hora de nos despedirmos do BPF clássico e olharmos para o futuro.
Despedida do BPF clássico
Analisamos como a tecnologia BPF, desenvolvida no início dos anos 90, conseguiu sobreviver por um quarto de século e continua a encontrar novas aplicações. No entanto, assim como a transição de máquinas empilhadas para RISC, que impulsionou o desenvolvimento do BPF clássico, nos anos 2000 ocorreu a transição de máquinas de 32 bits para 64 bits, e o BPF clássico começou a se tornar obsoleto. Além disso, as capacidades do BPF clássico são bastante limitadas; além da arquitetura desatualizada, não temos a possibilidade de manter o estado entre as chamadas dos programas BPF, não há interação direta com o usuário, e não podemos interagir com o kernel, exceto para ler um número limitado de campos da estrutura. sk_buff e executar funções auxiliares simples, não podemos alterar o conteúdo dos pacotes nem redirecioná-los.
Na verdade, atualmente, do BPF clássico no Linux, permanece apenas a interface da API, e dentro do kernel todos os programas clássicos, sejam filtros de soquete ou filtros seccomp, são automaticamente transcodificados para um novo formato, Extended BPF. (Contaremos como isso acontece no próximo artigo.)
A transição para a nova arquitetura começou em 2013, quando Alexey Starovoitov propôs um esquema de atualização do BPF. Em 2014, os patches correspondentes no kernel. Pelo que entendi, inicialmente, o objetivo era apenas otimizar a arquitetura e o JIT-compiler para um funcionamento mais eficiente em máquinas de 64 bits, mas em vez disso, essas otimizações deram início a um novo capítulo no desenvolvimento do Linux.
Os próximos artigos desta série discutirão a arquitetura e as aplicações da nova tecnologia, originalmente conhecida como internal BPF, depois extended BPF, e agora simplesmente BPF.
Links
- Steven McCanne e Van Jacobson, "The BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — o bytecode esquecido:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Apresentando a Ferramenta BPF:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- Uma visão geral do seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: uma olhada por baixo do capô",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Fonte: habr.com
