

Olá! Meu nome é Vadim Madison, eu lidero o desenvolvimento da System Platform da Avito. Já falamos várias vezes sobre como estamos fazendo a transição de uma arquitetura monolítica para uma arquitetura de microsserviços. É hora de compartilhar como transformamos nossa infraestrutura para aproveitar ao máximo os microsserviços e não nos perdermos neles. Como o PaaS nos ajuda, como simplificamos o deploy e reduzimos a criação de um microsserviço a um único clique — continue lendo. Nem tudo que escrevo abaixo foi completamente implementado na Avito, parte é sobre como estamos desenvolvendo nossa plataforma.
(E no final deste artigo, vou falar sobre a oportunidade de participar de um seminário de três dias com o especialista em arquitetura de microsserviços Chris Richardson).
Como chegamos aos microsserviços
A Avito é um dos maiores classificados do mundo, com mais de 15 milhões de novos anúncios publicados diariamente. Nosso backend recebe mais de 20 mil solicitações por segundo. Atualmente, temos várias centenas de microsserviços.
Estamos construindo uma arquitetura de microsserviços há vários anos. Como exatamente — nossos colegas detalharão na nossa sessão no RIT++ 2017. No CodeFest 2017 (veja ), Sergey Orlov e Mikhail Prokoptchuk explicaram detalhadamente por que precisávamos fazer a transição para microsserviços e qual o papel que o Kubernetes desempenhou aqui. Agora, estamos fazendo todo o possível para minimizar os custos de escalonamento que essa arquitetura traz consigo.
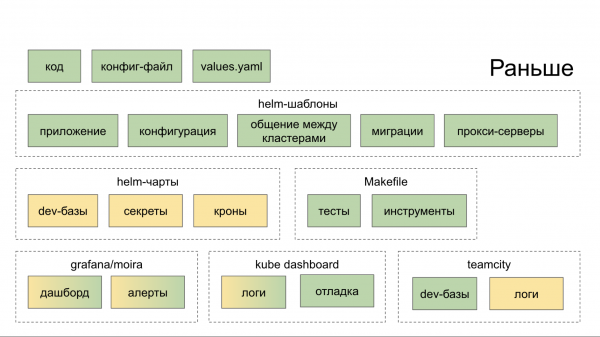
Inicialmente, não criamos um ecossistema que ajudasse amplamente no desenvolvimento e lançamento de microsserviços. Apenas reunimos boas soluções open source, as executamos internamente e pedimos aos desenvolvedores que se virassem com elas. Como resultado, o desenvolvedor tinha que visitar uma dezena de locais (painéis, serviços internos), o que reforçava seu desejo de continuar codificando da maneira antiga, em monolito. Na diagramas abaixo, o que o desenvolvedor faz manualmente é destacado em verde, e a automação em amarelo.
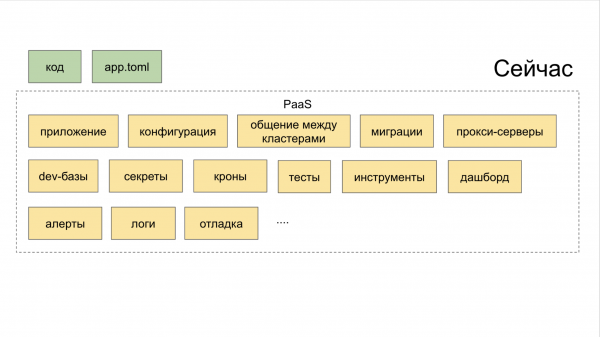
Agora, no utilitário CLI do PaaS, um novo serviço é criado com um único comando, enquanto outros dois comandos adicionam um novo banco de dados e fazem o deploy no Stage.
Como superar a era da 'fragmentação dos microsserviços'
Na arquitetura monolítica, por questão de consistência nas mudanças do produto, os desenvolvedores foram obrigados a entender o que estava acontecendo com os vizinhos. Com a nova arquitetura, os contextos dos serviços deixaram de depender uns dos outros.
Além disso, para que a arquitetura de microsserviços seja eficaz, é necessário estabelecer diversos processos, a saber:
• Log de eventos;
• Rastreamento de requisições (Jaeger);
• Agregação de erros (Sentry);
• Status, mensagens e eventos do Kubernetes (Processamento de Fluxo de Eventos);
• limite de corrida / disjuntor (pode ser utilizado o Hystrix);
• Controle de coesão dos serviços (utilizamos o Netramesh);
• Monitoramento (Grafana);
• Compilação (TeamCity);
• Comunicação e notificação (Slack, email);
• Rastreamento de tarefas (Jira);
• Elaboração de documentação.
Para que conforme a escalabilidade, o sistema não perca sua integridade e permaneça eficiente, repensamos a organização do trabalho dos microsserviços na Avito.
Como gerenciamos os microsserviços
Realizar uma única ‘política de partido’ entre os diversos microsserviços da Avito é facilitado por:
- divisão da infraestrutura em camadas;
- a concepção de Plataforma como Serviço (PaaS);
- monitoramento de tudo que acontece com os microsserviços.
Os níveis de abstração da infraestrutura incluem três camadas. Vamos do topo para a base.
A. Superior — service mesh. Inicialmente, testamos o Istio, mas descobrimos que ele consome muitos recursos, o que se torna excessivamente caro para os nossos volumes. Portanto, o engenheiro sênior da equipe de arquitetura, Alexander Lukyanchенко, desenvolveu uma solução própria — (disponível em Código Aberto), que usamos atualmente em produção e consome várias vezes menos recursos do que o Istio (mas também não faz tudo o que o Istio se orgulha de fazer).
B. Intermediário — Kubernetes. Nele, implantamos e operamos os microsserviços.
C. Inferior — bare metal. Não usamos nuvens e tecnologias como OpenStack, operamos inteiramente em bare metal.
Todas as camadas se unem em PaaS. E esta plataforma, por sua vez, consiste em três partes.
I. Geradores, geridos através de uma ferramenta CLI. É ela que ajuda o desenvolvedor a criar microsserviços de forma adequada e com o mínimo de esforço.
II. Coletor agregado com monitoramento de todas as ferramentas através de um painel geral.
III. Armazenamento. Conecta-se com planejadores que automaticamente definem gatilhos para ações significativas. Com esse sistema, nenhuma tarefa é esquecida apenas porque alguém se esqueceu de se atribuir uma tarefa no Jira. Para isso, usamos uma ferramenta interna chamada Atlas.
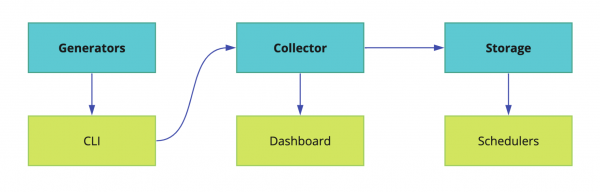
A implementação de microsserviços no Avito também ocorre segundo um esquema único, o que simplifica o controle sobre eles em cada fase de desenvolvimento e lançamento.
Como é estruturada a pipeline padrão de desenvolvimento de um microsserviço
De forma geral, a cadeia de criação de um microsserviço se apresenta da seguinte maneira:
CLI-push → Integração Contínua → Bake → Deploy → Testes automatizados → Testes Canary → Squeeze Testing → Produção → Manutenção.
Vamos percorrer isso exatamente nessa sequência.
CLI-push
• Criação de microsserviço.
Nos esforçamos bastante para ensinar cada desenvolvedor a criar microsserviços. Inclusive, escrevemos instruções detalhadas no Confluence. Mas os esquemas mudavam e eram complementados. O resultado — um gargalo surgiu no início do caminho: o tempo para lançar microsserviços era muito maior do que o aceitável, e mesmo assim, frequentemente surgiam problemas durante sua criação.
No final, construímos uma simples utilidade de CLI que automatiza as principais etapas para criar um microsserviço. De fato, ela substitui o primeiro git push. Aqui está o que ela faz especificamente.
— Cria um serviço a partir de um modelo — passo a passo, em modo de 'assistente'. Temos modelos para as principais linguagens de programação no backend do Avito: PHP, Golang e Python.
— Com um único comando, implanta um ambiente para desenvolvimento local em uma máquina específica — o Minikube é iniciado, os gráficos do Helm são automaticamente gerados e lançados no kubernetes local.
— Conecta o banco de dados necessário. O desenvolvedor não precisa saber o IP, login e senha para acessar o banco de dados necessário — seja localmente, em Stage ou na produção. Além disso, o banco de dados é implantado imediatamente em uma configuração tolerante a falhas e com balanceamento.
— Realiza uma construção ao vivo por si só. Suponha que o desenvolvedor tenha modificado algo no microsserviço através de sua IDE. A utilidade detecta as alterações no sistema de arquivos e, com base nelas, reconstrói o aplicativo (para Golang) e reinicia. Para PHP, simplesmente passamos o diretório para dentro do contêiner e lá o live-reload ocorre automaticamente.
— Gera testes automatizados. Em forma de modelos, mas totalmente utilizáveis.
• Implantação de microsserviço.
Implantar um microsserviço anteriormente era um pouco complicado. Eram obrigatórios:
I. Dockerfile.
II. Configuração.
III. Helm chart, que por si só é volumoso e inclui:
— os próprios charts;
— templates;
— valores específicos levando em conta diferentes ambientes.
Eliminamos a dor de reconfigurar os manifestos do Kubernetes, e agora eles são gerados automaticamente. Mas o principal, simplificamos ao máximo a implantação. A partir de agora temos um Dockerfile, e toda a configuração é especificada pelo desenvolvedor em um único arquivo curto app.toml.
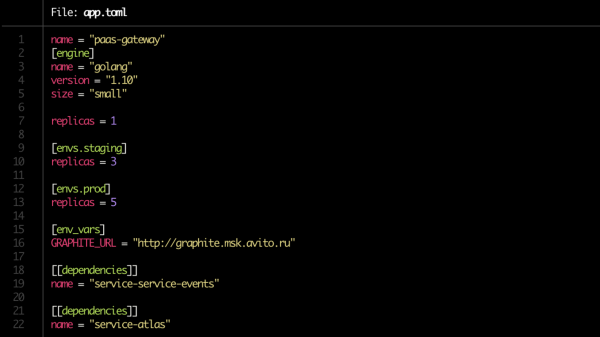
E no próprio app.toml agora leva um minuto. Especificamos quantas cópias do serviço são iniciadas (no servidor de desenvolvimento, no staging, na produção) e indicamos suas dependências. Preste atenção na linha size = "small" no bloco [engine]. Este é o limite que será alocado ao serviço através do Kubernetes.
Em seguida, com base na configuração, todos os Helm charts necessários são gerados automaticamente e as conexões com bancos de dados são criadas.
• Validação básica. Essas verificações também estão automatizadas.
É necessário monitorar:
— se há Dockerfile;
— se há app.toml;
— se a documentação está disponível;
— se as dependências estão corretas;
— se as regras de alerta estão definidas.
Quanto ao último ponto: o proprietário do serviço indica quais métricas de produto monitorar.
• Preparação da documentação.
Até agora, um ponto problemático. Pode parecer óbvio, mas, ao mesmo tempo, é o elo da cadeia que mais "esquecemos", e, portanto, vulnerável.
É necessário que haja documentação para cada microsserviço. Ela deve incluir os seguintes blocos.
I. Descrição breve do serviço. Algumas frases sobre o que ele faz e para que serve.
II. Link para o diagrama de arquitetura. É importante que, ao dar uma olhada, você consiga entender facilmente, por exemplo, se você usa Redis para caching ou como armazenamento principal de dados em modo persistente. No Avito, isso ainda é um link para o Confluence.
III. Runbook. Um guia curto sobre como iniciar o serviço e as sutilezas de usá-lo.
IV. FAQ, onde seria bom antecipar problemas com os quais seus colegas podem se deparar ao trabalhar com o serviço.
V. Descrição dos endpoints para a API. Se você não especificou os destinos, é quase certo que seus colegas, cujos microsserviços estão conectados ao seu, pagarão por isso. Atualmente, usamos o Swagger e nossa solução chamada brief para isso.
VI. Rótulos. Ou marcadores que mostram a que produto, funcionalidade ou unidade organizacional da empresa o serviço se refere. Eles ajudam a entender rapidamente, por exemplo, se você não está duplicando uma funcionalidade que seus colegas lançaram para o mesmo setor de negócios há uma semana.
VII. Proprietário ou proprietários do serviço. Na maioria dos casos, é possível identificá-lo — ou eles — automaticamente usando PaaS, mas para segurança exigimos que o desenvolvedor os informe manualmente.
Finalmente, uma boa prática é realizar a revisão da documentação, assim como no code review.
Continuous Integration
- Preparação dos repositórios.
- Criação do pipeline no TeamCity.
- Definição de permissões.
- Busca por proprietários do serviço. Aqui temos um esquema híbrido — marcação manual e uma mínima automação da PaaS. Um esquema totalmente automático falha ao transferir serviços para o suporte de outra equipe de desenvolvimento ou, por exemplo, se o desenvolvedor do serviço foi demitido.
- Registro do serviço no Atlas (veja acima). Com todos os seus proprietários e dependências.
- Verificação das migrações. Verificamos se há migrações potencialmente perigosas entre elas. Por exemplo, se uma delas contém um alter table ou algo que possa quebrar a compatibilidade do esquema de dados entre diferentes versões do serviço. Nesse caso, a migração não é realizada e entra em uma fila de espera — o PaaS deve notificar o proprietário do serviço quando for seguro aplicá-la.
Assar
A próxima fase é a embalagem dos serviços antes do deploy.
- Construção do aplicativo. Conforme o clássico — em uma imagem Docker.
- Geração de Helm charts para o próprio serviço e recursos relacionados. Incluindo para bancos de dados e caches. Eles são criados automaticamente de acordo com a configuração do app.toml que foi gerada na fase de CLI-push.
- Criação de tickets para os administradores abrirem portas (quando necessário).
- Execução de testes unitários e cálculo da cobertura de códigoSe a cobertura do código estiver abaixo do limite estabelecido, é provável que o serviço não passe pela implantação. Se estiver no limite aceitável, um coeficiente "pessimista" será atribuído ao serviço: assim, na ausência de melhorias ao longo do tempo, o desenvolvedor receberá uma notificação de que não há progresso em relação aos testes (e é necessário tomar uma atitude em relação a isso).
- Consideração das restrições de memória e CPUPrincipalmente escrevemos microsserviços em Golang e os executamos no Kubernetes. Daí vem uma sutileza relacionada à característica da linguagem Golang: por padrão, todos os núcleos da máquina são utilizados ao iniciar, a menos que a variável GOMAXPROCS seja explicitamente definida. Quando vários desses serviços são iniciados em uma única máquina, eles começam a competir por recursos, interferindo uns nos outros. Os gráficos abaixo mostram como o tempo de execução muda se o aplicativo for executado sem competição e em um modo de corrida por recursos. (Os fontes dos gráficos estão disponíveis) ).
Tempo de execução, menor é melhor. Máximo: 643 ms, mínimo: 42 ms. A imagem é clicável.
Tempo para a operação, menor é melhor. Máximo: 14091 ns, mínimo: 151 ns. A imagem é clicável.
Na etapa de preparação da construção, essa variável pode ser definida explicitamente ou pode-se usar a biblioteca da equipe da Uber.
Deploy
• Verificação das convenções. Antes de começar a entregar as composições do serviço nos ambientes planejados, é preciso verificar o seguinte:
— Endpoints da API.
— Conformidade das respostas dos endpoints da API com o esquema.
— Formato dos logs.
— Definição de cabeçalhos nas requisições ao serviço (atualmente isso é feito pelo netramesh)
— Definindo um marcador de proprietário ao enviar mensagens para o barramento (event bus). Isso é necessário para rastrear a coerência dos serviços através do barramento. No barramento, é possível enviar tanto dados idempotentes, que não aumentam a coerência dos serviços (o que é bom), quanto dados comerciais que aumentam a coerência dos serviços (o que é muito ruim!). E no momento em que essa coerência se torna um problema, entender quem escreve e lê o barramento ajuda a dividir os serviços corretamente.
Por enquanto, não existem muitas convenções na Avito, mas seu número está aumentando. Quanto mais acordos desse tipo, em um formato que seja compreensível e conveniente para a equipe, mais fácil será manter a consistência entre os microsserviços.
Testes sintéticos
• Testes em um contorno fechado. Para isso, atualmente usamos o open source . Primeiro, ele registra a carga real no serviço, depois — como em um circuito fechado — a emula.
• Testes de carga. Nós nos esforçamos para otimizar o desempenho de todos os serviços. E todas as versões de cada serviço devem passar por testes de carga — assim podemos entender o desempenho atual do serviço e a diferença em relação às versões anteriores do mesmo serviço. Se, após uma atualização do serviço, seu desempenho cair pela metade, isso é um sinal claro para os proprietários: é preciso investigar o código e corrigir a situação.
Baseamos nossas decisões nos dados coletados, por exemplo, para implementar corretamente o auto scaling e, no final das contas, entender até que ponto o serviço é escalável.
Durante os testes de carga, verificamos se o consumo de recursos está dentro dos limites estabelecidos. E nos concentramos, principalmente, nos extremos.
a) Analisamos a carga total.
— Se estiver muito baixa — provavelmente algo não está funcionando, se a carga cair repentinamente várias vezes.
— Se estiver muito alta — otimização é necessária.
b) Analisamos a limitação de RPS.
Aqui, observamos a diferença entre a versão atual e a anterior, assim como o número total. Por exemplo, se um serviço fornece 100 rps — ou ele está mal escrito, ou é uma de suas características, mas de qualquer forma, é um motivo para olhar atentamente para o serviço.
Se, por outro lado, o RPS for excessivamente alto, é possível que haja um bug e que algum dos endpoints parou de executar a carga útil e simplesmente aciona algum tipo de return true;
Testes Canary
Após a conclusão dos testes sintéticos, começamos a testar o funcionamento do microsserviço com um pequeno número de usuários. Começamos com cautela, com uma fração mínima do público-alvo do serviço — menos de 0,1%. Nesta fase, é muito importante que o monitoramento tenha métricas técnicas e de produto corretas registradas, para que possam indicar rapidamente um problema no serviço. O tempo mínimo do teste canário é de 5 minutos, e o principal — 2 horas. Para serviços mais complexos, definimos o tempo manualmente.
Analisamos:
— métricas específicas para a linguagem, em particular, trabalhadores php-fpm;
— erros no Sentry;
— status das respostas;
— tempo de resposta (response time), preciso e médio;
— latência;
— exceções, tratadas e não tratadas;
— métricas de produto.
Squeeze Testing
O Squeeze Testing também é conhecido como teste de "espremimento". O nome da metodologia foi introduzido pela Netflix. A essência dela é que primeiro preenchemos uma instância com tráfego real até o ponto de falha, estabelecendo assim seu limite. Depois, adicionamos mais uma instância e sobrecarregamos esse par — novamente até o máximo; vemos seu teto e a diferença em relação ao primeiro "squeeze". E assim vamos conectando uma instância por vez e calculando a regularidade nas mudanças.
Os dados dos testes de "espremimento" também se acumulam em uma base de métricas, onde ou enriquecemos os resultados da carga artificial com eles ou os substituímos completamente pela "sintética".
Produção
• Escalabilidade. Ao lançar um serviço em produção, monitoramos como ele se escala. Monitorar apenas os indicadores de CPU, baseado em nossa experiência, não é eficaz. O autoescalonamento com benchmarking de RPS em sua essência funciona, mas apenas para serviços específicos, como streaming online. Portanto, olhamos, em primeiro lugar, para métricas de produto específicas para a aplicação.
No final, ao escalar analisamos:
— os indicadores de CPU e RAM,
— o número de solicitações na fila,
— o tempo de resposta,
— previsões com base em dados históricos acumulados.
Ao escalar um serviço, também é importante monitorar suas dependências, para evitar que escalemos o primeiro serviço na cadeia, enquanto aqueles a quem ele se conecta falham sob carga. Para estabelecer uma carga aceitável para todo o pool de serviços, olhamos para os dados históricos do serviço dependente "mais próximo" (com base na combinação de indicadores de CPU e RAM junto com métricas específicas da aplicação) e os comparamos com os dados históricos do serviço inicial, e assim por diante, por toda a "cadeia de dependências", de cima para baixo.
Manutenção
Depois que o microsserviço é colocado em operação, podemos adicionar gatilhos a ele.
Aqui estão situações típicas em que os gatilhos são ativados.
— Migrações potencialmente perigosas foram detectadas.
— Atualizações de segurança foram lançadas.
— O próprio serviço não foi atualizado por um longo tempo.
— A carga no serviço diminuiu significativamente ou algumas de suas métricas de produto estão fora dos padrões.
— O serviço deixou de atender às novas exigências da plataforma.
Parte dos gatilhos é responsável pela estabilidade operacional, enquanto a outra parte — como uma função de manutenção do sistema — por exemplo, algum serviço não foi implantado há muito tempo e sua imagem básica deixou de passar na verificação de segurança.
Dashboard
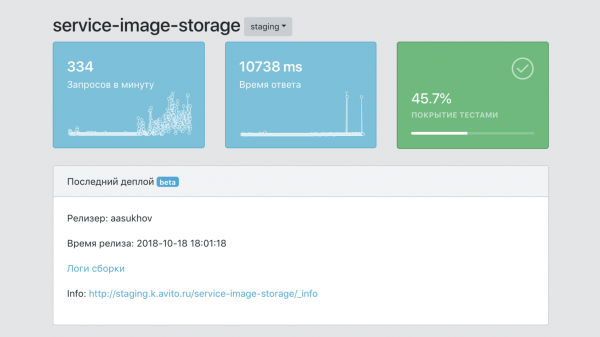
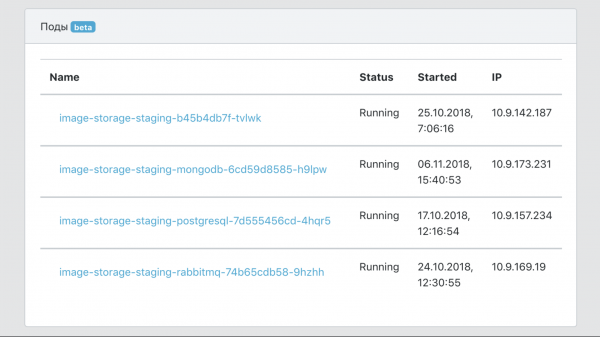
Se formos resumir, o dashboard é o painel de controle de toda a nossa PaaS.
- Um ponto único de informação sobre o serviço, com dados sobre sua cobertura de testes, número de imagens, quantidade de cópias em produção, versões, etc.
- Uma ferramenta de filtragem de dados por serviços e labels (marcadores de pertencimento a unidades de negócios, funcionalidade de produtos, etc.)
- Uma ferramenta de integração com ferramentas de infraestrutura para rastreamento, registro de logs e monitoramento.
- Um ponto único de documentação sobre os serviços.
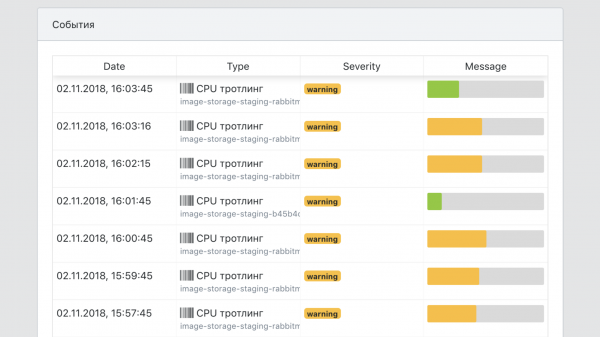
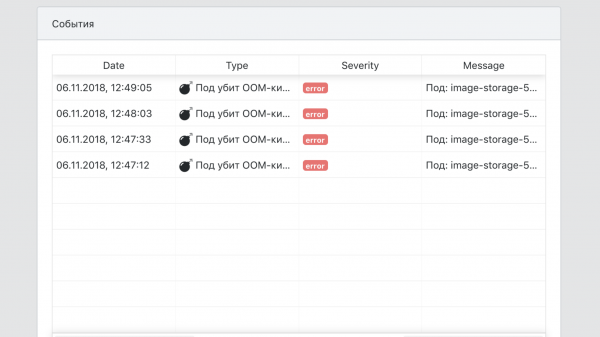
- Um ponto único de visão sobre todos os eventos relacionados aos serviços.
Total
Antes da implementação da PaaS, um novo desenvolvedor poderia gastar várias semanas entendendo todas as ferramentas necessárias para implantar um microsserviço em produção: Kubernetes, Helm, nossas peculiaridades internas no TeamCity, configuração da conexão com bancos de dados e caches de forma resiliente, etc. Agora, isso leva algumas horas — ler o quickstart e criar o serviço.
Fiz uma apresentação sobre este tema para o HighLoad++ 2018, você pode conferir. e .
Uma faixa bônus para aqueles que leram até o final.
Na Avito, organizamos um treinamento interno de três dias para desenvolvedores por , um especialista em arquitetura de microsserviços. Queremos dar a oportunidade de participação a alguém dos leitores deste post. O programa do treinamento foi publicado.
O treinamento ocorrerá de 5 a 7 de agosto em Moscovo. Serão dias úteis, que estarão completamente ocupados. O almoço e o aprendizado ocorrerão em nosso escritório, enquanto o transporte e a estadia do participante escolhido serão pagos por ele mesmo.
As inscrições para participação podem ser feitas . De você — uma resposta à pergunta sobre por que exatamente você precisa participar do treinamento e informações de contato. Responda em inglês, pois o participante que irá para o treinamento será escolhido pelo Chris.
Anunciaremos o nome do participante do treinamento através de uma atualização neste post e nas redes sociais da Avito para desenvolvedores (AvitoTech no , , ) até o dia 19 de julho.
Fonte: habr.com
