

A definição de DevOps é bastante complexa, por isso a discussão sobre o tema é constantemente reaberta. Apenas no Habr há mil publicações sobre isso. Mas se você está lendo isso, com certeza já sabe o que é DevOps. Porque eu não sei. Olá, meu nome é Alexander Titov (@), e nós vamos simplesmente conversar sobre DevOps e eu vou compartilhar minha experiência.
Pensei bastante em como tornar meu relato útil, por isso haverá muitas perguntas — aquelas que faço a mim mesmo e aquelas que faço aos clientes da nossa empresa. Respondendo a essas perguntas, a compreensão se torna melhor. Vou explicar por que DevOps é necessário do meu ponto de vista, o que é isso, novamente, do meu ponto de vista, e como entender se você está avançando em direção ao DevOps, novamente do meu ponto de vista. O último ponto será por meio de perguntas. Ao responder a elas para si mesmo, você conseguirá entender se sua empresa está caminhando para o DevOps ou se há problemas em algum aspecto.
Durante um tempo, naveguei pelas ondas de fusões e aquisições. Primeiro trabalhei em uma pequena startup chamada Qik, depois ela foi adquirida por uma empresa um pouco maior, a Skype, que, por sua vez, foi comprada por uma empresa ainda maior, a Microsoft. Nesse momento, consegui ter uma visão de como a percepção de DevOps se transforma em empresas de diferentes tamanhos. Depois disso, fiquei interessado em olhar para o DevOps do ponto de vista de mercado, e com colegas, fundamos a empresa Express 42. Há 6 anos navegamos nas ondas do mercado.
Além de tudo isso, sou um dos organizadores da comunidade DevOps Moscow e organizei o DevOps Days 2017, mas não organizei em 2018. A Express 42 trabalha com muitas empresas. Nós fazemos crescer o DevOps lá, observamos como isso acontece, tiramos conclusões, analisamos, compartilhamos nossas conclusões com todos, e treinamos pessoas em práticas de DevOps. Em suma, estamos cultivando a experiência e a expertise nesse sentido.
Por que DevOps
A primeira pergunta que persegue a todos sempre é: por quê? Muitos acreditam que DevOps é apenas automação ou algo similar que já existe em cada empresa.
— Nós já tínhamos Integração Contínua — isso significa que já tínhamos DevOps, e para que precisamos de toda essa confusão? Lá fora eles se divertem, e aqui eles só atrapalham o trabalho!
Em 9 anos de desenvolvimento da comunidade e da metodologia, já ficou claro que isso, de fato, não é um brilho de marketing, mas ainda não está totalmente claro para que serve. Como qualquer ferramenta ou processo, o DevOps tem objetivos específicos que acaba alcançando.
Tudo isso está relacionado ao fato de que o mundo está mudando. Ele está se afastando da abordagem empresarial, onde as empresas avançam diretamente em direção ao sonho, como cantou nosso clássico de São Petersburgo, do ponto A ao ponto B, seguindo uma estratégia definida, com uma estrutura específica construída para isso.
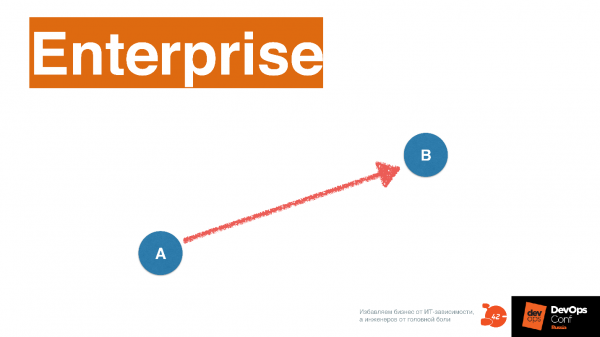
Em princípio, tudo em TI deveria ser estruturado com base nessa abordagem. Aqui, a TI é usada exclusivamente para a automação de processos.
A automação não muda com frequência, porque quando uma empresa está na mesma rota, o que há para mudar? Funciona — não mexa. Hoje em dia, no mundo, as abordagens estão mudando, e a que é conhecida como Agile diz que o ponto final B não é imediatamente visível.
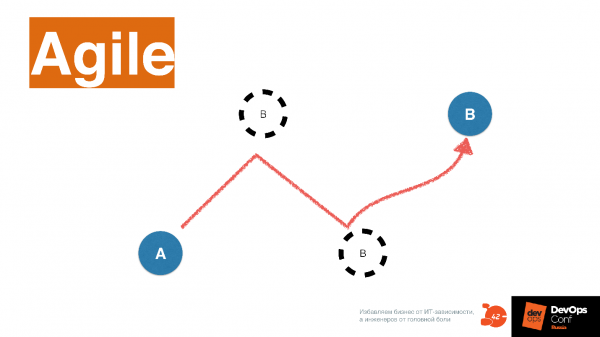
Quando uma empresa opera no mercado e trabalha com o cliente, ela está constantemente pesquisando o mercado e mudando o ponto final B. Quanto mais frequentemente a empresa muda sua direção, mais bem-sucedida ela acaba se tornando, porque escolhe mais nichos de mercado.
Uma estratégia é demonstrada por uma empresa interessante, da qual soube recentemente. One Box Shave é um serviço de entrega de lâminas e acessórios de barbear por assinatura em uma caixa. Eles conseguem personalizar sua 'caixinha' para diferentes clientes. Isso é feito por um software específico, que depois envia o pedido para uma fábrica na Coréia que produz o produto.
Esse produto foi adquirido pela Unilever por 1 bilhão de dólares. Agora ele compete com a Gillette e tomou uma parte significativa do público no mercado americano. A One Box Shave diz:
— 4 lâminas? Você está falando sério? Por que você precisaria disso - isso não melhora a qualidade do barbear. Um creme especialmente selecionado, uma fragrância e uma lâmina de qualidade com duas lâminas resolvem muito mais questões do que essas bobas 4 lâminas da Gillette! Vamos chegar a 10 em breve?
Assim, o mundo está mudando. A Unilever afirma que possui um sistema de TI incrível que permite isso. No final, isso se parece com o conceito Time-to-market, sobre o qual já se falou muito.
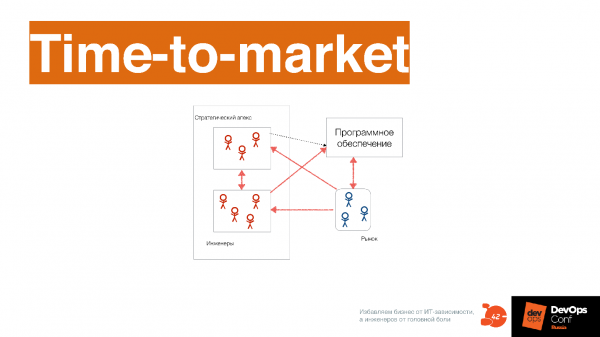
O significado de Time-to-market não está em quão frequentemente fazemos deploy. Muitas vezes, é possível fazer deploy, mas os ciclos de lançamento podem ser longos. Se sobrepormos ciclos de lançamento de três meses, adiando um pouco, parece que a empresa faz deploy toda semana. Mas na verdade, desde a ideia até a implementação final, passam-se três meses.
Time-to-market é sobre minimizar o tempo desde a ideia até a implementação final.
Nesse caso, o software interage com o mercado. Assim, no One Box Shave, o site interage com o cliente. Eles não têm vendedores — apenas um site onde o visitante clica e deixa suas preferências. Portanto, é necessário atualizar constantemente o site com coisas novas, alinhando-o com os desejos dos usuários. Por exemplo, na Coreia do Sul, o método de barbear é diferente do da Rússia, e eles preferem fragrâncias diferentes, como baunilha em vez de pinho.
Como é necessário mudar rapidamente o conteúdo do site, o desenvolvimento de software muda muito. Através do software, precisamos entender o que o cliente quer. Antes, isso era feito de maneira indireta, como através da gestão de negócios. Depois, projetávamos e incorporávamos requisitos no sistema de TI, e tudo corria bem. Agora é diferente — o software é projetado por todos os envolvidos no processo, incluindo engenheiros, que entendem através das especificações técnicas como o mercado opera e também compartilham suas percepções com os negócios.
Por exemplo, na empresa Qik, descobrimos de repente que as pessoas adoram carregar listas de contatos no servidor, e acabaram desenvolvendo um aplicativo para isso. Inicialmente, não tínhamos pensado nisso. Em uma empresa clássica, todos teriam decidido que isso era um bug, pois não estava especificado que precisava funcionar bem e, na verdade, foi implementado de maneira improvisada, teriam desativado a funcionalidade e teriam dito: 'Isso não interessa a ninguém, o mais importante é que a funcionalidade principal funciona.' Mas uma empresa tecnológica vê nisso uma oportunidade e começa a mudar o software de acordo.
Em 1968, um cara perspicaz, Melvin Conway, formulou a seguinte ideia.
Uma organização que cria um sistema é limitada pelo design que copia a estrutura de comunicação dessa organização.
Se for mais detalhado, para produzir sistemas de outro tipo, você ainda precisa ter uma estrutura de comunicação dentro da empresa de outro tipo. Se você tem uma estrutura de comunicação hierárquica superior, isso não permitirá que você crie sistemas que possam garantir um alto índice de Time-to-market.
Ler é possível . Ela é importante para compreender a cultura ou filosofia DevOps, já que a única coisa que muda basicamente no DevOps é precisamente a estrutura de comunicação entre as equipes..
Do ponto de vista do processo, até o DevOps, todas as etapas: análise, desenvolvimento, teste, operação, aconteciam de forma linear.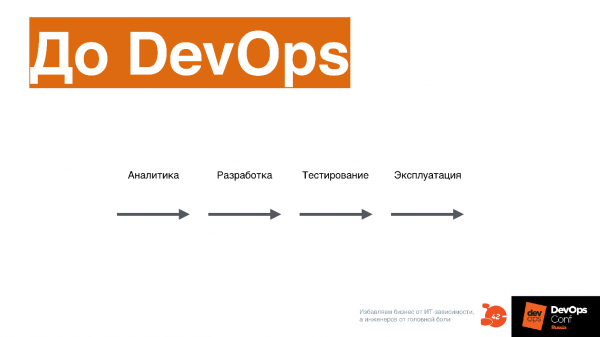
No caso do DevOps, todos esses processos ocorrem simultaneamente.
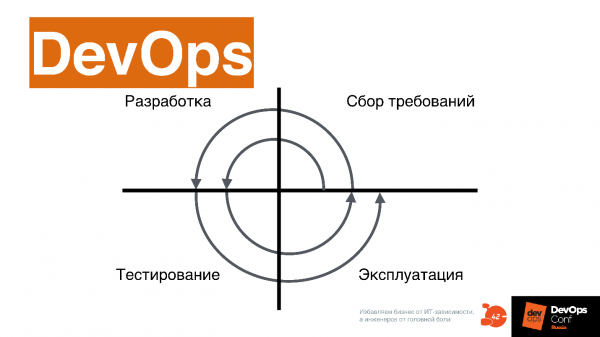
Time-to-market só pode ser alcançado assim. Para as pessoas que trabalharam no antigo processo, isso parece um pouco espacial e é de fato bastante complicado.
Então, por que o DevOps é necessário?
Para o desenvolvimento de produtos digitais. Se você não tem um produto digital na sua empresa, o DevOps não é necessário - isso é muito importante.
O DevOps supera as limitações de velocidade do modelo de produção sequencial de software. Nele, todos os processos ocorrem ao mesmo tempo.
A complexidade aumenta. Quando os evangelistas do DevOps dizem que ficará mais fácil lançar software - isso é absurdo.
Com o DevOps, tudo se tornará apenas mais complicado.
Na conferência, no estande da Avito, vocês podiam ver o que significa implantar um contêiner Docker - uma tarefa irreal. A complexidade se torna excessiva, é necessário malabarizar muitas bolas ao mesmo tempo.
O DevOps muda completamente o processo e a organização na empresa — na verdade, não é o DevOps que muda, mas o produto digital. Para chegar ao DevOps, você deve realmente transformar completamente este processo.
Perguntas para o especialista
E quanto a você? Perguntas que você pode se fazer, trabalhando na empresa e se desenvolvendo como especialista.
Você tem uma estratégia para criar um produto digital? Se sim, isso já é bom. Isso significa que sua empresa está avançando em direção ao DevOps.
Sua empresa já está criando um produto digital? Isso significa que você pode subir mais um nível, se envolver em assuntos mais interessantes - ainda do ponto de vista do DevOps. Estou falando apenas desse ponto de vista.
Sua empresa é uma das líderes de mercado em um nicho com produto digital? Spotify, Yandex, Uber — empresas que estão no auge do progresso tecnológico atualmente.
Faça a si mesmo estas perguntas e, se todas as respostas forem negativas, talvez você não deva se envolver em DevOps nesta empresa. Mas se a questão de DevOps realmente lhe interessa, será que… talvez você deva mudar para outra empresa? Se a sua empresa quer avançar em DevOps, mas você respondeu "Não" a todas as perguntas, então ela se assemelha a aquele lindo rinoceronte que nunca vai mudar.
Organização
Como já mencionei, pela lei de Conway, a organização dentro da empresa muda. Começarei discutindo o que impede o DevOps de penetrar na empresa sob a perspectiva da organização.
O problema dos "silos"
A palavra inglesa "Silo" foi traduzida aqui para o russo como "колодец" (poço). O significado desse problema é que não há troca de informações entre as equipes. Cada equipe escava sua especialização em profundidade, sem construir um mapa comum que permita a orientação.
Isso se assemelha a uma pessoa que acabou de chegar a Moscou e ainda não sabe se orientar pelo mapa do metrô. Os moscovitas geralmente conhecem bem seu bairro, enquanto se orientam em toda Moscou pelo mapa do metrô. Quando você chega a Moscou pela primeira vez, não possui essa habilidade e está completamente desorientado.
O DevOps propõe passar por esse momento de desorientação e construir um mapa comum de interação junto com todos os departamentos.
Dois fatores dificultam isso.
As consequências do sistema de gestão corporativa. Ele é construído por "silos" hierárquicos separados. Por exemplo, existem certos KPIs nas empresas que sustentam esse sistema. Por outro lado, a mente humana dificulta a saída de sua zona de conforto e a orientação em todo o sistema. Isso é simplesmente desconfortável. Imagine que você está em um aeroporto em Bangkok — é difícil se orientar rapidamente lá. No DevOps, também é complicado se orientar, e por isso as pessoas dizem que é necessário encontrar um guia para chegar lá.
Mas o mais importante é que o problema dos "silos" para um engenheiro que se deixou levar pelo espírito do DevOps, que leu Fowler e muitos outros livros, se expressa no fato de que "silos" não permitem realizar coisas "óbvias". Frequentemente nos reunimos após o DevOps Moscow, conversamos uns com os outros, e as pessoas reclamam:
— Queríamos apenas iniciar a CI, mas acabou que a gestão não precisa disso.
Isso acontece exatamente por causa do CI e processo de Entrega Contínua estão na fronteira de várias especializações. Simplesmente não conseguirão avançar sem superar o problema dos "poços" a nível organizacional, não importa o que façam, e por mais triste que isso seja.
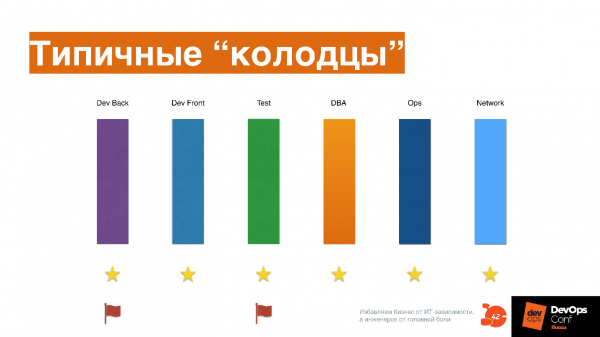
Cada participante do processo na empresa: desenvolvedores de backend e frontend, testadores, DBA, operações, rede, cavando na sua própria direção, e ninguém além do gestor, que os observa e controla com a técnica do "dividir para conquistar", possui um mapa geral.
As pessoas lutam por algumas estrelinhas ou bandeirolas, cada um se dedica à sua própria especialidade.
No final, quando surge a tarefa de conectar tudo isso e construir um pipeline comum, e já não é necessário lutar por estrelinhas e bandeirolas, surge a pergunta — e agora, o que fazer? Precisamos de algum tipo de acordo, mas como fazer isso, ninguém nos ensinou na escola. Estamos ensinados desde a escola: o oitavo ano — uau! — em comparação com o sétimo ano! Aqui é a mesma coisa.
Na sua empresa é assim também?
Para verificar isso, você pode fazer as seguintes perguntas.
As equipes utilizam ferramentas comuns, contribuem para as mudanças dessas ferramentas comuns?
Com que frequência as equipes se reestruturam — alguns especialistas de uma equipe passam para outra? Isso se torna normal no ambiente DevOps, porque às vezes a pessoa simplesmente não consegue compreender o que a outra área de especialização faz. Ela se muda para outro departamento, trabalha lá por duas semanas para criar um mapa de orientação e interação com esse departamento.
É possível criar um comitê de mudança e fazer alguma alteração? Ou isso requer uma mão forte da alta direção e uma ordem? Recentemente escrevi no Facebook sobre como um banco pouco conhecido implementa ferramentas através de ordens: escreveram a ordem, passaram um ano implementando, vendo o que acontece. Isso, claro, é demorado e triste.
Quão importante é para os gerentes obter conquistas pessoais independentemente das conquistas da empresa?
Se você responder a essas perguntas para si mesmo, ficará mais claro se você tem esse problema na sua empresa.
Infraestrutura como código
Depois que esse problema for resolvido, a primeira prática importante, sem a qual é difícil avançar em DevOps, é infraestrutura como código.
Normalmente, a infraestrutura como código é entendida assim:
— Vamos automatizar tudo com bash, usar scripts, para que os administradores tenham menos trabalho manual!
Mas isso não é verdade.
Infraestrutura como código implica que o sistema de TI com o qual você trabalha é descrito em forma de código, para que você entenda constantemente seu estado.
Juntamente com outras equipes, você cria um mapa em forma de código, que seja compreensível a todos, para orientação e navegação. Não importa em que isso é feito — Chef, Ansible, Salt, ou se são usados arquivos YAML no Kubernetes — não faz diferença.
Em uma conferência, um colega da 2GIS contou como eles criaram sua própria ferramenta interna para Kubernetes, que descreve a configuração de sistemas individuais. Para descrever 500 sistemas, eles precisaram de uma ferramenta separada que gera essa descrição. Quando essa descrição existe, qualquer um pode se comparar, monitorar mudanças, como modificá-la e melhorá-la, e o que está faltando.
Concorde que scripts bash separados geralmente não oferecem essa compreensão. Em uma das empresas em que trabalhei, havia até o nome de "script write only" — quando o script é escrito, mas não pode ser lido depois. Acredito que isso seja familiar para você também.
Infraestrutura como código é o código que descreve o estado atual da infraestrutura. Esse código é colaborativamente trabalhado por várias equipes de produtos, infraestrutura e serviços, e, mais importante, todos devem entender como esse código realmente funciona.
O código é mantido de acordo com as melhores práticas de codificação: desenvolvimento colaborativo, revisão de código, programação XP, testes, pull requests, CI para códigos de infraestrutura — tudo isso é válido e pode ser utilizado.
O código torna-se uma linguagem comum para todos os engenheiros.
Modificar a infraestrutura no código não leva muito tempo. Sim, também pode haver dívida técnica no código de infraestrutura. Normalmente, as equipes enfrentam isso cerca de um ano e meio após começarem a implementar "infraestrutura como código" na forma de uma coleção de scripts ou até mesmo Ansible, que eles escrevem como código espaguete, e ainda adicionam scripts bash na mistura!
Importante: se você ainda não experimentou essa coisa ruim, lembre-se de que Ansible não é bash! Leia a documentação com atenção e estude o que dizem sobre isso.
Infraestrutura como código é a divisão do código de infraestrutura em camadas distintas.
Na nossa empresa, destacamos 3 camadas básicas, que são muito claras e simples, mas podem existir mais. Você pode analisar seu código de infraestrutura e determinar se possui essa condição ou não. Se não houver camadas definidas, é necessário reservar um tempo para fazer um pequeno refatoramento.
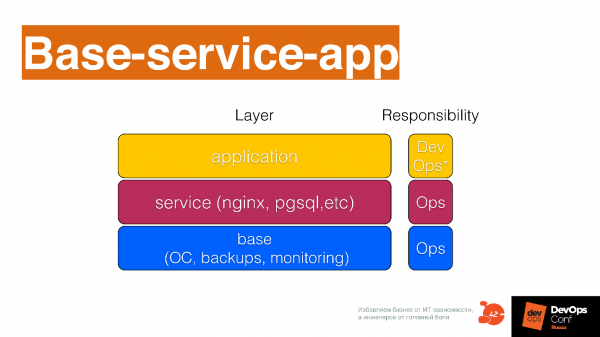
Camada básica — é como o sistema operacional é configurado, backups e outras coisas de baixo nível, como o Kubernetes é implantado em nível básico.
Nível de serviços — são os serviços que você fornece ao desenvolvedor: logging como serviço, monitoramento como serviço, banco de dados como serviço, balanceador como serviço, fila como serviço, Continuous Delivery como serviço — uma série de serviços que diferentes equipes podem disponibilizar para desenvolvimento. Tudo isso deve ser descrito como módulos distintos em seu sistema de gerenciamento de configuração.
Camada onde os aplicativos são feitos e descrito como serão implantados sobre as duas camadas anteriores.
Perguntas de controle
Você tem um repositório de infraestrutura comum na sua empresa? Você controla a dívida técnica na infraestrutura? Utiliza práticas de desenvolvimento no repositório de infraestrutura? Sua infraestrutura está dividida em camadas? Você pode consultar o esquema Base-service-APP. Quão difícil é fazer uma alteração?
Se você enfrentou situações em que fazer alterações levou um dia e meio, isso significa que você acumulou dívida técnica, e precisa trabalhar nisso. Você acabou de encontrar as armadilhas da dívida técnica no código de infraestrutura. Eu me lembro de muitas histórias em que, para mudar algum CCTL, é preciso reescrever metade do código de infraestrutura, porque a criatividade e o desejo de automatizar tudo levaram a um emaranhado, onde tudo ficou muito complicado, e precisa ser refatorado.
Implantação contínua
Vamos analisar o débito e o crédito. Primeiro, aparece uma descrição da infraestrutura, que pode ser bastante básica. Não é necessário descrever tudo em detalhe, mas é preciso ter uma descrição básica para que você possa trabalhar com isso. Caso contrário, fica difícil entender sobre o que construir a entrega contínua. Todas essas práticas se desenrolam simultaneamente quando você entra no DevOps, mas é fundamental começar com o entendimento do que você tem e como gerenciá-lo. Isso é, na verdade, a prática de infraestrutura como código.
Depois que ficou claro o que você tem e como gerenciá-lo, você começa a imaginar como o código do desenvolvedor pode ser enviado para a produção o mais rápido possível. Quero dizer, junto com o desenvolvedor — lembre-se do problema dos 'poços', ou seja, não são pessoas separadas que criam isso, mas sim a equipe.
Quando nós Vania Evtukhovich vimos o primeiro livro Jez Humble e o grupo de autores «Continuous Delivery», que foi lançado em 2009, pensamos por muito tempo sobre como traduzir seu título para o russo. Queríamos traduzir como 'Entregar continuamente', mas, infelizmente, foi traduzido como 'Entrega contínua'. Eu acho que o nosso título tem algo bem russo, com uma força especial.
'Entregar continuamente' significa
O código que está no repositório do produto pode sempre ser lançado na produção. Ele pode não ser lançado, mas está sempre pronto para isso. Assim, você sempre escreve código com uma sensação difícil de explicar de certa inquietação. Isso frequentemente surge quando você implementa o código da infraestrutura. Essa sensação de inquietação deve estar presente — ela provoca processos mentais que permitem escrever código de uma forma um pouco diferente. Isso deve ser registrado nas regras dentro do desenvolvimento.
Para entregar continuamente, é necessário um formato de artefato que percorra a plataforma de infraestrutura. Se você joga resíduos de formatos diferentes pela plataforma de infraestrutura, ela se torna não unificada, é difícil de manter, e surge o problema da dívida técnica. O formato do artefato precisa ser uniformizado — essa também é uma tarefa coletiva: todos precisam se reunir, usar a criatividade e pensar nesse formato.
O artefato está em constante melhoria e mudança para o ambiente de produção enquanto passa pelo pipeline de entrega. Quando o artefato se move pelo pipeline, ele constantemente se depara com situações desconfortáveis que se assemelham às que o artefato encontrado em produção enfrenta. Se na desenvolvimento clássico isso é feito por um administrador de sistema que faz a entrega, no processo DevOps isso acontece continuamente: aqui ele é testado de várias formas, ali é inserido em um cluster Kubernetes, que é semelhante ao ambiente de produção, e, de repente, um teste de carga é iniciado.
Isso é um pouco como o jogo Pac-Man - o artefato passa por uma certa história. Ao mesmo tempo, é importante controlar se o código realmente está passando por essa história e se está de alguma forma relacionado ao seu ambiente de produção. Histórias sobre produção podem ser incorporadas ao processo de Entrega Contínua: acontecia assim quando algo falhou, agora vamos programar esse cenário no sistema. Dessa forma, toda vez que o código passar, ele também enfrentará esse cenário, e você não encontrará essa problemática novamente. Você estará ciente dela muito antes de ela afetar seu cliente.
Diferentes estratégias de deploy. Por exemplo, você utiliza testes A/B ou deploys canary para 'testar' o código com diferentes clientes, coletando informações sobre como o código se comporta, muito antes de ser liberado para 100 milhões de usuários.
Entregar de forma contínua se parece assim.
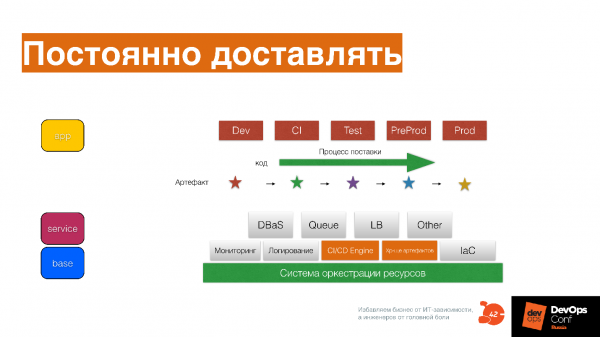
O processo de entrega Dev, CI, Test, PreProd, Prod - não é um ambiente separado, são estágios ou estações com somas inextinguíveis, pelas quais passa seu artefato.
Se você tem código de infraestrutura descrito como Base Service APP, ele ajuda a não esquecer todos os cenários, e a registrá-los também como código para esse artefato, a promover o artefato e a alterá-lo ao longo do caminho.
Perguntas para autoavaliação
O tempo desde a descrição da funcionalidade até a entrega em produção é inferior a uma semana em 95% dos casos? A qualidade do artefato aumenta em cada etapa do pipeline? Existe uma história pela qual ele passa? Você utiliza diferentes estratégias de deploy?
Se todas as respostas forem sim, você é incrivelmente incrível! Escreva suas respostas nos comentários - ficarei feliz em ver).
Feedback
Esta é a prática mais complexa de todas. Na conferência DevOpsConf, um colega da Infobip estava falando sobre isso e se atrapalhou um pouco nas palavras, porque realmente é uma prática muito complicada sobre o que deve ser monitorado em geral.
Por exemplo, há muito tempo, quando eu trabalhava na Qik e percebemos que precisávamos monitorar tudo. Nós fizemos isso, e no Zabbix surgiram 150.000 itens que eram monitorados constantemente. Foi assustador, o diretor técnico revirou os olhos:
— Pessoal, por que você está maltratando o servidor com coisas que não conseguimos entender?
Mas depois aconteceu um caso que mostrou que essa é realmente uma estratégia muito legal.
Um dos serviços começou a falhar constantemente. Inicialmente, ele não falhava; o que é interessante, nenhum código foi acrescentado, porque era um broker básico, que praticamente não tinha funcionalidade de negócios — ele apenas transmitia mensagens entre serviços separados. O serviço não mudava há 4 meses e, de repente, começou a falhar com o erro "Segmentation fault".
Ficamos em choque, abrimos nossos gráficos no Zabbix e descobrimos que, na verdade, há uma semana e meia, o comportamento das requisições no serviço API havia mudado drasticamente. Depois, observamos que a frequência de envio de um determinado tipo de mensagem havia mudado. Após investigação, descobrimos que eram os clientes Android. Perguntamos:
— Pessoal, o que aconteceu com vocês há uma semana e meia?
Em resposta, ouvimos uma história interessante sobre como eles reformularam a interface do usuário. É bem improvável que alguém diga de imediato que mudou a biblioteca HTTP. Para os clientes Android, isso é como trocar o sabonete no banheiro — eles simplesmente não se lembram. No final, após 40 minutos de conversa, descobrimos que eles realmente mudaram a biblioteca HTTP, e isso alterou os tempos padrão. Isso levou a uma mudança no comportamento do tráfego no servidor API, que provocou uma corrida interna no broker, fazendo-o falhar.
Sem monitoramento profundo, isso é impossível de detectar.. Caso exista ainda o problema dos "poços" na organização, onde cada um passa a responsabilidade para o outro, isso pode persistir por anos. Você simplesmente reinicia o servidor porque é impossível resolver o problema. Quando você monitora, rastreia e acompanha todos os eventos que possui, e utiliza o monitoramento como um teste — escreve o código e imediatamente indica como monitorá-lo, também em forma de código (já temos infraestrutura como código), tudo fica claro como o dia. Mesmo problemas complexos são facilmente rastreáveis.
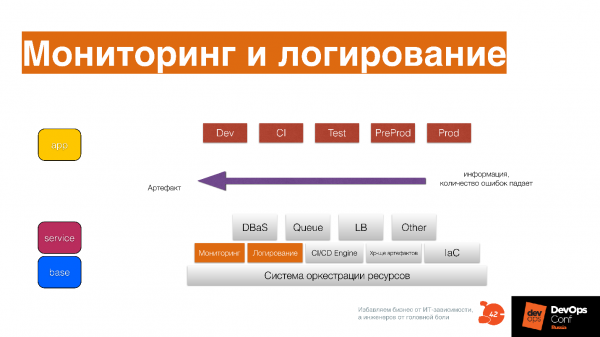
Colete todas as informações sobre o que acontece com o artefato em cada fase do processo de entrega — não em produção.
Carregue o monitoramento no CI, e lá já serão visíveis algumas questões básicas. Depois você as verá tanto no Test quanto no PredProd e nos testes de carga. Colete informações em todas as fases, incluindo não apenas métricas e estatísticas, mas também logs: como o aplicativo foi implantado, anomalias — colete tudo.
Caso contrário, será difícil entender. Já mencionei que DevOps é uma complexidade maior. Para lidar com essa complexidade, é necessário ter uma análise adequada..
Questões para autocontrole.
Seu monitoramento e registro de logs são uma ferramenta de desenvolvimento para você? Seus desenvolvedores, e você também, ao escrever código, pensam em como monitorá-lo?
Você descobre problemas pelos clientes? Você entende o cliente melhor através do monitoramento e do registro de logs? Você entende o sistema melhor através do monitoramento e do registro de logs? Você muda o sistema simplesmente porque viu que a tendência está crescendo e entende que mais 3 semanas e tudo vai desmoronar?
Quando você tem esses três componentes, você pode pensar sobre qual é a plataforma de infraestrutura da sua empresa.
Plataforma de infraestrutura.
O sentido não está no fato de que se trata de um conjunto de ferramentas desconexas que estão em cada empresa.
O sentido da plataforma de infraestrutura é que todas as equipes utilizam essas ferramentas e as desenvolvem em conjunto.
É claro que existem equipes separadas que são responsáveis pelo desenvolvimento de partes específicas da plataforma de infraestrutura. No entanto, a responsabilidade pelo desenvolvimento, funcionalidade e promoção da plataforma de infraestrutura recai sobre cada engenheiro. Em nível interno, isso se torna uma ferramenta comum..
Todas as equipes desenvolvem a plataforma de infraestrutura, tratando-a com cuidado como se fosse seu próprio IDE.. No seu IDE, você instala diferentes plugins para tudo ficar bonito e rápido, além de configurar teclas de atalho. Quando você abre o Sublime, Atom ou Visual Studio Code, aparecem erros de código e você percebe que é impossível trabalhar, fica imediatamente triste e corre para consertar seu IDE.
Trate sua plataforma de infraestrutura da mesma forma. Se você perceber que algo não está certo, faça uma solicitação, caso não consiga corrigir sozinho. Se for algo simples, conserte por conta própria e envie um pull request — a equipe revisa e adiciona. Essa é uma abordagem diferente em relação às ferramentas de engenharia na mente do desenvolvedor.
A plataforma de infraestrutura garante a transferência de artefatos do desenvolvimento para o cliente, com melhora contínua da qualidade.. Na IP, um conjunto de histórias está programado, que ocorre com o código em produção. Ao longo dos anos de desenvolvimento, essas histórias se acumulam, algumas delas são únicas e se referem apenas a você — não é possível encontrá-las na internet.
Nesse momento, a plataforma de infraestrutura se torna sua vantagem competitiva., porque ela contém o que não existe na ferramenta do concorrente. Quanto mais madura sua IP, maior sua vantagem competitiva em termos de Time-to-market. Aqui surge o problema do vendor lock.: você pode adotar a plataforma de alguém, mas ao utilizar a experiência de terceiros, não compreenderá quão relevante ela é para você. Sim, nem toda empresa pode construir uma plataforma como a da Amazon. É uma linha tênue, onde a experiência da empresa é pertinente à sua posição no mercado, e não se deve aceitar vendor lock. Isso também é algo importante para se pensar.
Esquema
Este é o esquema básico da plataforma de infraestrutura, que ajudará você a organizar todas as práticas e processos em uma empresa de DevOps.
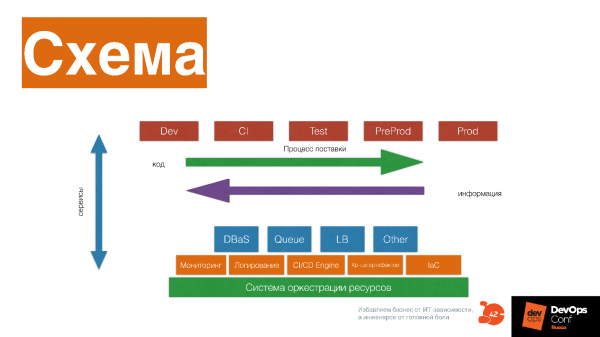
Vamos considerar do que ela é composta.
Sistema de orquestração de recursos, que fornece CPU, memória e disco para aplicativos e outros serviços. Acima disso, existem serviços de baixo nível:monitoramento, registro, CI/CD Engine, armazenamento de artefatos, infraestrutura como código para sistemas.
Serviços de nível superior.: banco de dados como serviço, filas como serviço, Load Balance como serviço, redimensionamento de imagens como serviço, Big Data como serviço. Em cima disso — um pipeline que fornece código constantemente modificado ao seu cliente.
Você obtém informações sobre como seu software está funcionando para o cliente, modifica, fornece novamente esse código, obtém informações — e assim desenvolve continuamente tanto a plataforma de infraestrutura quanto seu software.
Na representação, um delivery pipeline consiste em várias etapas. Mas esta é uma representação conceitual, que serve como exemplo — não deve ser replicada exatamente. As etapas interagem com os serviços como serviços — cada componente da plataforma traz sua própria história: como os recursos são alocados, como o aplicativo é iniciado, trabalha com os recursos, é monitorado e modificado.
É importante entender que cada parte da plataforma traz uma história, e perguntar a si mesmo — que história esse componente traz, talvez seja melhor descartá-lo e substituí-lo por um serviço de terceiros. Por exemplo, é possível substituir um componente pelo Okmeter? Talvez eles já tenham aprimorado essa expertise muito mais do que nós. Mas talvez não — talvez tenhamos uma expertise única e precisemos implementar o Prometheus e desenvolver isso ainda mais.
Criação da plataforma
É um processo de comunicação complexo. Quando você tem práticas básicas, você inicia a comunicação entre diferentes engenheiros e especialistas, que elaboram requisitos e padrões e os modificam constantemente para diferentes ferramentas e abordagens. Aqui, a cultura presente no DevOps é fundamental.
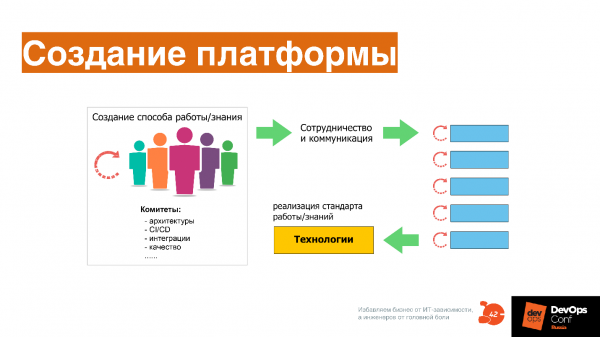
Com a cultura, tudo é muito simples — é colaboração e comunicação, ou seja, a vontade de trabalhar juntos em um espaço comum, o desejo de dominar uma ferramenta juntos. Não há nada de complicado — é tudo muito simples, quase banal. Por exemplo, todos nós vivemos em um prédio e mantemos sua limpeza — esse é o nível de cultura.
E quanto a você?
Novamente, perguntas que você pode se fazer.
A plataforma de infraestrutura está bem definida? Quem é responsável pelo seu desenvolvimento? Você compreende as vantagens competitivas da sua plataforma de infraestrutura?
Essas perguntas devem ser constantemente feitas a si mesmo. Se algo pode ser transferido para serviços externos, deve ser feito; se um serviço externo começa a bloquear seu progresso, então é necessário construir um sistema internamente.
Então, DevOps…
… é um sistema complexo que deve conter:
- Produto digital.
- Módulos de negócios que desenvolvem esse produto digital.
- Equipes de produto que escrevem código.
- Práticas de Continuous Delivery.
- Plataformas como serviço.
- Infraestrutura como serviço.
- Infraestrutura como código.
- Práticas individuais de manutenção de confiabilidade embutidas no DevOps.
- Prática de feedback que descreve tudo isso.
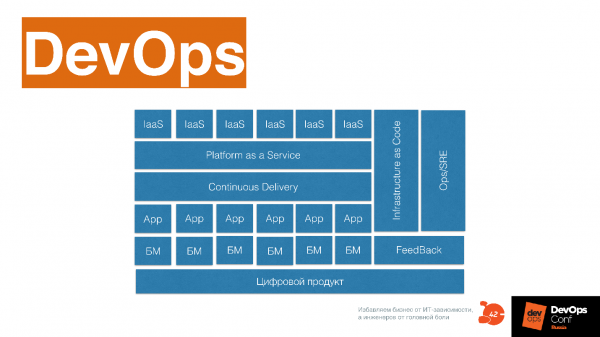
Você pode usar esse esquema, colorindo nele o que você já possui na sua empresa de alguma forma: isso se desenvolveu ou ainda precisa ser desenvolvido.
Daqui a algumas semanas acontecerá . como parte do RIT++. Venha para a conferência, onde você encontrará muitas palestras incríveis sobre entrega contínua, infraestrutura como código e transformação DevOps. , o último prazo para preços é 20 de maio
Fonte: habr.com
