

Abordagem IaC (Infrastructure as Code) não consiste apenas no código que é armazenado no repositório, mas também nas pessoas e processos que cercam esse código. É possível reutilizar abordagens do desenvolvimento de software na gestão e descrição de infraestrutura? Mantenha essa ideia em mente enquanto lê o artigo.
Esta é a transcrição do meu para .
Slides e vídeos
- Execução a seco 2019-04-24
Infraestrutura como histórico de bash
Suponha que você entre em um novo projeto e alguém diga: «temos Infraestrutura como Código». Na realidade, acaba sendo que Infraestrutura como histórico de bash ou, por exemplo, Documentação como histórico de bash. Esta é uma situação bastante real, por exemplo, um caso semelhante foi descrito por Denis Lysenko em sua apresentação , ele contou como, a partir do histórico de bash, eles conseguiram uma infraestrutura bem estruturada no projeto.
Com um certo desejo, pode-se dizer que Infraestrutura como histórico de bash isso é como código:
- a reprodutibilidade: você pode pegar o histórico de bash, executar os comandos de lá, e pode ser que, aliás, você consiga uma configuração funcional como resultado.
- versionamento: você sabe quem acessou e o que fez, novamente, não é certo que isso o levará a uma configuração funcional como resultado.
- história: uma história de quem fez o que. mas você não poderá usá-la se perder o servidor.
O que fazer?
Infraestrutura como Código
Até um caso tão estranho como Infraestrutura como histórico de bash pode ser forçado a se relacionar com Infraestrutura como Código, mas quando quisermos fazer algo mais complicado do que o velho e bom servidor LAMP, chegaremos à conclusão de que esse código precisa ser modificado de alguma forma. Infraestrutura como Código A seguir, gostaria de discutir paralelos entre
e desenvolvimento de software.
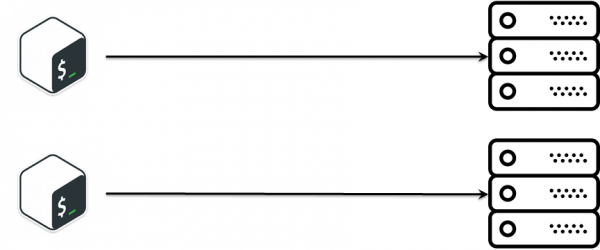
D.R.Y. para configurar periodicamente o SDS
- : lançamos uma nova versão — é necessário implantá-la para testes posteriores. A tarefa é extremamente simples:
- entre aqui via ssh e execute o comando.
- copia o arquivo para lá.
- faça as alterações nas configurações aqui.
- …
- LUCRO!
inicie o serviço lá. , mas com o tempo surgem solicitações para desenvolver algo semelhante, mas um pouco diferente. O primeiro pensamento que vem à mente: copiar e colar. E assim já temos dois scripts muito parecidos que fazem quase a mesma coisa. Com o tempo, o número de scripts aumentou e nos deparamos com uma lógica de negócios para a implantação das instalações que precisava ser sincronizada entre diferentes scripts, o que é bastante complicado.
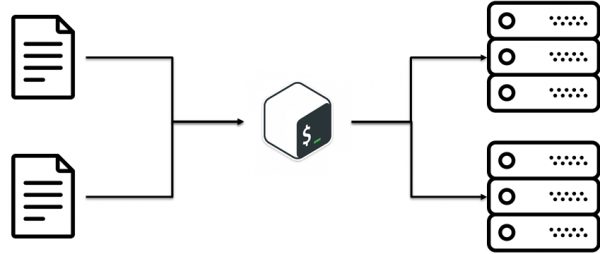
Descobrimos que há uma prática chamada D.R.Y. (Não Repita Você Mesmo). A ideia é reutilizar o código existente. Parece simples, mas não chegamos a isso imediatamente. No nosso caso, foi uma ideia banal: separar as configurações dos scripts. Ou seja, a lógica de negócios de como a instalação é implantada separadamente, as configurações separadamente.
S.O.L.I.D. para CFM
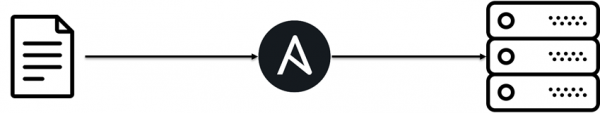
Com o tempo, o projeto cresceu e a introdução do Ansible. A principal razão para sua criação foi a presença de expertise na equipe e que o bash não é adequado para lógica complexa. O Ansible também começou a conter lógica complexa. Para que essa lógica complicada não se torne um caos, existem princípios de organização de código no desenvolvimento de software. S.O.L.I.D. Além disso, por exemplo, Grigory Petrov em sua palestra "Por que um profissional de TI precisa de uma marca pessoal" abordou a questão de que o ser humano é naturalmente inclinado a operar com certas entidades sociais, e, no desenvolvimento de software, isso se refere a objetos. Se combinarmos essas duas ideias e continuarmos a desenvolvê-las, podemos perceber que na descrição da infraestrutura também podemos usar S.O.L.I.D. para que seja mais fácil manter e modificar essa lógica no futuro.
O Princípio da Responsabilidade Única
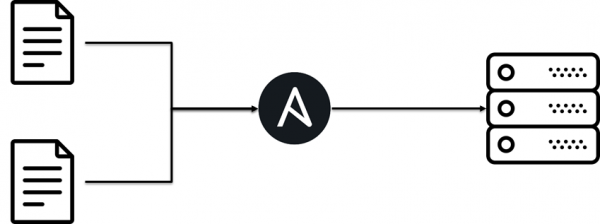
Cada classe realiza apenas uma tarefa.
Não misture código e faça monstros de massa monolíticos. A infraestrutura deve consistir em blocos simples. Descobrimos que se você dividir um playbook do Ansible em pedaços pequenos, ou seja, em roles do Ansible, será mais fácil de manter.
O Princípio Aberto/Fechado
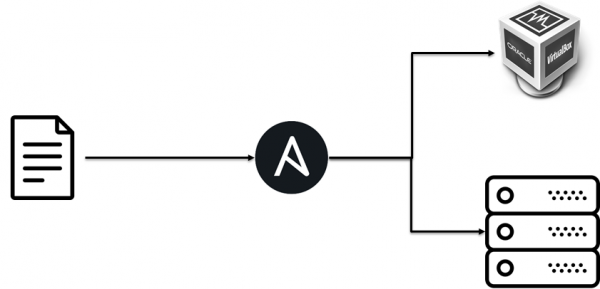
Princípio da Abertura/Fechamento.
- Aberto para extensão: significa que o comportamento da entidade pode ser ampliado criando novos tipos de entidades.
- Fechado para modificação: como resultado da extensão do comportamento da entidade, não devem ser feitas alterações no código que utiliza essas entidades.
Originalmente, implementamos a infraestrutura de teste em máquinas virtuais, mas como a lógica de negócios de implantação estava separada da implementação, conseguimos facilmente adicionar a instalação em bare metal.
O Princípio da Substituição de Liskov
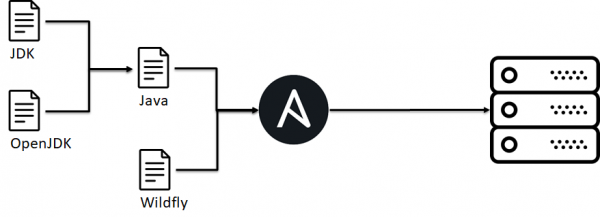
O princípio de substituição de Barbara Liskov. Os objetos no programa devem ser substituíveis por instâncias de seus subtipos sem alterar a correção da execução do programa
Se olharmos de forma mais ampla, não é uma característica de um projeto específico que pode ser aplicada S.O.L.I.D., trata-se em geral de CFM, por exemplo, em outro projeto, é necessário implantar um aplicativo Java em caixa em vários servidores Java, bases de dados, SO, etc. Nesse exemplo, eu analisarei os princípios subsequentes S.O.L.I.D.
No nosso caso, dentro da equipe de infraestrutura, existe um acordo de que se instalarmos o papel imbjava ou oraclejava, temos um arquivo executável binário do Java. Isso é necessário, pois os papéis acima dependem desse comportamento, eles esperam a presença do Java. Ao mesmo tempo, isso nos permite substituir uma implementação/version do Java por outra, sem alterar a lógica de implantação do aplicativo.
O problema aqui reside no fato de que no Ansible não é possível implementar tal, como consequência, surgem alguns acordos dentro da equipe.
O Princípio da Segregação de Interface
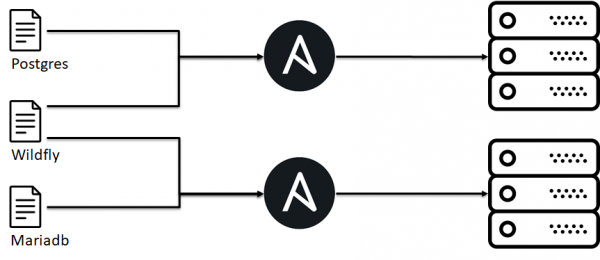
Princípio da segregação de interface: "muitas interfaces, especialmente projetadas para os clientes, são melhores do que uma interface de uso geral."
Originalmente, tentamos consolidar toda a variabilidade da implantação do aplicativo em um único playbook do Ansible, mas foi difícil de manter, e a abordagem em que temos uma interface especificada para fora (o cliente espera a porta 443) permite que, para uma implementação específica, a infraestrutura seja composta de blocos separados.
O Princípio da Inversão de Dependência
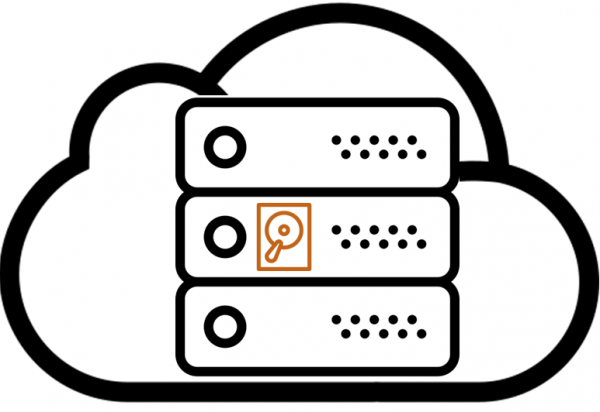
Princípio da inversão de dependências. Módulos de níveis superiores não devem depender de módulos de níveis inferiores. Ambos os tipos de módulos devem depender de abstrações. As abstrações não devem depender de detalhes. Os detalhes devem depender das abstrações.
Neste exemplo, será baseado em um antipadrão.
- Um dos clientes tinha uma nuvem privada.
- Dentro da nuvem, solicitamos máquinas virtuais.
- Mas, devido às características da nuvem, a implantação do aplicativo estava vinculada ao hipervisor em que a VM foi provisionada.
Ou seja, a lógica de alto nível de implantação do aplicativo e as dependências ocorriam nos níveis subjacentes do hipervisor, e isso significava problemas ao reutilizar essa lógica. Não é assim que se faz.
Interação
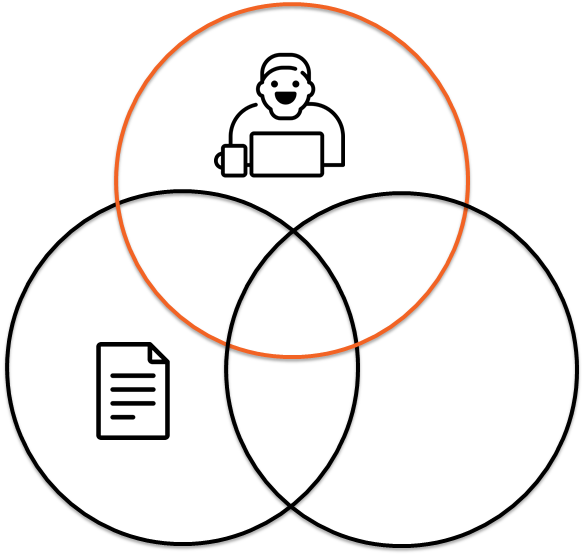
Infraestrutura como código não se trata apenas de código, mas também das relações entre o código e o ser humano, sobre as interações entre os desenvolvedores de infraestrutura.
Fator Bus
Suponha que você tenha um funcionário chamado Vasya em seu projeto. Vasya sabe tudo sobre sua infraestrutura; o que aconteceria se ele simplesmente desaparecesse? Essa é uma situação bem real, pois ele pode ser atropelado por um ônibus. Às vezes, isso acontece. Se ocorrer e o conhecimento sobre o código, sua estrutura, como ele funciona, segredos e senhas não estiver distribuído na equipe, você pode enfrentar uma série de situações desagradáveis. Para minimizar esses riscos e espalhar o conhecimento na equipe, várias abordagens podem ser utilizadas.
DevOps em Par
Não é como , onde os administradores bebiam cerveja, trocavam senhas, e uma analogia ao programação em par. Ou seja, dois engenheiros se sentam em um computador, uma única tecla e começam a configurar juntos sua infraestrutura: ajustar o servidor, escrever um papel do Ansible, etc. Parece bonito, mas não funcionou para nós. No entanto, casos específicos dessa prática tiveram sucesso. Um novo funcionário chegou, seu mentor pega uma tarefa real junto com ele, trabalha — transmite conhecimento.
Outro caso específico é a chamada de incidente. Durante um problema, um grupo de plantão e envolvidos se reúne, é nomeado um líder que compartilha sua tela e verbaliza seu raciocínio. Os outros participantes seguem o pensamento do líder, espiam truques no console, verificam se alguma linha do log foi esquecida, aprendem algo novo sobre o sistema. Essa abordagem costuma ser mais eficaz do que não.
Revisão de Código
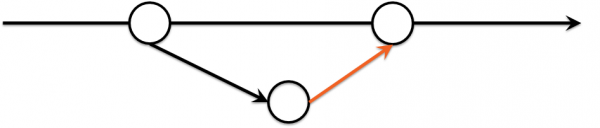
Subjetivamente, a disseminação de conhecimento sobre infraestrutura e como ela é construída foi mais eficaz por meio de revisão de código:
- A infraestrutura é descrita em código no repositório.
- As alterações ocorrem em uma branch separada.
- Na solicitação de merge, é possível ver a diferença nas mudanças na infraestrutura.
O ponto interessante aqui foi que os revisores eram escolhidos por rotação, de acordo com um cronograma, ou seja, havia uma probabilidade de você entrar em uma nova parte da infraestrutura.
Estilo de Código
Com o tempo, começaram a surgir desavenças durante as revisões, pois os revisores tinham seus próprios estilos e a rotatividade de revisores os empilhava com diferentes estilos: 2 espaços ou 4, camelCase ou snake_case. Implementar isso não foi imediato.
- A primeira ideia foi recomendar o uso de um linter, afinal, são todos engenheiros, todos inteligentes. Mas diferentes editores e sistemas operacionais tornavam isso inconveniente.
- Isso evoluiu para um bot que, a cada commit problemático, escrevia no Slack e anexava a saída do linter. Mas, na maioria das vezes, havia questões mais importantes e o código permanecia sem correções.
Green Build Master
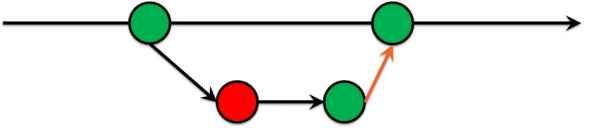
O tempo passou e chegamos à conclusão de que não se pode permitir commits no master que não passem certos testes. Voilà! Inventamos o Green Build Master, que já é uma prática há muito tempo na desenvolvê-lo software:
- O desenvolvimento ocorre em um ramo separado.
- Testes são executados nesse ramo.
- Se os testes falharem, o código não irá para o master.
Tomar esta decisão foi bastante doloroso, pois gerou muitas disputas, mas valeu a pena, pois as solicitações de mesclagem começaram a chegar sem divergências de estilo e, com o tempo, a quantidade de problemas diminuiu.
IaC Testing
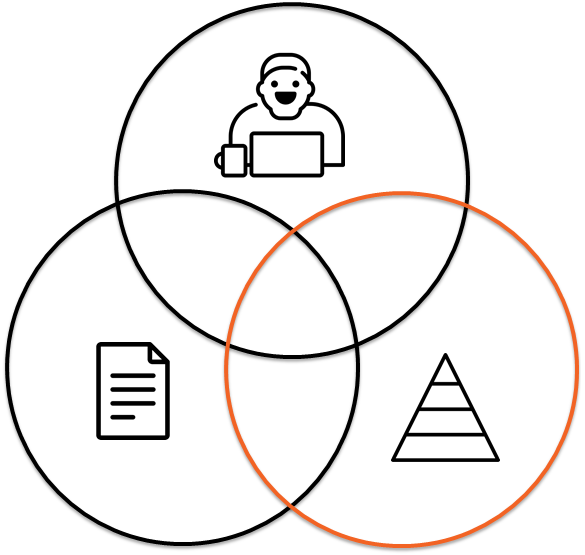
Além de verificar o estilo, também é possível usar outras abordagens, como verificar se sua infraestrutura realmente pode ser implantada. Ou verificar se mudanças na infraestrutura não levarão a perda de dinheiro. Por que isso pode ser necessário? A pergunta é complexa e filosófica; é melhor responder com uma história: havia uma auto-escaladora em PowerShell que, sem checar condições limites, criou mais VMs do que o necessário, fazendo com que o cliente gastasse mais do que havia planejado. Não é nada agradável, mas esse erro poderia ter sido identificado em estágios anteriores.
Pode-se perguntar: por que tornar uma infraestrutura complexa ainda mais complicada? Testes para infraestrutura, assim como para código, não se tratam de simplificação, mas de entender como sua infraestrutura deve funcionar.
IaC Testing Pyramid
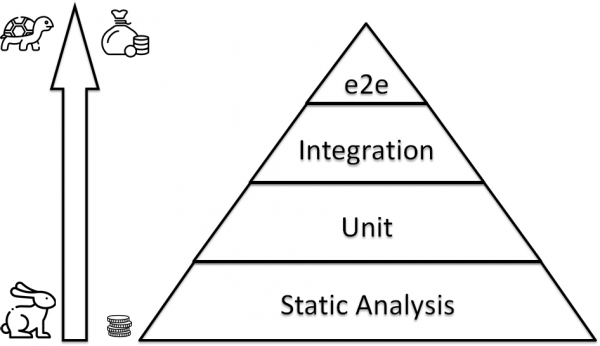
IaC Testing: Static Analysis
Se você implantar toda a infraestrutura de uma vez e verificar se ela funciona, poderá descobrir que isso leva muito tempo e requer muitos recursos. Portanto, deve haver algo que funcione rapidamente, que seja abundante e que cubra muitos pontos primitivos.
Bash é complicado
Vamos a considerar um exemplo simples. Selecionar todos os arquivos no diretório atual e copiá-los para outro lugar. A primeira coisa que vem à mente:
for i in * ; do
    cp $i /some/path/$i.bak
done
E se houver um espaço no nome do arquivo? Bem, tudo bem, somos inteligentes, sabemos usar aspas:
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneParabéns? Não! E se não houver nada no diretório, ou seja, o globbing não funcionar.
find . -type f -exec mv -v {} dst/{}.bak ;Agora estamos prontos? Não... Esquecemos que pode haver n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Ferramentas de análise estática
O problema do passo anterior poderia ser detectado quando esquecemos as aspas, para isso existem muitos mecanismos , na verdade há muitos, e provavelmente você encontrará um linter para seu IDE para sua pilha.
Linguagem
Ferramenta
bash
Ruby
python
ansible
Teste IaC: Testes unitários
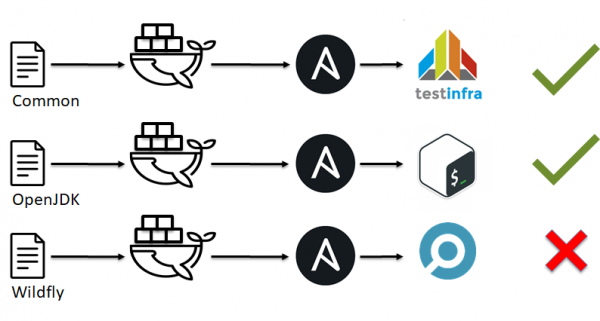
Como vimos no exemplo anterior, os linters não são onipotentes e não podem indicar todos os pontos problemáticos. Seguindo a analogia com os testes em desenvolvimento de software, podemos lembrar dos testes unitários. De imediato, surgem na mente , , , . Mas o que fazer com ansible, chef, saltstack e afins?
No início, falamos sobre S.O.L.I.D. e o fato de que nossa infraestrutura deve consistir em pequenos blocos. Chegou a vez deles.
- A infraestrutura é decomposta em pequenos blocos, como papéis do Ansible.
- Um ambiente é implantado, seja ele docker ou VM.
- Aplicamos nosso papel do Ansible a esse ambiente de teste.
- Verificamos se tudo funcionou como esperávamos (executamos os testes).
- Decidimos se está ok ou não.
Teste IaC: Ferramentas de testes unitários
A pergunta, o que são testes para CFM? Pode-se simplesmente executar um script, ou pode-se usar soluções prontas para isso:
CFM
Ferramenta
Ansible
Chef
Chef
saltstack
Exemplo para testinfra, verificamos se os usuários test1, test2 existem e estão no grupo sshusers:
def test_default_users(host):
    users = ['test1', 'test2' ]
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
O que escolher? A questão é complexa e não é simples, aqui está um exemplo de mudanças em projetos no github entre 2018-2019:
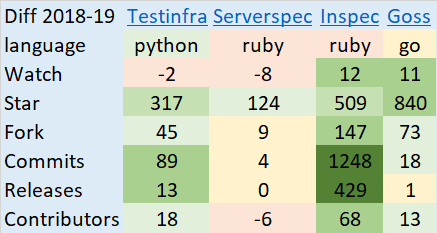
Frameworks de teste IaC
Como juntar tudo isso e executar? É possível desde que haja um número suficiente de engenheiros. Mas pode-se usar soluções prontas, embora não haja muitas:
CFM
Ferramenta
Ansible
Chef
Terraform
Um exemplo de mudanças em projetos no github entre 2018-2019:
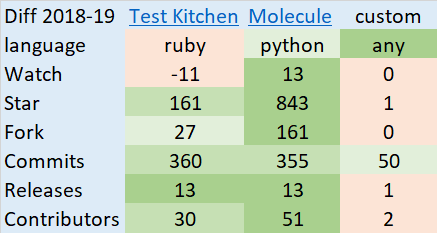
Molecule vs. Testkitchen
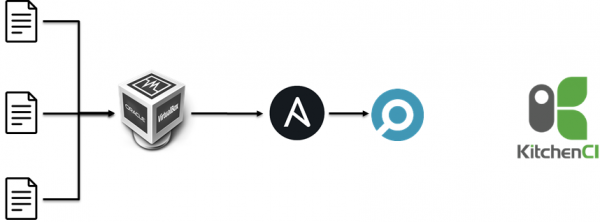
Inicialmente, tentamos usar testkitchen :
- Criar VM em paralelo.
- Aplicar funções Ansible.
- Executar inspec.
Para 25-35 funções, isso levou de 40 a 70 minutos, o que foi muito longo.
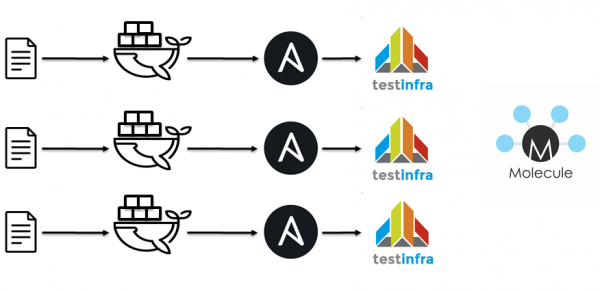
O próximo passo foi a transição para Jenkins / Docker / Ansible / Molecule. Ideologicamente, tudo permanece o mesmo.
- Lintrar os playbooks.
- Lintrar as funções.
- Iniciar o contêiner.
- Aplicar funções Ansible.
- Executar testinfra.
- Verificar a idempotência.
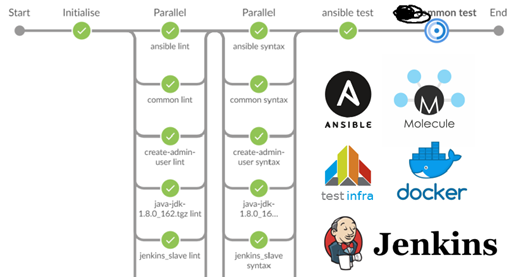
A lintagem para 40 funções e testes para uma dezena passaram a levar cerca de 15 minutos.
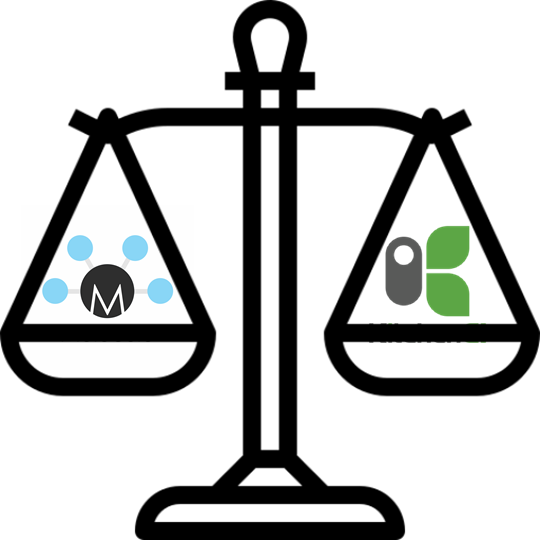
O que escolher depende de muitos fatores, como a pilha utilizada, a expertise da equipe, etc. Aqui, cada um decide como abordar a questão dos testes unitários.
Teste IaC: Testes de Integração.
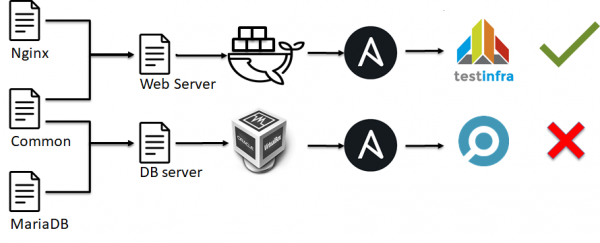
Na próxima etapa da pirâmide de testes de infraestrutura, aparecem os testes de integração. Eles são semelhantes aos testes unitários:
- A infraestrutura é dividida em pequenos blocos, como funções Ansible.
- Um ambiente é implantado, seja ele docker ou VM.
- Esse ambiente de teste é aplicado. múltiplas Funções Ansible.
- Verificamos se tudo funcionou como esperado (executamos os testes).
- Decidimos se está ok ou não.
De forma simplificada, não testamos o funcionamento de um único elemento do sistema como nos testes unitários; testamos como o servidor está configurado como um todo.
Teste IaC: Testes de Final a Final.
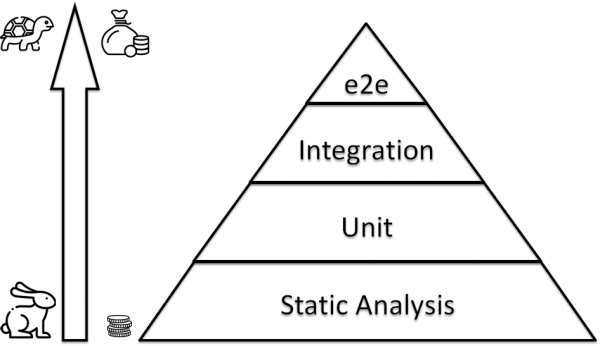
No topo da pirâmide, encontramos os testes de Final a Final. Ou seja, não testamos o funcionamento de um único servidor, um único script, ou um único bloco da nossa infraestrutura. Testamos se múltiplos servidores, unidos, fazem nossa infraestrutura funcionar como esperamos. Infelizmente, não tenho visto soluções prontas, provavelmente porque a infraestrutura costuma ser única e difícil de templatear e criar um framework para testes. Como resultado, todos criam suas próprias soluções. Há demanda, mas a resposta não existe. Portanto, vou compartilhar o que existe, para inspirar outros a refletirem ou para que me indiquem que tudo já foi inventado antes de nós.
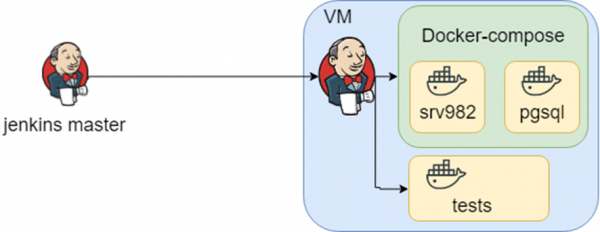
Um projeto com uma história rica. Utilizado em grandes organizações e, provavelmente, cada um de vocês já teve contato indireto com ele. O aplicativo suporta diversas bases de dados, integrações, etc. O conhecimento sobre como a infraestrutura pode parecer envolve vários arquivos docker-compose, e saber quais testes executar em qual ambiente — isso é Jenkins.
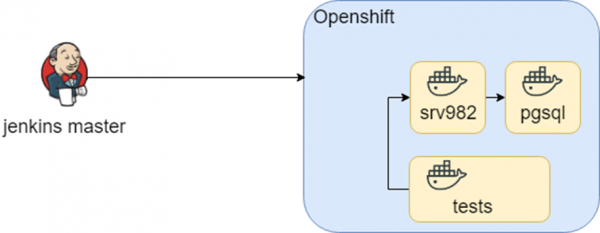
Esse esquema funcionou por um longo tempo, até que, no âmbito tentamos transferi-lo para o Openshift. Os contêineres permanecem os mesmos, mas o ambiente de execução mudou (olá D.R.Y. novamente).
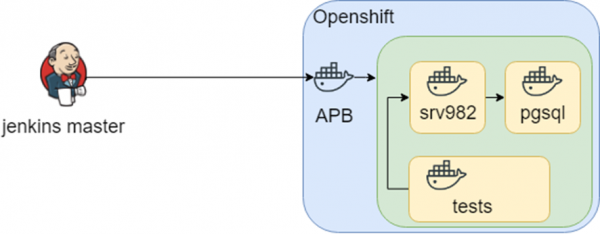
A ideia da pesquisa foi além e no openshift encontramos algo chamado APB (Ansible Playbook Bundle), que permite empacotar o conhecimento sobre como implantar a infraestrutura em um contêiner. Ou seja, existe um ponto de conhecimento reprodutível e testável sobre como implantar a infraestrutura.
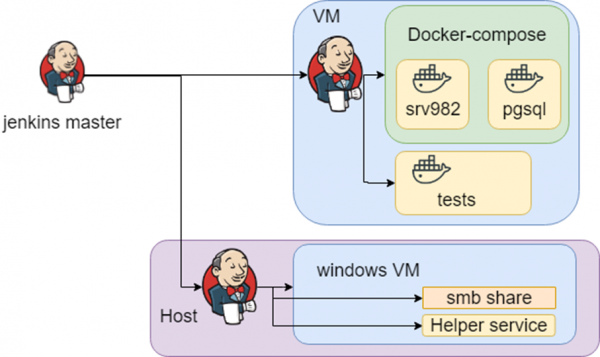
Tudo isso soou bem até nos depararmos com uma infraestrutura heterogênea: precisamos de Windows para os testes. No fim, o conhecimento sobre o que, onde e como implantar e testar está no jenkins.
Conclusão
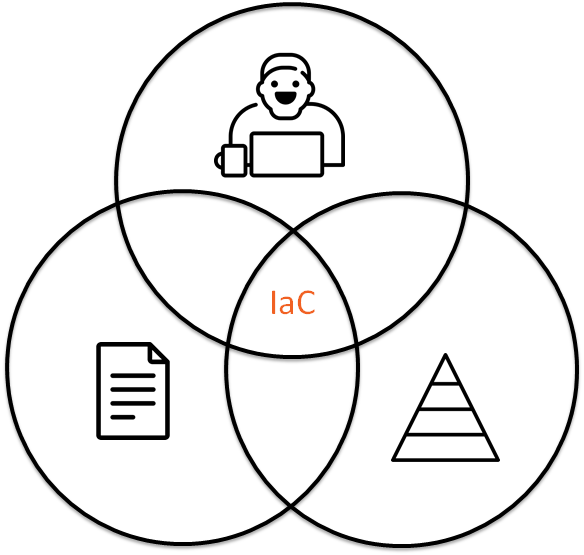
Infrastructure as Code é
- Código no repositório.
- Interação entre pessoas.
- Testando a infraestrutura.
links
- Execução a seco 2019-04-24
- &
Fonte: habr.com
