

Saudações, habr.
Se alguém está explorando o sistema e enfrentou problemas de desempenho de armazenamento (I/O, espaço em disco consumido), a probabilidade de ter considerado ClickHouse como uma substituição deve se aproximar de um. Esta afirmação implica que uma implementação de terceiros já está sendo usada como receptor de métricas, como ou .
ClickHouse resolve bem os problemas descritos. Por exemplo, após transferir 2TiB de dados do whisper, eles caberam em 300GiB. Não vou detalhar a comparação, há muitos artigos sobre o assunto. Além disso, até recentemente, nosso armazenamento ClickHouse não estava totalmente ideal.
Problemas com o espaço consumido
À primeira vista, tudo deve funcionar bem. Seguindo , criamos a configuração para o esquema de armazenamento de métricas (daqui em diante retention), em seguida, criamos uma tabela de acordo com a recomendação do backend escolhido para graphite-web: + ou , dependendo da pilha utilizada. E... uma bomba-relógio é ativada.
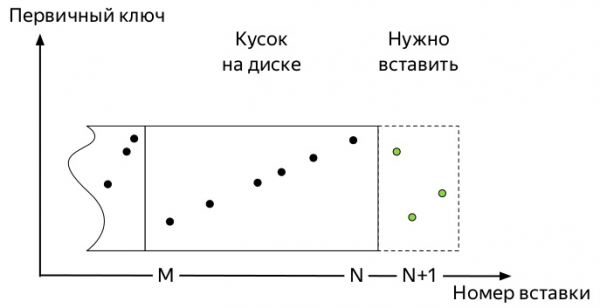
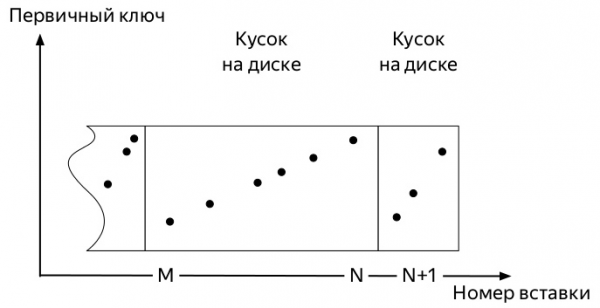
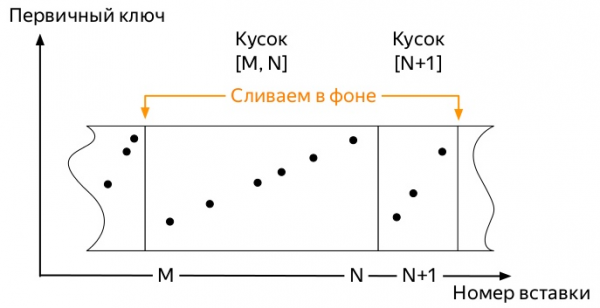
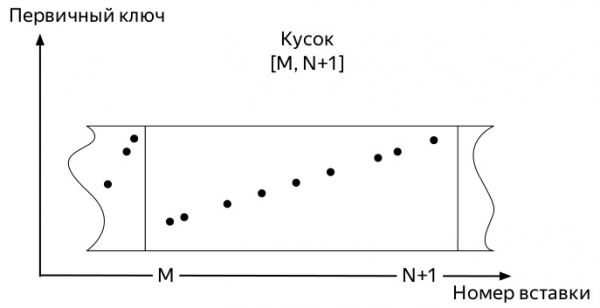
Para entender qual é, precisamos saber como funcionam as inserções e o caminho que os dados percorrem nas tabelas dos motores da família *MergeTree ClickHouse (diagramas retirados de Aleksei Zatelepina):
- Um
blocode dados é inserido. No nosso caso, essas são métricas.

- Cada bloco é ordenado antes de ser gravado no disco, de acordo com a chave
FUNÇÃO AGREGADA DEFINIDA PELO USUÁRIO CLR, especificada na criação da tabela. - Após a ordenação,
um pedaço(part) de dados é gravado no disco.
- O servidor monitora em segundo plano para que não haja muitos desses pedaços, e inicia
fusões(mesclar, após isso, as merges).
- O servidor para de iniciar merges automaticamente assim que os dados param de ser inseridos ativamente na
partição(partition), mas o processo pode ser iniciado manualmente com o comandoOPTIMIZE. - Se sobrar apenas um pedaço na partição, não será possível iniciar a merge com um comando normal, sendo necessário usar
OPTIMIZE ... FINAL
Assim, as primeiras métricas chegam. E elas ocupam um certo espaço. Os eventos subsequentes podem variar dependendo de muitos fatores:
- A chave de particionamento pode ser muito pequena (um dia) ou muito grande (vários meses).
- A configuração de retention pode conter vários limites significativos de agregação de dados dentro da partição ativa (onde as métricas estão sendo gravadas), ou pode não conter.
- Se houver muitos dados, os primeiros pedaços, que devido a fusões em segundo plano podem já ser enormes (ao escolher uma chave de partição subótima), não serão mais mesclados com os novos pedaços pequenos.
E sempre termina da mesma forma. O espaço ocupado pelas métricas no ClickHouse só aumenta se:
- não aplicarmos
OPTIMIZE ... FINALmanualmente ou - não inserirmos dados em todas as partições regularmente, para que, cedo ou tarde, uma fusão em segundo plano possa ser iniciada.
O segundo método parece o mais simples de implementar e, portanto, é o errado, e foi testado em primeiro lugar.
Escrevi um script Python bastante simples que enviava métricas fictícias para cada dia dos últimos 4 anos e era executado a cada hora pelo cron.
Uma vez que todo o trabalho do ClickHouse DBMS é baseado no fato de que este sistema fará eventualmente todo o trabalho em segundo plano, mas não se sabe quando, não consegui esperar pelo momento em que os antigos pedaços enormes decidissem começar a mesclar com os novos pedaços pequenos. Ficou claro que precisava encontrar uma maneira de automatizar as otimizações forçadas.
As informações nas tabelas do sistema ClickHouse
Vamos olhar para a estrutura da tabela . Esta é uma informação abrangente sobre cada pedaço de todas as tabelas no servidor ClickHouse. Contém, entre outras coisas, as seguintes colunas:
- nome do banco de dados (
database); - nome da tabela (
table); - nome e ID da partição (
partition&partition_id); - quando o pedaço foi criado (
modification_time); - data mínima e máxima no pedaço (a partição é feita por dias) (
min_date&max_date);
Há também uma tabela , com os seguintes campos interessantes:
- nome do banco de dados (
Tables.database); - nome da tabela (
Tables.table); - idade da métrica, quando a próxima agregação deve ser aplicada (
age);
Então:
- Temos uma tabela de pedaços e uma tabela de regras de agregação.
- Unimos sua interseção e obtemos todas as tabelas *GraphiteMergeTree.
- Estamos procurando todas as partições onde:
- há mais de um pedaço
- ou chegou o momento de aplicar a próxima regra de agregação, e
modification_timeé mais velho que esse momento.
Implementação
Esta consulta
SELECIONE
    concat(p.database, '.', p.table) AS tabela,
    p.partition_id AS id_partição,
    p.partition AS partição,
    -- A "regra mais antiga" que pode ser aplicada a
    -- partição, mas não no futuro, veja (*)
    max(g.age) AS idade,
    -- Número de pedaços na partição
    countDistinct(p.name) AS partes,
    -- A métrica mais antiga na partição é considerada 00:00:00 do dia seguinte
    toDateTime(max(p.max_date + 1)) AS max_tempo,
    -- Quando a partição deve ser otimizada
    max_tempo + idade AS tempo_rollup,
    -- Quando o pedaço mais antigo na partição foi atualizado
    min(p.modification_time) AS atualizado_em
FROM system.parts AS p
INNER JOIN
(
    -- Todas as regras para todas as tabelas *GraphiteMergeTree
    SELECIONE
        Tables.database AS database,
        Tables.table AS table,
        idade
    FROM system.graphite_retentions
    ARRAY JOIN Tables
    GRUPAR POR
        database,
        table,
        idade
) AS g ON
    (p.table = g.table)
    AND (p.database = g.database)
WHERE
    -- Apenas pedaços ativos
    p.active
    -- (*) E apenas linhas onde as regras de agregação já devem ser aplicadas
    AND ((toDateTime(p.max_date + 1) + g.idade) < now())
GRUPAR POR
    tabela,
    partição
HAVING
    -- Apenas partições que são mais jovens que o momento da otimização
    (atualizado_em  1)
ORDER BY
    tabela ASC,
    partição ASC,
    idade ASC
retorna cada uma das partições das tabelas *GraphiteMergeTree, cujas mesclagens devem resultar na liberação de espaço em disco. Agora resta apenas passar por todas elas com a consulta OPTIMIZE ... FINAL. Na implementação final, também foi considerado que as partições com gravação ativa não precisam ser tocadas.
É exatamente isso que faz o projeto . Antigos colegas do Yandex.Market testaram-no em produção, o resultado do trabalho pode ser visto abaixo.
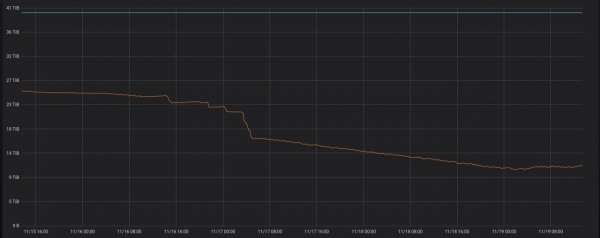
Se você executar o programa em um servidor com ClickHouse, ele começará a funcionar em modo daemon. Uma vez por hora, uma consulta será executada, verificando se novas partições com mais de três dias estão disponíveis para otimização.
Nos planos mais próximos está fornecer, pelo menos, pacotes deb e, se possível, também rpm.
Em conclusão
Nos últimos 9 meses, passei muito tempo dentro da minha empresa mergulhando na interseção entre ClickHouse e graphite-web. Foi uma boa experiência, cujo resultado possibilitou a rápida transição de whisper para ClickHouse como repositório de métricas. Espero que este artigo seja uma espécie de início de um ciclo sobre as melhorias que fizemos em várias partes deste stack e o que será feito no futuro.
O desenvolvimento do pedido consumiu alguns litros de cerveja e dias de administração em conjunto com , pelo que quero expressar minha gratidão. E também pela revisão deste artigo.
Fonte: habr.com
