

Atualmente, o tema DevOps está em alta. O pipeline de integração e entrega contínua está sendo adotado por todos que não estão ociosos. Mas a maioria nem sempre presta a devida atenção à garantia da confiabilidade das operações dos sistemas de informação em diferentes etapas do CI/CD Pipeline. Neste artigo, gostaria de compartilhar minha experiência na automação de verificações de qualidade de software e na implementação de possíveis cenários para a sua "auto-recuperação".
Eu trabalho como engenheiro no departamento de gerenciamento de serviços de TI da empresa . Minha especialização é a implementação de diferentes sistemas de monitoramento de desempenho e disponibilidade de aplicativos. Frequentemente me comunico com clientes de TI de diversos segmentos de mercado sobre questões relevantes relacionadas ao monitoramento da qualidade de seus serviços de TI. A principal tarefa é minimizar o tempo do ciclo de lançamento e aumentar a frequência de lançamento. Isso, é claro, é tudo muito bom: mais lançamentos – mais novas funcionalidades – mais usuários satisfeitos – mais lucros. Mas, na prática, nem sempre tudo acontece bem. Com velocidades de implantação muito altas, surge imediatamente a questão da qualidade de nossos lançamentos. Mesmo em um pipeline totalmente automatizado, um dos maiores problemas é a transferência de serviços de teste para produção, sem impactar o tempo de operação contínua e a interação dos usuários com o aplicativo.
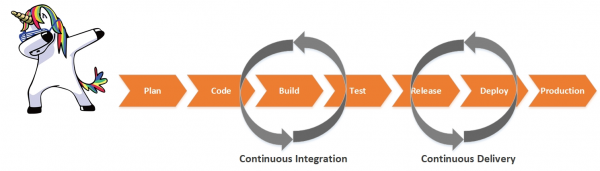
Após numerosas conversas com clientes, posso afirmar que o controle da qualidade dos lançamentos, o problema da confiabilidade do aplicativo e a possibilidade de "auto-recuperação" (por exemplo, revertendo para uma versão estável) em diferentes etapas do pipeline CI/CD estão entre os tópicos mais preocupantes e relevantes.
Recentemente, trabalhei como cliente – no serviço de suporte de aplicativos de um banco online. Na arquitetura do nosso aplicativo, era utilizado um grande número de microsserviços feitos sob medida. O mais triste é que nem todos os desenvolvedores conseguiam acompanhar o ritmo acelerado de desenvolvimento, a qualidade de alguns microsserviços sofria, gerando apelidos engraçados para eles e seus criadores. Surgiram histórias sobre os materiais usados para criar esses produtos.
"Definição do Problema"
A alta frequência de lançamentos e o grande número de microsserviços dificultam a compreensão do funcionamento do aplicativo como um todo, tanto na fase de testes quanto na fase de operação. As mudanças ocorrem constantemente e monitorá-las sem boas ferramentas de monitoramento é muito difícil. Muitas vezes, após um lançamento noturno, de manhã os desenvolvedores ficam como em uma barrica de pólvora, esperando que nada quebre, embora todas as verificações na fase de testes tenham sido bem-sucedidas.
Há mais um aspecto a considerar. Na fase de testes, a funcionalidade do software é verificada: a execução das funções principais do aplicativo e a ausência de erros. As avaliações de qualidade de desempenho ou são inexistentes ou não levam em conta todos os aspectos do funcionamento do aplicativo e da camada de integração. Algumas métricas podem nem ser verificadas. Como resultado, quando ocorre uma falha no ambiente produtivo, o departamento de suporte técnico só toma conhecimento disso quando os usuários reais começam a reclamar. É desejável minimizar a influência de software de baixa qualidade sobre os usuários finais.
Uma das maneiras de resolver isso é implementar processos de verificação de qualidade do software em várias etapas do Pipeline CI/CD, adicionando diferentes cenários para recuperação do sistema em caso de falhas. Também lembramos que temos o DevOps. O negócio espera obter o novo produto o mais rápido possível. Portanto, todas as nossas verificações e cenários devem ser automatizados.
A tarefa é dividida em duas partes:
- monitoramento da qualidade de compilações na fase de testes (automatizar o processo de identificação de compilações de baixa qualidade);
- monitoramento da qualidade do software em ambiente produtivo (mecanismos de detecção automática de problemas e possíveis cenários para sua auto-recuperação).
ferramenta para monitoramento e coleta de métricas
Para realizar as tarefas propostas, é necessário um sistema de monitoramento capaz de detectar problemas e transmiti-los para sistemas de automação em diferentes etapas do pipeline CI/CD. Além disso, seria um ponto positivo se esse sistema fornecesse métricas úteis para diferentes equipes: desenvolvimento, testes e operação. E seria ainda mais maravilhoso se também beneficiasse os negócios.
Para coletar métricas, você pode usar uma combinação de vários sistemas (Prometheus, ELK Stack, Zabbix, etc.), mas, na minha opinião, para essas tarefas, as soluções da classe APM são as mais adequadas (), que podem facilitar muito a sua vida.
No âmbito do meu trabalho na equipe de suporte, comecei a desenvolver um projeto semelhante, utilizando a solução da classe APM da empresa Dynatrace. Atualmente, trabalhando como integrador, conheço bem o mercado de sistemas de monitoramento. Minha opinião subjetiva: Dynatrace é a mais adequada para resolver essas questões.
A solução Dynatrace oferece uma visualização horizontal de cada operação do usuário, com um elevado nível de detalhamento até o nível de execução do código. É possível rastrear toda a cadeia de interações entre os diferentes serviços de informações: desde os níveis de aplicações web e móveis front-end, servidores de aplicações back-end, barramento de integração até uma chamada específica no banco de dados.
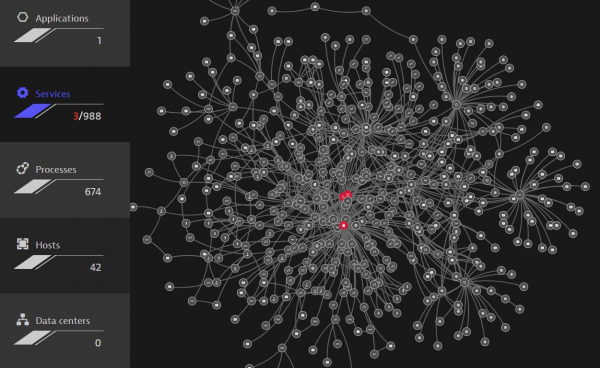 . A construção automática de todas as dependências entre os componentes do sistema
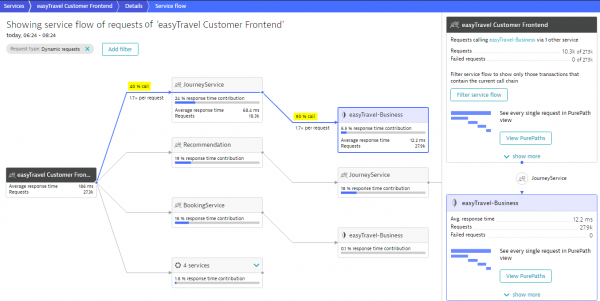 . A identificação e construção automática do caminho de execução da operação do serviço.
Também devemos lembrar que precisamos nos integrar a diferentes ferramentas de automação. Aqui, a solução possui uma API conveniente, que permite enviar e receber várias métricas e eventos.
Vamos agora considerar em mais detalhes como resolver as tarefas propostas utilizando o sistema Dynatrace.
Tarefa 1. Automação do controle de qualidade das builds na fase de teste.
A primeira tarefa é detectar problemas o mais cedo possível nas etapas do pipeline de entrega da aplicação. Apenas as builds de código 'boas' devem chegar ao ambiente de produção. Para isso, monitores adicionais para verificar a qualidade dos seus serviços devem ser incluídos no seu pipeline na fase de teste.
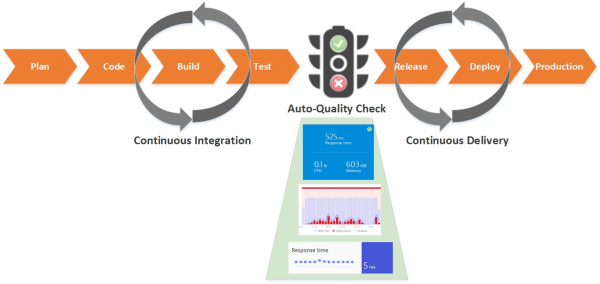
Vamos analisar passo a passo como isso pode ser realizado e automatizado:
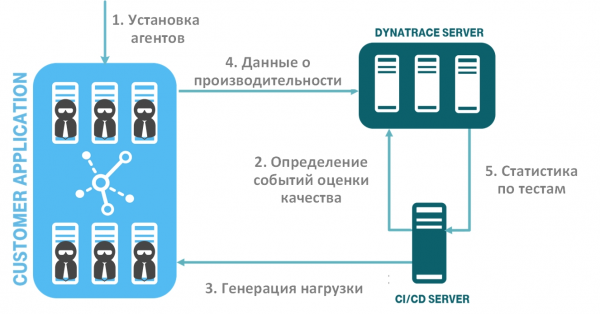
Na figura, estão mostrados os passos automatizados do processo de verificação da qualidade do software:
- implementação do sistema de monitoramento (instalação de agentes);
- definição de eventos de avaliação da qualidade do seu software (métricas e valores de limite) e transmissão deles para o sistema de monitoramento;
- geração de carga e testes de desempenho;
- coleta de dados sobre desempenho e disponibilidade no sistema de monitoramento;
- transferência de dados sobre testes baseados em eventos de avaliação da qualidade do software do sistema de monitoramento para o sistema CI/CD. Análise automática de builds.
Passo 1. Implantação do sistema de monitoramento
Primeiro, é necessário instalar os agentes em seu ambiente de teste. A solução Dynatrace tem uma característica agradavelmente única – ela utiliza um agente universal OneAgent, que é instalado no instante do SO (Windows, Linux, AIX), detecta automaticamente seus serviços e começa a coletar dados de monitoramento. Você não precisa configurar agentes separadamente para cada processo. A mesma situação se aplicará a plataformas em nuvem e plataformas de contêineres. Além disso, o processo de instalação dos agentes também pode ser automatizado. A Dynatrace se encaixa perfeitamente no conceito de "infraestrutura como código" (): já existem scripts prontos e instruções para todas as plataformas populares. Você incorpora o agente na configuração do seu serviço, e ao implantá-lo, você já obtém um novo serviço com o agente funcionando.
Passo 2. Definição dos eventos de avaliação da qualidade do seu software
Agora é preciso definir a lista de serviços e operações de negócios. É importante considerar precisamente aquelas operações dos usuários que são críticas para o seu serviço. Recomendo consultar analistas de negócios e analistas de sistemas.
Em seguida, você deve determinar quais métricas deseja incluir na verificação para cada um dos níveis. Por exemplo, isso pode incluir tempo de execução (com divisão entre média, mediana, percentis, etc.), erros (lógicos, de serviço, de infraestrutura, etc.) e várias métricas de infraestrutura (memory heap, garbage collector, thread count, etc.).
Para automação e conveniência da equipe DevOps, surge o conceito de "Monitoramento como código". O que eu quero dizer com isso é que um desenvolvedor/testador pode escrever um simples arquivo JSON que define as métricas de verificação da qualidade do software.
Vamos considerar um exemplo desse arquivo JSON. Como um par chave/valor, são usados objetos da API da Dynatrace (a descrição da API pode ser vista aqui ).
{
   "timeseries": [
   {
     "timeseriesId": "service.ResponseTime",
     "aggregation": "avg",
     "tags": "Frontend",
     "severe": 250000,
     "warning": 1000000
   },
   {
     "timeseriesId": "service.ResponseTime ",
     "aggregation": "avg",
     "tags": "Backend",
     "severe": 4000000,
     "warning": 8000000
   },
   {
     "timeseriesId": "docker.Container.Cpu",
     "aggregation": "avg",
     "severe": 50,
     "warning": 70
   }
  ]
}
O arquivo é um array de definições de séries temporais (timeseries):
- timeseriesId – a métrica que está sendo verificada, por exemplo, Tempo de Resposta, Contagem de Erros, Memória Usada, etc.;
- aggregation — nível de agregação das métricas, neste caso avg, mas você pode usar qualquer um que precisar (avg, min, max, sum, count, percentile);
- tags – tag do objeto no sistema de monitoramento, ou você pode especificar um identificador específico do objeto;
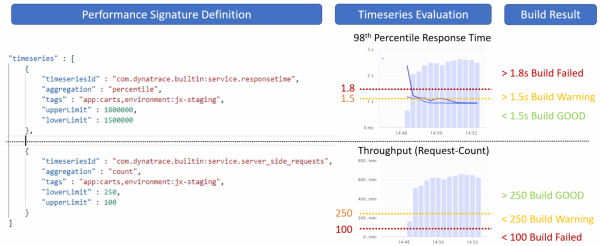
- severe e warning – esses indicadores regulam os limites das nossas métricas; se o valor dos testes ultrapassar o limite severe, nossa coleta é marcada como não bem-sucedida.
Na próxima imagem, um exemplo de uso desses limites é apresentado.
Passo 3. Geração de carga
Depois de definirmos os níveis de qualidade do nosso serviço, é necessário gerar uma carga de teste. Você pode usar qualquer uma das ferramentas de teste que preferir, como Jmeter, Selenium, Neotys, Gatling, etc.
O sistema de monitoramento Dynatrace permite capturar diferentes metadados de seus testes e reconhecer qual teste pertence a qual ciclo de liberação e a qual serviço. É recomendado adicionar cabeçalhos adicionais nas requisições HTTP do teste.
Na próxima imagem, um exemplo é apresentado, onde usamos o cabeçalho adicional X-Dynatrace-Test para marcar que este teste está relacionado ao teste da operação de adicionar produto ao carrinho.
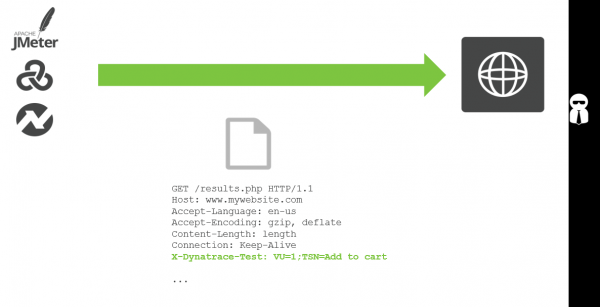
Ao iniciar cada teste de carga, você envia informações contextuais adicionais ao Dynatrace através da API de eventos do servidor CI/CD. Assim, o sistema pode distinguir diferentes testes uns dos outros.
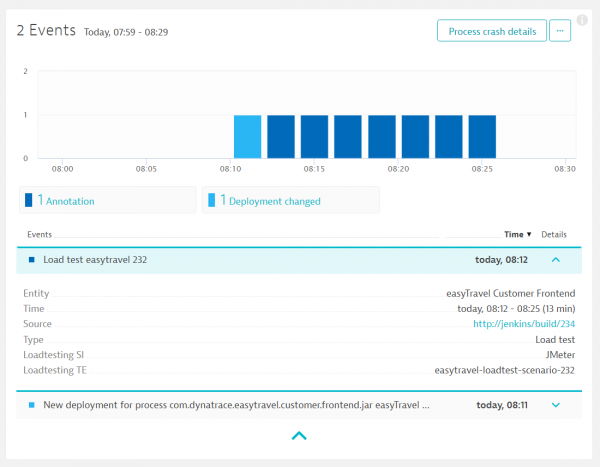 . Evento no sistema de monitoramento sobre o início do teste de carga
Passo 4-5. Coleta de dados de desempenho e transferência de dados para o sistema CI/CD
Juntamente com o teste gerado, um evento é enviado para o sistema de monitoramento indicando a necessidade de coletar dados sobre a verificação de métricas de qualidade do serviço. Também é indicado nosso arquivo JSON, no qual as métricas-chave estão definidas.
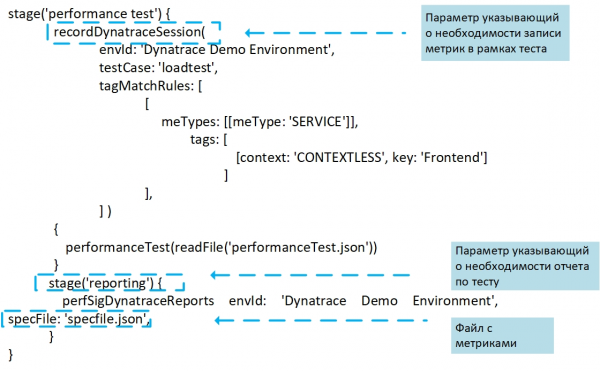 Um evento sobre a necessidade de verificar a qualidade do software gerado no servidor CI/CD para envio ao sistema de monitoramento
No nosso exemplo, o evento de verificação da qualidade é chamado de perfSigDynatraceReport (Performance_Signature) – é um plug-in pronto Evento no sistema de monitoramento sobre o início da verificação da qualidade da compilação.
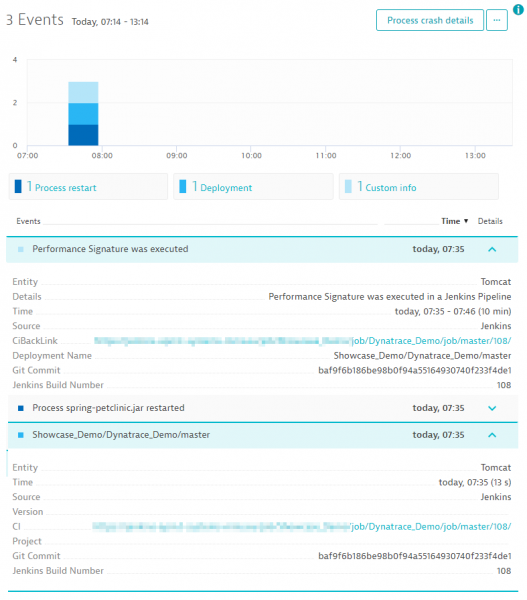 Após a conclusão do teste, todas as métricas de avaliação da qualidade do software são enviadas de volta ao sistema de integração contínua, por exemplo, Jenkins, que gera um relatório de resultados.
Resultados das estatísticas por compilações no servidor CI/CD.
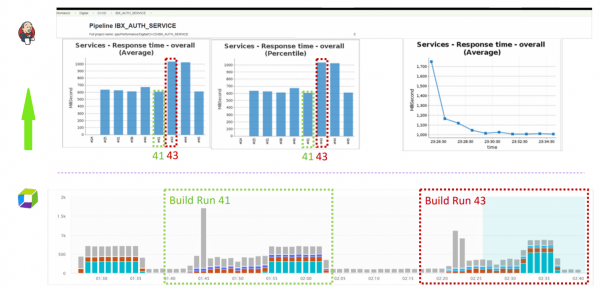 Para cada compilação específica, vemos estatísticas para cada métrica definida por nós ao longo da execução do teste. Também vemos se houve violações em determinados valores de limite (warning e thresholds severos). Com base nos indicadores agregados, toda a compilação é marcada como estável, instável ou falida. Para sua conveniência, você também pode adicionar ao relatório indicadores que comparam a compilação atual com a anterior.
Visualização de estatísticas detalhadas por compilações no servidor CI/CD.
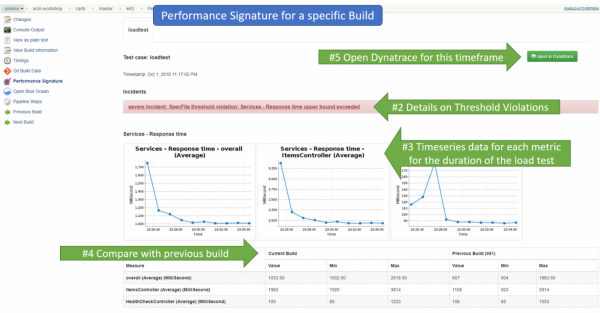 Comparação detalhada de duas compilações
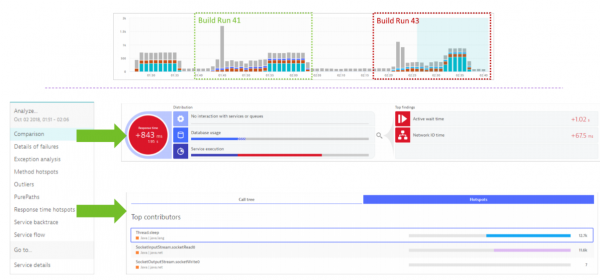
Se necessário, você pode acessar a interface do Dynatrace e lá visualizar estatísticas de cada uma de suas compilações de forma mais detalhada e compará-las entre si.
Comparação das estatísticas das compilações no Dynatrace.
 Conclusões
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Tarefa 2. Automação do controle de qualidade do software em produção
Assim, resolvemos a tarefa de como automatizar o processo de monitoramento na fase de testes no Pipeline. Dessa forma, minimizamos a taxa de compilações de baixa qualidade que vão para o ambiente de produção.
Nós conseguimos automatizar o processo de monitoramento na fase de teste no Pipeline. Isso nos ajuda a reduzir a porcentagem de construções com problemas que chegam ao ambiente de produção.
Mas o que fazer se um software problemático chegar à produção, ou simplesmente algo quebrar? Em nossa utopia, gostaríamos que existissem mecanismos de detecção automática de problemas e que, sempre que possível, o sistema se restaurasse automaticamente, pelo menos durante a noite.
Para isso, precisamos, da mesma forma que no capítulo anterior, prever verificações automáticas da qualidade do software em ambiente de produção e estabelecer cenários para a autorrecuperação do sistema.
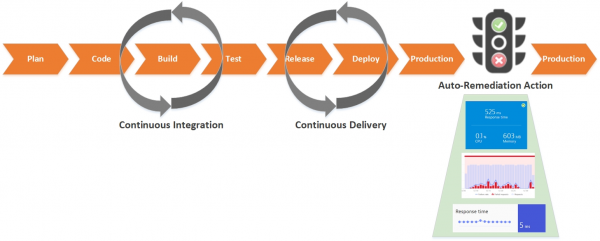
Auto-reparo como código
Na maioria das empresas, já existe uma base de conhecimento acumulada sobre vários tipos de problemas comuns e uma lista de ações para corrigi-los, como reiniciar processos, limpar recursos, reverter versões, restaurar alterações de configuração incorretas, aumentar ou diminuir o número de componentes no cluster, alternar entre o contorno azul ou verde, etc.
Apesar de esses casos de uso serem conhecidos há muitos anos por muitas das equipes com as quais converso, poucas refletiram e investiram em sua automação.
Se pensarmos, não há nada excessivamente complexo na implementação de processos de autorrecuperação de um aplicativo; é necessário simplesmente apresentar cenários de trabalho já conhecidos pelos seus administradores na forma de scripts de código (a concepção de "auto-reparo como código"), que você escreveu previamente para cada caso específico. Os cenários de correção automática devem se concentrar na eliminação da causa raiz do problema. Você mesmo define as ações corretas para responder ao incidente.
Qualquer métrica do seu sistema de monitoramento pode servir como um gatilho para iniciar um script, desde que essas métricas determinem com precisão que algo está errado, pois não queremos falsos positivos em um ambiente produtivo.
Você pode usar qualquer sistema ou combinação de sistemas: Prometheus, ELK Stack, Zabbix, etc. Mas eu vou dar alguns exemplos com base na solução APM (como exemplo, novamente será o Dynatrace), que também ajudará a facilitar sua vida.
Em primeiro lugar, aqui está tudo o que diz respeito à disponibilidade do ponto de vista do funcionamento do aplicativo. A solução fornece centenas de métricas em vários níveis que você pode usar como triggers:
- nível de usuários (navegadores, aplicativos móveis, dispositivos IoT, comportamento dos usuários, conversão, etc.);
- nível de serviço e operações (desempenho, disponibilidade, erros, etc.);
- nível de infraestrutura do aplicativo (métricas do SO do host, JMX, MQ, servidor web, etc.);
- nível de plataformas (virtualização, nuvem, contêiner, etc).
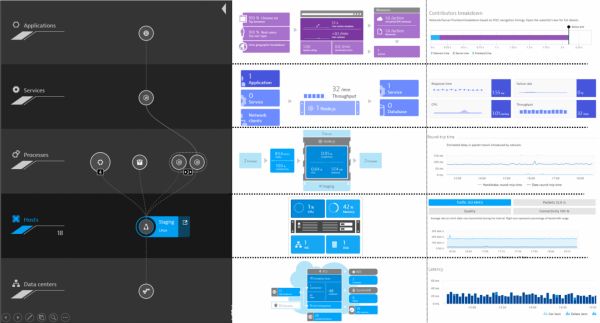 Níveis de monitoramento no Dynatrace.
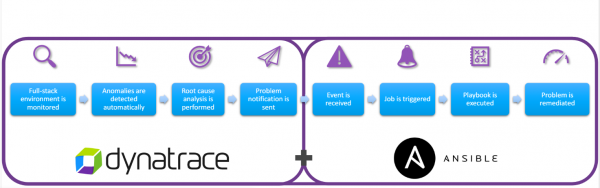
Em segundo lugar, como mencionei anteriormente, o Dynatrace possui uma API aberta que permite uma integração muito conveniente com vários sistemas de terceiros. Por exemplo, enviar notificações para um sistema de automação quando os parâmetros de controle são excedidos.
Abaixo está um exemplo de interação com o Ansible.
Em seguida, darei alguns exemplos de que automações podem ser realizadas. Esta é apenas uma parte dos casos, sua lista em seu ambiente pode ser limitada apenas pela sua imaginação e pelas capacidades das suas ferramentas de monitoramento.
1. Deploy ruim – reverter versão
Mesmo que verifiquemos tudo muito bem no ambiente de teste, ainda há a chance de que um novo release possa derrubar seu aplicativo em produção. O fator humano não pode ser descartado.
No próximo gráfico, vemos um aumento repentino no tempo de execução das operações no serviço. O início desse aumento coincide com o momento do deploy no aplicativo. Todas essas informações são transmitidas como eventos para o sistema de automação. Se a funcionalidade do serviço não se normalizar após o tempo estabelecido por nós, um script é automaticamente chamado para reverter a versão para a antiga.
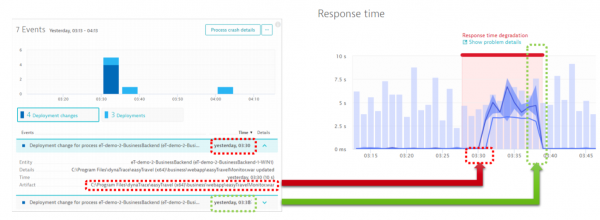 Degradação do desempenho das operações após o deploy.
2. Uso de recursos a 100% — adicionar nó à roteação
No próximo exemplo, o sistema de monitoramento identifica que um dos componentes está com CPU a 100%.
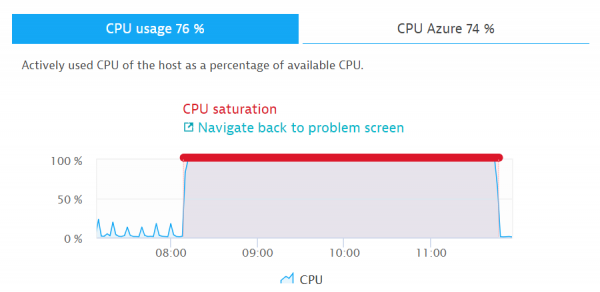 Uso de CPU 100%
Para este evento, há vários cenários possíveis. Por exemplo, o sistema de monitoramento verifica se a falta de recursos está relacionada a um aumento de carga no serviço. Se sim, um script é executado automaticamente para adicionar um nó à roteação, restabelecendo assim a funcionalidade do sistema como um todo.
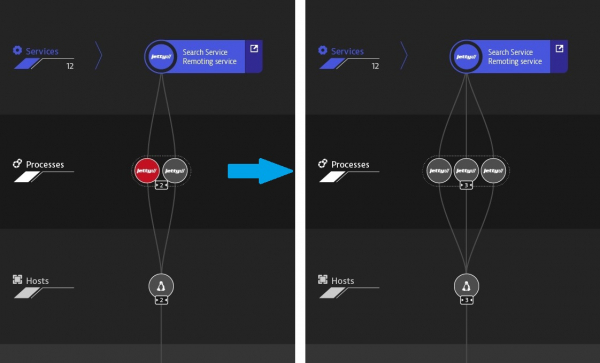 Escalonamento após o incidente
3. Falta de espaço no disco rígido – limpeza do disco
Eu acho que muitos já automatizaram esses processos. Com o APM, também é possível monitorar o espaço livre no subsistema de disco. Na falta de espaço ou em caso de lentidão na operação do disco, acionamos um script para limpeza ou adicionamos espaço.
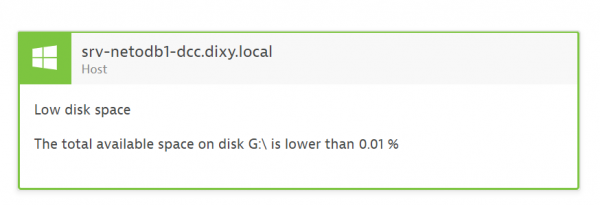
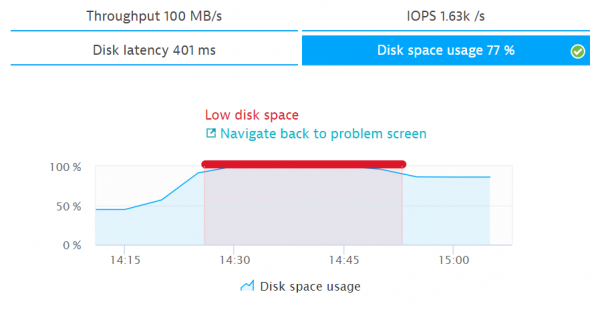 Carga do disco 100%
4. Baixa atividade dos usuários ou baixa conversão – alternância entre o ramo azul e o verde
Costumo encontrar clientes que utilizam dois contornos (blue-green deploy) para aplicativos em ambientes de produção. Isso permite uma rápida alternância entre ramos ao entregar novas versões. Muitas vezes, após o deploy, podem ocorrer mudanças significativas que não são imediatamente perceptíveis. Ao mesmo tempo, a degradação no desempenho e na disponibilidade pode não ser observada. Para uma resposta rápida a essas mudanças, é melhor usar várias métricas que reflitam o comportamento dos usuários (número de sessões e ações dos usuários, conversão, taxa de rejeição). A seguir, um exemplo onde a alternância ocorre entre os ramos de software em caso de queda na conversão.
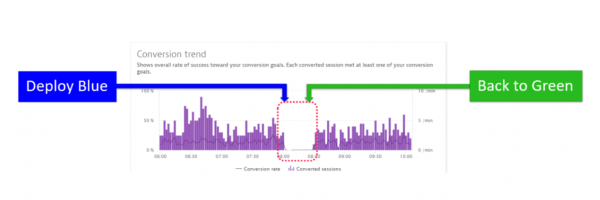 Queda na conversão após a alternância entre os ramos de software.
Mecanismos de detecção automática de problemas
No final, trarei mais um exemplo do que eu mais gosto no Dynatrace.
Na parte da minha narrativa sobre a automação da verificação de qualidade das compilações em um ambiente de teste, todos os valores de limite foram determinados manualmente. Para o ambiente de teste, isso é normal; o testador define os indicadores antes de cada verificação, dependendo da carga. Em um ambiente de produção, é desejável que os problemas sejam detectados automaticamente, levando em consideração vários mecanismos de baseline.
O Dynatrace possui ferramentas integradas de inteligência artificial interessantes que, com base em mecanismos de detecção de métricas anômalas (baselining) e criação de um mapa de interação entre todos os componentes, correspondendo e correlacionando eventos, definem anomalias no funcionamento do seu serviço e fornecem informações detalhadas sobre cada problema e sua causa raiz.
Através da análise automática das dependências entre os componentes, o Dynatrace determina não apenas se o serviço problemático é a causa raiz, mas também a sua dependência em relação a outros serviços. No exemplo abaixo, o Dynatrace rastreia e avalia automaticamente o desempenho de cada serviço durante a execução das transações, identificando o serviço Golang como a causa principal.
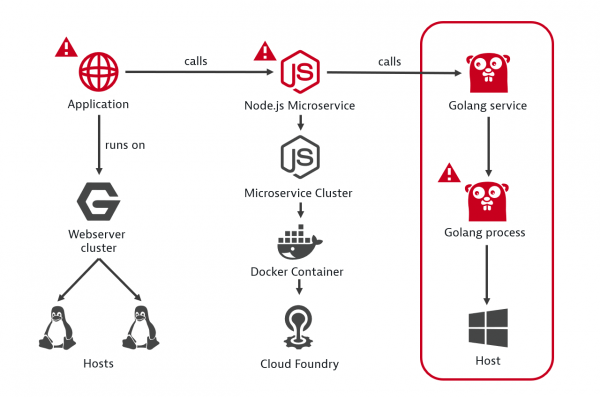 Exemplo de determinação da causa raiz de uma falha.
A ilustração a seguir mostra o processo de monitoramento de problemas com seu aplicativo desde o início do incidente.
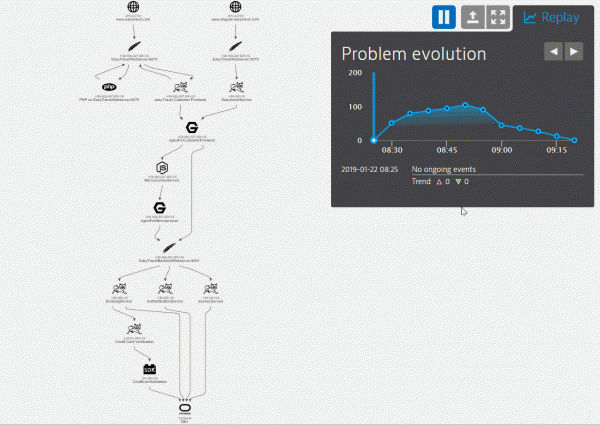 Visualização do problema em desenvolvimento, exibindo todos os componentes e os eventos relacionados.
O sistema de monitoramento coletou uma cronologia completa dos eventos relacionados ao problema surgido. Na janela abaixo do gráfico temporal, vemos todos os eventos-chave em cada um dos componentes. Com base nesses eventos, você pode definir procedimentos para correção automática na forma de scripts de código.
Além disso, recomendo integrar o sistema de monitoramento com o Service Desk ou com um bug tracker. Quando um problema ocorre, os desenvolvedores recebem rapidamente todas as informações necessárias para análise a nível de código no ambiente de produção.
Conclusão
Como resultado, conseguimos criar um pipeline CI/CD com verificações de qualidade de software automatizadas integradas ao Pipeline. Minimizamos o número de compilações de baixa qualidade, aumentamos a confiabilidade do sistema como um todo e, se a funcionalidade do sistema for comprometida, acionamos mecanismos para sua recuperação.
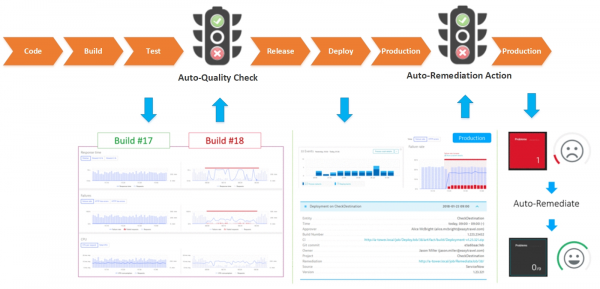
Vale a pena investir esforços na automação do monitoramento de qualidade de software; nem sempre é um processo rápido, mas com o tempo dará seus frutos. Recomendo que, após a resolução de um novo incidente no ambiente de produção, você pense imediatamente em quais monitores adicionar para verificações no ambiente de testes, a fim de evitar que uma compilação ruim chegue à produção, além de elaborar um script para a correção automática dessas questões.
Espero que meus exemplos ajudem em seus esforços. Também ficarei curioso para ver seus exemplos de métricas utilizadas para implementar a auto-reparação da funcionalidade dos sistemas.
Fonte: habr.com
