

Nota do tradutor.: esta história instrutiva da Omio — um agregador de viagens europeu — conduz os leitores da teoria básica às fascinantes sutilezas práticas na configuração do Kubernetes. Conhecer esses casos ajuda não apenas a expandir o conhecimento, mas também a evitar problemas não triviais.
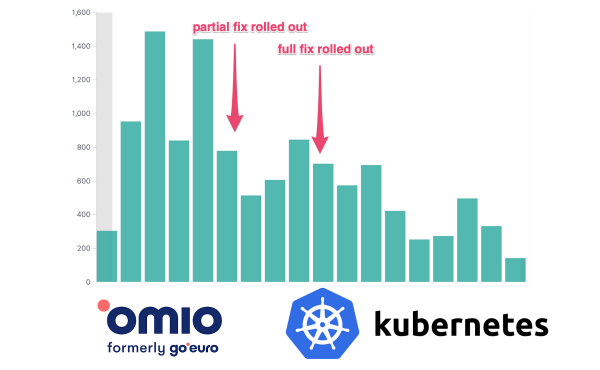
Você já se deparou com o problema de um aplicativo que "congelou", parando de responder a solicitações de verificação de estado (health checks) e você não conseguia entender a razão desse comportamento? Uma das possíveis explicações está relacionada ao limite de cotas de recursos de CPU. É sobre isso que falaremos neste artigo.
TL;DR:
Recomendamos fortemente que você evite limites de CPU no Kubernetes (ou desative as cotas CFS no Kubelet) se usar uma versão do kernel Linux com erro nas cotas CFS. No kernel é um bug sério e que causa throttling excessivo e latências.
Na Omio toda a infraestrutura é gerida pelo Kubernetes. Todas as nossas cargas de trabalho stateful e stateless funcionam exclusivamente no Kubernetes (usamos o Google Kubernetes Engine). Nos últimos seis meses, começamos a notar atrasos aleatórios. Aplicativos congelam ou param de responder aos health checks, perdem conexão com a rede, etc. Esse comportamento nos deixou perplexos por um longo tempo, e finalmente decidimos abordar o problema mais de perto.
Resumo do artigo:
- Algumas palavras sobre contêineres e Kubernetes;
- Como os requests e limites de CPU são implementados;
- Como o limite de CPU funciona em ambientes com múltiplos núcleos;
- Como monitorar o throttling de CPU;
- Solução do problema e nuances.
Algumas palavras sobre contêineres e Kubernetes
Kubernetes, em essência, é o padrão moderno no mundo da infraestrutura. Sua principal tarefa é a orquestração de contêineres.
Contêineres
No passado, precisávamos criar artefatos como JARs/WARs Java, Eggs Python ou arquivos executáveis para serem executados em servidores. Porém, para fazê-los funcionar, era necessário realizar trabalho adicional: configurar o ambiente de execução (Java/Python), colocar os arquivos necessários nos lugares corretos, garantir compatibilidade com uma versão específica do sistema operacional etc. Em outras palavras, era preciso prestar muita atenção à gestão de configurações (o que frequentemente causava atritos entre desenvolvedores e administradores de sistema).
Os contêineres mudaram tudo. Agora o artefato é a imagem do container. Ele pode ser visto como uma versão ampliada de um arquivo executável, contendo não apenas o programa, mas também um ambiente de execução completo (Java/Python/…), além dos arquivos/pacotes necessários, pré-instalados e prontos para execução. Os containers podem ser implantados e executados em diversos servidores sem qualquer ação adicional.
Além disso, os containers operam em seu próprio ambiente isolado. Eles possuem seu próprio adaptador de rede virtual, seu sistema de arquivos com acesso restrito, sua hierarquia de processos, suas restrições de CPU e memória, etc. Tudo isso é implementado através de uma subsistema especial do núcleo Linux — namespaces.
Kubernetes
Como mencionado anteriormente, o Kubernetes é um orquestrador de containers. Ele funciona assim: você fornece a ele um pool de máquinas e, em seguida, diz: "Ei, Kubernetes, inicie dez instâncias do meu container com 2 processadores e 3 GB de memória cada, e mantenha-as operacionais!" O Kubernetes se encarregará do resto. Ele encontrará recursos disponíveis, iniciará os containers e os reiniciará conforme necessário, aplicará atualizações ao mudar de versões, etc. Essencialmente, o Kubernetes permite abstrair a parte de hardware e torna toda a variedade de sistemas adequada para implantação e operação de aplicações.
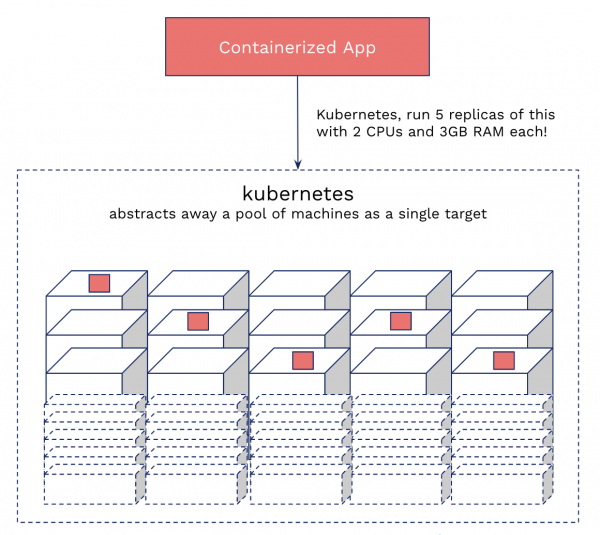
Kubernetes sob a perspectiva de uma pessoa comum
O que são requests e limits no Kubernetes
Ok, entendemos os containers e Kubernetes. Também sabemos que vários containers podem estar em uma única máquina.
Podemos fazer uma analogia com um apartamento compartilhado. É um espaço amplo (máquinas/nós) alugado para vários inquilinos (containers). O Kubernetes atua como o corretor de imóveis. Surge a pergunta: como evitar conflitos entre os inquilinos? E se um deles, digamos, decidir ocupar o banheiro por meio dia?
É aqui que entram os requests e limits. CPU Request é necessário apenas para planejamento. É algo como uma "lista de desejos" do container, e é usado para encontrar o nó mais adequado. Ao mesmo tempo, a CPU Limite pode ser comparada a um contrato de aluguel — assim que encontrarmos um nó para o container, ele não poderá ultrapassar os limites estabelecidos. E aqui surge o problema…
Como são implementadas as requisições e limites no Kubernetes
O Kubernetes utiliza um mecanismo de throttling (limitação) embutido no núcleo para implementar os limites de CPU. Se um aplicativo ultrapassa o limite, o throttling é ativado (ou seja, ele recebe menos ciclos de CPU). As requisições e os limites de memória são organizados de forma diferente, sendo mais fáceis de detectar. Para isso, basta verificar o último status da reinicialização do pod: se não está como «OOMKilled». Com o throttling da CPU, tudo é mais complicado, pois o K8s disponibiliza apenas métricas de uso, e não de cgroups.
Requisição de CPU
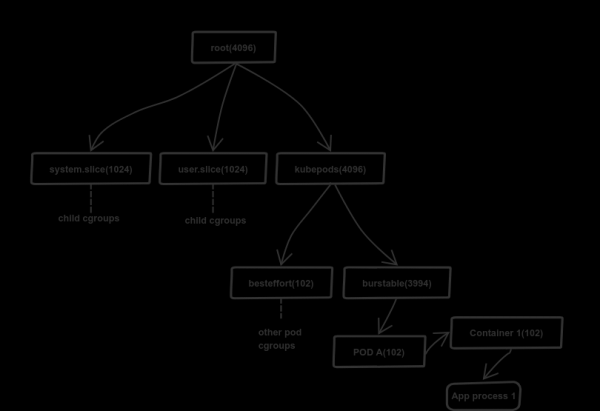
Como é implementada a requisição de CPU
Para simplificar, vamos considerar o processo usando uma máquina com CPU de 4 núcleos.
O K8s utiliza um mecanismo de grupos de controle (cgroups) para gerenciar a alocação de recursos (memória e processador). Uma modelo hierárquico está disponível para ele: um filho herda os limites do grupo pai. Os detalhes da alocação são armazenados em um sistema de arquivos virtual (/sys/fs/cgroup). No caso do processador, isso é /sys/fs/cgroup/cpu,cpuacct/*.
O K8s utiliza o arquivo cpu.share para alocar os recursos do processador. No nosso caso, o grupo de controle raiz recebe 4096 partes de recursos de CPU — 100% da capacidade disponível do processador (1 núcleo = 1024; este é um valor fixo). O grupo raiz aloca os recursos proporcionalmente com base nas partes dos filhos, especificadas em cpu.share, e estes, por sua vez, fazem o mesmo com seus filhos, e assim por diante. Em um nó típico do Kubernetes, o grupo de controle raiz tem três filhos: system.slice, user.slice e kubepods. Os dois primeiros subgrupos são utilizados para alocar recursos entre cargas de trabalho de sistema críticas e programas de usuários fora do K8s. O último — kubepods — é criado pelo Kubernetes para alocar recursos entre os pods.
No diagrama acima, pode-se ver que os dois primeiros subgrupos receberam 1024 partes, enquanto o subgrupo kubepod recebeu 4096 partes. Como isso é possível: afinal, o grupo raiz tem acesso a apenas 4096 partes, e a soma das partes de seus filhos excede significativamente esse número (6144)? O fato é que o valor tem um significado lógico, portanto, o planejador do Linux (CFS) o utiliza para alocar proporcionalmente os recursos de CPU. No nosso caso, os primeiros dois grupos recebem cada um 680 partes reais (16,6% de 4096), enquanto o kubepod recebe as restantes 2736 partes. Em caso de inatividade, os dois primeiros grupos não utilizarão os recursos alocados.
Felizmente, o planejador possui um mecanismo que evita a perda de recursos CPU não utilizados. Ele redistribui as capacidades "ociosas" para um pool global, do qual elas são alocadas para grupos que precisam de capacidade adicional de processamento (a transferência ocorre em lotes para evitar perdas por arredondamento). Um método similar é aplicado a todos os descendentes.
Esse mecanismo garante uma distribuição justa das capacidades do processador e evita que qualquer processo "roube" recursos de outros.
Limite de CPU
Embora as configurações de limites e requisições no K8s pareçam semelhantes, sua implementação é radicalmente diferente: a parte mais confusa e menos documentada.
O K8s utiliza para implementar os limites. Suas configurações são definidas nos arquivos cfs_period_us e cfs_quota_us no diretório cgroup (onde também está localizado o arquivo cpu.share).
Diferentemente de cpu.share, a quota é baseada no período de tempo, não na capacidade disponível do processador. cfs_period_us define a duração do período (época) — que é sempre 100000 microssegundos (100 ms). O K8s permite alterar esse valor, mas isso está disponível apenas na versão alfa. O planejador utiliza a época para reiniciar as quotas utilizadas. O segundo arquivo, cfs_quota_us, define o tempo disponível (quota) em cada época. Note que ela também é especificada em microssegundos. A quota pode exceder a duração da época; em outras palavras, pode ser maior que 100 ms.
Vamos considerar dois cenários em máquinas de 16 núcleos (o tipo de computador mais comum que temos na Omio):
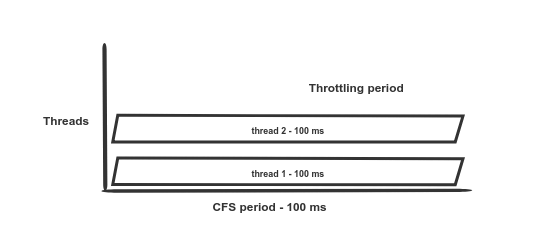
Cenário 1: 2 fluxos e limite de 200 ms. Sem throttling.
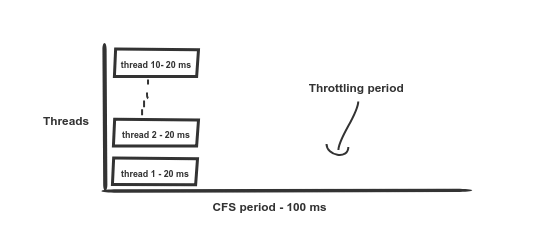
Cenário 2: 10 fluxos e limite de 200 ms. O throttling começa após 20 ms, e o acesso aos recursos do processador é retomado mais 80 ms depois.
Vamos supor que você definiu o limite de CPU em 2 núcleos; o Kubernetes converterá esse valor para 200 ms. Isso significa que o contêiner pode usar no máximo 200 ms de tempo de CPU sem throttling.
E é aqui que começa a parte interessante. Como mencionado anteriormente, a quota disponível é de 200 ms. Se você estiver executando simultaneamente dez fluxos em uma máquina de 12 núcleos (veja a ilustração do cenário 2), enquanto todos os outros pods estão ociosos, a quota será consumida em apenas 20 ms (já que 10 * 20 ms = 200 ms), e todos os fluxos deste pod "congelarão" (throttle) nos próximos 80 ms. Agrava a situação já mencionada , que causa throttling excessivo e o contêiner não consegue utilizar nem mesmo sua cota disponível.
Como avaliar o throttling em pods?
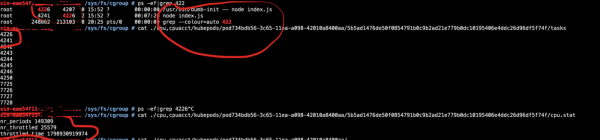
Basta entrar no pod e executar cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— total de períodos do planejador; -
nr_throttled— número de períodos estrangulados dentro denr_periods; -
throttled_time— tempo total estrangulado em nanosegundos.
O que realmente está acontecendo?
No final, temos um alto throttling em todos os aplicativos. Às vezes é uma vez e meia mais forte que o calculado!
Isso leva a vários erros — falhas em verificações de prontidão, contenção de contêineres, quebras de conexões de rede, timeouts em chamadas de serviço. No final, isso resulta em maior latência e aumento no número de erros.
Solução e consequências
Aqui é simples. Abrimos mão dos limites de CPU e nos concentramos na atualização do kernel do SO nos clusters para a versão mais recente, onde o bug foi corrigido. O número de erros (HTTP 5xx) em nossos serviços caiu significativamente imediatamente:
Erros HTTP 5xx
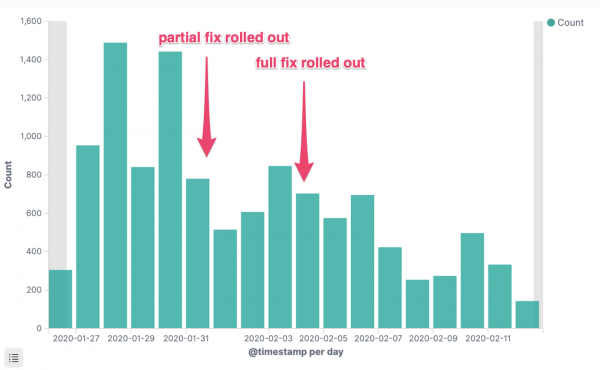
Erros HTTP 5xx de um serviço crítico
Tempo de resposta p95
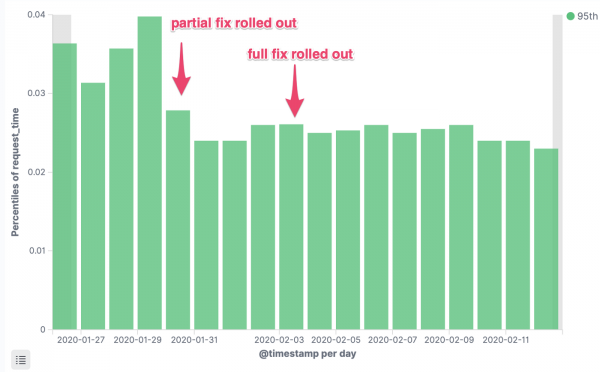
Latência das solicitações de um serviço crítico, percentil 95
Custos operacionais
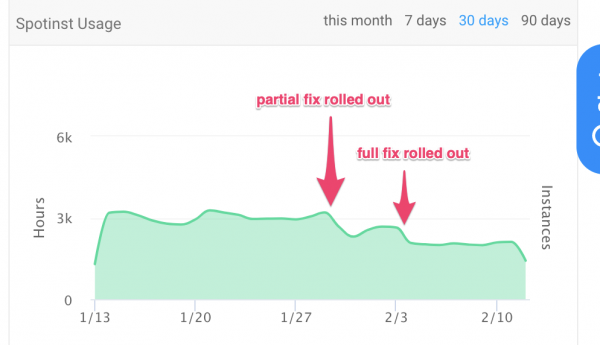
Número de horas de instância consumidas
Qual é o truque?
Como mencionado no início do artigo:
Pode-se fazer uma analogia com um apartamento compartilhado... Kubernetes atua como o corretor de imóveis. Mas como evitar que os inquilinos entrem em conflito entre si? E se um deles, digamos, decidir ocupar o banheiro por meio dia?
Aqui está o truque. Um contêiner descuidado pode consumir todos os recursos disponíveis da CPU na máquina. Se você tem um bom stack de aplicativos (por exemplo, JVM, Go, Node VM bem configurados), então não é um problema: é possível operar nessas condições por um longo período. Mas se os aplicativos estão mal otimizados ou não otimizados de forma alguma (FROM java:latest), a situação pode sair do controle. Na Omio, temos Dockerfiles básicos automatizados com configurações adequadas por padrão para stacks das principais linguagens, então esse tipo de problema não existiu.
Recomendamos monitorar as métricas (uso, saturação e erros), latências da API e frequência de erros. Certifique-se de que os resultados correspondam às expectativas.
Links
Esta é a nossa história. Os seguintes recursos foram muito úteis para entender o que está acontecendo:
- ;
- ;
- ;
- ;
- — procure por "throttling de CPU".
Relatórios de erros do Kubernetes:
- ;
- ;
- .
Você já enfrentou problemas semelhantes em sua prática ou tem experiência relacionada ao throttling em ambientes de produção containerizados? Compartilhe sua história nos comentários!
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
