

Essas foram as reclamações que ouvi de nossos desenvolvedores. O mais interessante é que isso se mostrou verdade, dando início a uma longa investigação. A questão refere-se aos servidores SQL que operam em nossa infraestrutura VMware.
Na verdade, é fácil fazer com que o servidor de produção fique desesperadamente atrasado em relação ao laptop. Execute (não no tempdb e não em um banco com Delayed Durability) o código:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Que lentidão!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
No meu desktop, ele leva 5 segundos para ser executado, enquanto no servidor de produção leva 28 segundos. Isso porque o SQL deve esperar a conclusão física da gravação no log de transações, enquanto fazemos transações muito curtas. Grosso modo, estamos colocando um grande caminhão poderoso no tráfego urbano e observando como os entregadores de pizza em scooters o ultrapassam rapidamente — aqui, o throughput não importa, apenas a latência. E nenhum armazenamento de rede, por mais caro que seja, pode superar a latência de um SSD local.
(nos comentários, descobri que eu menti — em ambos os lugares estava ativada a delayed durability. Sem delayed durability, temos:
Desktop — 39 segundos, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 segundos, 1600 tr/sec, 0.6ms
Eu devia ter prestado atenção, muito rápido)
Entretanto, neste caso, lidamos com zeros triviais da função de Riemann em um exemplo trivial. No exemplo que os desenvolvedores me trouxeram, era diferente. Verifiquei que estavam corretos e comecei a remover toda a especificidade do exemplo relacionada à lógica de negócios. Em determinado momento, percebi que poderia descartar completamente o código deles e escrever o meu — que demonstra o mesmo problema — no ambiente de produção ele é de 3 a 4 vezes mais lento:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- check odds up to sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Se tudo estiver bem, a verificação de primalidade levará de 6 a 7 a 8 segundos. Assim foi em várias servidores. Mas em alguns casos, a verificação levou de 25 a 40 segundos. O curioso é que não havia servidores onde a execução demorasse, digamos, 14 segundos — o código funcionava muito rápido ou muito devagar, ou seja, o problema era, por assim dizer, preto e branco.
O que eu fiz? Fui analisar as métricas do VMware. Tudo estava bem — havia recursos em abundância, Ready time = 0, tudo era suficiente; no teste, tanto nos servidores rápidos quanto nos lentos, a CPU chegava a 100 em um único vCPU. Eu fiz um teste com o cálculo do número Pi — os resultados foram idênticos em todos os servidores. A situação estava cada vez mais estranha.
Ao chegar na fazenda DEV, comecei a brincar com os servidores. Descobri que o vMotion entre hosts poderia "curar" um servidor, mas também poderia, ao contrário, transformar um servidor "rápido" em "lento". Parece que aqui estava a questão — alguns hosts tinham problemas... mas não. Uma determinada máquina virtual estava lenta no host A, mas funcionava rapidamente no host B. E outra máquina virtual, ao contrário, funcionava bem no A e estava lenta no B! No host, frequentemente estavam rodando tanto máquinas "rápidas" quanto "lentas"!
A partir deste momento, o ar ficou claramente carregado de enxofre. Afinal, o problema não poderia ser atribuído a nenhuma máquina virtual (atualizações do Windows, por exemplo) — pois ela se tornava "rápida" ao fazer vMotion. Mas o problema também não poderia ser atribuído ao host — pois nele poderiam estar tanto máquinas "rápidas" quanto "lentas". Além disso, isso não estava relacionado à carga — consegui obter uma máquina "lenta" em um host que não tinha nada além dela.
Desesperado, executei o Process Explorer da Sysinternals e analisei a pilha SQL. Nas máquinas lentas, imediatamente notei a seguinte linha:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… pulado
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Isso já era algo. Um programa foi escrito:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Este programa demonstrou uma desaceleração ainda mais acentuada — em máquinas "rápidas", ele apresenta 16-18 milhões de ciclos por segundo, enquanto em máquinas lentas, apenas um milhão e até 700 mil. Ou seja, a diferença chega a ser de 10-20 vezes (!!!). Essa já foi uma pequena vitória: de qualquer forma, não havia a ameaça de ficar preso entre o suporte da Microsoft e da VMware, jogando a responsabilidade um para o outro.
Depois, o progresso parou — férias, assuntos importantes, histeria viral e um aumento repentino na carga. Eu frequentemente mencionava o problema mágico para os colegas, mas às vezes parecia que eles não acreditavam em mim — a afirmação de que a VMware desacelera o código em 10-20 vezes era realmente alarmante.
Eu tentei descobrir o que estava causando a lentidão. Às vezes, parecia que eu tinha encontrado a solução — ativar e desativar Hot plugs, alterar a quantidade de memória ou o número de processadores frequentemente tornava a máquina "rápida". Mas não para sempre. O que se provou verdadeiro é que bastava sair e bater na roda — ou seja, mudar (lembrando das pessoas em posições elevadas), isso é ruim o parâmetro da máquina virtual
Finalmente, meus colegas americanos de repente encontraram a causa raiz.
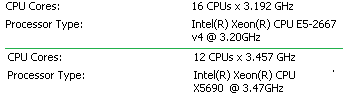
Os hosts diferiam na frequência!
- Normalmente, isso não é um problema. Mas: ao mover de um host 'nativo' para um host com uma frequência 'diferente', a VMware deve corrigir o resultado do GetTimePrecise.
- Normalmente isso não é um problema, a menos que apareça uma aplicação que solicita o tempo exato milhões de vezes por segundo, como o SQL Server.
- Mas isso também não é um problema, já que o SQL Server não faz isso o tempo todo (veja a conclusão).
Mas há casos em que esses problemas realmente causam dor. E sim, ao bater na roda (mudando algo nas configurações da VM), eu fazia a VMware 'recontar' a configuração, e a frequência do host atual se tornava a 'frequência nativa' da máquina.
Solução
Quando você desativa a virtualização do TSC, ler o TSC de dentro da máquina virtual retorna o valor do TSC da máquina física, e escrever no TSC de dentro da máquina virtual não tem efeito. Migrar a máquina virtual para outro host, retomar o estado suspenso, ou reverter para um snapshot faz com que o TSC salte discontinuamente. Alguns sistemas operacionais convidados falham ao iniciar ou apresentam outros problemas de controle de tempo quando a virtualização do TSC está desativada. No passado, esse recurso às vezes foi recomendado para melhorar o desempenho de aplicações que leem o TSC com frequência., mas o desempenho do TSC virtual melhorou substancialmente nos produtos atuais. O recurso também foi recomendado para uso ao realizar medições que requerem uma fonte precisa de tempo real na máquina virtual.
Em resumo, é necessário adicionar o parâmetro
monitor_control.virtual_rdtsc = FALSE
Conclusão
Você deve estar se perguntando: por que chamar GetTimePrecise tão frequentemente no SQL?
Não tenho os códigos-fonte do SQL Server, mas a lógica diz o seguinte. SQL é quase um sistema operacional com concorrência cooperativa, onde cada thread deve "ceder" de vez em quando. E onde é melhor fazer isso? Lá onde há uma espera natural — por causa de bloqueios ou I/O. Certo, mas e se estivermos rodando ciclos computacionais? Então, o óbvio e quase único lugar é no interpretador (que não é bem um interpretador), após a execução do próximo operador.
Em geral, o SQL Server não é utilizado para tarefas puramente computacionais, e isso não é um problema. Mas ciclos com operações em várias tabelas temporárias (que são imediatamente cacheadas) transformam o código em uma sequência de operadores que são executados muito rapidamente.
Por sinal, se a função for envolvida em NATIVELY COMPILED, ela para de solicitar o tempo, e sua velocidade aumenta em até 10 vezes. E quanto ao multitasking cooperativo? Justamente por isso o código natively compiled precisou ter PREEMPTIVE MULTITASKING implementado no SQL.
Fonte: habr.com
