

Quais princípios sustentam o armazenamento de dados ideal?
Foco no valor de negócio e na análise, sem código boilerplate. Gestão de DWH como base de código: versionamento, revisão, testes automatizados e CI. Modularidade, escalabilidade, código aberto e comunidade. Documentação amigável para o usuário e visualização de dependências (Data Lineage).
Para mais detalhes sobre tudo isso e o papel do DBT no ecossistema Big Data & Analytics — fique à vontade para ler mais.
Olá a todos
Aqui é Artemy Kozyr. Já trabalhei com armazenamento de dados por mais de 5 anos, desenvolvendo ETL/ELT, além de análise de dados e visualização. Atualmente, estou trabalhando na , leciono na OTUS no curso , e hoje quero compartilhar com vocês um artigo que escrevi antes do lançamento do novo ciclo de curso.
Resumo
O framework DBT trata da letra T no acrônimo ELT (Extract — Transform — Load).
Com o surgimento de bancos de dados analíticos tão poderosos e escaláveis como BigQuery, Redshift, Snowflake, deixou de fazer sentido realizar transformações fora do Armazenamento de Dados.
O DBT não exporta dados de fontes, mas oferece imensas possibilidades de trabalhar com os dados que já estão carregados no Armazenamento (em Internal ou External Storage).
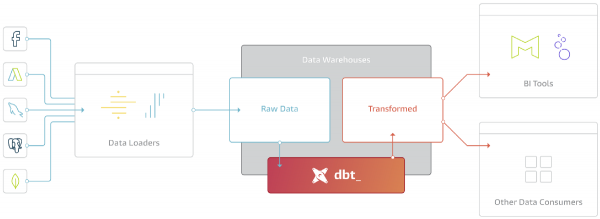
O principal objetivo do DBT é pegar código, compilá-lo em SQL e executar comandos na sequência correta no Armazenamento.
Estrutura do projeto DBT
O projeto é composto por duas tipos de diretórios e arquivos:
- Modelo (.sql) — unidade de transformação, expressa como uma consulta SELECT
- Arquivo de configuração (.yml) — parâmetros, configurações, testes, documentação
Em um nível básico, o trabalho é realizado da seguinte forma:
- O usuário prepara o código dos modelos em qualquer IDE conveniente
- Através do CLI, a execução dos modelos é chamada, o DBT compila o código dos modelos em SQL
- O SQL compilado é executado no Armazenamento na sequência definida (grafo)
Veja como pode ser a execução a partir do CLI:
Tudo que existe é SELECT
Esse é o recurso principal do framework Data Build Tool. Em outras palavras, o DBT abstrai todo o código relacionado à materialização das suas consultas no Armazenamento (variações a partir dos comandos CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, ...).
Qualquer modelo envolve a escrita de uma consulta SELECT que define o conjunto de dados resultante.
Nesse contexto, a lógica das transformações pode ser multinível e consolidar dados de vários outros modelos. Um exemplo de modelo que construirá o vitrine de pedidos (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

  select * from {{ ref('stg_orders') }}

),

order_payments as (

  select * from {{ ref('order_payments') }}

),

final as (

  select
      orders.order_id,
      orders.customer_id,
      orders.order_date,
      orders.status,
      {% for payment_method in payment_methods -%}
      order_payments.{{payment_method}}_amount,
      {% endfor -%}
      order_payments.total_amount as amount
  from orders
      left join order_payments using (order_id)

)

select * from final
O que de interessante podemos ver aqui?
Em primeiro lugar: foram utilizados CTEs (Common Table Expressions) — para organizar e compreender o código, que contém muitas transformações e lógica de negócios.
Em segundo lugar: o código do modelo é uma mistura de SQL e (linguagem de template).
No exemplo, foi utilizado um loop para para calcular a soma por cada método de pagamento especificado na expressão set. Também é utilizada a função ref — a possibilidade de referenciar outros modelos dentro do código:
- Durante a compilação ref ele será transformado em um ponteiro para a tabela ou visão no armazém
- ref que permite construir um gráfico de dependência dos modelos.
É isso que adiciona ao DBT quase possibilidades ilimitadas. Os mais utilizados são:
- If / else statements — instruções de ramificação.
- For loops — loops.
- Variables — variáveis.
- Macro — criação de macros.
Materialização: Table, View, Incremental.
A estratégia de materialização é a abordagem segundo a qual o conjunto de dados resultante do modelo será salvo no armazém.
Em uma análise básica, isso é:
- Table — tabela física no armazém.
- View — visão, uma tabela virtual no armazém.
Existem também estratégias de materialização mais complexas:
- Incremental — carregamento incremental (de grandes tabelas de fatos); novas linhas são adicionadas, as modificadas são atualizadas e as removidas são limpas.
- Ephemeral — o modelo não é materializado diretamente, mas participa como CTE em outros modelos.
- Qualquer outra estratégia que você possa adicionar por conta própria.
Além das estratégias de materialização, abrem-se oportunidades para otimização para armazéns específicos, por exemplo:
- Snowflake: Transient tables, Merge behavior, Table clustering, Copying grants, Secure views.
- Redshift: Distkey, Sortkey (interleaved, compound), Late Binding Views.
- BigQuery: Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & Tags.
- Spark: Formato de arquivo (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
No momento, os seguintes Armazenamentos são suportados:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (parcialmente)
- Spark (parcialmente)
- Microsoft SQL Server (adaptador da comunidade)
Vamos aprimorar nosso modelo:
- Tornaremos seu preenchimento incremental
- Adicionaremos chaves de segmentação e ordenação para o Redshift
-- Configuração do modelo:
-- Preenchimento incremental, chave única para atualização de registros (unique_key)
-- Chave de segmentação (dist), chave de ordenação (sort)
{{
  config(
          materialized='incremental',
          unique_key='order_id',
          dist="customer_id",
          sort="order_date"
      )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Este filtro será aplicado apenas para a execução incremental
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Grafo de dependências de modelos
Também conhecido como árvore de dependências. Também é um DAG (Grafo Acíclico Direcionado).
O DBT constrói um grafo com base na configuração de todos os modelos do projeto, ou seja, nas referências ref() dentro dos modelos a outros modelos. A presença do grafo permite que as seguintes coisas sejam feitas:
- Execução dos modelos na sequência correta
- Paralelização da formação de vitrines
- Execução de um subgrafo arbitrário
Exemplo de visualização do grafo:
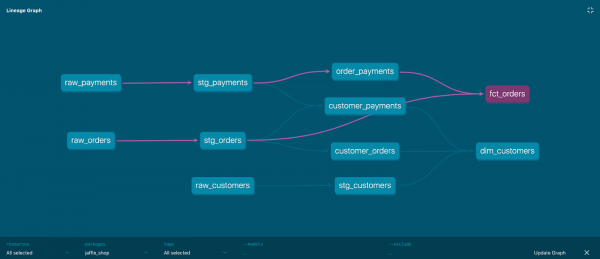
Cada nó do grafo é um modelo, e as arestas do grafo são definidas pela expressão ref.
Qualidade dos dados e Documentação
Além de formar os próprios modelos, o DBT permite testar uma série de suposições (assertions) sobre o conjunto de dados resultante, como:
- Not Null
- Único
- Integridade Referencial — a integridade referencial (por exemplo, customer_id na tabela orders corresponde ao id na tabela customers)
- Conformidade com uma lista de valores permitidos
É possível adicionar seus próprios testes (custom data tests), como, por exemplo, % de desvio de receita em relação aos dados de ontem, uma semana atrás, ou um mês atrás. Qualquer suposição formulada na forma de uma consulta SQL pode se tornar um teste.
Assim, é possível detectar desvios indesejados e erros nos dados em vitrines de Armazenamento.
No que diz respeito à documentação, o DBT fornece mecanismos para adicionar, versionar e disseminar metadados e comentários em nível de modelos e até mesmo de atributos.
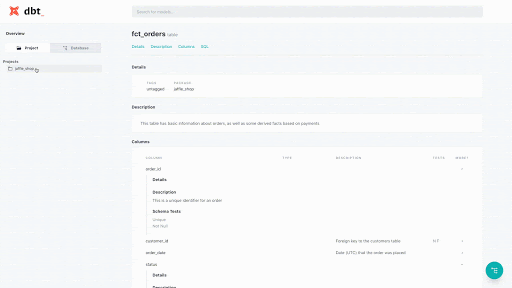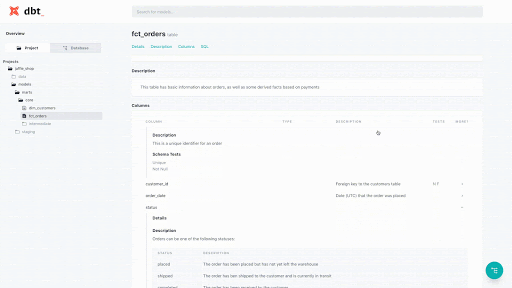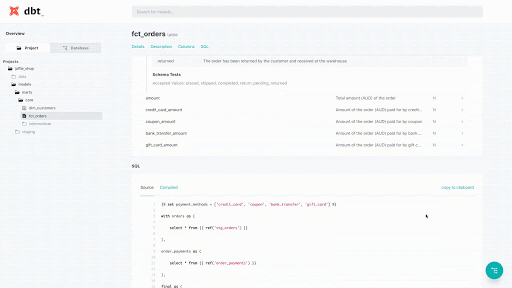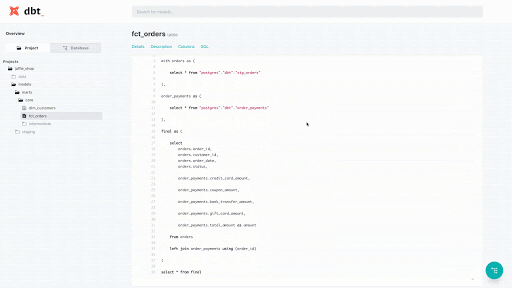
Veja como é a adição de testes e documentação em nível de arquivo de configuração:
 - name: fct_orders
   description: Esta tabela contém informações básicas sobre pedidos, assim como alguns fatos derivados dos pagamentos
   columns:
     - name: order_id
       tests:
         - unique # verificação de valores únicos
         - not_null # verificação de nulos
       description: Este é um identificador único para um pedido
     - name: customer_id
       description: Chave estrangeira para a tabela de clientes
       tests:
         - not_null
         - relationships: # verificação de integridade referencial
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Data (UTC) em que o pedido foi feito
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # verificação de valores aceitáveis
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
E aqui está como essa documentação aparece já em um site gerado:
Macros e Módulos
O propósito do DBT não é tanto se tornar um conjunto de scripts SQL, mas fornecer aos usuários ferramentas poderosas e ricas em recursos para construir suas próprias transformações e disseminar esses módulos.
Macros são conjuntos de construções e expressões que podem ser chamadas como funções dentro de modelos. As macros permitem reutilizar SQL entre modelos e projetos, de acordo com o princípio de engenharia DRY (Don’t Repeat Yourself).
Exemplo de uma macro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
E sua utilização:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- chamada da macro
from my_table
DBT vem com um gerenciador de pacotes (packages), que permite aos usuários publicar e reutilizar módulos e macros individuais.
Isso significa a capacidade de carregar e usar bibliotecas como:
- : trabalho com Date/Time, Chaves Substitutas, Testes de Esquema, Pivot/Unpivot e outros.
- Modelos prontos para serviços como e
- Bibliotecas para determinados Data Warehouses, como
- — Módulo para registrar o trabalho do DBT
Uma lista completa de pacotes pode ser encontrada em .
Ainda mais possibilidades
Aqui eu descrevo algumas outras características interessantes e implementações que eu e a equipe utilizamos para construir o Armazenamento de Dados em .
Divisão de ambientes de execução DEV — TEST — PROD
Até mesmo dentro de um cluster DWH (no âmbito de diferentes esquemas). Por exemplo, utilizando a seguinte expressão:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Esse código basicamente diz: para os ambientes dev, test, ci traga dados apenas dos últimos 3 dias e não mais. Isso significa que a execução nesses ambientes será muito mais rápida e exigirá menos recursos. Ao rodar no ambiente prod a condição de filtro será ignorada.
Materialização com codificação alternativa de colunas
Redshift é um banco de dados columnar que permite definir algoritmos de compressão de dados para cada coluna específica. A escolha de algoritmos ótimos pode reduzir o espaço ocupado em disco em 20-50%.
Macro executará o comando ANALYZE COMPRESSION, criará uma nova tabela com os algoritmos recomendados de codificação de colunas, usando as chaves de segmentação (dist_key) e de ordenação (sort_key), moverá os dados para ela, e se necessário, eliminará a cópia antiga.
Assinatura da macro:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Registro das execuções dos modelos
Para cada execução de modelo, é possível adicionar hooks que serão executados antes de iniciar ou logo após a conclusão da criação do modelo:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
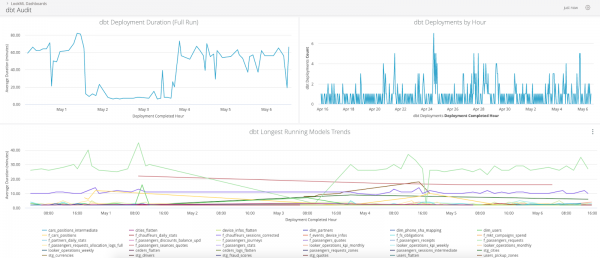
O módulo de log permitirá registrar todos os metadados necessários em uma tabela separada, que posteriormente pode ser utilizada para auditoria e análise de problemas (bottlenecks).
Veja como é o dashboard com os dados de log no Looker:
Automação da manutenção do Armazenamento
Se você está usando algumas extensões de funcionalidade no Armazenamento que está utilizando, como UDF (User Defined Functions), a versionamento dessas funções, gerenciamento de acessos e lançamento automatizado de novas versões é muito conveniente ser realizado no DBT.
Utilizamos UDF em Python para calcular valores de hash, domínios de endereços de e-mail e decodificar máscaras de bits (bitmask).
Exemplo de macro que cria UDF em qualquer ambiente de execução (dev, teste, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
Na Wheely, usamos o Amazon Redshift, que é baseado no PostgreSQL. Para o Redshift, é importante coletar estatísticas sobre as tabelas regularmente e liberar espaço em disco — comandos ANALYZE e VACUUM, respectivamente.
Para isso, todos os dias à noite são executados os comandos da macro redshift_maintenance:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " de " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Realizando VACUUM em " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analisando " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Concluído " ~ relation_to_vacuum ~ " em " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Ignorando relação "' ~ row.values() | join ('"."') ~ '" pois não existe') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
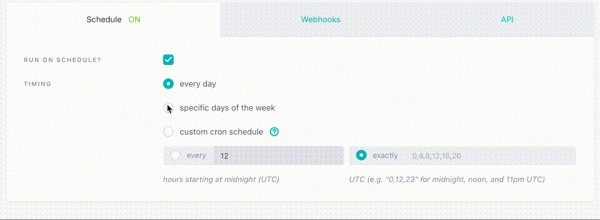
Há a possibilidade de usar o DBT como um serviço (Managed Service). Inclui:
- Web IDE para desenvolvimento de projetos e modelos
- Configuração de jobs e agendamento
- Acesso simples e prático aos logs
- Website com documentação do seu projeto
- Integração CI (Continuous Integration)
Conclusão
Preparar e utilizar o DWH torna-se tão agradável e benéfico quanto beber smoothies. O DBT é composto por Jinja, extensões personalizadas (módulos), um compilador, um motor (executor) e um gerenciador de pacotes. Reunindo esses elementos, você obtém um ambiente de trabalho completo para seu Armazém de Dados. Hoje em dia, dificilmente existe uma melhor maneira de gerenciar transformações dentro do DWH.
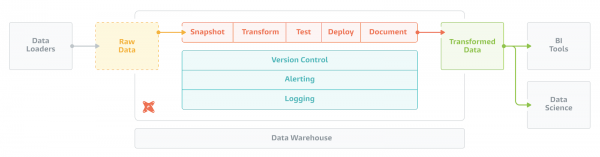
As crenças seguidas pelos desenvolvedores do DBT estão formuladas da seguinte maneira:
- Código, e não GUI, é a melhor abstração para expressar lógica analítica complexa.
- Trabalhar com dados deve adaptar as melhores práticas de desenvolvimento de software.
- A infraestrutura mais importante para trabalhar com dados deve ser controlada pela comunidade de usuários como software de código aberto.
- Não apenas as ferramentas de análise, mas também o código se tornará cada vez mais parte da comunidade Open Source.
Essas crenças fundamentais geraram um produto que hoje é usado em mais de 850 empresas, e elas formam a base para muitas extensões interessantes que serão criadas no futuro.
Para aqueles que estão interessados, há uma gravação de uma aula aberta que ministramos há alguns meses como parte de uma aula aberta na OTUS — .
Além do DBT e dos Armazéns de Dados, no curso de Data Engineer na plataforma OTUS, eu e meus colegas ministramos aulas sobre uma série de outros tópicos relevantes e modernos:
- Conceitos arquitetônicos de aplicativos de Big Data.
- Prática com Spark e Spark Streaming.
- Aprendendo estratégias e ferramentas para carregar fontes de dados.
- Construindo painéis analíticos no DWH.
- Conceitos NoSQL: HBase, Cassandra, ElasticSearch.
- Princípios de organização de monitoramento e orquestração.
- Projeto Final: reunindo todas as habilidades sob a orientação de um mentor.
Links:
- — Documentação oficial.
- — Artigo de revisão de um dos autores do DBT.
- — YouTube, gravação da aula aberta OTUS.
- — Próxima aula aberta em 15 de maio de 2020.
- — OTUS.
- — Uma visão sobre o futuro do trabalho com dados e análise.
- — A evolução da análise e o impacto do código aberto.
- — Princípios da construção de CI usando o DBT.
- — Prática, passo a passo, instruções para trabalho independente.
- — Github, código do projeto de aprendizado
Fonte: habr.com
