

Como um desenvolvedor backend entende que uma consulta SQL funcionará bem em produção? Em grandes ou rapidamente crescentes empresas, o acesso à produção não é garantido para todos. E mesmo com acesso, nem todas as consultas podem ser testadas sem riscos, e criar uma cópia do banco de dados frequentemente leva horas. Para resolver esses problemas, criamos um DBA artificial — Joe. Ele já foi implementado com sucesso em várias empresas e ajuda mais de uma dezena de desenvolvedores.
Vídeo:
Oi pessoal! Meu nome é Anatoly Stansler. Trabalho na empresa . Estamos focados em acelerar o processo de desenvolvimento, eliminando as latências relacionadas ao uso do Postgres para desenvolvedores, DBAs e QA.
Temos clientes incríveis e hoje parte da apresentação será dedicada a casos que encontramos em nosso trabalho com eles. Vou contar como os ajudamos a resolver problemas bastante sérios.
Quando estamos desenvolvendo e realizando migrações complexas e pesadas, nos fazemos a pergunta: "Essa migração vai funcionar?". Usamos revisões, utilizamos os conhecimentos de colegas mais experientes, especialistas em DBA. E eles podem nos dizer — vai funcionar ou não.
Mas, talvez, fosse melhor se pudéssemos testar isso nós mesmos em cópias em tamanho real. E hoje vamos falar exatamente sobre quais abordagens existem atualmente para teste e como isso pode ser feito da melhor forma e com quais ferramentas. Também discutiremos os prós e contras dessas abordagens e o que podemos melhorar aqui.
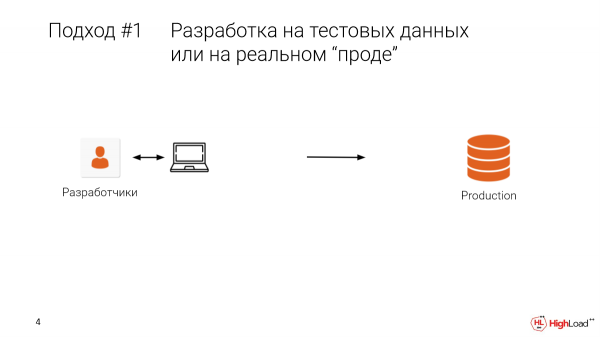
Quem já fez índices ou fez alterações diretamente em produção? Bastante gente. E quantos disso resultaram em perda de dados ou interrupções? Então você conhece essa dor. Graças a Deus, temos backups.
A primeira abordagem é o teste em produção. Ou seja, quando o desenvolvedor está em sua máquina local, possui dados de teste, há uma amostra limitada. E nós implantamos em produção e obtemos essa situação.
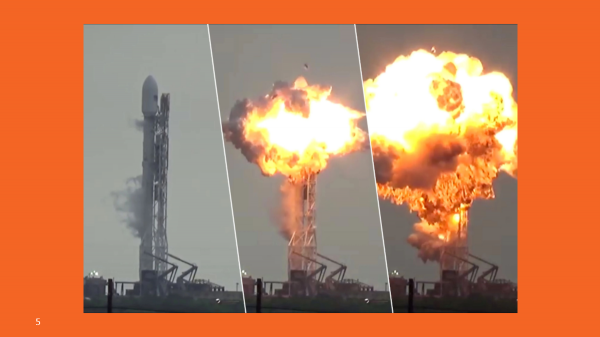
Isso é doloroso, isso é caro. Provavelmente, essa não é a melhor maneira de fazer.
E como podemos fazer isso melhor?
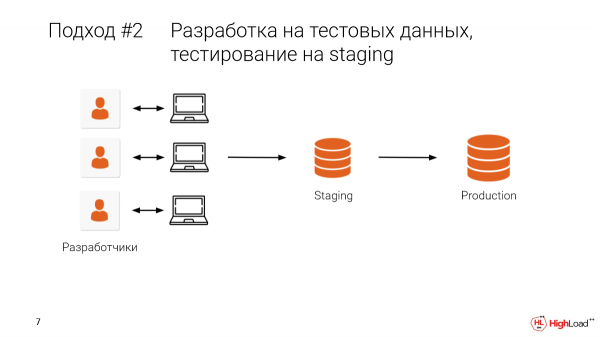
Vamos levar o staging e dedicar uma parte da produção para isso. Ou, na melhor das hipóteses, vamos usar a verdadeira produção, todos os dados. E, após desenvolver localmente, vamos verificar também no staging.
Isso nos permitirá eliminar uma parte dos erros, ou seja, evitar problemas na produção.
Quais são os problemas?
- O problema é que este ambiente de staging é compartilhado com colegas. E muitas vezes acontece que você faz uma alteração e, de repente, não há dados, todo o trabalho perdido. O staging tinha muitos terabytes. E é necessário esperar muito tempo até que ele se recupere. Decidimos adiar isso para amanhã. A nossa desenvolvimento parou.
- E, claro, temos muitos colegas lá, muitas equipes. E é preciso aprovar tudo manualmente. Isso é inconveniente.
E é importante mencionar que temos apenas uma tentativa, um tiro, se quisermos fazer algumas alterações no banco de dados, mexer nos dados, mudar a estrutura. E se algo der errado, se houve um erro na migração, não conseguiremos voltar facilmente.
Isso é melhor do que a abordagem anterior, mas ainda há uma grande probabilidade de que algum erro passe para a produção.
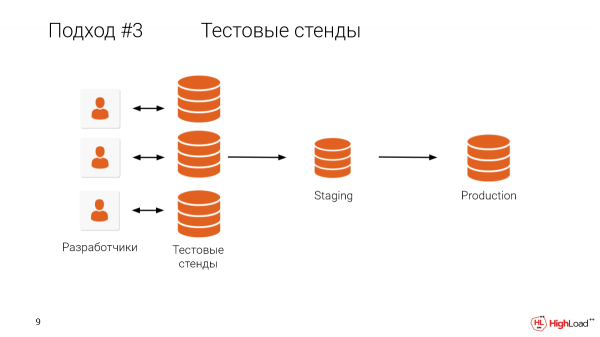
O que nos impede de dar a cada desenvolvedor um ambiente de teste, uma cópia completa? Acho que é evidente o que está impedindo.
Quem tem um banco de dados maior que um terabyte? Mais da metade da sala.
E é claro que manter máquinas para cada desenvolvedor, quando a produção é tão grande, é muito caro e também leva muito tempo.
Temos clientes que entenderam que é muito importante testar todas as mudanças em cópias completas, mas eles têm bancos menores que um terabyte, e não têm recursos para manter um ambiente de teste para cada desenvolvedor. Portanto, eles precisam baixar dumps localmente em suas máquinas e testar dessa forma. Isso leva muito tempo.
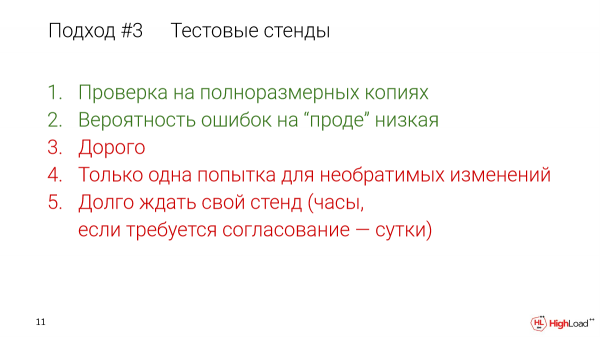
Mesmo que você faça isso dentro da infraestrutura, baixar um terabyte de dados em uma hora já é muito bom. Mas eles usam dumps lógicos, baixam localmente da nuvem. Para eles, a velocidade é em torno de 200 gigabytes por hora. E ainda precisa haver tempo para restaurar do dump lógico, aplicar os índices, etc.
Mas eles usam essa abordagem porque isso permite manter a produção confiável.
O que podemos fazer aqui? Vamos tornar os ambientes de teste baratos e dar a cada desenvolvedor seu próprio ambiente de teste.
E isso é possível.
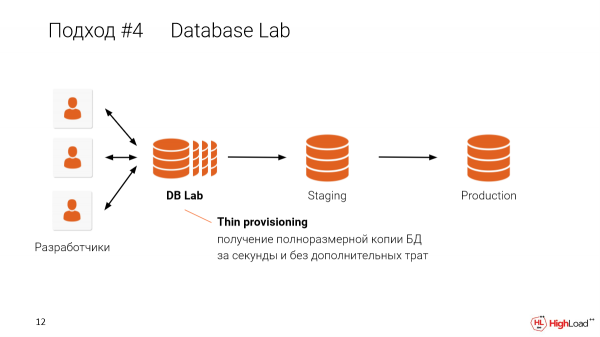
E nesta abordagem, quando criamos clones finos para cada desenvolvedor, podemos compartilhá-los em uma única máquina. Por exemplo, se você tem um banco de dados de quatro terabytes e deseja fornecê-lo a 10 desenvolvedores, não precisa ter 10 bancos de dados de quatro terabytes. Uma única máquina é suficiente para criar cópias isoladas e finas para cada desenvolvedor, usando um só equipamento. Como isso funciona contarei um pouco mais tarde.
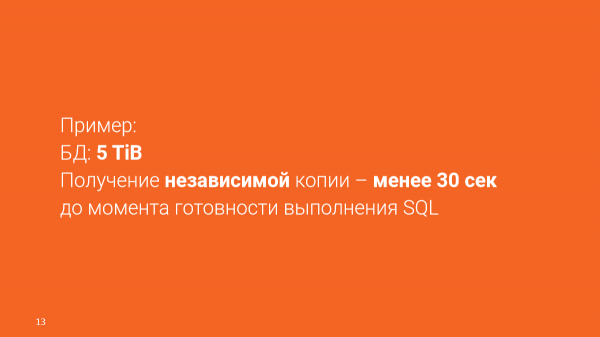
Um exemplo real:
O banco de dados – 4,5 terabytes.
Podemos obter cópias independentes em 30 segundos.
Você não precisa esperar um ambiente de testes e depender do tamanho dele. Você pode obtê-lo em segundos. Serão ambientes totalmente isolados, mas que compartilham dados entre si.
Isso é incrível. Aqui estamos falando de mágica e de um universo paralelo.
No nosso caso, isso funciona com o sistema OpenZFS.
OpenZFS é um sistema de arquivos copy-on-write que já suporta snapshots e clones. É confiável e escalável. É muito fácil de gerenciar. Pode ser implementado em apenas duas linhas de comando.
Existem outras opções:
LVM,
Sistemas de Armazenamento (por exemplo, Pure Storage).
O Database Lab, sobre o qual estou falando, é modular. Pode ser implementado usando essas opções. Mas por enquanto nos concentramos no OpenZFS, porque houve problemas especificamente com LVM.
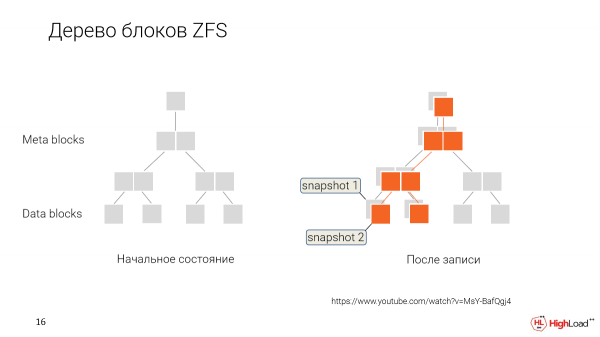
Como isso funciona? Em vez de reescrever os dados cada vez que os modificamos, nós os preservamos, apenas marcando que esses novos dados pertencem a um novo ponto no tempo, a um novo snapshot.
E posteriormente, quando queremos reverter ou criar um novo clone de alguma versão mais antiga, simplesmente dizemos: "Ok, nos dê esses blocos de dados que estão marcados assim".
E esse usuário trabalhará com esse conjunto de dados. Ele os modificará gradualmente, criando seus próprios snapshots.
E teremos ramificações. Cada desenvolvedor, no nosso caso, terá a chance de ter seu próprio clone, que ele pode editar, enquanto os dados que são compartilhados serão compartilhados entre todos.
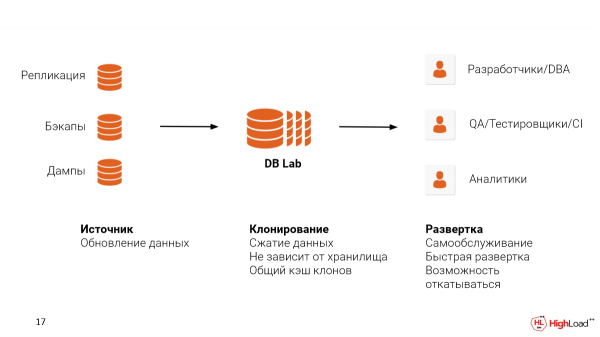
Para implementar um sistema como esse, é necessário resolver dois problemas:
A primeira é a fonte de dados de onde você irá obtê-los. É possível configurar a replicação a partir do ambiente de produção. Você pode usar os backups que já tem configurados, espero. WAL-E, WAL-G ou Barman. E mesmo que você esteja utilizando alguma solução em nuvem, como RDS ou Cloud SQL, você pode usar dumps lógicos. Mas ainda assim, recomendamos utilizar os backups, pois com essa abordagem você também preservará a estrutura física dos arquivos, o que permitirá ficar ainda mais próximo das métricas que você veria em produção, para capturar os problemas existentes.
A segunda é o local onde você deseja hospedar o Database Lab. Pode ser na nuvem ou no local. É importante ressaltar que o ZFS suporta compressão de dados. E faz isso muito bem.
Imagine que cada um desses clones, dependendo das operações que realizamos com o banco, terá um espaço de dev crescente. Para esse dev, também será necessário espaço. Porém, como pegamos um banco de 4,5 terabytes, o ZFS irá compactá-lo para 3,5 terabytes. Dependendo das configurações, isso pode ser ajustado. E ainda teremos espaço para o dev.
Esse sistema pode ser utilizado para diversos casos.
São desenvolvedores e DBAs para verificar consultas e otimizações.
Isso pode ser usado em testes de QA para validar uma migração específica antes que implantemos isso em produção. E também podemos criar ambientes especiais para QA com dados reais, onde eles podem testar novas funcionalidades. E isso levará segundos, em vez de esperar horas ou até mesmo dias em outros casos, onde cópias finas não são utilizadas.
E ainda há um caso separado. Se a empresa não tiver um sistema de analytics configurado, podemos criar um clone fino do banco de dados do produto e disponibilizá-lo para consultas longas ou para índices especiais que podem ser utilizados na análise.
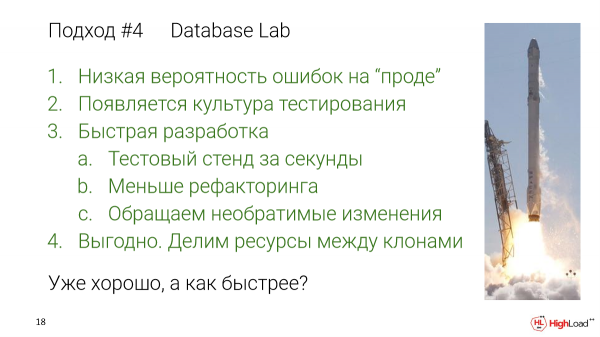
Com essa abordagem:
Baixa probabilidade de erros em produção, pois testamos todas as alterações em dados completos.
Nós desenvolvemos uma cultura de testes, já que agora não é necessário esperar por horas pelo seu próprio ambiente.
E não há barreiras, nem esperas entre os testes. Você realmente pode ir e verificar. E será melhor, pois aceleraremos o desenvolvimento.
Haverá menos refatoração. Menos bugs chegarão ao prod. Nós os refatoraremos menos depois.
Podemos fazer alterações irreversíveis. Isso não está nos métodos padrão.
- É vantajoso, pois dividimos os recursos dos ambientes de teste.
Já é bom, mas o que mais poderia ser acelerado?
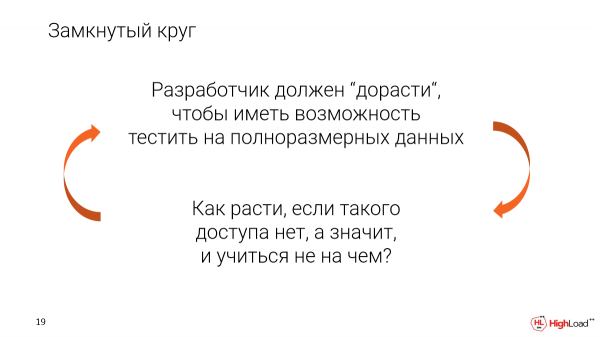
Graças a esse sistema, podemos reduzir bastante a barreira de entrada para esse tipo de teste.
Atualmente, existe um ciclo vicioso, onde o desenvolvedor, para ter acesso a dados reais em tamanho real, precisa se tornar um especialista. Ele deve ter esse acesso confiável.
Mas como crescer se não há isso? E se você tiver acesso apenas a um conjunto muito pequeno de dados de teste? Então não será possível ganhar experiência real.
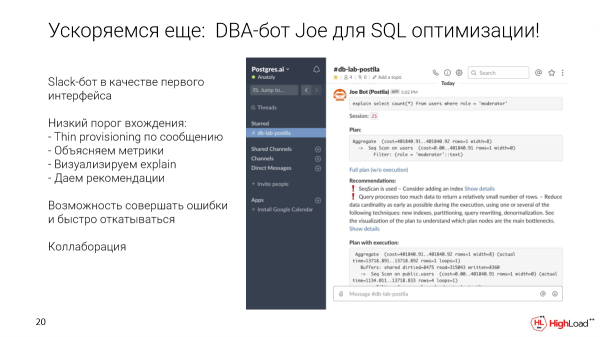
Como sair desse ciclo? Como primeira interface, acessível para desenvolvedores de todos os níveis, escolhemos um bot do Slack. Mas pode ser qualquer outra interface.
O que ele permite fazer? Você pode pegar uma consulta específica e enviá-la para um canal especial para o banco de dados. Nós automaticamente, em segundos, implantaremos um clone leve. Executaremos essa consulta. Coletaremos métricas e recomendações. Mostraremos a visualização. E, em seguida, esse clone permanecerá para que essa consulta possa ser otimizada, adicionar índices, etc.
E também o Slack nos oferece oportunidades de colaboração prontas para uso. Como é apenas um canal, podemos começar a discutir essa consulta diretamente no thread, mencionando nossos colegas, DBAs que estão dentro da empresa.
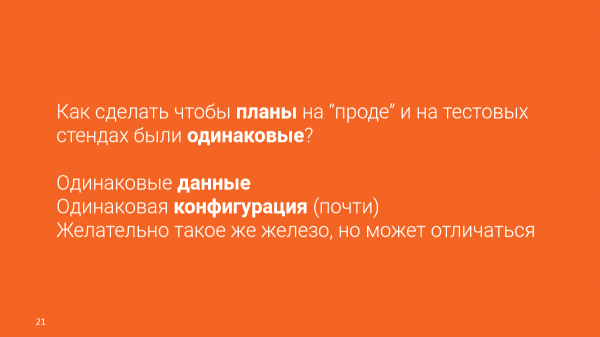
Mas, claro, existem problemas. Como estamos no mundo real, e usamos um servidor que hospeda muitos clones ao mesmo tempo, temos que limitar a quantidade de memória e capacidade de processamento disponíveis para os clones.
Mas para que esses testes sejam realistas, precisamos resolver esse problema de alguma forma.
É claro que um aspecto importante são os dados idênticos. Mas isso nós já temos. E queremos alcançar uma configuração idêntica. E podemos fornecer uma configuração praticamente idêntica.
Seria ótimo ter o mesmo hardware que na produção, mas isso pode variar.
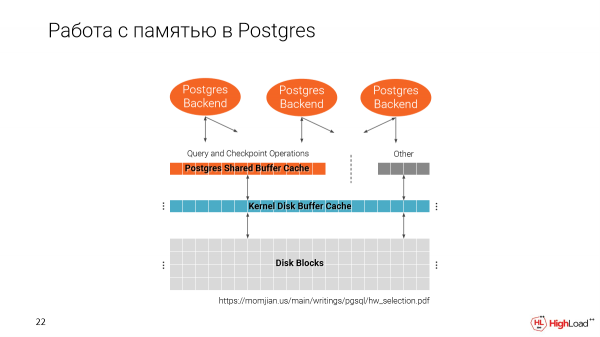
Vamos lembrar como o Postgres trabalha com a memória. Temos dois caches. Um do sistema de arquivos e outro do próprio Postgres, ou seja, o Shared Buffer Cache.
É importante notar que o Shared Buffer Cache é alocado ao iniciar o Postgres, dependendo do tamanho que você definir na configuração.
E o segundo cache utiliza todo o espaço disponível.
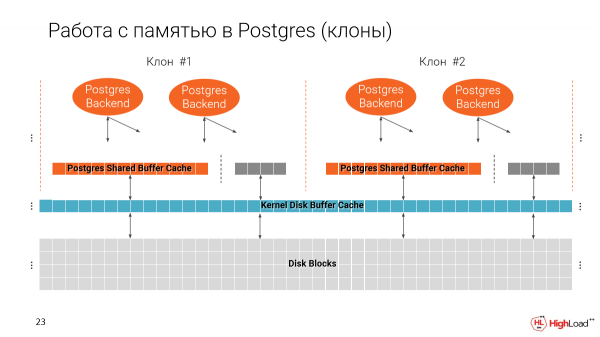
E quando fazemos várias cópias em uma única máquina, acabamos preenchendo a memória gradualmente. E, na verdade, o Shared Buffer Cache deve ser cerca de 25% do total de memória disponível na máquina.
E assim, se não mudarmos esse parâmetro, poderemos executar apenas 4 instâncias em uma máquina, ou seja, apenas 4 dessas cópias leves. E isso é, claro, ruim, porque gostaríamos de ter muito mais.
Mas, por outro lado, o Buffer Cache é usado para executar consultas, para índices, ou seja, o plano depende do tamanho de nossos caches. E se simplesmente pegarmos esse parâmetro e diminuirmos, nossos planos podem mudar significativamente.
Por exemplo, se em produção tivermos um cache grande, o Postgres preferirá usar o índice. Se não, então será SeqScan. E qual seria o sentido se esses planos não coincidissem?
Mas aqui chegamos à conclusão de que, na verdade, o plano no Postgres não depende do tamanho específico definido no Shared Buffer, mas sim do effective_cache_size.
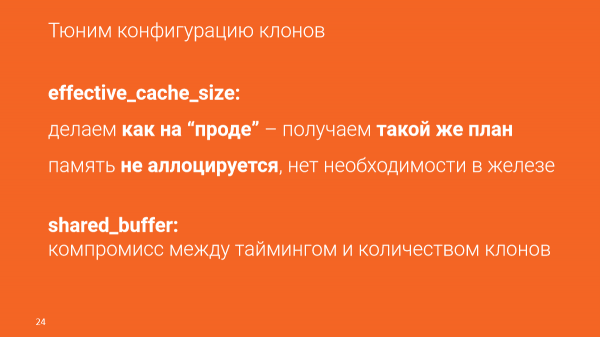
Effective_cache_size é o volume estimado de cache que temos disponível, ou seja, a soma do Buffer Cache e do cache do sistema de arquivos. Isso é definido pela configuração. E essa memória não é alocada.
E com esse parâmetro, podemos enganar o Postgres, dizendo que temos, na verdade, muitos dados disponíveis, mesmo que não os tenhamos. Dessa forma, os planos coincidirão completamente com a produção.
Mas isso pode influenciar o timing. E otimizamos as consultas com base no timing, mas é importante que o timing depende de muitos fatores:
Depende da carga atual em produção.
Depende das características da própria máquina.
E esse é um parâmetro indireto, mas na verdade podemos otimizar com base na quantidade de dados que essa consulta irá ler para obter o resultado.
E se quisermos que o tempo seja semelhante ao que veremos em produção, precisamos usar hardware o mais parecido possível e, talvez, até mais, para que todas as cópias caibam. Mas isso é um compromisso, ou seja, você terá os mesmos planos, verá quanta informação uma consulta específica lê e poderá concluir – esta consulta é boa (ou a migração) ou ruim, precisando de mais otimização.
Vamos detalhar como a otimização ocorre com o Joe.
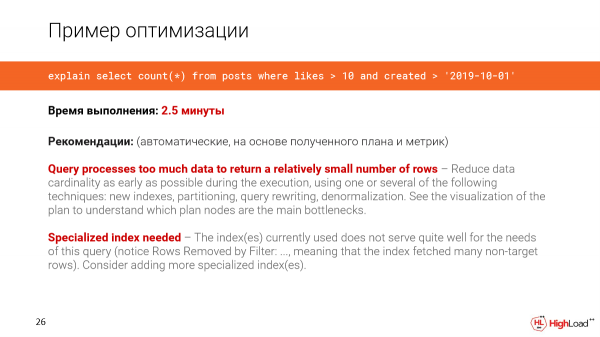
Vamos usar uma consulta de um sistema real. Neste caso, a base de dados tem 1 terabyte. E queremos calcular o número de posts recentes que tiveram mais de 10 likes.
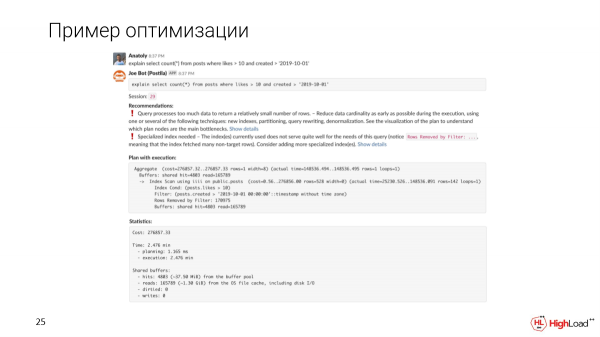
Nós enviamos uma mensagem no canal e um clone foi ativado para nós. E veremos que tal consulta levará 2,5 minutos. Essa é a primeira coisa que notaremos.
O Joe mostrará recomendações automáticas baseadas no plano e nas métricas.
Veremos que a consulta está processando muitos dados para obter um número relativamente pequeno de linhas. E precisamos de algum índice especializado, uma vez que notamos que na consulta existem muitas linhas filtradas.
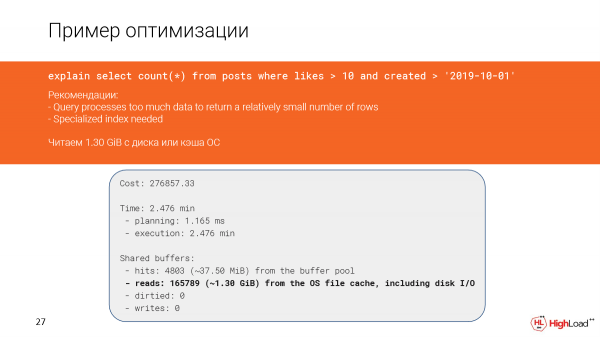
Vamos examinar mais de perto o que aconteceu. De fato, vemos que lemos quase um giga e meio de dados do cache de arquivos ou até mesmo do disco. E isso não é bom, pois conseguimos apenas 142 linhas.
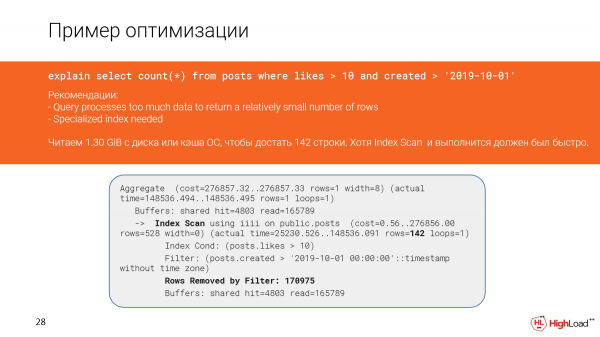
E, aparentemente, temos um índice de varredura e deveria ter sido rápido, mas, como filtramos muitas linhas (tivemos que contá-las), a consulta foi lenta.
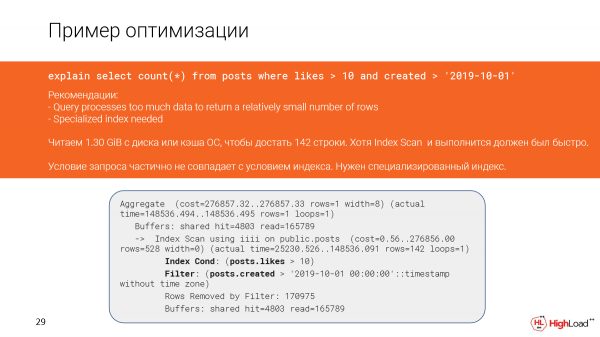
E isso ocorreu no plano devido ao fato de que as condições da consulta e as condições do índice não coincidem parcialmente.
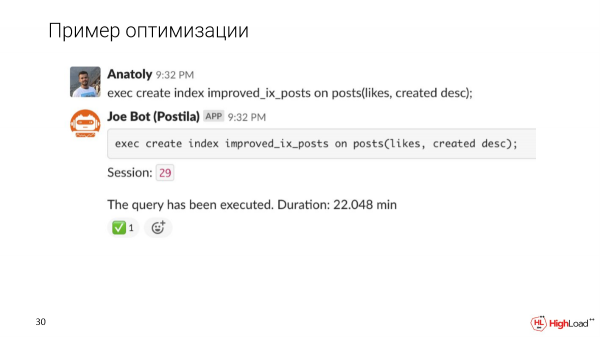
Vamos tentar fazer um índice mais preciso e ver como a execução da consulta mudará depois disso.
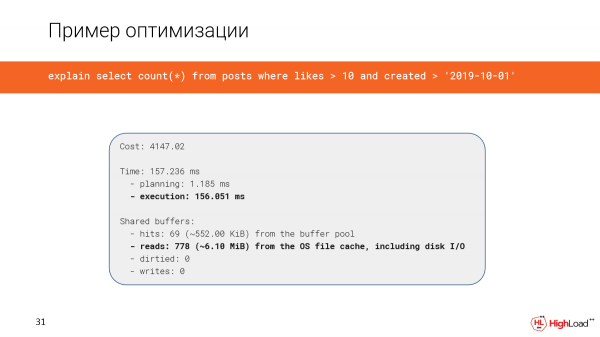
A criação do índice levou bastante tempo, mas agora checamos a consulta e vemos que o tempo, em vez de 2,5 minutos, agora é de apenas 156 milissegundos, o que é bastante bom. E estamos lendo apenas 6 megabytes de dados.
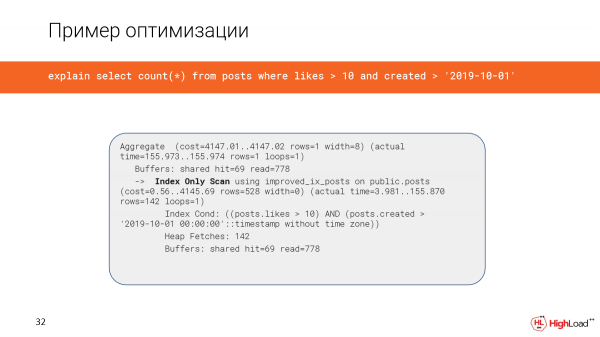
E agora estamos usando uma varredura apenas de índice.
Outra questão importante é que queremos apresentar o plano de uma maneira mais compreensível. Implementamos uma visualização com o uso de Flame Graphs.
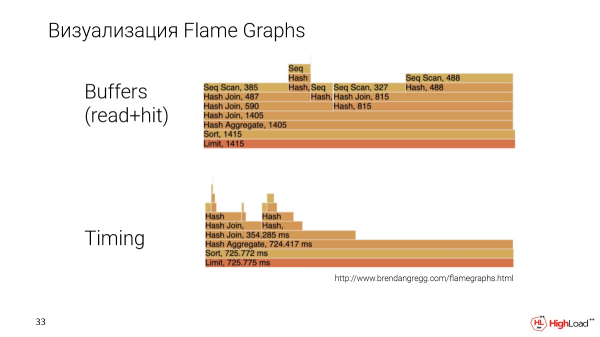
Esta é uma consulta diferente, mais complexa. Construímos os Flame Graphs com base em dois parâmetros: a quantidade de dados que um nó específico no plano leu e o tempo, ou seja, o tempo de execução do nó.
Aqui podemos comparar especificamente os nós entre si. E será claro qual deles ocupa mais ou menos espaço, o que geralmente é complicado de fazer em outros métodos de visualização.
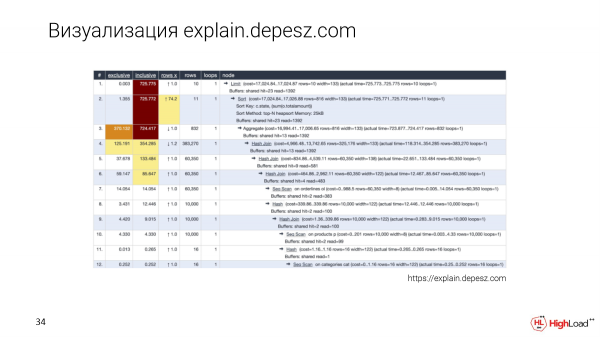
Claro, todos conhecem explain.depesz.com. Uma boa característica dessa visualização é que salvamos o plano textual e também extraímos alguns parâmetros principais em uma tabela, para que possamos classificar.
E desenvolvedores que ainda não se aprofundaram nesse tema também utilizam explain.depesz.com, porque para eles é mais fácil entender quais métricas são importantes e quais não são.
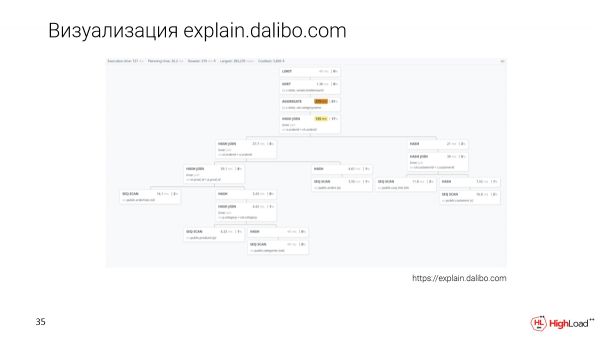
Há uma nova abordagem de visualização – é o explain.dalibo.com. Eles fazem uma visualização em árvore, mas aqui é muito difícil comparar os nós entre si. Aqui dá para entender bem a estrutura, na verdade, se houver uma consulta grande, será necessário rolar para lá e para cá, mas também é uma opção.
Colaboração
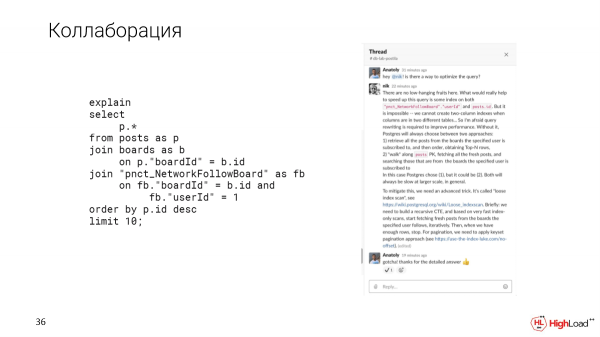
E, como já disse, o Slack nos oferece a possibilidade de colaboração. Por exemplo, se encontramos uma consulta complicada que não sabemos como otimizar, podemos esclarecer essa questão no thread do Slack com nossos colegas.
Acreditamos que é importante testar com dados de tamanho real. Para isso, criamos a ferramenta Update Database Lab, que está disponível em código aberto. Você pode usar o bot Joe também. Você pode pegá-lo agora e implementá-lo em seu sistema. Todos os guias estão disponíveis lá.
É importante também ressaltar que a solução em si não é algo revolucionário, porque existe o Delphix, mas é uma solução empresarial. Ela é totalmente fechada e custa muito caro. Nós nos especializamos em Postgres. Todos esses produtos são open source. Junte-se a nós!
Com isso, eu encerro. Obrigado!
Perguntas
Olá! Obrigado pela palestra! Muito interessante, especialmente para mim, porque enfrentei uma tarefa semelhante há algum tempo atrás. E por isso tenho uma série de perguntas. Espero conseguir fazer pelo menos algumas.
É interessante saber como você calcula o espaço para esse ambiente? A tecnologia pressupõe que sob certas circunstâncias seus clones podem crescer até o tamanho máximo. Grosso modo, se você tem um banco de dados de dez terabytes e 10 clones, é fácil simular uma situação em que cada clone ocuparia 10 dados únicos. Como você calcula esse espaço, ou seja, a delta da qual você falou, onde esses clones vão viver?
Boa pergunta. Aqui é importante monitorar clones específicos. Se houver uma alteração muito grande em um clone, e ele começar a crescer, podemos, primeiro, emitir um aviso ao usuário sobre isso, ou então parar imediatamente esse clone para evitar uma situação de falha.
Sim, eu tenho uma pergunta adicional. Ou seja, como você garante o ciclo de vida desses módulos? Para nós, isso é um problema e uma história separada. Como isso funciona?
Cada clone tem um certo ttl. Basicamente, temos um ttl fixo.
Qual é, se não for segredo?
1 hora, ou seja, idle – 1 hora. Se não for utilizado, nós o descartamos. Mas isso não é surpreendente, pois podemos levantar um clone em segundos. E se ele for necessário novamente, é só fazer.
Estou curioso também sobre a escolha das tecnologias, porque nós, por exemplo, usamos vários métodos ao mesmo tempo por várias razões. Por que exatamente ZFS? Por que você não usou LVM? Você mencionou que houve problemas com LVM. Quais foram os problemas? A meu ver, a opção com a SAN é a mais otimizada em termos de desempenho.
Qual é o principal problema com ZFS? O fato de que você deve operar em um único host, ou seja, todas as instâncias viverão dentro do mesmo sistema operacional. No caso de uma SAN, você pode conectar diferentes equipamentos. O único gargalo são os blocos que estão na SAN. E a pergunta sobre a escolha das tecnologias é realmente interessante. Por que não usar LVM?
Podemos discutir especificamente sobre LVM no meetup. Sobre a SAN – isso é simplesmente caro. O sistema ZFS pode ser implementado em qualquer lugar. Você pode instalá-lo na sua máquina. Você pode apenas baixar o repositório e instalá-lo. ZFS pode ser instalado praticamente em qualquer lugar, se estamos falando de Linux. Ou seja, temos uma solução muito flexível. E o próprio ZFS, pronto para uso, oferece muito. Você pode carregar tantos dados quanto quiser, conectar um grande número de discos, há snapshots. E, como já mencionei, é fácil de administrar. Ou seja, parece ser muito agradável de usar. Ele é testado, tem muitos anos. E possui uma comunidade muito grande que continua a crescer. ZFS é uma solução muito confiável.
Nikolai Samokhvalov: Posso fazer mais um comentário? Meu nome é Nikolai, trabalho junto com Anatoly. Concordo que a SAN é excelente. E alguns dos nossos clientes têm Pure Storage, etc.
Anatoly corretamente observou que estamos focados na modularidade. No futuro, podemos implementar uma única interface – faça um snapshot, faça um clone, destrua o clone. Tudo isso é simples. E o storage é incrível, se estiver disponível.
Mas o ZFS está disponível para todos. Já chega de DelPhix, eles têm 300 clientes. Destes, 50 estão na lista da Fortune 100, ou seja, eles miram no NASA e assim por diante. É hora de todos terem essa tecnologia. E é por isso que temos o Core open source. Temos uma parte da interface que não é open source. Esta é a plataforma que vamos mostrar. Mas queremos que isso esteja acessível a todos. Queremos fazer uma revolução para que todos os testadores parem de adivinhar em laptops. Precisamos escrever SELECT e ver imediatamente que está lento. Chega de esperar que o DBA fale sobre isso. Esse é o nosso principal objetivo. E eu acho que conseguiremos isso. E estamos fazendo essa solução para que todos tenham acesso. Por isso o ZFS, porque ele estará disponível em toda parte. Obrigado à comunidade por resolver problemas e por ter licença open source, etc.
Saudações! Obrigado pela apresentação! Meu nome é Maxim. Nós enfrentamos os mesmos problemas. Nós já resolvemos. Como vocês dividem os recursos entre esses clones? Cada clone pode estar lidando com algo diferente a qualquer momento: um testa uma coisa, o outro outra, alguém está construindo um índice, outro está executando um job pesado. E, se for possível dividir pelo CPU, como vocês fazem em relação ao IO? Essa é a primeira pergunta.
E a segunda pergunta é sobre a discrepância entre os ambientes. Suponha que eu tenha ZFS aqui e tudo esteja ótimo, mas o cliente em produção não tem ZFS, e sim ext4, por exemplo. Como vocês lidam com isso?
Essas são questões muito boas. Eu mencionei um pouco sobre o problema de como dividimos os recursos. A solução é a seguinte. Imagine que você está testando no staging. Você também pode ter uma situação em que alguém está gerando uma carga, enquanto outra pessoa gera outra. E, no final, você vê métricas confusas. Um problema semelhante pode ocorrer em produção. Quando você quer verificar um determinado comando e vê que há algum problema – ele está processando lentamente – na verdade, o problema não estava no comando, mas na carga paralela.
Portanto, é importante focar em qual será o plano, quais etapas seguiremos e quantos dados iremos levantar para isso. O fato de que teremos discos, por exemplo, sendo sobrecarregados com algo, impactará especificamente no timing. Mas podemos avaliar, com base na quantidade de dados, quão intensa é essa solicitação. Não é tão importante que, ao mesmo tempo, haja alguma outra execução.
Eu tenho duas perguntas. Isso é realmente incrível. Houve casos em que dados em produção são criticamente importantes, como números de cartões de crédito? Já existe algo pronto ou isso é uma tarefa separada? E a segunda pergunta – existe algo assim para MySQL?
Sobre os dados. Nós faremos ofuscação, enquanto isso não estamos fazendo. Mas se você está implementando especificamente o Joe, e não dá acesso aos desenvolvedores, então não há acesso aos dados. Por quê? Porque o Joe não mostra os dados. Ele apenas mostra métricas, planos e tudo mais. Isso foi feito intencionalmente, pois é uma das exigências do nosso cliente. Eles queriam ter a capacidade de otimizar, mas sem dar acesso indiscriminado a todos.
Sobre o MySQL. Este sistema pode ser usado para qualquer coisa que armazene estado no disco. E como estamos focando no Postgres, atualmente estamos priorizando toda a automação para o Postgres. Queremos automatizar a recuperação de dados do backup. Estamos configurando o Postgres corretamente. Sabemos como fazer para que os planos coincidam, etc.
Mas como o sistema é expansível, também poderá ser utilizado para MySQL. Existem alguns exemplos disso. Um sistema similar está no Yandex, mas eles não publicam em nenhum lugar. Eles usam isso internamente no Yandex.Metrica. E lá, de fato, é uma história sobre MySQL. Mas as tecnologias são as mesmas, ZFS.
Obrigado pela apresentação! Eu também tenho algumas perguntas. Você mencionou que a clonagem pode ser utilizada para análise, por exemplo, para construir índices adicionais. Poderia nos contar um pouco mais sobre como isso funciona?
E já vou fazer a segunda pergunta sobre a uniformidade dos ambientes e dos planos. O plano depende, entre outras coisas, da estatística coletada pelo Postgres. Como você resolve esse problema?
Não temos análises de casos específicos, pois ainda não utilizamos dessa forma, mas essa possibilidade existe. Se falarmos sobre índices, imagine que um pedido é executado em uma tabela com centenas de milhões de registros e em uma coluna que geralmente não está indexada em produção. E nós queremos calcular alguns dados. Se esse pedido for executado em produção, há a possibilidade de que a produção tenha uma paralisação, pois o pedido pode levar um minuto para ser processado.
Certo, vamos criar um clone leve, que não seja um problema parar por alguns minutos. E para torna mais fácil calcular a análise, adicionaremos índices nas colunas que nos interessam.
O índice será criado toda vez?
Podemos fazer de modo que mexamos nos dados, façamos snapshots, e depois recuperemos desses snapshots para executar novos pedidos. Ou seja, podemos criar novos clones já com os índices definidos.
Quanto à questão sobre estatísticas, se estamos nos recuperando de um backup, se estamos fazendo replicação, as estatísticas serão exatamente as mesmas. Pois teremos toda a estrutura física dos dados, ou seja, traremos os dados como estão, com todas as métricas estatísticas.
Aqui temos um outro problema. Se você está utilizando uma solução em nuvem, apenas dumps lógicos estão disponíveis, pois Google, Amazon não permitem acessar uma cópia física. Esse será o problema.
Obrigado pela apresentação. Aqui surgiram duas boas perguntas sobre MySQL e sobre a divisão de recursos. Mas, essencialmente, tudo se resume ao fato de que isso não é uma questão de sistemas gerenciadores de banco de dados específicos, mas sim do sistema de arquivos como um todo. Portanto, as questões de divisão de recursos também devem ser abordadas a partir desse ponto, não no final, considerando que se trata de Postgres, mas sim no sistema de arquivos. servidor, na instância.
Minha pergunta é um pouco diferente. Ela se aproxima mais da multilayer dos bancos de dados, onde existem várias camadas. Por exemplo, configuramos a atualização de uma imagem de dez terabytes, estamos realizando a replicação. E usamos essa solução especificamente para bancos de dados. A replicação está ativa, enquanto a atualização dos dados ocorre. Paralelamente, 100 funcionários estão trabalhando, constantemente executando diferentes snapshots. O que fazer? Como evitar conflitos, caso eles executem uma operação e, em seguida, a estrutura do sistema de arquivos seja alterada, e esses snapshots fiquem corrompidos?
Eles não vão, porque é assim que o ZFS funciona. Podemos manter, separadamente, em um fluxo, as alterações do sistema de arquivos que, graças à replicação, chegam. E manter clones das versões antigas dos dados que os desenvolvedores usam. E isso está funcionando para nós, está tudo bem.
Então, a atualização acontecerá como uma camada adicional, e todas as novas instantâneas serão geradas a partir dessa camada, certo?
Das camadas anteriores, que foram das replicações anteriores.
As camadas anteriores desaparecerão, mas elas estarão referenciadas na camada antiga, e as novas imagens serão extraídas da última camada obtida na atualização?
Em geral, sim.
Então, como consequência, teremos muitas camadas. E com o tempo, elas precisarão ser compactadas?
Sim, exatamente. Há uma certa janela. Mantemos instantâneas semanais. Isso depende de quão grande é o seu recurso. Se você puder armazenar muitos dados, pode manter as instantâneas por muito tempo. Elas não serão excluídas automaticamente. Não haverá corrupção de dados. Se as instantâneas estiverem desatualizadas, como achamos, ou seja, isso depende da política da empresa, podemos simplesmente excluí-las e liberar espaço.
Olá, obrigado pela apresentação! Em relação à pergunta do Joe. Você disse que o cliente não queria dar acesso irrestrito aos dados. Estritamente falando, se uma pessoa possui o resultado do Explain Analyze, ela pode visualizar os dados.
Isso mesmo. Por exemplo, podemos escrever: "SELECT FROM WHERE email = algo assim". Ou seja, não veremos os próprios dados, mas poderemos olhar alguns indícios indiretos. Isso precisa ser compreendido. Mas, por outro lado, isso tudo é visível. Temos auditoria de logs, temos o controle de outros colegas, que também veem o que os desenvolvedores estão fazendo. E se alguém tentar fazer isso, a equipe de segurança virá até eles e investigará a questão.
Bom dia! Obrigado pela apresentação! Tenho uma pergunta rápida. Se o Slack não é usado na empresa, existe algum tipo de vinculação atualmente, ou é possível desenvolver instâncias para os desenvolvedores se conectarem ao aplicativo de teste da base de dados?
Atualmente, há integração com o Slack, ou seja, não há outros mensageiros disponíveis, mas gostaríamos muito de implementar suporte a outros mensageiros também. O que você pode fazer? Você pode implantar o DB Lab em sua infraestrutura sem o Joe, usar a API REST ou a nossa plataforma para criar clones e conectar-se ao PSQL. Mas isso só pode ser feito se você estiver disposto a fornecer acesso aos dados para seus desenvolvedores, pois aqui não teremos mais uma interface gráfica.
Não preciso dessa camada, mas sim dessa funcionalidade.
Então – sim, isso pode ser feito.
Fonte: habr.com
