

A Variti desenvolve proteção contra bots e ataques DDoS, além de realizar testes de estresse e carga. Na conferência HighLoad++ 2018, falamos sobre como proteger os recursos contra diferentes tipos de ataques. Em resumo: isole partes do sistema, use serviços em nuvem e CDN, e mantenha-se sempre atualizado. Mas sem empresas especializadas em proteção, você ainda não conseguirá se proteger 🙂
Antes de ler o texto, você pode verificar os pontos-chave .
E se você não gosta de ler ou simplesmente quer assistir ao vídeo, a gravação da nossa apresentação está abaixo, sob o spoiler.
Gravação da apresentação
Muitas empresas já sabem como realizar testes de carga, mas nem todas fazem testes de estresse. Alguns de nossos clientes acreditam que seus sites são invulneráveis porque têm um sistema de highload, que os protege bem contra ataques. Nós mostramos que isso não é bem verdade.
Com certeza, antes de realizar os testes, obtemos a autorização do cliente, com assinatura e carimbo, e com a nossa ajuda um ataque DDoS não pode ser realizado contra ninguém. Os testes são feitos no horário escolhido pelo cliente, quando o tráfego em seu recurso é mínimo, e os problemas de acesso não impactam os clientes. Além disso, como sempre pode haver imprevistos durante os testes, mantemos contato constante com o cliente. Isso permite não apenas relatar os resultados alcançados, mas também fazer ajustes durante o teste. Ao final do teste, sempre elaboramos um relatório que aponta as deficiências encontradas e oferecemos recomendações para corrigir as fragilidades do site.
Como trabalhamos
Ao realizar os testes, emulamos um botnet. Como trabalhamos com clientes que não estão em nossas redes, para que o teste não termine no primeiro minuto devido a limites ou proteções ativadas, geramos carga não de um único IP, mas de nossa própria sub-rede. Além disso, para criar uma carga significativa, temos nosso próprio servidor de testes suficientemente potente.
Postulados
Muito — não significa bem
Quanto menor for a carga que conseguirmos levar o recurso à falha, melhor. Se conseguirmos fazer com que o site deixe de funcionar com uma solicitação por segundo, ou até mesmo com uma solicitação por minuto, será maravilhoso. Porque, por lei de Murphy, usuários ou atacantes acabarão encontrando exatamente essa vulnerabilidade.
Uma falha parcial é melhor do que uma total
Sempre aconselhamos a tornar os sistemas heterogêneos. E a separação deve ocorrer no nível físico, e não apenas por meio de contêineres. No caso de separação física, mesmo que algo falhe no site, é grande a probabilidade de que ele não pare completamente, e os usuários tenham acesso, pelo menos, a parte da funcionalidade.
A arquitetura correta é a base da resiliência
A resiliência do recurso e sua capacidade de suportar ataques e cargas devem ser planejadas na fase de design, de fato, na fase de esboçar os primeiros fluxogramas no caderno. Porque se erros fatais se infiltrarão, corrigi-los posteriormente é possível, mas muito difícil.
Não só o código deve ser bom, mas também a configuração
Muitos pensam que uma boa equipe de desenvolvimento é garantia de resiliência do serviço. Uma boa equipe de desenvolvimento é realmente necessária, mas também deve haver uma boa operação, um bom DevOps. Ou seja, são necessários especialistas que configurem corretamente o Linux e a rede, escrevam corretamente as configurações no nginx, ajustem limites e assim por diante. Caso contrário, o recurso funcionará bem apenas nos testes, mas em produção, em algum momento, tudo poderá quebrar.
Diferenças entre testes de carga e de estresse
Os testes de carga permitem identificar os limites de funcionamento do sistema. Os testes de estresse visam encontrar os pontos fracos do sistema e são usados para quebrar esse sistema e observar como ele se comporta durante a falha de algumas partes. Nesse processo, a natureza da carga geralmente permanece desconhecida para o cliente antes do início do teste de estresse.
Características distintivas dos ataques L7
Classificamos os tipos de carga em cargas de nível L7 e L3&4. L7 refere-se à carga no nível de aplicação, que geralmente é entendida apenas como HTTP, mas aqui entendemos qualquer carga no nível do protocolo TCP.
Os ataques L7 têm características distintas. Em primeiro lugar, eles chegam diretamente ao aplicativo, ou seja, dificilmente podem ser refletidos por meio de medidas de rede. Esses ataques envolvem lógica e, por isso, consomem de forma muito eficaz e com baixo tráfego CPU, memória, disco, banco de dados e outros recursos.
Inundação HTTP
Em qualquer tipo de ataque, é mais fácil criar a carga do que processá-la, e isso também é verdade para o L7. O tráfego do ataque nem sempre é fácil de distinguir do tráfego legítimo, e na maioria das vezes isso pode ser feito pela frequência, mas se tudo for planejado adequadamente, é impossível, com os logs, entender onde está o ataque e onde estão as requisições legítimas.
Como primeiro exemplo, vamos considerar um ataque de Inundação HTTP. O gráfico mostra que, geralmente, esses ataques são muito poderosos; no exemplo abaixo, o número pico de requisições superou 600 mil por minuto.
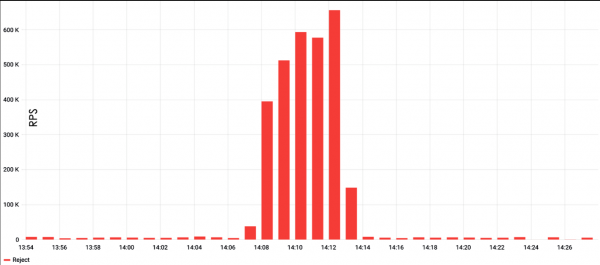
A Inundação HTTP é a forma mais simples de gerar carga. Normalmente, uma ferramenta de teste de carga é utilizada, como o ApacheBench, e são definidos a requisição e o alvo. Com essa abordagem simples, há uma grande probabilidade de esbarrar no cache do servidor, mas isso é fácil de contornar. Por exemplo, adicionando linhas aleatórias à requisição, o que forçará o servidor a sempre entregar uma página atualizada.
Não devemos esquecer do user-agent no processo de criação de carga. Muitos user-agents de ferramentas de teste populares são filtrados por administradores de sistemas, e nesse caso a carga pode simplesmente não chegar ao backend. É possível melhorar significativamente o resultado inserindo no pedido um cabeçalho mais ou menos válido de um navegador.
Apesar da simplicidade, os ataques de Inundação HTTP também têm suas desvantagens. Em primeiro lugar, são necessárias grandes potências para gerar carga. Em segundo lugar, esses ataques são muito fáceis de detectar, especialmente se originam de um único endereço. Como resultado, as requisições começam imediatamente a ser filtradas, seja por administradores de sistemas, seja até mesmo no nível do provedor.
O que procurar
Para reduzir o número de requisições por segundo sem comprometer a eficiência, é necessário usar um pouco de criatividade e explorar o site. Assim, não apenas o canal ou o servidor podem ser sobrecarregados, mas também partes específicas da aplicação, como bancos de dados ou sistemas de arquivos. Além disso, pode-se procurar por áreas no site que realizam cálculos pesados: calculadoras, páginas com seleção de produtos, entre outros. Por fim, muitas vezes há um script PHP no site que gera a página a partir de várias centenas de milhares de linhas. Esse script também sobrecarrega significativamente o servidor e pode se tornar um alvo de ataque.
Onde procurar
Quando escaneamos um recurso antes de realizar testes, primeiramente olhamos para o próprio site. Buscamos diversos campos de entrada, arquivos pesados - basicamente, tudo o que pode causar problemas ao recurso e desacelerá-lo. Aqui, ferramentas simples de desenvolvimento no Google Chrome e no Firefox ajudam ao mostrar os tempos de resposta da página.
Também escaneamos subdomínios. Por exemplo, se há uma loja online, abc.com, e ela possui um subdomínio admin.abc.com. Provavelmente, este é o painel de administração com autenticação, mas se o submetermos a carga, isso pode causar problemas ao recurso principal.
O site pode ter um subdomínio api.abc.com. Provavelmente, este é um recurso para aplicativos móveis. O aplicativo pode ser encontrado na App Store ou Google Play, configurando um ponto de acesso especial, manipulando a API e registrando contas de teste. O problema é que muitas vezes as pessoas pensam que tudo que está protegido por autenticação é invulnerável a ataques de negação de serviço. Supostamente, a autenticação é o melhor CAPTCHA, mas não é assim. Criar 10-20 contas de teste é simples, e ao fazê-lo, obtemos acesso a funcionalidades complexas e não expostas.
Naturalmente, observamos o histórico, o robots.txt e o WebArchive, ViewDNS, buscando versões antigas do recurso. Às vezes acontece que os desenvolvedores lançaram, digamos, mail2.yandex.net, mas uma versão antiga, mail.yandex.net, permanece. Este mail.yandex.net deixa de ser suportado, não recebe recursos de desenvolvimento, mas continua consumindo o banco de dados. Consequentemente, utilizando a versão antiga é possível explorar efetivamente os recursos do backend e tudo o que está por trás da estrutura. Claro, isso não acontece sempre, mas nos deparamos com situações semelhantes com bastante frequência.
Naturalmente, analisamos todos os parâmetros de solicitação, a estrutura dos cookies. Podemos, por exemplo, injetar um valor em um array JSON dentro do cookie, criar uma grande profundidade e fazer o recurso funcionar de forma desnecessariamente lenta.
Carga na pesquisa
A primeira coisa que vem à mente ao investigar um site é sobrecarregar o banco de dados, uma vez que a pesquisa está presente na maioria deles e, infelizmente, quase todos a protegem mal. Por alguma razão, os desenvolvedores não prestam atenção suficiente à pesquisa. Mas aqui vai uma recomendação — não faça consultas semelhantes, pois você pode se deparar com o cache, assim como no caso de um ataque de inundação HTTP.
Fazer consultas aleatórias no banco de dados também nem sempre é eficaz. É muito melhor criar uma lista de palavras-chave que se relacionam com a pesquisa. Voltemos ao exemplo da loja online: suponha que o site venda pneus de carro e permita definir o raio dos pneus, tipo de carro e outros parâmetros. Portanto, combinações de palavras relevantes farão o banco de dados operar em condições muito mais complexas.
Além disso, vale a pena usar paginação: é muito mais difícil para a pesquisa devolver a penúltima página de resultados do que a primeira. Assim, com a paginação, é possível diversificar um pouco a carga.
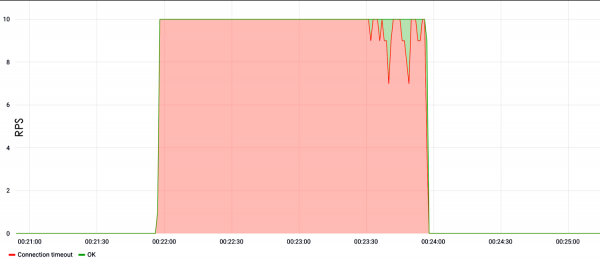
No exemplo abaixo, mostramos a carga na pesquisa. Pode-se ver que, desde o primeiro segundo do teste, com uma velocidade de dez solicitações por segundo, o site caiu e não respondeu.
E se não houver pesquisa?
Se não houver pesquisa, isso não significa que o site não contenha outros campos vulneráveis para entrada. Um desses campos pode ser a autenticação. Atualmente, os desenvolvedores gostam de criar hashes complexos para proteger o banco de logins de ataques de tabelas arco-íris. Isso é bom, mas tais hashes consomem grandes recursos de CPU. Um grande fluxo de tentativas de autenticação falsas leva à falha do processador e, como resultado, o site para de funcionar.
A presença de vários formulários para comentários e feedback no site é um motivo para enviar textos muito grandes ou simplesmente criar um fluxo massivo de dados. Às vezes, os sites aceitam arquivos anexos, incluindo no formato gzip. Nesse caso, pegamos um arquivo com tamanho de 1TB, o comprimimos com gzip para alguns bytes ou kilobytes e o enviamos para o site. Depois, ele é descompactado e resulta em um efeito muito interessante.
Rest API
Gostaria de dedicar um pouco de atenção a serviços que estão se tornando populares, como o Rest API. Proteger um Rest API é muito mais difícil do que proteger um site comum. Métodos simples de proteção contra ataques de força bruta e outras atividades ilegítimas não funcionam para Rest APIs.
Um Rest API é muito fácil de ser comprometido porque acessa diretamente o banco de dados. Além disso, a interrupção de tal serviço pode ter consequências graves para os negócios. O fato é que o Rest API geralmente conecta não apenas o site principal, mas também o aplicativo móvel e alguns recursos internos de negócios. Se tudo isso falhar, o impacto é muito maior do que se apenas um site simples saísse do ar.
Carga em conteúdo pesado
Quando nos oferecem para testar algum aplicativo simples de uma página, uma landing page ou um site de apresentação, que não possuem funcionalidades complexas, procuramos por conteúdo pesado. Por exemplo, grandes imagens que o servidor fornece, arquivos binários, documentação em PDF – tentamos baixar tudo isso. Esses testes sobrecarregam o sistema de arquivos e congestionam os canais, tornando-os eficazes. Ou seja, mesmo que você não derrube o servidor baixando um grande arquivo em velocidades baixas, simplesmente estará congestionando o canal do servidor de destino, resultando em uma indisponibilidade.
No exemplo deste teste, fica claro que à velocidade de 30 RPS, o site parou de responder ou começou a retornar erros de servidor 500.
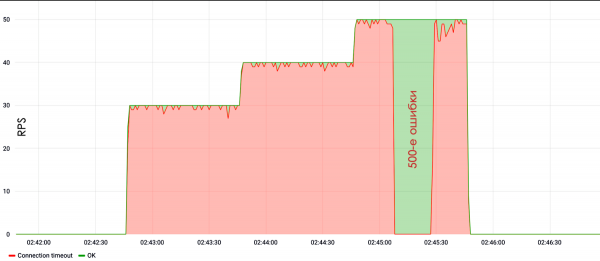
Não devemos esquecer da configuração dos servidores. Muitas vezes encontramos pessoas que compraram uma máquina virtual, instalaram o Apache, configuraram tudo como padrão, hospedaram um aplicativo PHP, e abaixo é possível ver o resultado.
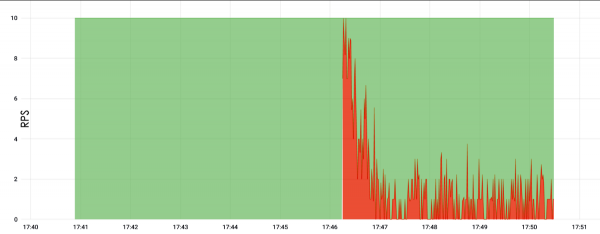
Aqui, a carga estava no diretório raiz e era de apenas 10 RPS. Esperamos 5 minutos, e o servidor caiu. De fato, não se sabe ao certo por que ele caiu, mas há uma suspeita de que ele simplesmente esgotou a memória, por isso parou de responder.
Baseado em Wave
Nos últimos um ou dois anos, os ataques de onda se tornaram bastante populares. Isso se deve ao fato de que muitas organizações compram determinados dispositivos para proteção contra DDoS, que exigem um certo tempo para acumular estatísticas antes de iniciar a filtragem do ataque. Ou seja, eles não filtram o ataque nos primeiros 30-40 segundos, pois estão acumulando dados e aprendendo. Assim, durante esses 30-40 segundos, o site pode ser bombardeado a tal ponto que os recursos ficam offline por um longo período, enquanto todas as solicitações são processadas.
No caso do ataque abaixo, houve um intervalo de 10 minutos, após o qual uma nova e modificada onda de ataque chegou.
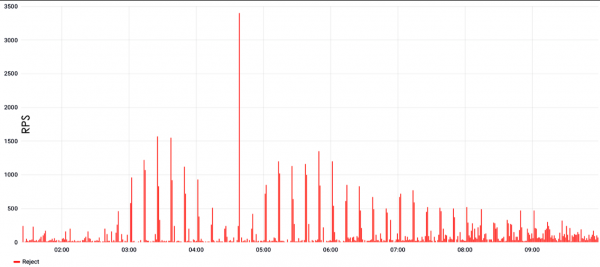
Ou seja, a proteção aprendeu, começou a filtragem, mas surgiu uma nova, completamente diferente onda de ataque, e a proteção iniciou o aprendizado novamente. Na prática, a filtragem deixa de funcionar, a proteção se torna ineficaz e o site fica inacessível.
Os ataques de onda são caracterizados por picos muito altos, podendo atingir cem mil ou um milhão de solicitações por segundo, no caso de L7. Se falarmos sobre L3&4, pode haver centenas de gigabits de tráfego, ou, respectivamente, centenas de mpps, se contarmos em pacotes.
O problema desses ataques está na sincronização. Os ataques vêm de um botnet, e para criar um grande pico em um único momento, é necessária uma alta程度 de sincronização. E essa coordenação nem sempre é alcançada: às vezes, no final, obtém-se um pico parabólico que parece bastante fraco.
Não é só HTTP
Além do HTTP no nível L7, gostamos de explorar outros protocolos. Geralmente, um site comum, especialmente um serviço de hospedagem comum, tem protocolos de e-mail e MySQL expostos. Os protocolos de e-mail são menos suscetíveis a cargas do que os bancos de dados, mas também podem ser sobrecarregados de maneira eficaz, resultando em um CPU sobrecarregado no servidor.
Conseguimos obter sucesso usando a vulnerabilidade SSH de 2016. Atualmente, essa vulnerabilidade foi corrigida pela maioria, mas isso não significa que não se possa deixar a carga em SSH. É possível. Apenas é enviada uma carga enorme de autenticações, e o SSH consome quase todo o CPU do servidor, fazendo com que o site fique lento mesmo com uma ou duas solicitações por segundo. Assim, essas uma ou duas solicitações nos logs não podem ser diferenciadas de uma carga legítima.
Muitas conexões permanecem relevantes, as quais abrimos em servidores. Antes, isso era comum no Apache, e agora o nginx também comete esse erro, uma vez que frequentemente é configurado por padrão. O número de conexões que o nginx pode manter abertas é limitado, portanto, ao atingirmos esse número, novas conexões não são aceitas, e o site deixa de funcionar.
Nosso cluster de teste possui poder de CPU suficiente para atacar o handshake SSL. De fato, como demonstra a prática, bots também costumam fazer isso. Por um lado, é evidente que não se pode prescindir do SSL, devido às classificações do Google, ranqueamento e segurança. Por outro lado, infelizmente, o SSL apresenta problemas relacionados ao uso de CPU.
L3&4
Quando falamos sobre ataques nos níveis L3&4, geralmente nos referimos a ataques no nível de canal. Essa carga é quase sempre distinguível da carga legítima, a menos que seja um ataque SYN-flood. O problema dos ataques SYN-flood para os meios de defesa reside em seu grande volume. O máximo registrado em L3&4 foi de 1,5-2 Tbit/s. Esse tráfego é extremamente difícil de processar, mesmo para grandes empresas, incluindo Oracle e Google.
SYN e SYN-ACK são pacotes utilizados durante o estabelecimento de uma conexão. Portanto, o SYN-flood é difícil de distinguir da carga legítima: não está claro se é um SYN que chegou para a instalação da conexão ou parte de um flood.
UDP-flood
Normalmente, os atacantes não possuem o mesmo poder que nós, portanto, para realizar ataques, podem usar amplificação. Ou seja, o atacante escaneia a internet e encontra servidores vulneráveis ou mal configurados que, por exemplo, em resposta a um único pacote SYN, respondem com três SYN-ACK. Fingindo o endereço de origem do servidor alvo, é possível amplificar o poder, digamos, em três vezes, e redirecionar o tráfego para a vítima.
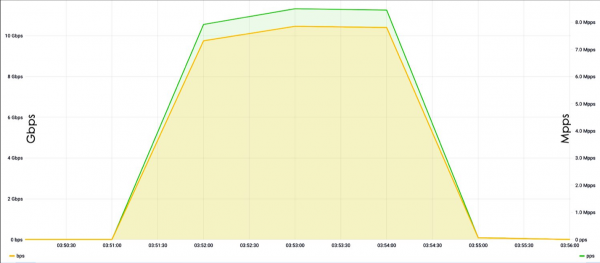
O problema das amplificações está em sua difícil detecção. Um dos exemplos mais recentes é o famoso caso do memcached vulnerável. Além disso, surgiram muitos dispositivos IoT e câmeras IP que também estão predominantemente configurados por padrão de forma inadequada, o que tem permitido que atacantes realizem ataques com mais frequência através desses dispositivos.
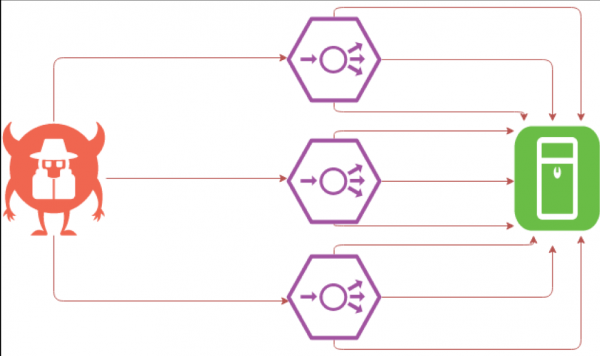
SYN-flood não é um assunto simples
SYN-flood é, sem dúvida, o tipo mais interessante de ataque do ponto de vista do desenvolvedor. O problema é que muitas vezes os administradores de sistemas utilizam bloqueio por IP como forma de proteção. Contudo, com esse bloqueio, não apenas os administradores que seguem scripts são afetados, mas também, infelizmente, alguns sistemas de proteção adquiridos por altos preços.
Esse método pode se transformar em um desastre, pois, se os criminosos substituírem endereços IP, a empresa bloqueará sua própria sub-rede. Quando o Firewall bloqueia seu próprio cluster, as interações externas começam a falhar, e o recurso fica inacessível.
E conseguir bloquear a própria rede não é difícil. Se houver uma rede Wi-Fi no escritório do cliente, ou se a funcionalidade dos recursos for medida por meio de várias monitorizações, pegamos o endereço IP desse sistema de monitoramento ou do cliente Wi-Fi do escritório e o utilizamos como origem. O recurso parece acessível, mas os endereços IP-alvo estão bloqueados. Assim, a rede Wi-Fi da conferência HighLoad, onde um novo produto da empresa é apresentado, pode ser bloqueada, resultando em custos empresariais e econômicos significativos.
Durante os testes, não podemos utilizar a amplificação através do memcached com recursos externos, pois existem acordos para direcionar o tráfego apenas para endereços IP permitidos. Portanto, utilizamos a amplificação através de SYN e SYN-ACK, onde o envio de um SYN é respondido com dois ou três SYN-ACK, resultando em um aumento do ataque em duas a três vezes.
Ferramentas
Uma das principais ferramentas que utilizamos para carga no nível L7 é o Yandex-tank. Em particular, um Phantom é usado como canhão, além de haver vários scripts para gerar projéteis e para analisar os resultados.
Para analisar o tráfego de rede, usamos o Tcpdump, e para análise do servidor, o Nmap. Para criar carga nos níveis L3&4, utilizamos o OpenSSL e um pouco da nossa própria magia com a biblioteca DPDK. A DPDK é uma biblioteca da Intel que permite trabalhar com a interface de rede, desviando da pilha do Linux, aumentando assim a eficiência. Naturalmente, usamos a DPDK não apenas no nível L3&4, mas também no nível L7, pois ela permite criar um fluxo de carga muito alto, na faixa de milhões de requisições por segundo a partir de uma única máquina.
Também utilizamos certos geradores de tráfego e ferramentas especiais que desenvolvemos para testes específicos. Se lembrarmos da vulnerabilidade no SSH, o conjunto mencionado não pode ser explorado. Se atacarmos o protocolo de e-mail, usamos utilitários de e-mail ou simplesmente escrevemos scripts para eles.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Como conclusão, gostaria de dizer:
- Além do clássico teste de carga, é essencial realizar testes de estresse. Temos um exemplo real em que um subcontratado do parceiro apenas fez testes de carga. Isso mostrou que o recurso suportava a carga padrão. Mas então surgiu uma carga não padrão, os visitantes do site começaram a usar o recurso de maneira um pouco diferente, e o subcontratado falhou. Portanto, vale a pena procurar vulnerabilidades mesmo que você já esteja protegido contra ataques DDoS.
- É necessário isolar partes do sistema umas das outras. Se você tem busca, deve colocá-la em máquinas separadas, ou seja, nem mesmo em docker. Porque se a busca ou a autenticação falharem, pelo menos algo continuará funcionando. No caso de uma loja online, os usuários continuarão encontrando produtos no catálogo, acessando através de agregadores, comprando, se já estiverem autenticados, ou se autenticando através do OAuth2.
- Não deve-se negligenciar os diversos serviços em nuvem.
- Use CDN não apenas para otimização de latência de rede, mas também como um meio de proteção contra ataques de esgotamento de banda e simplesmente contra flood na estática.
- É necessário utilizar serviços especializados de proteção. Você não conseguirá se proteger de ataques L3&4 no nível de canal, porque provavelmente você não possui largura de banda suficiente. De ataques L7 também será difícil se defender, pois eles podem ser bastante grandes. Além disso, detectar ataques menores ainda é prerrogativa de serviços especiais e algoritmos específicos.
- Atualize-se regularmente. Isso se aplica não apenas ao kernel, mas também ao daemon SSH, especialmente se eles estiverem expostos para fora. Na verdade, tudo deve ser atualizado, pois você dificilmente conseguirá monitorar certas vulnerabilidades por conta própria.
Fonte: habr.com
