

Na véspera do lançamento de um novo fluxo do curso preparamos a tradução de um material interessante.
Visão geral
Vamos discutir um padrão bastante popular, pelo qual os aplicativos utilizam vários repositórios de dados, onde cada repositório é usado para seus próprios fins, por exemplo, para armazenar a forma canônica dos dados (MySQL, etc.), garantir capacidades avançadas de busca (ElasticSearch, etc.), caching (Memcached, etc.) e outros. Normalmente, ao usar vários repositórios de dados, um deles atua como repositório principal, enquanto os outros funcionam como repositórios derivados. O único problema é como sincronizar esses repositórios de dados.
Analisamos uma série de padrões diferentes que tentaram resolver o problema de sincronização de vários repositórios, como gravação dupla, transações distribuídas, etc. No entanto, essas abordagens têm limitações significativas em termos de uso na vida real, confiabilidade e manutenção técnica. Além da sincronização de dados, alguns aplicativos também precisam enriquecer os dados, chamando serviços externos.
Foi para resolver esses problemas que o Delta foi desenvolvido. O Delta, em última análise, representa uma plataforma consistente, gerenciada por eventos, para a sincronização e enriquecimento de dados.
Soluções existentes
Gravação dupla
Para sincronizar dois repositórios de dados, pode-se usar gravação dupla, que realiza uma gravação em um repositório e, em seguida, imediatamente faz a gravação no outro. A primeira gravação pode ser repetida, e a segunda pode ser interrompida se a primeira falhar após o esgotamento do número de tentativas. No entanto, os dois repositórios de dados podem deixar de se sincronizar se a gravação no segundo repositório falhar. Este problema é geralmente solucionado criando um procedimento de recuperação que pode periodicamente transferir os dados do primeiro repositório para o segundo ou fazer isso somente quando diferenças nos dados são detectadas.
Problemas:
A execução do procedimento de recuperação é um trabalho específico que não pode ser reutilizado. Além disso, os dados entre os armazenamentos permanecem dessincronizados até que o procedimento de recuperação seja concluído. A solução torna-se mais complexa se mais de dois armazenamentos de dados forem utilizados. Por fim, o procedimento de recuperação pode adicionar carga à fonte de dados original.
Tabela de logs de alterações
Quando ocorrem alterações em um conjunto de tabelas (por exemplo, inserções, atualizações e exclusões de registros), os registros de alterações são adicionados à tabela de logs como parte da mesma transação. Outro fluxo ou processo consulta constantemente os eventos da tabela de logs e registra-os em um ou mais armazenamentos de dados, removendo eventos da tabela de logs conforme necessário após a confirmação de registro em todos os armazenamentos.
Problemas:
Esse padrão deve ser implementado como uma biblioteca e, idealmente, sem modificar o código do aplicativo que a utiliza. Em um ambiente poliglota, a implementação dessa biblioteca deve existir em qualquer linguagem necessária, mas garantir a consistência de funcionamento das funções e comportamentos entre as linguagens é bastante difícil.
Outro problema diz respeito à obtenção de alterações de esquema, em sistemas que não suportam alterações de esquema transacionais [1][2], como o MySQL. Portanto, o padrão de execução de alteração (por exemplo, alteração de esquema) e o registro transacional na tabela de logs de alterações nem sempre funcionará.
Transações Distribuídas
As transações distribuídas podem ser usadas para dividir uma transação entre vários armazenamentos de dados heterogêneos, de modo que a operação seja ou confirmada em todos os armazenamentos utilizados, ou não seja confirmada em nenhum deles.
Problemas:
Transações distribuídas são um grande problema para armazenamentos de dados heterogêneos. Por natureza, elas podem depender apenas do menor denominador comum entre os sistemas participantes. Por exemplo, transações XA bloqueiam a execução se ocorrer uma falha no aplicativo durante a fase de preparação. Além disso, XA não oferece detecção de deadlocks e não suporta esquemas otimistas de controle de paralelismo. Além disso, alguns sistemas, como o ElasticSearch, não suportam XA ou qualquer outro modelo heterogêneo de transações. Assim, garantir a atomicidade da gravação em várias tecnologias de armazenamento de dados continua sendo um desafio significativo para os aplicativos [3].
Delta
O Delta foi desenvolvido para superar as limitações das soluções existentes de sincronização de dados, além de permitir o enriquecimento dos dados em tempo real. Nosso objetivo era abstrair todas essas complexidades dos desenvolvedores de aplicativos, para que eles pudessem se concentrar totalmente na implementação das funcionalidades de negócio. A seguir, descreveremos o 'Movie Search', um caso prático de uso do Delta na Netflix.
A Netflix utiliza amplamente a arquitetura de microsserviços, onde cada microsserviço geralmente gerencia um único tipo de dado. As informações básicas sobre filmes são centralizadas em um microsserviço chamado Movie Service, enquanto dados relacionados, como informações sobre produtores, atores, fornecedores e assim por diante, são gerenciados por vários outros microsserviços (como Deal Service, Talent Service e Vendor Service).
Os usuários de negócios nos Netflix Studios frequentemente precisam pesquisar filmes com base em diversos critérios, por isso é crucial que eles possam realizar buscas em todos os dados relacionados aos filmes.
Antes da chegada do Delta, a equipe de busca de filmes precisava coletar dados de vários microsserviços antes de indexar as informações dos filmes. Além disso, a equipe precisava desenvolver um sistema que atualizasse periodicamente o índice de busca, solicitando alterações a outros microsserviços, mesmo quando não havia alterações. Esse sistema rapidamente se tornou complicado e difícil de manter.
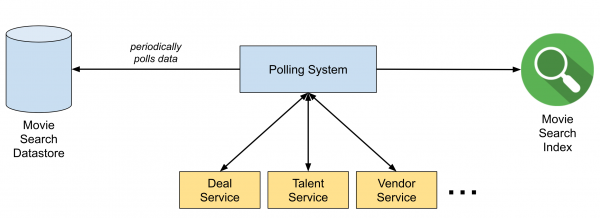
Figura 1. Sistema de polling antes do Delta
Após o início do uso do Delta, o sistema foi simplificado para um sistema gerenciado por eventos, como mostrado na figura a seguir. Os eventos de CDC (Change-Data-Capture) são enviados para os tópicos do Kafka Keystone através do Delta-Connector. O aplicativo Delta, construído com o uso do Delta Stream Processing Framework (baseado em Flink), recebe os eventos CDC do tópico, enriquece-os chamando outros microsserviços e, finalmente, transmite os dados enriquecidos para o índice de pesquisa no Elasticsearch. Todo o processo ocorre quase em tempo real, ou seja, assim que as mudanças são registradas no armazenamento de dados, os índices de pesquisa são atualizados.
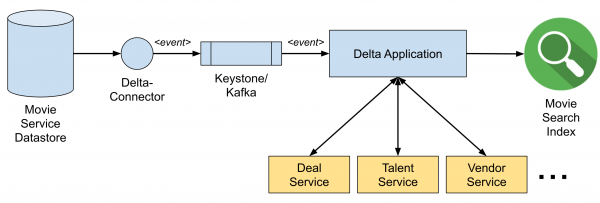
Figura 2. Pipeline de dados ao usar Delta
Nas seções seguintes, descreveremos o funcionamento do Delta-Connector, que se conecta ao armazenamento e publica eventos de CDC no nível de transporte, que é a infraestrutura de transmissão de dados em tempo real direcionando os eventos de CDC para os tópicos do Kafka. E, no final, falaremos sobre a estrutura de processamento de fluxo do Delta, que os desenvolvedores de aplicativos podem usar para a lógica de processamento e enriquecimento de dados.
CDC (Change-Data-Capture)
Desenvolvemos um serviço de CDC chamado Delta-Connector, que pode registrar alterações commitadas do armazenamento de dados em tempo real e escrevê-las em um fluxo. As alterações em tempo real são obtidas do log de transações e dos dumps do armazenamento. Os dumps são utilizados porque os logs de transações geralmente não mantêm todo o histórico de mudanças. As alterações normalmente são serializadas como eventos Delta, assim o destinatário não precisa se preocupar de onde vem a mudança.
O Delta-Connector suporta várias funcionalidades adicionais, como:
- A capacidade de escrever em saídas customizadas, sem passar pelo Kafka.
- A capacidade de ativar dumps manuais a qualquer momento para todas as tabelas, uma tabela específica ou para chaves primárias específicas.
- Os dumps podem ser coletados em partes, portanto, não há necessidade de reiniciar desde o início em caso de falha.
- Não há necessidade de bloquear tabelas, o que é muito importante para que o tráfego de gravação no banco de dados nunca seja bloqueado pelo nosso serviço.
- Alta disponibilidade devido a instâncias de reserva nas Zonas de Disponibilidade da AWS.
Atualmente, suportamos MySQL e Postgres, incluindo ao implantar no AWS RDS e Aurora. Também suportamos Cassandra (multi-master). Mais detalhes sobre o Delta-Connector podem ser encontrados neste .
Kafka e camada de transporte
A camada de transporte de eventos do Delta é construída sobre o serviço de troca de mensagens da plataforma .
Historicamente, a publicação de mensagens na Netflix foi otimizada para aumentar a disponibilidade em vez da durabilidade (veja ). O compromisso foi uma possível inconsistência dos dados do broker em vários cenários críticos. Por exemplo, eleição de líder não limpa responde pelo fato de que o receptor potencialmente duplica ou perde eventos.
Com o Delta, nossa intenção era obter garantias mais robustas de durabilidade para assegurar a entrega de eventos CDC em repositórios derivados. Para isso, propusemos um cluster Kafka projetado especificamente como um objeto de primeira classe. Você pode ver algumas configurações do broker na tabela abaixo:
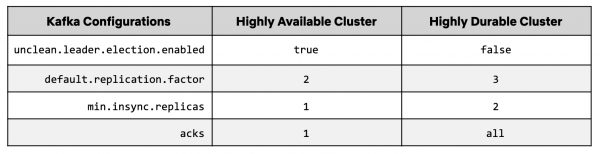
Nos clusters Keystone Kafka, eleição de líder não limpa normalmente habilitado para garantir a disponibilidade do publicador. Isso pode levar à perda de mensagens se uma réplica não sincronizada for escolhida como líder. Para um novo cluster Kafka de alta confiabilidade, a configuração eleição de líder não limpa está desativada para evitar a perda de mensagens.
Além disso, aumentamos fator de replicação de 2 para 3 e réplicas mínimas em sincronização de 1 para 2. Publicadores que escrevem neste cluster exigem acks de todas as outras, garantindo que 2 de 3 réplicas tenham as mensagens mais atualizadas enviadas pelo publicador.
Quando uma instância do broker é encerrada, uma nova instância substitui a antiga. No entanto, o novo broker precisará sincronizar as réplicas, o que pode levar várias horas. Para reduzir o tempo de recuperação deste cenário, começamos a usar o armazenamento em bloco (Amazon Elastic Block Store) em vez de discos locais dos brokers. Quando uma nova instância substitui a instância do broker que foi encerrada, ela anexa o volume EBS que pertencia à instância anterior e começa a recuperar novas mensagens. Este processo reduz o tempo de eliminação de pendências de várias horas para alguns minutos, pois a nova instância não precisa mais replicar a partir de um estado em branco. No geral, os ciclos de vida separados do armazenamento e do broker diminuem significativamente o impacto do efeito da troca de brokers.
Para aumentar ainda mais a garantia de entrega de dados, utilizamos para detectar qualquer perda de mensagens em condições extremas (por exemplo, desincronização de relógios no líder da partição).
Stream Processing Framework
O nível de processamento no Delta é construído sobre a plataforma Netflix SPaaS, que proporciona a integração do Apache Flink com o ecossistema Netflix. A plataforma oferece uma interface de usuário que gerencia a implementação de tarefas do Flink e a orquestração de clusters do Flink sobre nossa plataforma de gerenciamento de containers Titus. A interface também gerencia as configurações das tarefas e permite que os usuários façam alterações nas configurações de forma dinâmica, sem a necessidade de recompilar as tarefas do Flink.
O Delta fornece um framework de processamento de dados em fluxo baseado em Flink e SPaaS, que utiliza uma DSL (Linguagem Específica de Domínio) baseada em anotações para abstrair os detalhes técnicos. Por exemplo, para definir o passo em que os eventos serão enriquecidos, invocando serviços externos, os usuários precisam escrever a seguinte DSL, e o framework gerará uma modelagem que será executada pelo Flink. Figura 3. Exemplo de enriquecimento em DSL no Delta
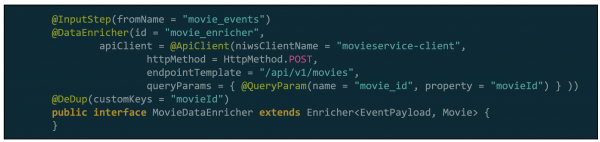
O framework de processamento não apenas reduz a curva de aprendizado, mas também fornece funcionalidades comuns de processamento de fluxo, como deduplicação, esquematização e flexibilidade e resiliência para resolver problemas comuns em operação.
Um framework de processamento não apenas reduz a curva de aprendizado, mas também fornece funcionalidades comuns de processamento de fluxo, como desduplicação, esquematização, assim como flexibilidade e resistência a falhas para resolver problemas comuns no trabalho.
O Delta Stream Processing Framework é composto por dois módulos-chave: o módulo DSL & API e o módulo Runtime. O módulo DSL & API fornece um API de DSL e UDF (User-Defined Function) para que os usuários possam escrever sua própria lógica de processamento (por exemplo, filtragem ou transformações). O módulo Runtime fornece uma implementação do parser de DSL, que constrói uma representação interna dos passos de processamento em modelos de DAG. O componente de Execução interpreta os modelos DAG para inicializar os operadores reais do Flink e, finalmente, iniciar a aplicação Flink. A arquitetura do framework está ilustrada na imagem a seguir.
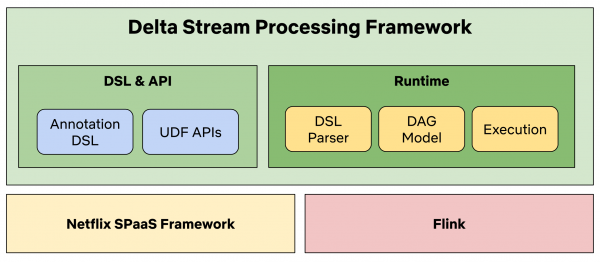
Figura 4. Arquitetura do Delta Stream Processing Framework
Esse método possui várias vantagens:
- Os usuários podem se concentrar em sua lógica de negócios sem precisar se aprofundar nas especificidades do Flink ou na estrutura do SPaaS.
- A otimização pode ocorrer de maneira transparente para os usuários, e os erros podem ser corrigidos sem a necessidade de modificar qualquer código do usuário (UDF).
- O funcionamento das aplicações Delta é simplificado para os usuários, pois a plataforma oferece flexibilidade e resiliência de forma nativa, além de coletar uma série de métricas detalhadas que podem ser usadas para alertas.
Uso em produção
O Delta está em produção há mais de um ano e desempenha um papel crucial em muitas aplicações do Netflix Studio. Ele ajudou as equipes a implementar casos de uso como indexação de pesquisa, armazenamento de dados e fluxos de trabalho gerenciados por eventos. Abaixo está uma visão geral da arquitetura de alto nível da plataforma Delta.
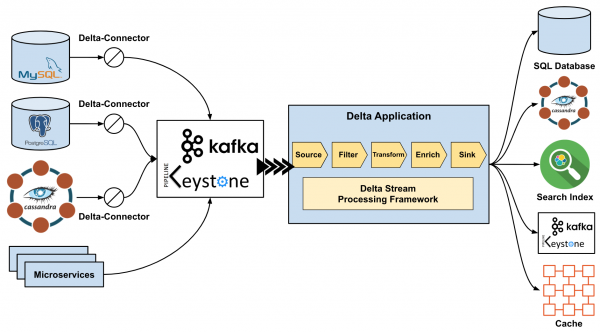
Figura 5. Arquitetura de alto nível do Delta.
Agradecimentos
Gostaríamos de agradecer às seguintes pessoas que participaram da criação e desenvolvimento do Delta no Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang e Zhenzhong Xu.
Fontes
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Processamento de eventos online. Commun. ACM 62(5): 43–49 (2019). DOI:
: "Data Build Tool para o armazenamento Amazon Redshift."
Fonte: habr.com
