

Olá a todos! Meu nome é Pavel Agaletsky. Sou líder de equipe na equipe que desenvolve o sistema de entrega da Lamoda. Em 2018, eu falei na conferência HighLoad++, e hoje quero apresentar a transcrição da minha palestra.
Meu tema se concentra na experiência da nossa empresa em implantar sistemas e serviços em diferentes ambientes. Desde nossos tempos pré-históricos, quando implantávamos todos os sistemas em servidores virtuais comuns, até a transição gradual do Nomad para a implantação no Kubernetes. Vou explicar por que fizemos isso e quais foram os problemas que encontramos no processo.

Implantação de aplicativos em VM
Começamos há 3 anos, quando todos os sistemas e serviços da empresa eram implantados em servidores virtuais comuns. A parte técnica foi organizada de forma que todo o código dos nossos sistemas era armazenado e compilado por meio de um sistema de build automático usando o Jenkins. Com o Ansible, ele era distribuído a partir do nosso sistema de controle de versões para os servidores virtuais. Cada sistema que existia na nossa empresa era implantado em pelo menos 2 servidores: um deles era o head, o outro era o tail. Esses dois sistemas eram absolutamente idênticos em todas as suas configurações, potência, configuração e assim por diante. A única diferença entre eles era que o head recebia o tráfego de usuários, enquanto o tail nunca recebia tráfego de usuários.
Por que isso foi feito?
Quando implantávamos novas versões do nosso aplicativo, queríamos garantir a possibilidade de uma implantação sem costuras, ou seja, sem consequências visíveis para os usuários. Isso era alcançado ao implementar a nova versão compilada usando o Ansible no tail. Lá, as pessoas encarregadas da implantação podiam verificar e garantir que tudo estava em ordem: todas as métricas, seções e aplicativos funcionavam; os scripts necessários eram executados. Somente depois de assegurar que estava tudo bem, o tráfego era redirecionado. Ele começava a fluir para o servidor que antes era o tail. E aquele que antes era o head permanecia sem tráfego de usuários, mantendo a versão anterior do nosso aplicativo.
Assim, para os usuários, foi tudo muito fluido. Pois a alternância é instantânea, já que é apenas uma mudança do balanceador. É muito fácil reverter para uma versão anterior, apenas alterando o balanceador de volta. Também pudemos garantir a capacidade do aplicativo em produção antes que o tráfego de usuários começasse a fluir, o que foi bastante conveniente.
Quais foram os benefícios que vimos em tudo isso?
- Acima de tudo, é bastante simples de funcionar. Está claro para todos como funciona esse tipo de esquema de deploy, pois a maioria das pessoas já fez deploy em servidores virtuais comuns.
- É bastante confiável, pois a tecnologia de deploy é simples, testada por milhares de empresas. Milhões de servidores são implantados exatamente assim. É difícil quebrar algo.
- E por fim, conseguimos realizar deploys atômicos. Deploys que ocorrem para os usuários de forma instantânea, sem uma fase perceptível de transição entre a versão antiga e a nova.
Mas em tudo isso também vimos algumas desvantagens:
- Além do ambiente de produção e do ambiente de desenvolvimento, existem outros ambientes. Por exemplo, qa e pré-produção. Naquele momento, tínhamos muitos servidores e cerca de 60 serviços. Por essa razão, era necessário manter a versão atualizada da máquina virtual para cada serviço. E se você quiser atualizar as bibliotecas ou adicionar novas dependências, deve fazê-lo em todos os ambientes. Também era necessário sincronizar o tempo em que você planejava implantar a nova versão do seu aplicativo com o tempo em que o devops faria as configurações necessárias do ambiente. Nessa situação é fácil chegar a um ponto em que o ambiente se diferencie um pouco em todos os ambientes consecutivos. Por exemplo, no ambiente QA haveria versões de bibliotecas diferentes, e na produção — outras, o que levaria a problemas.
- A complexidade na atualização das dependências do seu aplicativo. Isso não depende de você, mas de outra equipe. Ou seja, da equipe devops que mantém os servidores. Você deve definir a tarefa correspondente para eles e fornecer uma descrição do que deseja fazer.
- Naquela época, também queríamos dividir os grandes monolitos que tínhamos em pequenos serviços, pois entendíamos que a quantidade deles só aumentaria. Naquele momento, já tínhamos mais de 100. Era necessário criar uma nova máquina virtual para cada novo serviço, que também precisava ser mantida e implantada. Além disso, não era uma única máquina, mas pelo menos duas. A isso se somava ainda o ambiente de QA. Isso causa problemas e torna a criação e o lançamento de novos sistemas mais complicados, caros e demorados.
Por isso, decidimos que seria mais conveniente passar do deployment de máquinas virtuais comuns para o deployment de nossas aplicações em contêineres Docker. Com o Docker, é necessário um sistema que possa iniciar a aplicação no cluster, pois você não consegue simplesmente levantar um contêiner. Normalmente, é desejável monitorar quantos contêineres estão em execução, para que eles sejam iniciados automaticamente. Por essa razão, precisávamos escolher um sistema de gerenciamento.
Refletimos bastante sobre qual deles escolher. O fato é que, naquela época, nossa pilha de deployment em servidores virtuais comuns estava um pouco desatualizada, pois as versões dos sistemas operacionais eram antigas. Em algum momento, havia até o FreeBSD, que não era muito conveniente de manter. Entendíamos que precisávamos migrar para o Docker o mais rápido possível. Nossos DevOps analisaram sua experiência prévia com diferentes soluções e escolheram um sistema chamado Nomad.
Transição para o Nomad
O Nomad é um produto da empresa HashiCorp. Eles também são conhecidos por outras soluções:
«Consul» — é uma ferramenta para descoberta de serviços.
«Terraform» — é um sistema para gerenciamento de servidores, permitindo que você os configure através de uma configuração conhecida como infrastructure-as-a-code.
«Vagrant» permite que você implante máquinas virtuais localmente ou na nuvem usando arquivos de configuração específicos.
Naquele momento, o Nomad parecia uma solução simples, que poderia ser adotada rapidamente sem alterar toda a infraestrutura. Além disso, é fácil de aprender. Por isso, escolhemos exatamente ele como nosso sistema de orquestração de contêineres.
O que você precisa para implantar seu sistema no Nomad?
- Antes de mais nada, você precisa de um imagem docker do seu aplicativo. É necessário empacotá-lo e colocá-lo em um repositório de imagens docker. No nosso caso, esse repositório é o artifactory — um sistema que permite fazer push de diversos artefatos de diferentes tipos. Ele pode armazenar arquivos, imagens docker, pacotes Composer PHP, pacotes NPM e muito mais.
- Também é necessário um arquivo de configuração, que informará ao Nomad o que, onde e em que quantidade você deseja implantar.
Quando falamos sobre o Nomad, o formato do arquivo utilizado é a linguagem HCL, que é a abreviação de HashiCorp Configuration Language. Essa linguagem é uma superconjunto do Yaml, que permite descrever seu serviço em termos de Nomad.
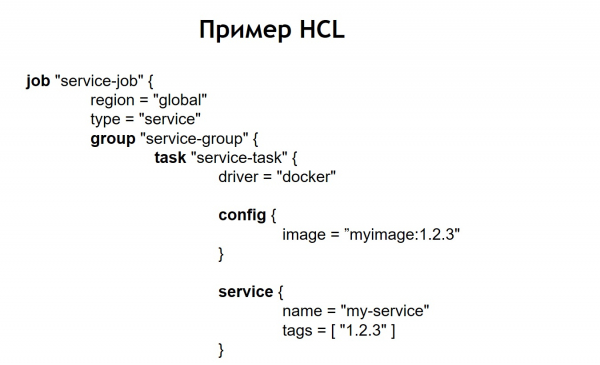
Ela permite especificar quantos contêineres você deseja implantar, de quais imagens e passar a eles vários parâmetros durante a implantação. Assim, você alimenta esse arquivo ao Nomad, que inicia os contêineres em produção de acordo com ele.
No nosso caso, percebemos que simplesmente criar arquivos HCL idênticos para cada serviço não seria muito prático, pois existem muitos serviços e às vezes é necessário atualizá-los. Às vezes, um serviço não está implantado em uma única instância, mas em várias. Por exemplo, um dos sistemas que temos em produção possui mais de 100 instâncias em produção. Eles são iniciados a partir das mesmas imagens, mas diferem nas configurações e arquivos de configuração.
Portanto, decidimos que seria conveniente armazenar todos os nossos arquivos de configuração para implantação em um único repositório central. Assim, eles se tornam visualizáveis: é fácil mantê-los e é possível ver quais sistemas temos. Em caso de necessidade, também não é difícil atualizar ou modificar algo. Adicionar um novo sistema também não será difícil — basta criar um arquivo de configuração em um novo diretório. Dentro dele estão os arquivos: service.hcl, que contém a descrição do nosso serviço, e alguns arquivos env, que permitem configurar esse serviço ao ser implantado em produção.
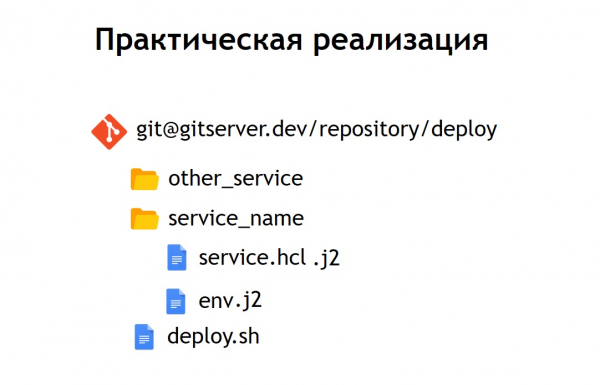
No entanto, alguns dos nossos sistemas estão implantados em produção não em uma única instância, mas em várias ao mesmo tempo. Portanto, decidimos que seria conveniente armazenar não as configurações em sua forma bruta, mas sim sua versão templatinizada. Como linguagem de template, escolhemos jinja 2. Neste formato, armazenamos tanto as configurações do próprio serviço quanto os arquivos env necessários para ele.
Além disso, colocamos no repositório um script de implantação comum a todos os projetos, que permite iniciar e implantar seu serviço em produção, no ambiente necessário, no alvo desejado. Quando transformamos nossa configuração HCL em um template, o arquivo HCL, que antes era uma configuração comum do Nomad, passa a ter uma aparência um pouco diferente.
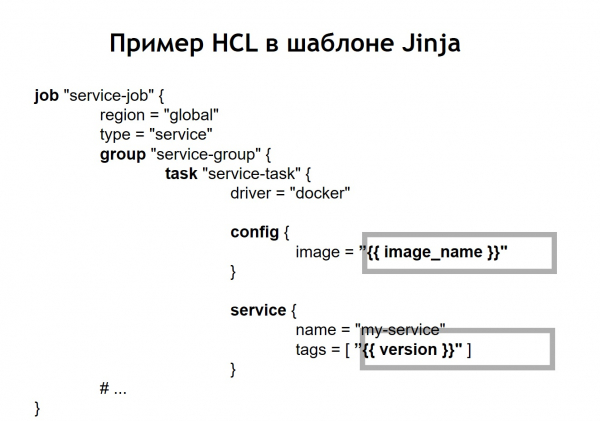
Ou seja, substituímos algumas variáveis na configuração por inserções de variáveis que são extraídas dos arquivos env ou de outras fontes. Além disso, conseguimos gerar arquivos HCL dinamicamente, o que significa que podemos aplicar não apenas inserções comuns de variáveis. Como o jinja suporta loops e condições, também podemos criar arquivos de configuração que mudam dependendo de onde você implanta seus aplicativos.
Por exemplo, você deseja implantar seu serviço em pré-produção e em produção. Digamos que, na pré-produção, você não queira executar scripts cron, mas apenas ver o serviço em um domínio separado para garantir que ele funcione. Para qualquer pessoa que implanta o serviço, o processo parece muito simples e transparente. Basta executar o arquivo deploy.sh, indicando qual serviço você deseja implantar e em qual alvo. Por exemplo, você deseja implantar um sistema na Rússia, na Bielorrússia ou no Cazaquistão. Para isso, é suficiente trocar um dos parâmetros, e o arquivo de configuração correto será gerado.
Quando o serviço Nomad já está implantado em seu cluster, ele se parece com isto.
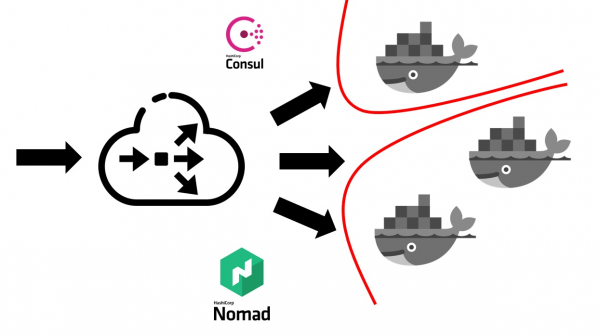
Para começar, você precisa de um balanceador externo que receba todo o tráfego dos usuários. Ele funcionará juntamente com o Consul e descobrirá onde, em qual nó, reside o endereço IP serviço específico que corresponde ao determinado nome de domínio. Os serviços no Consul aparecem a partir do próprio Nomad. Como são produtos da mesma empresa, eles estão bem integrados entre si. Pode-se dizer que o Nomad é capaz de registrar todos os serviços executados nele dentro do Consul, por padrão.
Após o balanceador externo de carga saber para qual serviço redirecionar o tráfego, ele o encaminha para o contêiner correspondente ou para vários contêineres que pertencem à sua aplicação. É certo que a segurança também deve ser considerada. Mesmo que todos os serviços sejam executados nas mesmas máquinas virtuais dentro de contêineres, geralmente é necessário proibir o acesso livre de qualquer serviço a qualquer outro. Nós alcançamos isso por meio da segmentação. Cada serviço era executado em sua própria rede virtual, onde foram definidas regras de roteamento e regras de permissão/proibição de acesso a outros sistemas e serviços. Eles podiam estar tanto dentro desse cluster quanto fora dele. Por exemplo, se você deseja proibir um serviço de se conectar a um determinado banco de dados, isso pode ser feito através da segmentação em nível de rede. Ou seja, mesmo que seja por erro, você não pode acidentalmente se conectar do ambiente de teste ao seu banco de dados de produção.
Quanto nos custou o processo de transição em termos de recursos humanos?
Levaram cerca de 5 a 6 meses para a transição de toda a empresa para o Nomad. Fizemos a transição serviço por serviço, mas em um ritmo bastante rápido. Cada equipe teve que criar seus próprios contêineres para os serviços.
Adotamos a abordagem de que cada equipe é responsável por suas próprias imagens Docker. Os DevOps fornecem a infraestrutura geral necessária para a implantação, ou seja, o suporte do próprio cluster, suporte do sistema CI e assim por diante. Naquele momento, mais de 60 sistemas haviam se mudado para o Nomad, totalizando cerca de 2 mil contêineres.
Os DevOps são responsáveis pela infraestrutura geral relacionada à implantação, aos servidores. Por outro lado, cada equipe de desenvolvimento é responsável pela implementação de contêineres para seu sistema específico, pois é a equipe que sabe exatamente o que precisa em cada contêiner.
Razões para desistir do Nomad
Quais benefícios obtivemos ao migrar para a implantação utilizando o Nomad e o Docker, entre outros?
- Nós garantimos condições iguais para todos os ambientes. Em desenvolvimento, ambiente de QA, pré-produção e produção, utilizam-se as mesmas imagens de container, com as mesmas dependências. Portanto, você praticamente não tem chance de que na produção apareça algo diferente do que foi testado localmente ou em um ambiente de teste.
- Também descobrimos que é suficiente adicionar facilmente um novo serviço. Qualquer novo sistema, em termos de deploy, é muito fácil de iniciar. Basta ir até o repositório que armazena as configurações, adicionar mais uma configuração para o seu sistema, e tudo estará pronto. Você pode fazer o deploy do seu sistema em produção sem esforços adicionais da parte do DevOps.
- Todos arquivos de configuração em um único repositório comum se mostraram observáveis. No momento em que fizemos o deploy dos nossos sistemas usando servidores virtuais, utilizamos o Ansible, onde as configurações estavam no mesmo repositório. No entanto, para a maioria dos desenvolvedores, isso era um pouco mais complicado. Aqui, o volume de configurações e código que você precisa adicionar para fazer o deploy do serviço foi significativamente reduzido. Além disso, para DevOps, é muito fácil corrigir ou alterar isso. No caso de transições, por exemplo, para uma nova versão do Nomad, eles podem pegar e atualizar massivamente todos os arquivos operacionais que estão no mesmo lugar.
Mas também enfrentamos algumas desvantagens:
Descobrimos que não conseguimos alcançar a continuidade nos deploys no caso do Nomad. Durante a implantação de containers de diferentes condições, poderia ocorrer que este estivesse em execução, e o Nomad o reconhecesse como pronto para receber tráfego. Isso acontecia antes mesmo do aplicativo dentro dele conseguir iniciar. Por causa disso, o sistema, por um curto período, começou a retornar erros 500, pois o tráfego começava a ir para um container que ainda não estava pronto para aceitá-lo.
Encontramos alguns bugs. O maior problema é que o Nomad não lida muito bem com um grande cluster quando você tem muitos sistemas e contêineres. Quando você deseja colocar em manutenção um dos servidores que faz parte do cluster Nomad, há uma grande probabilidade de que o cluster não se sinta bem e se desfaça. Alguns contêineres podem, por exemplo, cair e não se levantar — isso pode custar muito caro para você, se todos os seus sistemas em produção estiverem no cluster gerenciado pelo Nomad.
Portanto, decidimos refletir sobre o nosso próximo passo. Naquela época, começamos a entender muito melhor o que queríamos alcançar. Em resumo: buscamos confiabilidade, um pouco mais de funcionalidades do que o Nomad oferece e um sistema mais maduro e estável.
Nesse sentido, nossa escolha recaiu sobre o Kubernetes como a plataforma mais popular para executar clusters. Especialmente considerando que o tamanho e a quantidade de nossos contêineres eram bastante grandes. Para esses fins, o Kubernetes parecia ser o sistema mais adequado dentre os que avaliamos.
Transição para o Kubernetes
Vou explicar um pouco sobre os principais conceitos do Kubernetes e como eles diferem do Nomad.
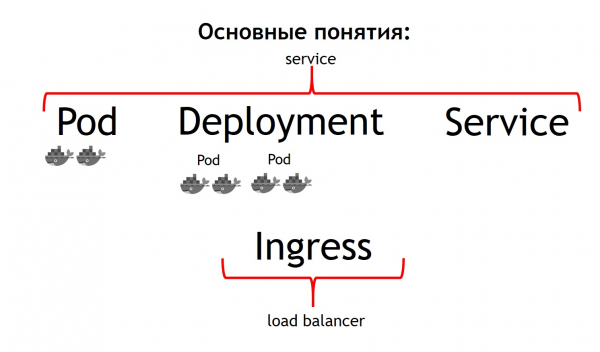
Em primeiro lugar, o conceito mais básico no Kubernetes é o pod. Pod — é um grupo de um ou mais contêineres que sempre são executados juntos. E eles funcionam como se estivessem sempre na mesma máquina virtual. Eles têm acesso entre si pelo endereço IP 127.0.0.1 em portas diferentes.
Suponha que você tenha uma aplicação PHP que consiste em nginx e php-fpm – um esquema clássico. É provável que você queira que os contêineres de nginx e php-fpm estejam sempre juntos. O Kubernetes permite que você consiga isso, descrevendo-os como um único pod. Isso é exatamente o que não conseguimos obter com o Nomad.
O segundo conceito é deployment. O fato é que um pod por si só é algo efêmero, ele inicia e desaparece. Você quer primeiro matar todos os seus contêineres anteriores e, em seguida, iniciar novas versões de uma só vez, ou prefere implantá-las gradualmente – é exatamente esse processo que o conceito de deployment gerencia. Ele descreve como você implanta seus pods, em que quantidade e como atualizá-los.
O terceiro conceito é serviço. Seu service é basicamente seu sistema, que aceita um certo tráfego e depois o direciona para um ou mais pods correspondentes ao seu serviço. Isso significa que você pode dizer que todo o tráfego de entrada para um serviço com um determinado nome deve ser enviado especificamente para esses pods. E assim, ele oferece balanceamento de tráfego. Você pode executar dois pods da sua aplicação, e todo o tráfego de entrada será equilibrado uniformemente entre os pods relacionados a esse serviço.
E o quarto conceito básico é Ingress. Este é um serviço que é executado em um cluster Kubernetes. Ele atua como um balanceador de carga externo, que aceita todas as solicitações. Através da API do Kubernetes, o Ingress pode determinar para onde essas solicitações devem ser enviadas. E faz isso de forma muito flexível. Você pode dizer que todas as solicitações para este host e este URL devem ser enviadas para este serviço. E aquelas solicitações que chegam a este host e a outro URL devem ser enviadas para outro serviço.
O mais incrível sob a perspectiva de quem desenvolve a aplicação é que você pode gerenciar tudo isso por conta própria. Definindo a configuração do Ingress, você pode direcionar todo o tráfego que chega a uma determinada API para contêineres separados, programados, por exemplo, em Go. E aquele tráfego que chega ao mesmo domínio, mas a outro URL, pode ser enviado para contêineres escritos em PHP, onde há muita lógica, mas são menos rápidas.
Se compararmos todos esses conceitos com o Nomad, podemos dizer que os primeiros três conceitos formam juntos um Service. E o último conceito não existe no Nomad. Como substituto, usamos um balanceador de carga externo: isso pode ser haproxy, nginx, nginx+ e assim por diante. No caso do Kubernetes, você não precisa introduzir esse conceito adicional separadamente. No entanto, se olharmos para o Ingress internamente, ele pode ser nginx, haproxy ou traefik, mas de alguma forma integrado ao Kubernetes.
Todos os conceitos que descrevi são, na verdade, recursos que existem dentro do cluster Kubernetes. Para descrevê-los no Kubernetes, utiliza-se o formato yaml, que é mais legível e familiar do que arquivos HCL no caso do Nomad. Mas estruturalmente, eles descrevem, por exemplo, o mesmo que um pod. Eles dizem – quero implantar esses pods aqui, com essas imagens, em tal quantidade.
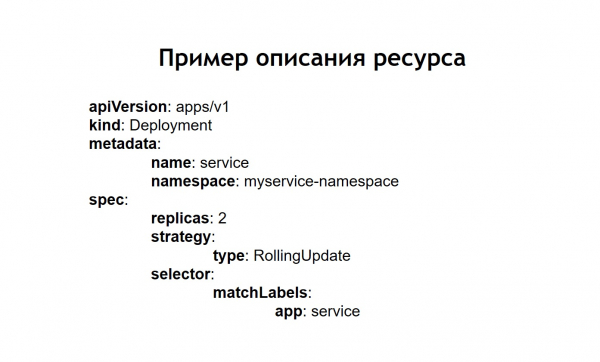
Além disso, entendemos que não queríamos criar manualmente cada recurso separadamente: deployment, serviços, Ingress e outros. Em vez disso, queríamos descrever cada sistema em termos do Kubernetes durante o deployment, para evitar ter que recriar manualmente todas as dependências necessárias na ordem correta. Para isso, escolhemos o Helm como a ferramenta que nos permitiria fazer isso.
Conceitos principais do Helm
O Helm é um gerenciador de pacotes gerenciador de pacotes para Kubernetes. Ele é muito semelhante ao funcionamento dos gerenciadores de pacotes em linguagens de programação. Eles permitem armazenar um serviço que consiste, por exemplo, em um deployment do nginx, um deployment do php-fpm, uma configuração para Ingress, configmaps (que são entidades que permitem definir variáveis de ambiente e outros parâmetros para o seu sistema) sob a forma dos chamados charts. Com isso, o Helm funciona sobre o Kubernetes.Ou seja, não se trata de um sistema à parte, mas sim de mais um serviço executado dentro do cluster. Você interage com ele por meio de sua API via comandos de console. Sua conveniência e valor estão no fato de que, mesmo que o Helm apresente falhas ou seja removido do cluster, seus serviços não desaparecerão, pois o Helm serve basicamente para iniciar o sistema. A funcionalidade e o estado dos serviços é responsabilidade do próprio Kubernetes.
Também percebemos que a templating, que antes tínhamos que implementar manualmente através da integração do jinja em nossas configurações, é uma das principais capacidades do Helm. Todas as configurações que você cria para seus sistemas são armazenadas no Helm na forma de templates, semelhantes ao jinja, mas que na verdade utilizam a templating da linguagem Go, na qual o Helm foi escrito, assim como o Kubernetes.
O Helm nos adiciona mais alguns conceitos.
Chart é a descrição do seu serviço. Em outros gerenciadores de pacotes, seria chamado de pacote, bundle ou algo similar. Aqui, ele é chamado de chart.
Values são as variáveis que você deseja usar para compor suas configurações a partir dos templates.
Release. Sempre que um serviço é implantado usando helm, ele recebe uma versão incremental do release. O Helm se lembra de como era a configuração do serviço no release anterior, no penúltimo, e assim por diante. Por isso, se for necessário reverter, basta executar o comando helm callback, especificando a versão anterior do release. Mesmo que, no momento da reversão, a configuração correspondente não esteja disponível em seu repositório, o helm ainda se lembrará de como ela era e reverterá seu sistema para o estado em que estava no release anterior.
No caso de usarmos helm, as configurações comuns do Kubernetes também se transformam em templates, onde é possível usar variáveis, funções e operadores condicionais. Assim, você pode compor a configuração do seu serviço dependendo do ambiente.
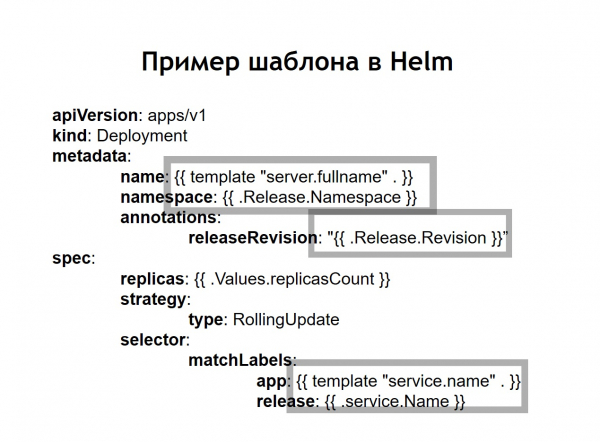
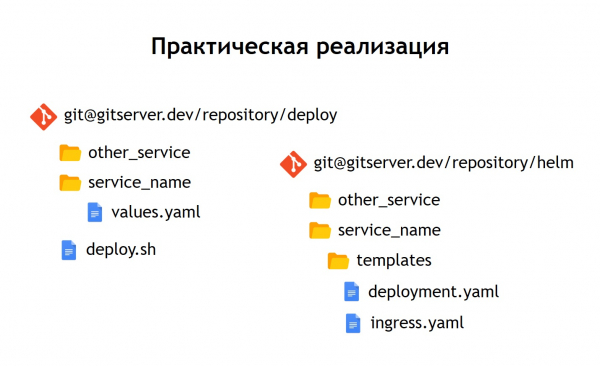
Na prática, decidimos proceder de maneira um pouco diferente do que fizemos com o Nomad. Se no Nomad, um único repositório armazenava tanto as configurações de implantação quanto as variáveis n necessárias para implantar nosso serviço, aqui decidimos dividi-las em dois repositórios separados. No repositório "deploy" são armazenadas apenas as variáveis n necessárias para a implantação, enquanto no repositório "helm" são guardadas as configurações ou charts.
O que isso nos proporcionou?
Embora não armazenemos dados realmente sensíveis nos próprios arquivos de configuração, como senhas de bancos de dados, que são mantidas como secrets no Kubernetes, ainda existem aspectos que não queremos permitir o acesso a todos. Portanto, o acesso ao repositório "deploy" é mais restrito, enquanto o repositório "helm" contém apenas a descrição do serviço. Por essa razão, ele pode ser acessado de forma segura por um grupo maior de pessoas.
Como temos não apenas produção, mas também outros ambientes, graças a essa separação podemos reutilizar nossos charts do helm para implantar serviços não apenas na produção, mas também, por exemplo, no ambiente de QA. Mesmo para que possam ser implantados localmente usando Minikube — isso é uma ferramenta para execução local do Kubernetes.
Dentro de cada repositório, deixamos a divisão em diretórios separados para cada serviço. Ou seja, dentro de cada diretório, encontram-se os templates relacionados ao respectivo chart, descrevendo os recursos que precisam ser implantados para iniciar nosso sistema. No repositório 'deploy', deixamos apenas o env. Nesse caso, não usamos a templatação com jinja, pois o helm já oferece templatação out of the box - essa é uma de suas principais funções.
Deixamos um script para a implantação - deploy.sh, que simplifica e padroniza o início da implantação usando helm. Assim, para qualquer um que deseje implantar, a interface de implantação é exatamente como era no caso da implantação através do Nomad. O mesmo deploy.sh, o nome do seu serviço e o local onde você deseja implantá-lo. Isso resulta na execução do helm. Ele, por sua vez, coleta as configurações dos templates, insere os arquivos values necessários e, em seguida, implanta, enviando-os para o Kubernetes.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
O serviço Kubernetes parece mais complexo do que o Nomad.
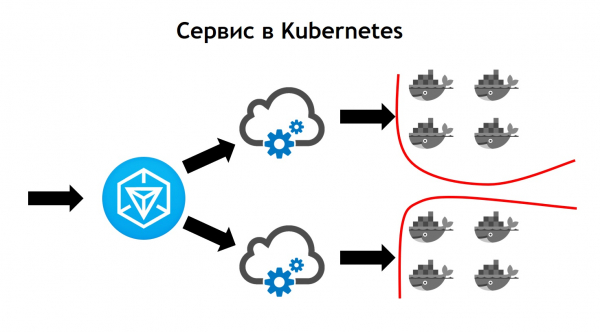
Aqui, o tráfego de saída chega ao Ingress. Este é o controlador de front que recebe todas as solicitações e posteriormente as direciona aos serviços correspondentes a essas solicitações. Ele os define com base nas configurações que fazem parte da descrição do seu aplicativo no helm e que os desenvolvedores definem por conta própria. O serviço, por sua vez, envia as solicitações para seus pods, ou seja, contêineres específicos, equilibrando o tráfego de entrada entre todos os contêineres que pertencem a esse serviço. E, claro, não devemos esquecer que não podemos nos afastar da segurança em nível de rede. Portanto, no cluster Kubernetes, há uma segmentação baseada em tagging. Todos os serviços têm tags específicas, às quais estão associados os direitos de acesso dos serviços a determinados recursos externos/internos dentro ou fora do cluster.
Ao realizar a migração, vimos que o Kubernetes possui todas as funcionalidades do Nomad, que usávamos anteriormente, e ainda adiciona muitas novas. Ele pode ser expandido por meio de plugins, na verdade, através de tipos personalizados de recursos. Ou seja, você tem a possibilidade não apenas de usar o que vem no Kubernetes por padrão, mas de criar seu próprio recurso e serviço que vai ler esse recurso. Isso oferece oportunidades adicionais para expandir seu sistema sem a necessidade de reinstalar o Kubernetes e sem a necessidade de fazer alterações.
Um exemplo desse uso é o Prometheus, que roda dentro do nosso cluster Kubernetes. Para que ele comece a coletar métricas de um determinado serviço, precisamos adicionar à descrição do serviço um tipo de recurso adicional, chamado de monitor de serviço. O Prometheus, por saber ler e ser executado no Kubernetes, automaticamente começa a coletar métricas do novo sistema. Isso é bastante conveniente.
O primeiro deploy que fizemos no Kubernetes foi em março de 2018. E durante esse tempo nunca tivemos problemas com ele. Funciona de maneira bastante estável, sem bugs significativos. Além disso, podemos expandi-lo ainda mais. Hoje em dia, as capacidades que ele possui nos atendem bem, e a velocidade de desenvolvimento do Kubernetes nos agrada muito. Atualmente, mais de 3000 contêineres estão em Kubernetes. O cluster ocupa vários Nós. Ele é gerenciável, estável e muito controlado.
Fonte: habr.com
