

Olá a todos! Meu nome é Oleg Sidorenkov, sou o líder da equipe de infraestrutura na empresa DomClick. Já utilizamos o "Cubo" na produção por mais de três anos, e ao longo desse tempo vivenciamos muitos momentos interessantes com ele. Hoje, vou contar como, com a abordagem correta, você pode extrair ainda mais desempenho do Kubernetes "vanilla" para o seu cluster. Pronto, vai!
Todos vocês sabem que Kubernetes é um sistema escalável de código aberto para orquestração de containers; ou melhor, 5 binários que fazem mágica ao gerenciar o ciclo de vida dos seus microsserviços no ambiente de servidor. Além disso, é uma ferramenta bastante flexível, que pode ser montada como um brinquedo de Lego, para máxima personalização para diferentes tarefas.
E parece que está tudo bem: jogue servidores no cluster como lenha na lareira e não se preocupe. Mas se você se preocupa com o meio ambiente, vai pensar: "Como posso manter o fogo na lareira e ainda preservar a floresta?" Em outras palavras, como encontrar maneiras de melhorar a infraestrutura e reduzir custos.
1. Monitore os recursos das equipes e aplicações
Um dos métodos mais simples, mas eficazes, é a implementação de requests/limits. Separe as aplicações por namespaces e os namespaces pelas equipes de desenvolvimento. Defina os valores de consumo de tempo de CPU, memória e armazenamento efêmero para cada aplicação antes do deployment.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Por experiência, chegamos à conclusão de que não devemos inflacionar os requests em relação aos limits em mais de duas vezes. O volume do cluster é calculado com base nos requests, e se você definir para as aplicações uma diferença de recursos, por exemplo, de 5 a 10 vezes, imagine o que acontecerá com o seu nó quando ele estiver cheio de pods e de repente receber uma carga. Nada bom. No mínimo, throttling, e no máximo, você dirá adeus ao worker e enfrentará uma carga cíclica nos outros nós após os pods começarem a migrar.
Além disso, com o limitranges você pode definir valores de recursos para o container no início — mínimos, máximos e padrão:
➜  ~ kubectl describe limitranges --namespace ops
Nome:       limit-range
Namespace:  ops
Tipo        Recurso           Mín   Máx   Solicitação Padrão  Limite Padrão  Razão Máx Limite/Solicitação
----        --------           ---   ---   -------------------  -------------  -----------------------
Container   cpu                50m   10    100m                 100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi              4Gi            -
Container   memory             64Mi  40Gi  128Mi              128Mi          2
Não se esqueça de limitar os recursos do namespace para que um único time não consuma todos os recursos do cluster:
➜  ~ kubectl describe resourcequotas --namespace ops
Nome:                   resource-quota
Namespace:              ops
Recurso                Usado          Limitado
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Como pode ser visto na descrição resourcequotas, se o time ops tentar implantar pods que consumirão 10 cpu a mais, o agendador não permitirá e retornará um erro:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Para resolver um problema como esse, você pode escrever uma ferramenta, como , que é capaz de armazenar e commitar o estado dos recursos dos times.
2. Escolha um armazenamento de arquivos ideal
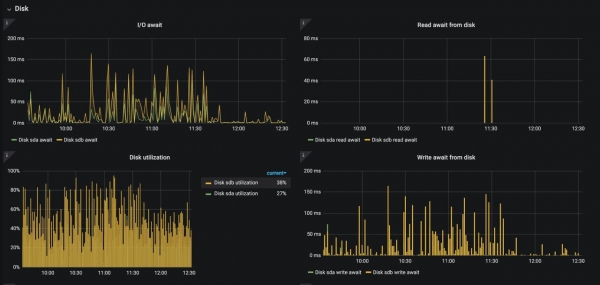
Aqui gostaria de abordar o tema de volumes persistentes e subsistemas de disco nos nós worker do Kubernetes. Espero que ninguém esteja usando "Kub" em HDD em produção, mas às vezes mesmo um SSD comum já não é suficiente. Enfrentamos um problema em que os logs estavam sobrecarregando o disco com operações de entrada e saída, e aqui as opções de solução são limitadas:
Usar SSDs de alto desempenho ou migrar para NVMe (se você gerencia seu próprio hardware).
Reduzir o nível de log.
Fazer um balanceamento "inteligente" dos pods que estão sobrecarregando o disco (
podAntiAffinity).
A captura acima mostra o que acontece com o nginx-ingress-controller no disco, quando o log de access_logs está ativo (~12 mil logs/segundo). Essa situação, certamente, pode levar à degradação de todos os aplicativos nesse nó.
Quanto aos PVs, infelizmente, não experimentei todos Volumes Persistentes. Utilize a melhor opção que se adapte a você. Historicamente, uma pequena parte dos serviços precisa de volumes RWX, e há muito tempo começamos a usar armazenamento NFS para essa finalidade. É barato e... suficiente. Claro, já nos cansamos de coisas ruins — e muito, mas aprendemos a ajustá-lo, e agora não temos mais dor de cabeça. E se possível, migre para o armazenamento de objetos S3.
3. Colete imagens otimizadas
O ideal é usar imagens otimizadas para contêineres, para que o Kubernetes possa acessá-las mais rapidamente e executá-las de forma mais eficiente.
A otimização significa que as imagens:
contêm apenas um aplicativo ou executam apenas uma função;
são de tamanho reduzido, pois imagens grandes têm pior desempenho na transmissão pela rede;
têm endpoints para verificar a saúde e a prontidão, permitindo que o Kubernetes tome medidas em caso de falhas;
utilizam sistemas operacionais que são amigáveis a contêineres (como Alpine ou CoreOS), que são mais resistentes a erros de configuração;
aplicam montagens em várias etapas, permitindo que você faça implementações apenas com aplicativos compilados, e não com o código fonte associado.
Existem muitas ferramentas e serviços que permitem verificar e otimizar imagens dinamicamente. É crucial mantê-las sempre atualizadas e verificadas quanto à segurança. Como resultado, você obterá:
Redução da carga de rede em todo o cluster.
Diminuição do tempo de inicialização do contêiner.
Menor volume em todo o seu registro Docker.
4. Utilize o cache DNS
Quando se trata de altas cargas, viver sem a otimização do sistema DNS do cluster é bastante complicado. Há muito tempo, os desenvolvedores do Kubernetes mantinham sua solução kube-dns. Ela foi implementada por nós, mas esse software não foi muito ajustado e não entregou a performance desejada, embora a tarefa parecesse simples. Depois surgiu o coredns, que adotamos e que funcionou bem, posteriormente tornando-se o serviço DNS padrão no K8s. Em um determinado momento, chegamos a 40 mil rps para o sistema DNS, e essa solução também se tornou insuficiente. Mas, por sorte, surgiu o Nodelocaldns, também conhecido como cache local de nó, que é .
Por que usamos isso? Existe um bug no núcleo do Linux que, quando múltiplas chamadas são feitas através do conntrack NAT por UDP, leva a uma condição de corrida ao gravar nas tabelas conntrack, fazendo com que parte do tráfego através do NAT seja perdido (cada acesso ao Serviço é NAT). O nodelocaldns resolve esse problema eliminando o NAT e atualizando a conexão para TCP com os DNS upstream, além de fazer cache local das consultas DNS para os upstreams (incluindo um pequeno cache negativo de 5 segundos).
5. Escale os pods horizontal e verticalmente de forma automática
Você pode afirmar com confiança que todos os seus microsserviços estão prontos para um aumento de carga de duas a três vezes? Como alocar recursos corretamente para suas aplicações? Manter alguns pods em execução além da carga de trabalho pode ser excessivo, e manter na carga máxima pode resultar em inatividade devido a um aumento repentino do tráfego no serviço. Serviços como os de escalonamento automático ajudam a encontrar o meio termo, como e .
VPA permite aumentar automaticamente os requests/limits dos seus contêineres no pod com base no uso real. Como isso pode ser útil? Se você tiver pods que não podem ser escalonados horizontalmente por algum motivo (o que não é muito confiável), pode tentar confiar ao VPA a alteração de seus recursos. Sua característica está no sistema de recomendações baseado em dados históricos e atuais do metric-server, portanto, se você não quiser alterar automaticamente os requests/limits, pode apenas monitorar os recursos recomendados para seus contêineres e otimizar as configurações para economizar CPU e memória no cluster.
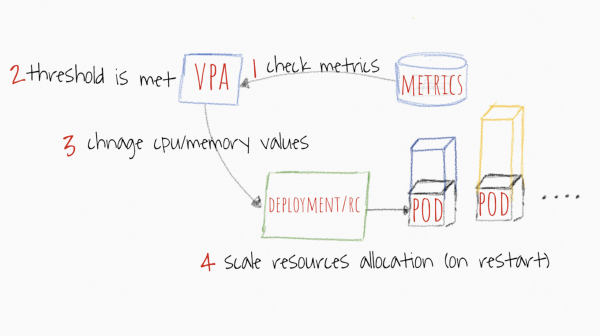 A imagem foi retirada de https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
O agendador no Kubernetes sempre se baseia nos requests. Qualquer que seja o valor que você definir, o agendador procurará um nó apropriado com base nisso. Os valores limits são necessários para o kubelet entender quando restringir ou matar o pod. E como o único parâmetro importante é o valor dos requests, o VPA irá trabalhar com isso. Sempre que você define o escalonamento vertical da aplicação, você determina quais devem ser os requests. E o que acontecerá com os limits? Esse parâmetro também será escalonado proporcionalmente.
Por exemplo, aqui estão as configurações comuns de um pod:
recursos:
   solicitações:
     memória: 250Mi
     cpu: 200m
   limites:
     memória: 500Mi
     cpu: 350m
O mecanismo de recomendação determina que sua aplicação requer 300m de CPU e 500Mi para funcionar normalmente. Você receberá essas configurações:
recursos:
   solicitações:
     memória: 500Mi
     cpu: 300m
   limites:
     memória: 1000Mi
     cpu: 525m
Como mencionado acima, esse é um dimensionamento proporcional baseado na relação requests/limits no manifesto:
CPU: 200m → 300m: relação 1:1.75;
Memória: 250Mi → 500Mi: relação 1:2.
Quanto às HPA, aqui o mecanismo de funcionamento é mais claro. Valores limites de métricas, como CPU e memória, são definidos, e se a média de todas as réplicas ultrapassar o limite, a aplicação é dimensionada para +1 pod até que o valor caia abaixo do limite ou até que o número máximo de réplicas seja alcançado.
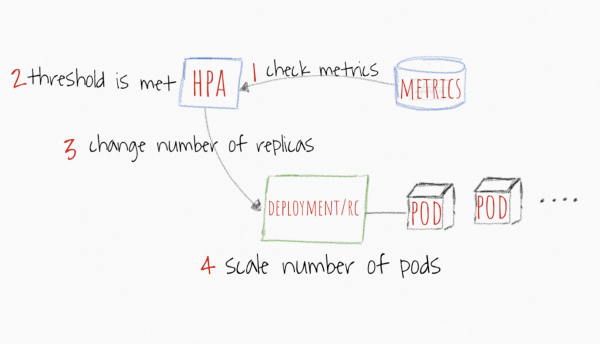 A imagem foi retirada de https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Além das métricas padrão, como CPU e memória, você pode configurar limites para suas métricas personalizadas a partir do Prometheus e trabalhar com elas, se achar que isso é a definição mais precisa de quando escalar sua aplicação. Após a estabilização da aplicação abaixo do limite de métrica estabelecido, o HPA começará a escalar os pods para baixo até o número mínimo de réplicas ou até que a carga atenda ao limite especificado.
6. Não se esqueça da Afinidade de Nó e da Afinidade de Pod
Nem todos os nós operam com o mesmo hardware, nem todos os pods precisam executar aplicações que exigem computação intensa. O Kubernetes permite definir especialização de nós e pods usando Node Affinity e Pod Affinity.
Se você tiver nós adequados para operações intensivas em computação, é melhor vincular as aplicações aos nós apropriados para máxima eficiência. Para isso, use nodeSelector com o rótulo do nó.
Suponha que você tenha dois nós: um com CPUType=HIGHFREQ e um grande número de núcleos rápidos, e outro com MemoryType=HIGHMEMORY um grande volume de memória e maior desempenho. O mais simples é atribuir o deployment do pod ao nó HIGHFREQ, adicionando na seção spec o seguinte seletor:
…
nodeSelector:
	CPUType: HIGHFREQ
Uma maneira mais custosa e específica de fazer isso é usar nodeAffinity no campo afinidade da seção spec. Existem duas opções:
requiredDuringSchedulingIgnoredDuringExecution: configuração rígida (o scheduler irá implantar pods apenas em nós específicos (e em nenhum outro lugar));preferredDuringSchedulingIgnoredDuringExecution: configuração suave (o planejador tentará implantar em nós específicos, e se não conseguir, tentará implantar no próximo nó disponível).
Você pode especificar uma certa sintaxe para controlar as etiquetas dos nós, como Em, NãoEm, Existe, NãoExiste, Gt ou Lt. No entanto, lembre-se de que métodos complexos em listas longas de etiquetas atrasarão a tomada de decisões em situações críticas. Em outras palavras, não complique.
Como mencionado anteriormente, o Kubernetes permite especificar a vinculação dos pods atuais. Ou seja, você pode fazer com que certos pods trabalhem junto com outros pods na mesma zona de disponibilidade (relevante para nuvens) ou nós.
Em podAffinity campos afinidade da seção spec os mesmos campos estão disponíveis que no caso de nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution e preferredDuringSchedulingIgnoredDuringExecution. A única diferença é que matchExpressions vinculará os pods ao nó onde já está sendo executado um pod com essa etiqueta.
Além disso, o Kubernetes oferece o campo podAntiAffinity, que, ao contrário, não vincula o pod a um nó com determinados pods.
Quanto às expressões nodeAffinity pode-se dar o mesmo conselho: busque manter a simplicidade e a lógica das regras, não tente sobrecarregar a especificação dos pods com um conjunto complicado de regras. É muito fácil criar uma regra que não corresponda às condições do cluster, criando uma carga extra no planejador e reduzindo o desempenho geral.
7. Taints & Tolerations
Há mais uma maneira de gerenciar o planejador. Se você tiver um grande cluster com centenas de nós e milhares de microsserviços, é muito difícil impedir que certos pods sejam alocados em certos nós.
Isso é ajudado pelo mecanismo de taints — regras proibitivas. Por exemplo, em certos cenários, pode-se proibir determinados nós de executar pods. Para aplicar um taint a um nó específico, você precisa usar a opção taint no kubectl. Especifique a chave e o valor, e depois o taint como NoSchedule ou NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleVale ressaltar também que o mecanismo de taint suporta três efeitos principais: NoSchedule, NoExecute e PreferNoSchedule.
NoSchedulesignifica que, enquanto não houver um registro correspondente na especificação do podtolerations, ele não poderá ser implantado em um nó (neste exemplonode10).PreferNoSchedule— uma versão simplificadaNoSchedule. Nesse caso, o planejador tentará não alocar pods que não possuam um registro correspondentetolerationsno nó, mas isso não é uma restrição rígida. Se não houver recursos no cluster, os pods começarão a ser implantados nesse nó.NoExecute— este efeito inicia a evacuação imediata de pods que não têm um registro correspondentetolerations.
Curiosamente, esse comportamento pode ser anulado por meio do mecanismo de tolerâncias. Isso é útil quando há um nó "proibido" e você precisa implantar nele apenas serviços de infraestrutura. Como fazer isso? Permitir apenas os pods para os quais há uma tolerância adequada.
Veja como ficará a especificação do pod:
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Isso não significa que, na próxima reinicialização do pod, ele será implantado exatamente nesse nó, isso não é um mecanismo de Affinity de Nó e nodeSelector. Mas, combinando vários recursos, você pode obter uma configuração de agendador muito flexível.
8. Configure a prioridade de implantação dos pods
O fato de você ter configurado a vinculação dos pods aos nós não significa que todos os pods devem ser tratados com a mesma prioridade. Por exemplo, você pode querer implantar certos pods antes dos outros.
O Kubernetes oferece diferentes maneiras de configurar a prioridade dos pods (Prioridade e Preempção de Pods). A configuração consiste em várias partes: do objeto PriorityClass e da descrição do campo priorityClassName na especificação do pod. Vamos ver um exemplo:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Esta classe de prioridade deve ser usada apenas para pods muito importantes"
Estamos criando PriorityClass, definindo um nome, uma descrição e um valor. Quanto maior valor, maior a prioridade. O valor pode ser qualquer número inteiro de 32 bits, menor ou igual a 1 000 000 000. Valores mais altos são reservados para pods de sistema críticos, que geralmente não podem ser preemptados. A preempção só ocorrerá se não houver lugar para o pod de alta prioridade ser implantado, então parte dos pods de um determinado nó será evacuada. Se esse mecanismo for muito rígido para você, pode-se adicionar a opção preemptionPolicy: Never, e então não haverá preempção, o pod ficará em primeiro na fila esperando que o agendador encontre recursos livres para ele.
Em seguida, criamos um pod, especificando o nome priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
É possível criar quantas classes de prioridade forem necessárias, embora seja recomendável não exagerar (por exemplo, limitar-se a prioridade baixa, média e alta).
Dessa forma, se necessário, você poderá aumentar a eficiência da implantação de serviços críticos, como nginx-ingress-controller, coredns etc.
9. Otimize o cluster ETCD
O ETCD pode ser considerado o cérebro de todo o cluster. É muito importante manter o funcionamento desse banco de dados em um alto nível, uma vez que a velocidade das operações no 'Kube' depende dele. Uma solução padrão e ao mesmo tempo razoável seria manter o cluster ETCD em nodos mestres, para ter a menor latência possível até kube-apiserver. Se não for possível, posicione o ETCD o mais perto possível, garantindo uma boa largura de banda entre os participantes. Além disso, preste atenção em quantos nós do ETCD podem falhar sem prejudicar o cluster.
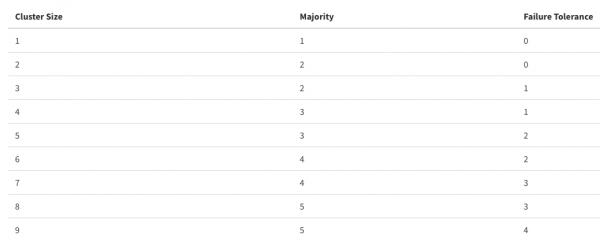
Lembre-se de que um aumento excessivo no número de participantes do cluster pode aumentar a tolerância a falhas em detrimento do desempenho; tudo deve ser equilibrado.
Falando sobre a configuração do serviço, as recomendações são poucas:
Tenha um bom hardware, levando em conta o tamanho do cluster (você pode ler sobre isso ).
Ajuste alguns parâmetros, se você espalhou o cluster entre alguns DCs ou se sua rede e discos deixam a desejar (você pode ler sobre isso ).
Conclusão
Neste artigo, descrevemos pontos que nossa equipe tenta seguir. Essa não é uma descrição passo a passo das ações, mas opções que podem ser úteis para otimizar os custos overhead do cluster. É claro que cada cluster é único, e as soluções de configuração podem variar bastante, portanto, seria interessante receber seu feedback: como você monitora seu cluster Kubernetes e como melhora seu desempenho. Compartilhe sua experiência nos comentários, será interessante conhecê-la.
Fonte: habr.com
