

Continuo minha história sobre como integrar Exchange e ELK (início ). Lembro que essa combinação pode processar sem hesitações uma quantidade muito grande de logs. Desta vez, falaremos sobre como configurar o Exchange com os componentes Logstash e Kibana.
Logstash na pilha ELK é usado para o processamento inteligente de logs e sua preparação para armazenamento no Elastic na forma de documentos, com base nos quais é conveniente construir várias visualizações no Kibana.
Instalação
Consiste em duas etapas:
- Instalação e configuração do pacote OpenJDK.
- Instalação e configuração do pacote Logstash.
Instalação e configuração do pacote OpenJDK
O pacote OpenJDK deve ser baixado e extraído em um diretório específico. Em seguida, o caminho para esse diretório deve ser adicionado às variáveis $env:Path e $env:JAVA_HOME do sistema operacional Windows:
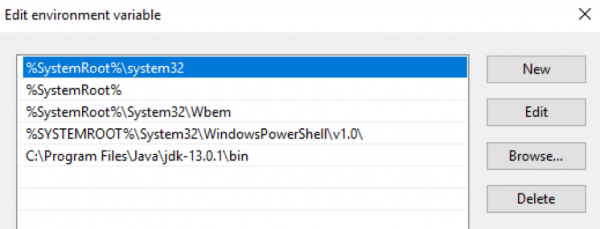
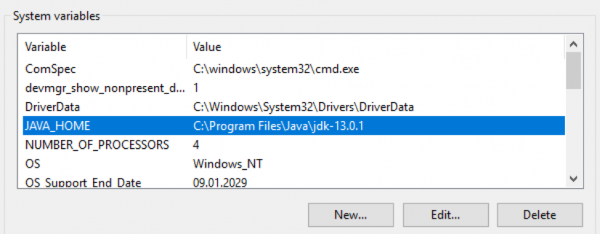
Verifique a versão do Java:
PS C:> java -version
openjdk version "13.0.1" 2019-10-15
OpenJDK Runtime Environment (build 13.0.1+9)
OpenJDK 64-Bit Server VM (build 13.0.1+9, mixed mode, sharing)
Instalação e configuração do pacote Logstash
Baixe o arquivo compactado com a distribuição do Logstash . O arquivo deve ser extraído na raiz do disco. Não deve ser extraído na pasta C:Program Files , o Logstash se recusará a iniciar corretamente. Em seguida, é necessário editar o arquivo jvm.options para alocar memória RAM para o processo Java. Recomendo especificar metade da memória RAM do servidor. Se ele tiver 16 GB de RAM, os parâmetros padrão são:
-Xms1g
-Xmx1g
devem ser alterados para:
-Xms8g
-Xmx8g
Além disso, é aconselhável comentar a linha -XX:+UseConcMarkSweepGC. Para mais detalhes sobre isso . O próximo passo é criar a configuração padrão no arquivo logstash.conf:
input {
 stdin{}
}

filter {
}

output {
 stdout {
 codec => "rubydebug"
 }
}
Ao usar esta configuração, Logstash lê dados do console, passa por um filtro vazio e os exibe de volta no console. A aplicação desta configuração permitirá verificar se o Logstash está funcionando. Para isso, executaremos em modo interativo:
PS C:...bin> .logstash.bat -f .logstash.conf
...
[2019-12-19T11:15:27,769][INFO ][logstash.javapipeline    ][main] Pipeline started {"pipeline.id"=>"main"}
O plugin stdin agora está aguardando entrada:
[2019-12-19T11:15:27,847][INFO ][logstash.agent           ] Pipelines em execução {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]}
[2019-12-19T11:15:28,113][INFO ][logstash.agent           ] Endpoint da API do Logstash iniciado com sucesso {:port=>9600}
Logstash foi iniciado com sucesso na porta 9600.
A etapa final da instalação: executar o Logstash como um serviço Windows. Isso pode ser feito, por exemplo, com o pacote :
PS C:...bin> .nssm.exe install logstash
Serviço "logstash" instalado com sucesso!
Resiliência
A integridade dos logs durante a transferência do servidor de origem é garantida pelo mecanismo de Filas Persistentes.
Como funciona
O esquema de localização das filas no processo de processamento de logs: input → queue → filter + output.
O plugin input recebe dados da fonte de logs, os grava na fila e envia uma confirmação de recebimento à fonte.
As mensagens da fila são processadas pelo Logstash, passam pelo filtro e pelo plugin output. Ao receber a confirmação de envio do log do output, o Logstash remove o log processado da fila. Se o Logstash for interrompido, todas as mensagens não processadas e as que não receberam confirmação de envio permanecem na fila, e o Logstash continuará a processá-las na próxima execução.
Configuração
É ajustado pelas chaves no arquivo C:Logstashconfiglogstash.yml:
queue.type: (valores possíveis —persistedememory (padrão)).path.queue: (caminho para a pasta com arquivos de filas, que por padrão são armazenados em C:Logstashqueue).queue.page_capacity: (tamanho máximo da página da fila, valor padrão — 64mb).queue.drain: (true/false — ativa/desativa a interrupção do processamento da fila antes de desligar o Logstash. Não recomendo ativar, pois isso impactará diretamente na velocidade de desligamento do servidor).queue.max_events: (número máximo de eventos na fila, por padrão — 0 (sem limite)).queue.max_bytes: (tamanho máximo da fila em bytes, por padrão — 1024mb (1gb)).
Se configuradas queue.max_events e queue.max_bytes, então as mensagens param de ser recebidas na fila ao atingir o valor de qualquer uma dessas configurações. Mais detalhes sobre Filas Persistentes são discutidos .
Exemplo de trecho do logstash.yml, responsável pela configuração da fila:
queue.type: persisted
queue.max_bytes: 10gb
Configuração
A configuração do Logstash geralmente consiste em três partes, responsáveis por diferentes fases do processamento de logs de entrada: recebimento (seção input), parsing (seção filter) e envio ao Elastic (seção output). Abaixo, analisaremos cada uma delas em mais detalhes.
Input
Recebemos o fluxo de logs brutos dos agentes filebeat. É este plugin que indicamos na seção input:
input {
  beats {
    port => 5044
  }
}
Após tal configuração, o Logstash começa a escutar na porta 5044 e, ao receber logs, os processa de acordo com as configurações da seção filter. Se necessário, o canal de recebimento de logs do filebeat pode ser envolvido em SSL. Mais detalhes sobre as configurações do plugin beats estão documentados. .
Filtro
Todos os logs de texto gerados pelo Exchange que são interessantes para processamento estão no formato csv, com os campos descritos no próprio arquivo de logs. Para analisar os registros csv, o Logstash nos oferece três plugins: , csv e grok. O primeiro é o mais , mas lida apenas com a análise dos logs mais simples.
Por exemplo, o seguinte registro será dividido em duas partes (devido à presença de uma vírgula dentro de um campo), resultando em uma análise incorreta do log:
…,"MDB:GUID1, Mailbox:GUID2, Event:526545791, MessageClass:IPM.Note, CreationTime:2020-05-15T12:01:56.457Z, ClientType:MOMT, SubmissionAssistant:MailboxTransportSubmissionEmailAssistant",…
Ele pode ser utilizado na análise de logs, por exemplo, do IIS. Nesse caso, a seção filter pode ser assim:
filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
    }
  }
}
A configuração do Logstash permite o uso de , portanto, no plugin dissect podemos direcionar apenas os logs que foram marcados com o tag do filebeat IIS. Dentro do plugin, mapeamos os valores dos campos com seus nomes, removemos o campo original message, que continha a entrada do log, e podemos adicionar um campo extra que pode, por exemplo, conter o nome do aplicativo do qual estamos coletando os logs.
No caso dos logs de rastreamento, é melhor usar o plugin csv, que é capaz de processar campos complexos corretamente:
filter {
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
}
Dentro do plugin, mapeamos os valores dos campos com seus nomes, removemos o campo original message (assim como os campos tenant-id e schema-version), que continha a entrada do log, e podemos adicionar um campo extra que pode, por exemplo, conter o nome do aplicativo do qual estamos coletando os logs.
Na saída da fase de filtragem, teremos documentos em um primeiro momento prontos para visualização no Kibana. O que nos faltará será o seguinte:
- Os campos numéricos serão reconhecidos como texto, o que não permite realizar operações com eles. Ou seja, os campos
time-takendo log IIS, bem como os camposrecipient-countetotal-bitesdo log Tracking. - O timestamp padrão do documento conterá o tempo de processamento do log, e não o tempo de gravação do lado do servidor.
- Campo
recipient-addressparecerá uma única linha, o que não permite realizar a análise com a contagem de destinatários dos e-mails.
Chegou a hora de adicionar um pouco de mágica ao processo de processamento de logs.
A conversão de campos numéricos
O plugin dissect tem a opção convert_datatype, que pode ser usada para converter um campo de texto em formato numérico. Por exemplo, assim:
dissect {
  …
  convert_datatype => { "time-taken" => "int" }
  …
}
É importante lembrar que este método é adequado apenas se o campo contiver exatamente uma string. Valores nulos nos campos não são tratados pela opção e resultam em uma exceção.
Para logs de tracking, é melhor não usar o método convert semelhante, pois os campos recipient-count e total-bites podem estar vazios. Para a conversão desses campos, é melhor usar o plugin :
mutate {
  convert => [ "total-bytes", "integer" ]
  convert => [ "recipient-count", "integer" ]
}
Dividindo recipient_address em destinatários separados
Essa tarefa também pode ser resolvida com o plugin mutate:
mutate {
  split => ["recipient_address", ";"]
}
Alterando o timestamp
No caso dos logs de tracking, a tarefa é facilmente resolvida com o plugin , que ajudará a definir no campo timestamp a data e a hora no formato desejado a partir do campo date-time:
date {
  match => [ "date-time", "ISO8601" ]
  timezone => "Europe/Moscow"
  remove_field => [ "date-time" ]
}
No caso dos logs IIS, precisaremos combinar os dados dos campos date e time com o plugin mutate, definir o fuso horário necessário e colocar esse timestamp em timestamp com o plugin date:
mutate {
  add_field => { "data-time" => "%{date} %{time}" }
  remove_field => [ "date", "time" ]
}
date {
  match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
  timezone => "UTC"
  remove_field => [ "data-time" ]
}
Saída
A seção output é usada para enviar os logs processados ao receptor de logs. No caso de envio direto ao Elastic, usa-se o plugin , no qual se especifica o endereço do servidor e o padrão de nome do índice para enviar o documento formatado:
output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Configuração final
A configuração final será parecida com o seguinte:
input {
  beats {
    port => 5044
  }
}

filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
      convert_datatype => { "time-taken" => "int" }
    }
    mutate {
      add_field => { "data-time" => "%{date} %{time}" }
      remove_field => [ "date", "time" ]
    }
    date {
      match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
      timezone => "UTC"
      remove_field => [ "data-time" ]
    }
  }
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
    mutate {
      convert => [ "total-bytes", "integer" ]
      convert => [ "recipient-count", "integer" ]
      split => ["recipient_address", ";"]
    }
    date {
      match => [ "date-time", "ISO8601" ]
      timezone => "Europe/Moscow"
      remove_field => [ "date-time" ]
    }
  }
}

output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Links úteis:
Fonte: habr.com
