

Como o ClickHouse é um sistema especializado, é importante considerar as características de sua arquitetura ao utilizá-lo. Neste relatório, Alexey discutirá exemplos típicos de erros ao usar o ClickHouse, que podem levar a um desempenho ineficaz. Serão mostrados exemplos práticos de como a escolha de um ou outro esquema de processamento de dados pode alterar a performance drasticamente.
Olá a todos! Meu nome é Alexey, eu trabalho com ClickHouse.
Em primeiro lugar, vou logo alegrá-los, não vou falar hoje sobre o que é ClickHouse. Para ser sincero, estou cansado disso. Eu explico isso toda vez. E, provavelmente, todos já sabem.
Em vez disso, vou falar sobre os possíveis erros, ou seja, como usar o ClickHouse de forma errada. Na verdade, não é para ter medo, porque desenvolvemos o ClickHouse como um sistema que é simples, conveniente e funciona bem desde o início. Instalou e está tudo pronto, sem problemas.
Mas ainda é preciso considerar que este sistema é especializado e é fácil se deparar com um cenário de uso incomum que pode tirar o sistema de sua zona de conforto.
Então, quais são esses erros? Principalmente, vou falar sobre coisas óbvias. Para todos é óbvio, todos entendem e podem se alegrar por serem tão inteligentes, e quem não entende, aprenderá algo novo.
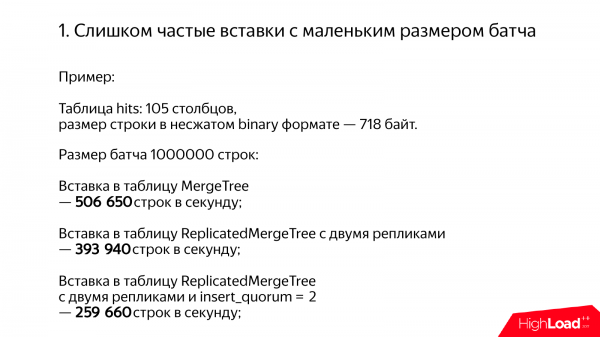
O primeiro e mais simples exemplo, que, infelizmente, é bastante comum, é o grande número de inserts com pequenos batches, ou seja, uma grande quantidade de pequenos inserts.
Se considerarmos como o ClickHouse executa um insert, você pode enviar em uma única solicitação um fluxo de dados de até um terabyte. Isso não é problema.
E vamos verificar qual seria a performance típica. Por exemplo, temos uma tabela com dados do Yandex.Metrica. Hits. 105 colunas de algum tipo. 700 bytes em formato não comprimido. E vamos inserir corretamente em batches de um milhão de linhas.
Inserindo na tabela MergeTree, obtemos meio milhão de linhas por segundo. Excelente. Na tabela replicada, será um pouco menos, cerca de 400.000 linhas por segundo.
E se ativarmos a inserção com quórum, obtemos um pouco menos, mas ainda uma performance razoável, 250.000 linhas por segundo. A inserção com quórum é um recurso não documentado no ClickHouse*.
* até o ano de 2020, .
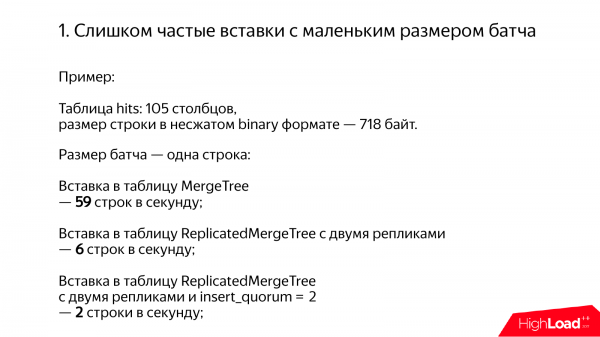
O que acontece se fizer mal? Inserimos uma linha por vez na tabela MergeTree e obtemos 59 linhas por segundo. Isso é 10.000 vezes mais devagar. No ReplicatedMergeTree, são 6 linhas por segundo. E se o quorum entrar em ação, acabam sendo 2 linhas por segundo. Na minha opinião, isso é um verdadeiro desastre. Como pode haver tanta lentidão? Até mesmo na minha camiseta está escrito que ClickHouse não deve travar. Mas, no entanto, isso acontece às vezes.
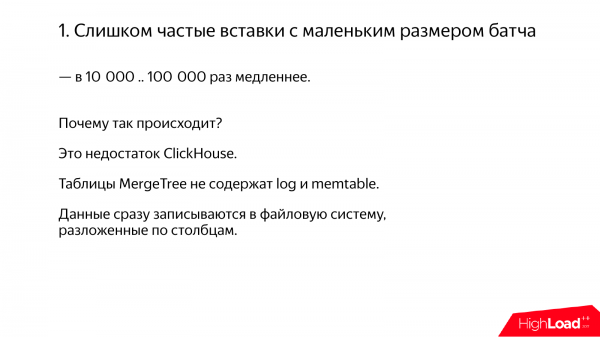
Na verdade, essa é uma falha nossa. Poderíamos facilmente fazer com que tudo funcionasse corretamente, mas não o fizemos. E não o fizemos porque, para o nosso cenário, isso não era necessário. Já tínhamos lotes. Os dados chegavam em lotes, e não havia problemas. Inserimos e tudo funcionava normalmente. Mas, é claro, vários cenários são possíveis. Por exemplo, quando você tem muitos servidores que geram dados. E eles inserem dados não com tanta frequência, mas ainda assim ocorrem inserções frequentes. E é necessário evitar isso de alguma forma.
Do ponto de vista técnico, a questão é que, quando você faz um insert no ClickHouse, os dados não vão para nenhuma memtable. Na verdade, nem temos um log structure MergeTree, mas apenas um MergeTree, porque não há log nem memTable. Nós simplesmente escrevemos os dados diretamente no sistema de arquivos, já organizados em colunas. E se você tem 100 colunas, será necessário gravar mais de 200 arquivos em um diretório separado. Tudo isso é bastante volumoso.
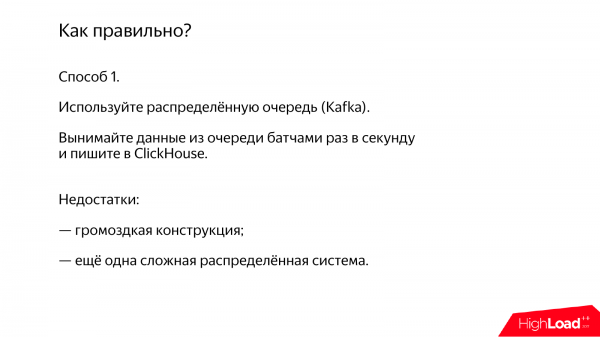
E surge a pergunta: ‘Como fazer corretamente?’, se essa situação implica que os dados precisam, de alguma forma, ser gravados no ClickHouse.
Método 1. Este é o método mais simples. Usar alguma fila distribuída. Por exemplo, Kafka. Basta extrair os dados do Kafka, processar em lotes uma vez por segundo. E tudo funcionará normalmente, você registra e tudo funciona bem.
As desvantagens são que Kafka é mais um sistema distribuído volumoso. Eu entendo melhor se você já tem o Kafka na sua empresa. Isso é bom, é conveniente. Mas se não tem, vale a pena pensar duas vezes antes de adicionar mais um sistema distribuído ao seu projeto. Portanto, é recomendável considerar alternativas.
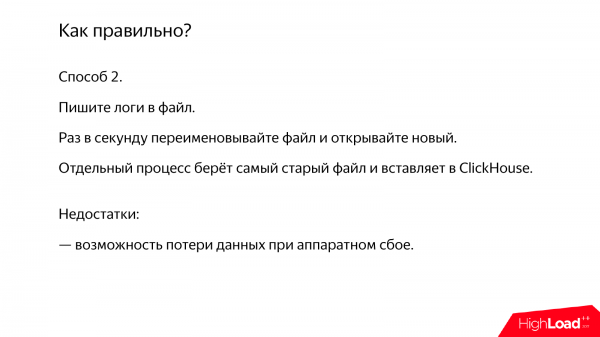
Método 2. Aqui está uma alternativa old school que é muito simples. Você tem algum servidor que gera seus logs. Ele simplesmente grava seus logs em um arquivo. E a cada segundo, por exemplo, renomeamos esse arquivo e abrimos um novo. E um script separado, seja por cron ou algum daemon, pega o arquivo mais antigo e grava no ClickHouse. Se você gravar os logs a cada segundo, tudo funcionará perfeitamente.
Mas a desvantagem desse método é que, se o seu servidor, onde os logs são gerados, desaparecer, os dados também desaparecerão.
Método 3. Existe outro método interessante que não usa arquivos temporários. Por exemplo, você tem um sistema de anúncios ou outro daemon interessante que gera dados. E você pode acumular um lote de dados diretamente na memória, no buffer. E quando passar um tempo suficiente, você guarda esse buffer de lado, cria um novo, e em uma thread separada, o que já foi acumulado, é inserido no ClickHouse.
Por outro lado, os dados também desaparecem com um kill -9. Se o seu servidor cair, você perderá esses dados. E outro problema é que se você não conseguir gravar no banco, os dados começarão a se acumular na memória. E ou a memória acabará, ou você simplesmente perderá os dados.
Método 4. Outro método interessante. Você tem algum processo no servidor. E ele pode enviar dados para o ClickHouse imediatamente, mas fazendo isso em uma única conexão. Por exemplo, enviando uma solicitação HTTP com transfer-encoding: chunked com um insert. E gera chunks não tão raramente, pode enviar cada linha, embora haja um overhead na estruturação desses dados.
Mas, no entanto, nesse caso, os dados serão enviados para o ClickHouse imediatamente. E o ClickHouse irá bufferizá-los.
Mas também surgem problemas. Agora você perderá dados, incluindo quando seu processo for encerrado e, se o processo ClickHouse for encerrado, porque será um insert não concluído. Os inserts no ClickHouse são atômicos até um determinado limite de número de linhas. Em princípio, esse é um método interessante. Também pode ser utilizado.
Método 5. Aqui está mais uma maneira interessante. É um servidor desenvolvido pela comunidade para processamento em lote de dados. Eu mesmo não olhei para ele, portanto não posso garantir nada. No entanto, para o próprio ClickHouse também não são fornecidas garantias. Este também é open source, mas por outro lado, você pode estar acostumado a um certo padrão de qualidade, que nos esforçamos para garantir. Mas para essa ferramenta – eu não sei, vá ao GitHub, veja o código. Pode ser que tenham escrito algo bom.
* em 2020, deve-se também considerar .
Método 6. Outra forma é usar tabelas Buffer. A vantagem desse método é que é muito fácil de começar a utilizar. Você cria uma tabela Buffer e insere nela.
Mas a desvantagem é que o problema não é completamente resolvido. Se ao inserir com tipo MergeTree você deve agrupar os dados em um lote por segundo, ao inserir na tabela buffer, você precisa agrupar pelo menos algumas milhares por segundo. Se houver mais de 10.000 por segundo, ainda será problemático. E se você estiver inserindo em lotes, você viu que consegue centenas de milhares de linhas por segundo. E isso já com dados bastante pesados.
E também as tabelas buffer não têm log. E se algo estiver errado com seu servidor, os dados serão perdidos.
E como um bônus, recentemente no ClickHouse surgiu a possibilidade de extrair dados do Kafka. Existe um mecanismo de tabelas – Kafka. Você simplesmente cria. E pode anexar visualizações materializadas a ele. Nesse caso, ele extrairá os dados do Kafka e os inserirá nas tabelas que você precisa.
E o que é especialmente gratificante nessa possibilidade é que não fomos nós que fizemos. É um recurso da comunidade. E quando digo "recurso da comunidade", não o digo com desprezo. Lemos o código, fizemos a revisão, deve funcionar normalmente.
* em 2020, foi adicionada suporte similar para .
O que mais pode ser incômodo ou inesperado ao inserir dados? Se você faz uma consulta insert values e em values escreve algumas expressões calculadas. Por exemplo, now() – isso também é uma expressão calculada. E nesse caso, o ClickHouse é forçado a executar o interpretador dessas expressões para cada linha, e o desempenho cairá drasticamente. É melhor evitar isso.
* No momento, o problema está completamente resolvido, não há mais degradação de desempenho ao usar expressões em VALUES.
Outro exemplo de quando podem ocorrer alguns problemas é quando, em um único lote, os dados pertencem a várias partições. Por padrão, o ClickHouse organiza as partições por meses. Se você insere um lote de um milhão de linhas e os dados abrangem vários anos, terá várias dezenas de partições. Isso equivale a ter lotes com tamanhos várias dezenas de vezes menores, porque internamente eles são divididos primeiro por partições.
* Recentemente, o ClickHouse adicionou suporte experimental para o formato compacto de pedaços e pedaços na memória com log gravável, o que resolve quase completamente o problema.
Agora vamos considerar o segundo tipo de problema – a tipificação de dados.
A tipificação de dados pode ser estrita ou ser uma string. String é quando você simplesmente declara que todos os seus campos são do tipo string. Isso é péssimo. Não devemos fazer assim.
Vamos entender como fazer corretamente nos casos em que queremos dizer que um campo é uma string e que o ClickHouse pode resolver isso sozinho, sem eu me preocupar. Mas ainda assim vale a pena fazer alguns esforços.
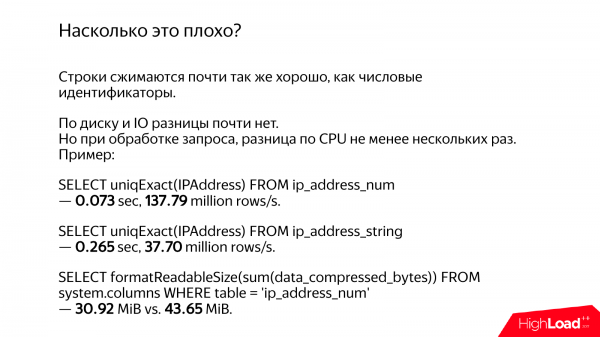
Por exemplo, temos um endereço IP. Em um caso, nós o salvamos como uma string. Por exemplo, 192.168.1.1. E em outro caso – será um número do tipo UInt32*. 32 bits são suficientes para um endereço IPv4.
Primeiro, não estranhe, os dados serão compactados de maneira aproximadamente igual. Havendo diferenças, claro, mas não tão grandes. Portanto, não há problemas significativos com entrada e saída de disco.
Mas há uma diferença séria em termos de tempo de CPU e no tempo de execução da consulta.
Vamos contar o número de endereços IP únicos, se eles forem armazenados como números. Obtemos 137 milhões de linhas por segundo. Se for o mesmo como strings, dá 37 milhões de linhas por segundo. Não sei por que essa coincidência aconteceu. Eu mesmo executei essas consultas. Mas, ainda assim, é cerca de 4 vezes mais lento.
E se contarmos a diferença no espaço em disco, também há uma diferença. E a diferença é de cerca de um quarto, porque há muitos endereços IP únicos. Se houvesse linhas com poucos valores diferentes, elas se comprimiriam de maneira semelhante a um dicionário, ocupando aproximadamente o mesmo espaço.
E a diferença de quatro vezes no tempo de estrada não é desprezível. Pode ser que você não se importe, mas quando vejo uma diferença assim, fico triste.
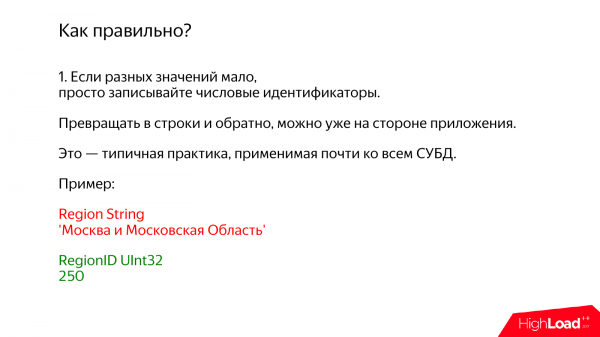
Vamos considerar diferentes casos.
1. Um caso onde você tem poucos valores únicos. Nesse caso, usamos uma prática simples que você provavelmente conhece e pode aplicar a qualquer SGBD. Isso faz sentido não apenas para o ClickHouse. Você simplesmente grava identificadores numéricos no banco. E a conversão para strings e vice-versa pode ser feita já no lado da sua aplicação.
Por exemplo, você tem uma região. E está tentando salvá-la como string. E lá estará escrito: Moscovo e MO. E quando vejo que está escrito "Moscovo", tudo bem, mas quando também aparece MO, fico ainda mais triste. Isso é uma quantidade enorme de bytes.
Em vez disso, gravamos simplesmente o número Ulnt32 e 250. Temos 250 no Yandex, e você pode ter um número diferente. Para constar, no ClickHouse existe a capacidade incorporada de trabalhar com geobases. Você simplesmente grava um dicionário com as regiões, incluindo hierárquico, ou seja, haverá Moscovo, MO e tudo o que precisar. E você pode converter isso no nível da consulta.
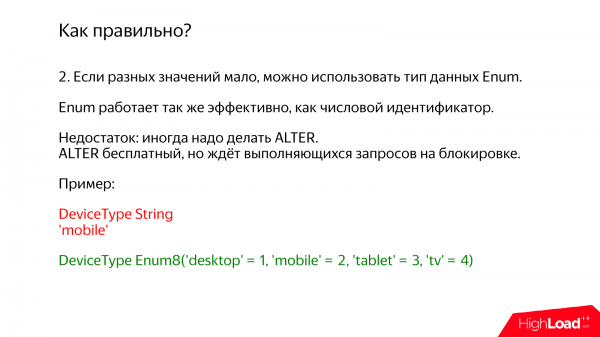
A segunda opção é semelhante, mas já com suporte dentro do ClickHouse. Este é o tipo de dados Enum. Você simplesmente define dentro do Enum todos os valores necessários. Por exemplo, o tipo de dispositivo e escreve: desktop, móvel, tablet, televisão. No total, 4 opções.
A desvantagem é que é necessário alterar periodicamente. Adicionou apenas uma opção. Fazemos alter table. Na verdade, alterar uma tabela no ClickHouse é gratuito. Especialmente gratuito para Enum, porque os dados no disco não mudam. Mas, mesmo assim, o alter bloqueia a tabela e precisa esperar que todas as seleções sejam concluídas. E só depois disso o alter será realizado, ou seja, algumas inconveniências ainda existem.
* nas versões mais recentes do ClickHouse, o ALTER é totalmente não bloqueante.
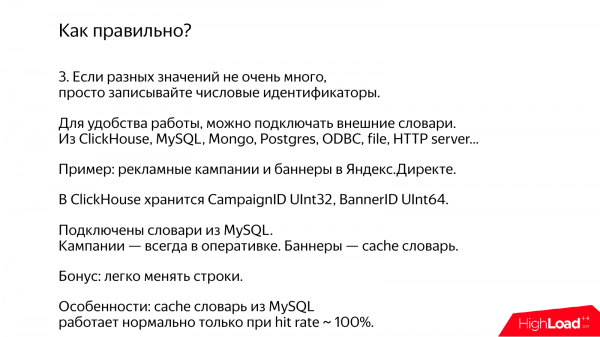
Outra opção bastante única para o ClickHouse é a conexão de dicionários externos. Você pode escrever números no ClickHouse e manter seus dicionários em qualquer sistema que lhe convier. Por exemplo, você pode usar: MySQL, Mongo, Postgres. Você pode até criar seu próprio microserviço que entregará esses dados via http. E no nível do ClickHouse, você escreve uma função que transformará esses dados de números em strings.
Este é um método especializado, mas muito eficaz para realizar um join com uma tabela externa. Existem duas opções. Em uma opção, esses dados serão totalmente armazenados em cache, completamente na memória e atualizados com certa periodicidade. Na outra opção, se esses dados não cabem na memória, é possível armazená-los em cache parcialmente.
Aqui está um exemplo. Existe o Yandex.Direct. E lá há campanhas publicitárias e banners. Existem cerca de dez milhões de campanhas publicitárias. E elas cabem na memória. Já os banners – são bilhões, eles não cabem. E usamos um dicionário em cache do MySQL.
O único problema é que o dicionário em cache funcionará corretamente se a taxa de acerto estiver próxima de 100%. Se for menor, ao processar solicitações para cada lote de dados, será necessário realmente buscar as chaves faltantes e obter os dados do MySQL. Posso garantir que o ClickHouse – sim, não apresenta lentidão, mas não comentarei sobre outros sistemas.
Como um bônus, o que os dicionários oferecem é uma maneira muito simples de atualizar dados no ClickHouse retroativamente. Ou seja, você tinha um relatório sobre campanhas publicitárias, o usuário simplesmente mudou a campanha publicitária e em todos os dados antigos, em todos os relatórios, esses dados também mudaram. Se você escrever linhas diretamente na tabela, será impossível atualizá-las.
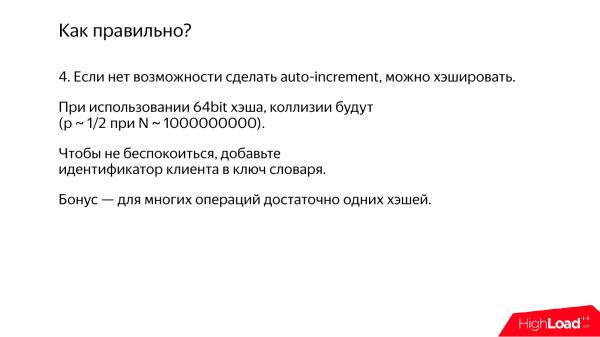
Outra maneira é quando você não sabe de onde obter os identificadores para suas linhas. Você pode simplesmente fazer um hash. E a opção mais simples é usar um hash de 64 bits.
O único problema é que se o hash tiver 64 bits, as colisões ocorrerão quase certamente. Porque se houver um bilhão de linhas, a probabilidade já se torna significativa.
E não seria muito bom fazer o hash dos nomes das campanhas publicitárias dessa forma. Se as campanhas publicitárias de diferentes empresas se confundirem, não ficará claro.
E há um truque simples. Embora não seja muito adequado para dados sérios, se você tiver algo menos crítico, basta adicionar o identificador do cliente à chave do dicionário. Assim, você terá colisões, mas apenas dentro dos limites de um único cliente. Este método é usado por nós para o mapa de links no Yandex.Metrica. Temos URLs lá, armazenamos hashes. E sabemos que, claro, há colisões. Mas quando a página é exibida, a probabilidade de que, em uma única página, um usuário tenha algumas URLs combinadas e que isso seja notado é desprezível.
Como bônus, para muitas operações, apenas os hashes são suficientes e você não precisa armazenar as strings em lugar algum.
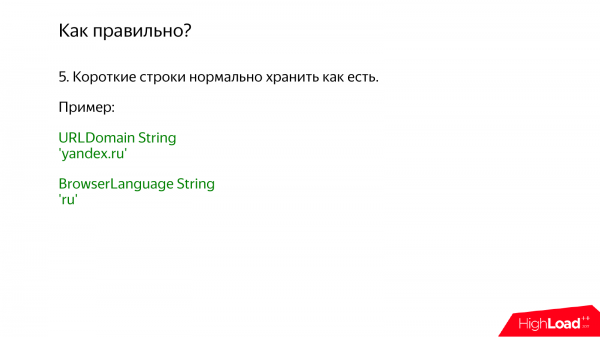
Outro exemplo, se as strings forem curtas, como domínios de sites. Você pode armazená-las como estão. Ou, por exemplo, o idioma do navegador ru – 2 bytes. Claro, eu lamento pelos bytes, mas não se preocupe, 2 bytes não são um problema. Por favor, armazene como está, não se preocupe.
Outro caso, quando, ao contrário, há muitas strings e muitas delas são únicas, com um potencial ilimitado. Um exemplo típico são as frases de busca ou URLs. Frases de busca, inclusive por causa de erros de digitação. Vamos ver quantas frases de busca únicas existem em um dia. Acontece que quase metade de todos os eventos é composta por elas. E nesse caso, você poderia pensar que é necessário normalizar os dados, calcular identificadores e armazená-los em uma tabela separada. Mas não é necessário fazer isso. Basta armazenar essas strings como estão.
Melhor não inventar nada, porque se armazenar separadamente, será necessário fazer um join. E esse join, na melhor das hipóteses, é um acesso aleatório à memória, se ainda couber na memória. Se não couber, haverá problemas.
E se os dados são armazenados in place, eles simplesmente são lidos na ordem necessária do sistema de arquivos e tudo funciona normalmente.
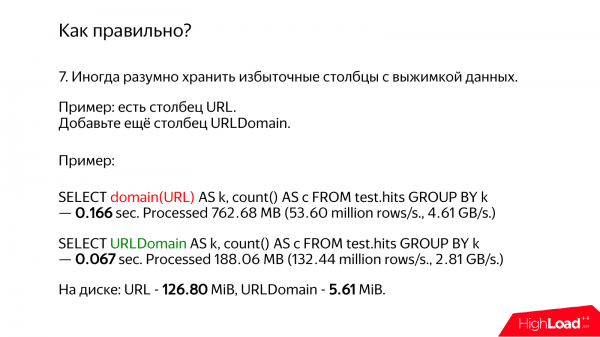
Se você tem URLs ou algum outro tipo de string longa e complexa, vale a pena considerar que você pode calcular um resumo antecipadamente e gravá-lo em uma coluna separada.
Para URLs, por exemplo, você pode armazenar o domínio separadamente. E se realmente precisar do domínio, basta usar essa coluna, enquanto as URLs estarão armazenadas e você não precisará sequer tocá-las.
Vamos ver qual é a diferença. No ClickHouse existe uma função especializada que calcula o domínio. Ela é muito rápida, nós a otimizamos. E, sinceramente, ela nem atende ao RFC, mas, mesmo assim, calcula tudo o que precisamos.
Em um caso, estaremos apenas extraindo URLs e computando o domínio. O resultado é de 166 milissegundos. Mas se pegarmos um domínio já preparado, o tempo cai para apenas 67 milissegundos, ou seja, quase três vezes mais rápido. Isso não é porque precisamos fazer cálculos, mas porque lemos menos dados.
Por que, então, uma consulta mais lenta gera uma maior velocidade em gigabytes por segundo? Porque ela lê mais gigabytes. Esses dados são completamente desnecessários. A consulta parece funcionar mais rápido, mas leva mais tempo para ser executada.
Se olharmos o volume de dados no disco, veremos que a URL ocupa 126 megabytes, enquanto o domínio ocupa apenas 5 megabytes. Isso é 25 vezes menos. No entanto, a consulta é realizada apenas 4 vezes mais rápido. Isso acontece porque os dados são quentes. Se fossem frios, provavelmente seria 25 vezes mais rápido devido à entrada e saída de disco.
A propósito, se avaliarmos o quanto o domínio é menor que a URL, vemos que é cerca de 4 vezes. Mas, por algum motivo, os dados no disco ocupam 25 vezes menos. Por que isso? Devido à compressão. Tanto a URL quanto o domínio são comprimidos. Mas frequentemente, a URL contém muita informação desnecessária.
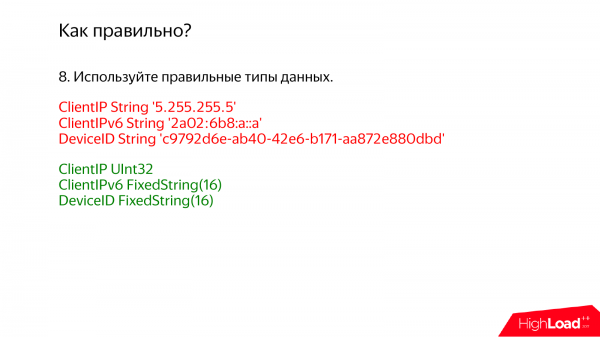
E, claro, é importante usar os tipos de dados corretos, que são especialmente projetados para os valores necessários ou que se adequam. Se você estiver usando IPv4, guarde como UInt32*. Se for IPv6, use FixedString(16), pois o endereço IPv6 tem 128 bits, ou seja, armazene no formato binário.
E o que fazer se você às vezes tem endereços IPv4 e outras vezes IPv6? Sim, é possível armazenar ambos. Uma coluna para IPv4 e outra para IPv6. Claro, existe a opção de representar IPv4 em IPv6. Isso também funcionará, mas se você frequentemente precisar de um endereço IPv4 nas suas consultas, é uma boa ideia armazená-lo em uma coluna separada.
* Agora no ClickHouse existem tipos de dados separados para IPv4 e IPv6 que armazenam os dados de forma tão eficiente quanto números, mas os apresentam de maneira tão conveniente quanto strings.
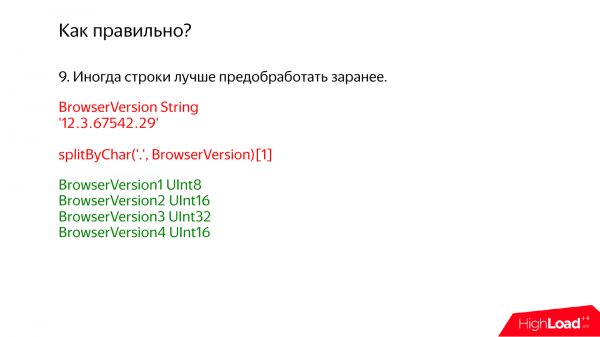
É importante observar que os dados devem ser pré-processados com antecedência. Por exemplo, você recebe alguns logs brutos. E talvez não seja uma boa ideia enviá-los imediatamente para o ClickHouse, embora seja tentador não fazer nada e tudo funcione. Mas é melhor realizar os cálculos que puder.
Por exemplo, a versão do navegador. Em um departamento vizinho, que não quero mencionar, a versão do navegador é armazenada assim, ou seja, como uma string: 12.3. E depois, para gerar um relatório, eles pegam essa string, dividem em um array e depois pegam o primeiro elemento do array. Naturalmente, tudo fica lento. Perguntei por que eles fazem isso. Eles me responderam que não gostam de otimização prematura. E eu não gosto de pessimismo prematuro.
Então, neste caso, é mais adequado dividir em 4 colunas. Não tenha medo, porque isso é ClickHouse. ClickHouse é um banco de dados por coluna. E quanto mais pequenas colunas organizadas, melhor. Se tiver 5 BrowserVersion, faça 5 colunas. Isso é normal.
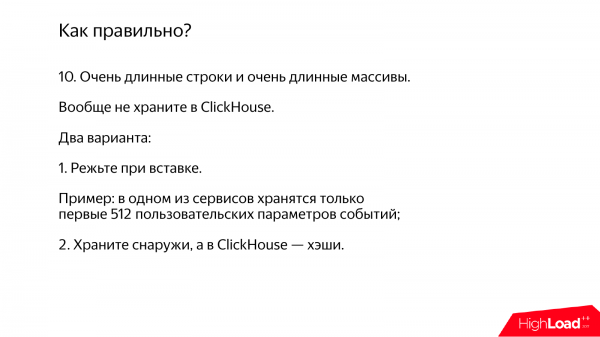
Agora, vamos considerar o que fazer se você tiver muitas strings muito longas, muitos arrays muito longos. Eles não precisam ser armazenados no ClickHouse de maneira alguma. Em vez disso, você pode salvar no ClickHouse apenas um identificador. E coloque essas strings longas em algum outro sistema.
Por exemplo, em um dos nossos serviços analíticos, existem certos parâmetros de eventos. E se muitos parâmetros chegarem para os eventos, nós simplesmente armazenamos os primeiros 512 que encontramos. Porque 512 não é um desperdício.
E se você não conseguir decidir sobre os seus tipos de dados, você também pode gravar os dados no ClickHouse, mas em uma tabela temporária do tipo Log, especialmente para dados temporários. Depois disso, você pode analisar qual é a distribuição de valores lá, o que realmente existe e criar os tipos corretos.
* atualmente, o ClickHouse tem um tipo de dado que permite armazenar strings de forma eficiente com menor custo de processamento.
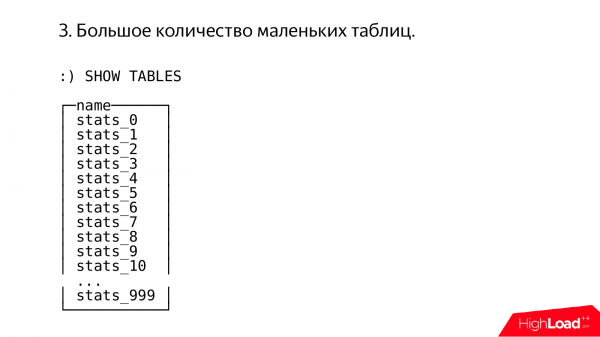
Agora, vamos considerar outro caso interessante. Às vezes, as coisas funcionam de um jeito estranho para as pessoas. Eu entro e vejo isso. E logo imagino que foi feito por um administrador muito experiente e inteligente, que tem grande experiência em configurar o MySQL versão 3.23.
Aqui vemos mil tabelas, cada uma com o resto da divisão de algo incompreensível por mil.
Eu respeito a experiência alheia e entendo as dificuldades que podem ter sido enfrentadas para adquiri-la.
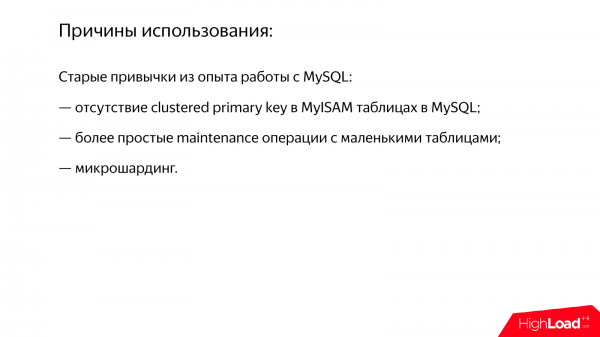
E as razões são mais ou menos compreensíveis. Esses são estereótipos antigos que podem ter se acumulado ao trabalhar com outros sistemas. Por exemplo, em tabelas MyISAM, não há uma chave primária clusterizada. E esse tipo de divisão de dados pode ser uma tentativa desesperada de obter a mesma funcionalidade.
Outra razão é que realizar operações como alter em tabelas grandes é difícil. Tudo fica bloqueado. Embora em versões modernas do MySQL esse problema não seja tão sério.
Ou, por exemplo, micro-sharding, mas falaremos disso mais adiante.
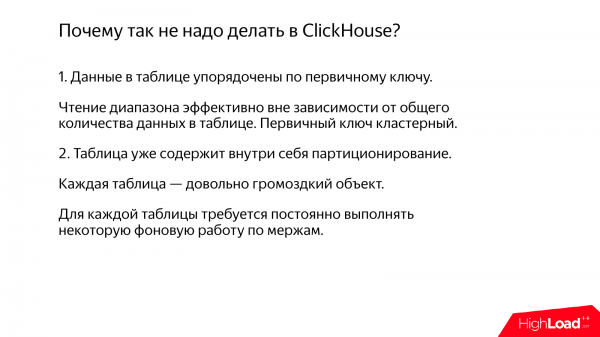
No ClickHouse não é necessário fazer isso, porque, primeiro, a chave primária é clusterizada e os dados são organizados de acordo com a chave primária.
Às vezes me perguntam: "Como o desempenho de consultas em intervalo no ClickHouse muda com o tamanho da tabela?" Eu digo que não muda. Por exemplo, se você tem uma tabela com um bilhão de linhas e lê um intervalo de um milhão de linhas, tudo funciona normalmente. Se a tabela tem um trilhão de linhas e você lê um milhão de linhas, o desempenho será quase o mesmo.
E, em segundo lugar, não há necessidade de coisas como partições manuais. Se você entrar e olhar o que está no sistema de arquivos, verá que a tabela é um objeto bastante robusto. Dentro dela, existe algo como partições. Ou seja, o ClickHouse faz tudo por você e você não precisa se preocupar.
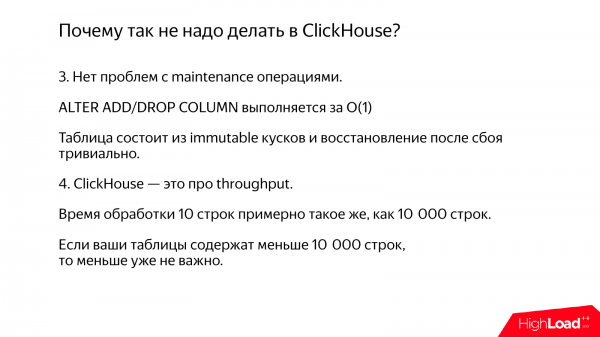
Alterar no ClickHouse é gratuito, se for apenas para adicionar/remover colunas.
E não vale a pena criar tabelas pequenas, porque se você tem 10 linhas ou 10.000 linhas na tabela, isso é irrelevante. O ClickHouse é um sistema que otimiza o throughput, não a latência, então processar 10 linhas não faz sentido.
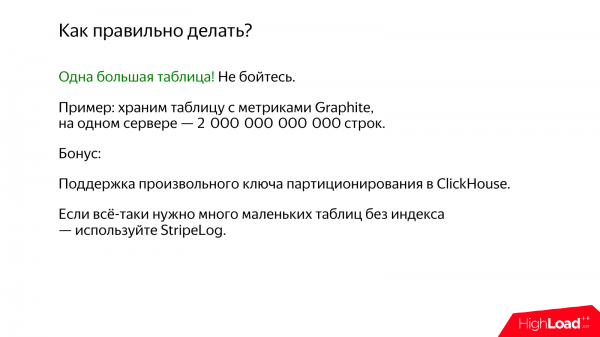
É correto utilizar uma tabela grande. Livre-se dos estereótipos antigos; tudo ficará bem.
Como bônus, na última versão, temos a capacidade de criar uma chave de partição arbitrária para realizar várias operações de manutenção em partições específicas.
Por exemplo, você precisa de muitas tabelas pequenas, como quando há uma necessidade de processar alguns dados intermediários, você recebe chunks e precisa realizar transformações sobre eles antes de gravá-los na tabela final. Para esse caso, existe um motor de tabela excelente – o StripeLog. É como o TinyLog, mas melhor.
* agora no ClickHouse há também .
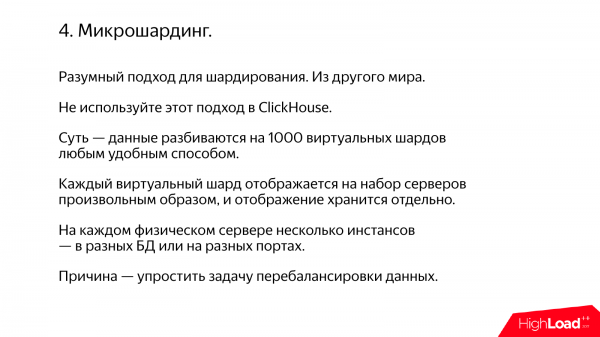
Outro antipadrão é o microsharding. Por exemplo, você precisa shardizar seus dados e tem 5 servidores, mas amanhã haverá 6 servidores. E você está pensando em como reequilibrar esses dados. Em vez disso, você divide não em 5 shards, mas em 1.000 shards. E depois mapeia cada um desses microshards para um servidor separado. Assim, em um servidor, você pode ter, por exemplo, 200 ClickHouse. Instâncias separadas em portas diferentes ou bancos de dados distintos.
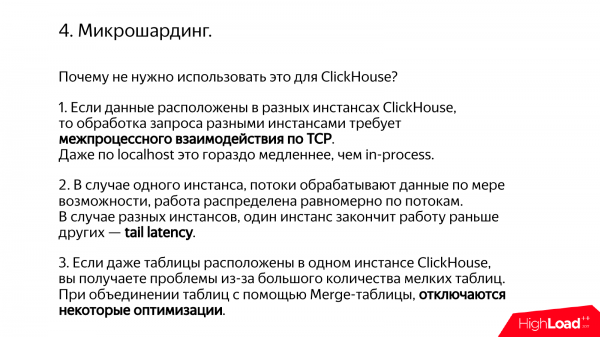
Mas no ClickHouse isso não é muito bom. Porque até mesmo uma instância do ClickHouse tenta usar todos os recursos disponíveis do servidor para processar uma única consulta. Ou seja, você tem um servidor e, por exemplo, 56 núcleos de processador. Você executa uma consulta que leva um segundo e ela usará 56 núcleos. E se você tem 200 ClickHouse no mesmo servidor, surgirão 10.000 threads. No geral, será muito ruim.
Outra razão é que a distribuição do trabalho entre essas instâncias será desigual. Alguma terminará antes, alguma terminará depois. Se tudo isso ocorresse em uma única instância, o ClickHouse resolveria automaticamente como distribuir corretamente os dados entre os threads.
E mais uma razão é que você terá comunicação interprocessos via TCP. Os dados precisarão ser serializados, desserializados e isso cria uma quantidade enorme de microshards. Será simplesmente ineficiente.
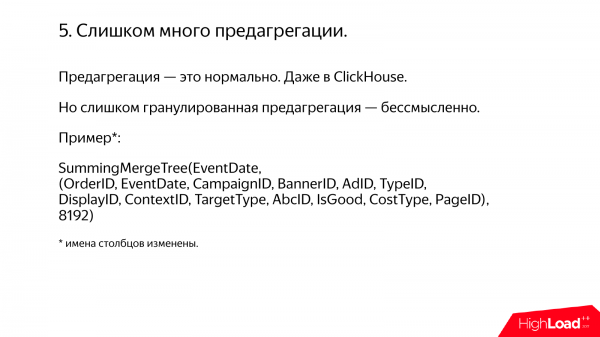
Outro antipadrão, embora seja difícil chamá-lo assim. É a grande quantidade de pré-agregação.
Na verdade, a pré-agregação é boa. Tinha um bilhão de linhas, você agregou e ficou com 1.000 linhas, e agora a consulta é executada instantaneamente. Tudo ótimo. Isso é possível. E para isso, até mesmo no ClickHouse há um tipo especial de tabela, o AggregatingMergeTree, que faz a agregação incremental à medida que os dados são inseridos.
Mas há casos em que você pensa que vamos agregar os dados dessa forma e ainda agregar os dados assim. E em algum departamento vizinho, que não quero mencionar, eles usam tabelas SummingMergeTree para somar por chave primária, usando cerca de 20 colunas como chave primária. Eu mudei os nomes de algumas colunas por precaução, mas é mais ou menos assim que funciona.
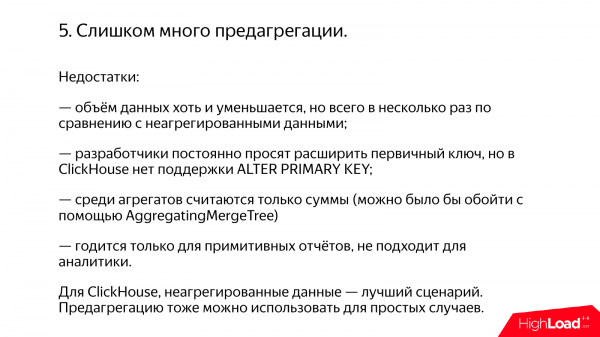
E surgem esses problemas. Primeiro, o volume de dados não diminui muito. Por exemplo, diminui em três vezes. Três vezes seria um bom preço para permitir-se oportunidades ilimitadas de análise, que surgem quando os dados não estão agregados. Se os dados estão agregados, você acaba recebendo apenas estatísticas medíocres em vez de análises.
E o que é especialmente irritante? É que essas pessoas do departamento vizinho vêm e pedem para adicionar mais uma coluna à chave primária. Ou seja, agregamos os dados assim, mas agora queremos um pouco mais. Mas no ClickHouse não há como alterar a chave primária. Portanto, é preciso escrever alguns scripts em C++. E eu não gosto de scripts, mesmo que sejam em C++.
E se você olhar para o motivo pelo qual o ClickHouse foi criado, dados não agregados são exatamente o cenário para o qual ele foi concebido. Se você está usando o ClickHouse para dados não agregados, você está fazendo tudo certo. Se você está agregando, isso às vezes pode ser perdoável.
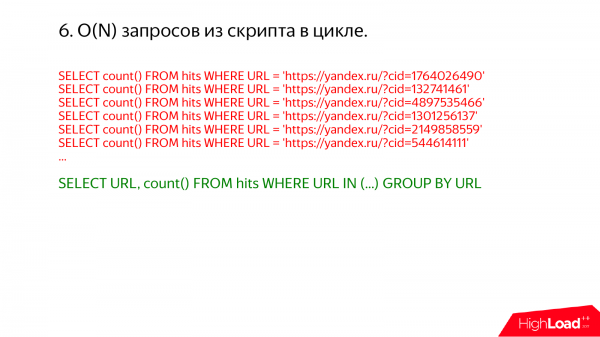
Outro caso interessante são as consultas em um loop infinito. Às vezes, eu vou a algum servidor de produção e olho lá o show processlist. E a cada vez descubro que algo terrível está acontecendo.
Por exemplo, isso. Aqui já fica claro que poderia ser tudo executado em uma única consulta. Basta escrever url in e a lista.
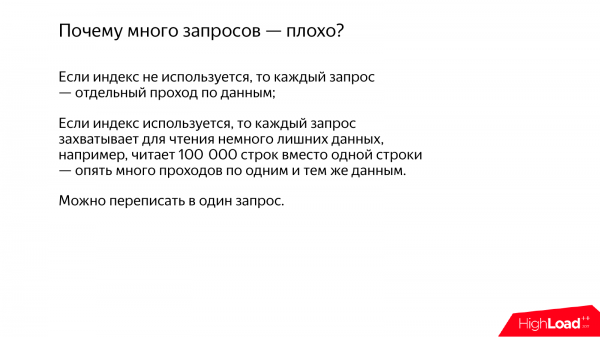
Por que muitas dessas consultas em um loop infinito são ruins? Se o índice não for utilizado, você terá muitas passagens pelos mesmos dados. Mas se o índice for utilizado, por exemplo, se você tem uma chave primária em ru e escreve url = algo assim. E você pensa que vai ler um único url da tabela, tudo ficará normal. Mas, na verdade, não. Porque o ClickHouse faz tudo em pacotes.
Quando é necessário ler um intervalo de dados, lê-se um pouco mais, porque o índice no ClickHouse é esparso. Esse índice não permite encontrar uma única linha na tabela, apenas um intervalo. E os dados são comprimidos em blocos. Para ler uma linha, é necessário pegar um bloco inteiro e descompactá-lo. E se você executar um monte de consultas, terá muitas interseções, e muitos trabalhos serão executados repetidamente.
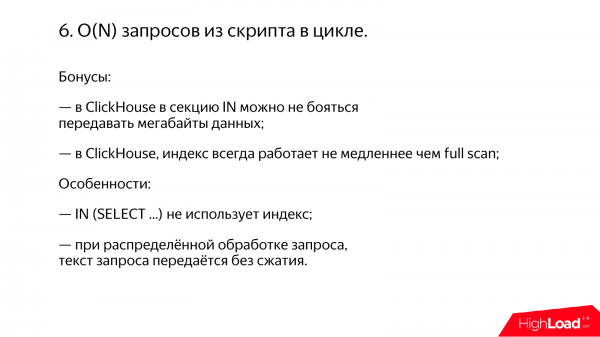
Como um bônus, vale destacar que no ClickHouse não se deve ter medo de passar até megabytes e até centenas de megabytes na seção IN. Lembro da nossa prática, que se no MySQL passarmos um monte de valores na seção IN, por exemplo, 100 megabytes de alguns números, o MySQL consome 10 gigabytes de memória e mais nada acontece, tudo funciona mal.
E a segunda coisa é que no ClickHouse, se suas consultas usam índices, isso nunca é mais lento do que um full scan, ou seja, se quase toda a tabela precisa ser lida, ele irá percorrer sequencialmente e ler toda a tabela. Em geral, ele mesmo se encarrega disso.
No entanto, existem algumas dificuldades. Por exemplo, o IN com subconsulta não utiliza o índice. Mas esse é o nosso problema e precisamos corrigi-lo. Não há nada fundamental aqui. Vamos consertar isso.
E mais uma coisa interessante é que se você tiver uma consulta muito longa e a execução distribuída de consultas, essa consulta muito longa será enviada para cada servidor sem compressão. Por exemplo, 100 megabytes e 500 servidores. E, assim, você transmitirá 50 gigabytes pela rede. Será transmitido e depois tudo será executado com sucesso.
* já é utilizado; tudo consertado, como prometido.
E é bastante comum que as consultas venham de uma API. Por exemplo, você criou um serviço. E se seu serviço for necessário para alguém, você abriu uma API e, literalmente dois dias depois, vê que algo estranho está acontecendo. Tudo está sobrecarregado e algumas consultas horríveis estão chegando, que nunca deveriam ter ocorrido.
E a solução é uma só. Se você abriu uma API, terá que limitá-la. Por exemplo, introduzir algumas quotas. Não há opções normais. Caso contrário, logo escreverão um script e você terá problemas.
E no ClickHouse existe uma funcionalidade especial – o monitoramento de cotas. Você pode, por exemplo, passar sua chave de cota. Isso pode ser, por exemplo, um identificador interno do usuário. E as cotas serão contabilizadas independentemente para cada um deles.
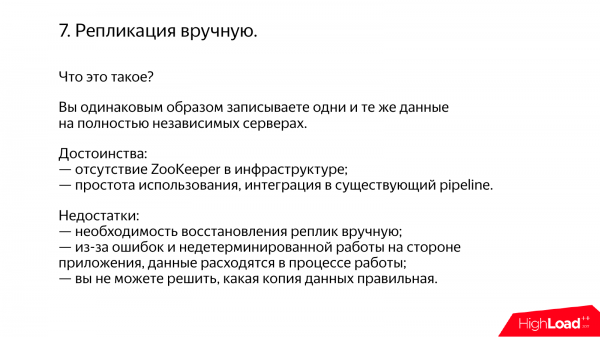
Agora, outra coisa interessante. É a replicação manual.
Eu conheço muitos casos em que, apesar de o ClickHouse ter suporte interno à replicação, as pessoas replicam o ClickHouse manualmente.
Qual é o princípio? Você tem um pipeline de processamento de dados. E ele opera independentemente, por exemplo, em diferentes data centers. Você grava os mesmos dados da mesma forma no ClickHouse. No entanto, a prática mostra que os dados acabarão divergindo devido a algumas peculiaridades no seu código. Espero que isso não aconteça com o seu.
E periodicamente você ainda precisará fazer a sincronização manualmente. Por exemplo, uma vez por mês, os administradores fazem rsync.
Na verdade, é muito mais simples usar a replicação embutida no ClickHouse. Mas aqui podem haver algumas contraindicações, pois para isso é necessário usar o ZooKeeper. Não direi nada de ruim sobre o ZooKeeper, no geral, o sistema funciona, mas às vezes as pessoas não o utilizam devido à fobia de Java, porque o ClickHouse é um sistema muito bom, escrito em C++, que pode ser utilizado e funcionará tudo bem. E o ZooKeeper é em Java. E de alguma forma, não dá vontade de olhar para isso, mas então você pode usar a replicação manual.
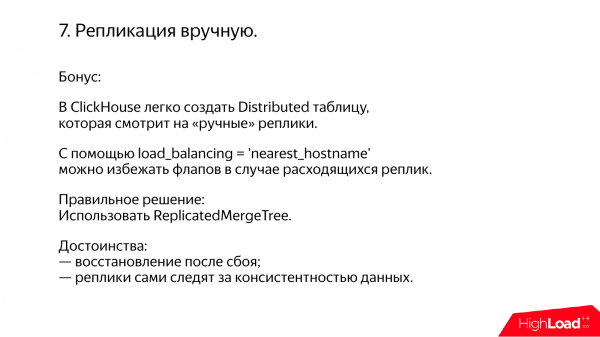
O ClickHouse é um sistema prático. Ele leva em consideração suas necessidades. Se você tiver replicação manual, poderá criar uma tabela Distribuída que observa suas réplicas manuais e realiza failover entre elas. E há até uma opção especial que permite evitar flaps, mesmo que suas réplicas divergiam sistematicamente.
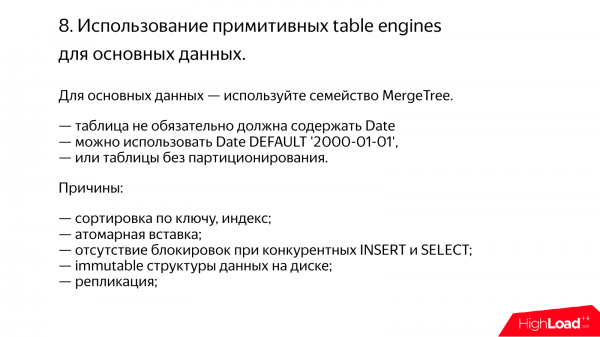
Além disso, podem haver problemas se você estiver usando motores de tabela primitivos. O ClickHouse é como um construtor, onde existem muitos tipos diferentes de motores de tabela. Para todos os casos sérios, como está escrito na documentação, use tabelas da família MergeTree. Os outros são apenas para casos específicos ou para testes.
Na tabela MergeTree, não é necessário que você tenha uma data e hora. Você ainda pode utilizá-la. Se não houver data e hora, coloque um valor padrão de 2000. Isso vai funcionar e não exigirá recursos.
E na nova versão do servidor, você pode até especificar para ter particionamento customizado sem uma chave de partição. Isso será o mesmo.
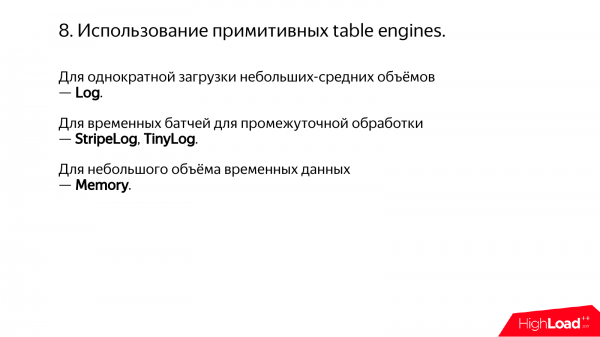
Por outro lado, você pode usar mecanismos de tabela primitivos. Por exemplo, encher os dados uma vez e ver, manipular e excluir. Você pode usar o Log.
Ou o armazenamento de pequenos volumes para processamento intermediário – isso é StripeLog ou TinyLog.
Memory pode ser usado se o volume de dados for pequeno e você precisar apenas manipular algo na RAM.
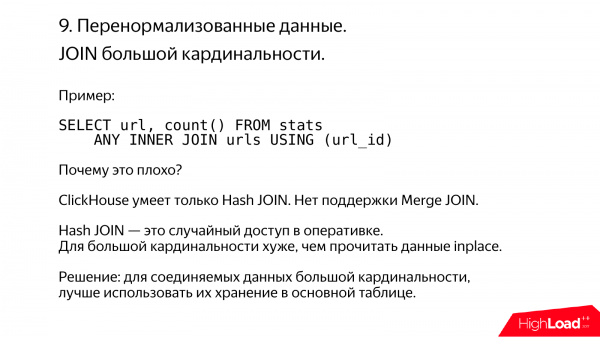
ClickHouse não gosta muito de dados hiper-normalizados.
Aqui está um exemplo típico. É uma enorme quantidade de URLs. Você os colocou em uma tabela vizinha. E então decidiu fazer um JOIN com eles, mas isso normalmente não funcionará, porque ClickHouse suporta apenas Hash JOIN. Se não houver RAM suficiente para o grande volume de dados que precisam ser unidos, então o JOIN não poderá ser realizado*.
Se os dados tiverem alta cardinalidade, não se preocupe, armazene-os de forma denormalizada, URLs diretamente inplace na tabela principal.
* agora o ClickHouse também tem merge join, e ele funciona quando os dados intermediários não cabem na RAM. Mas isso não é eficiente e a recomendação permanece válida.
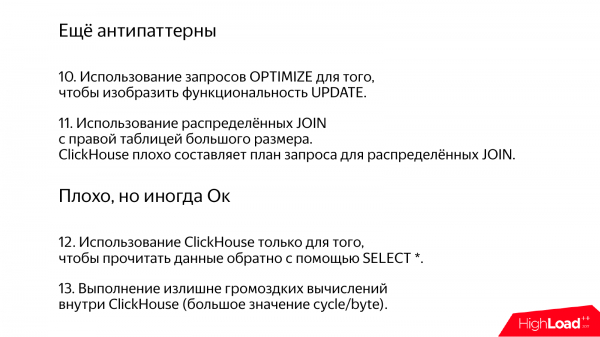
Mais alguns exemplos, mas já estou na dúvida se eles são antipadrões ou não.
O ClickHouse tem uma desvantagem conhecida. Ele não suporta updates*. Em certo sentido, isso é até bom. Se você tiver dados importantes, como contabilidade, ninguém poderá alterá-los, porque não há suporte para updates.
* já foi adicionada há tempos a compatibilidade com update e delete em modo batch.
Mas existem algumas maneiras especiais que permitem updates, de certa forma em segundo plano. Por exemplo, tabelas do tipo ReplaceMergeTree. Elas fazem updates durante as mesclagens em segundo plano. Você pode forçar isso usando optimize table. Mas não faça isso com muita frequência, pois resultará em reescrita completa da partição.
JOINs distribuídos no ClickHouse também são mal tratados pelo planejador de consultas.
Ruim, mas às vezes é aceitável.
Usar ClickHouse apenas para ler dados de volta com select*.
Eu não recomendaria usar ClickHouse para cálculos pesados. Mas não é bem assim, porque já estamos nos afastando dessa recomendação. E recentemente adicionamos a possibilidade de aplicar modelos de aprendizado de máquina no ClickHouse – Catboost. E isso me preocupa, porque eu penso: "Que horror. Quantos ciclos por byte isso resulta!". Fico muito triste em gastar ciclos em bytes.
Mas não se preocupe, instale o ClickHouse, tudo vai ficar bem. Se precisar, temos uma comunidade. Aliás, a comunidade é você. E se você tiver algum problema, pode ao menos entrar no nosso chat e, espero, que alguém te ajude.
Perguntas
Obrigado pela apresentação! Onde posso reclamar sobre a queda do ClickHouse?
Você pode reclamar comigo pessoalmente agora mesmo.
Recentemente comecei a usar o ClickHouse. Logo derrubei a interface cli.
Você teve sorte.
Mais tarde derrubei o servidor com um pequeno select.
Você tem talento.
Eu abri um bug no GitHub, mas ignoraram.
Vamos ver.
O Alexey me enganou para me levar à apresentação, prometendo falar sobre como você compacta os dados por dentro.
É muito simples.
Eu percebi isso ontem. Mais detalhes.
Não há nada de terrivelmente complicado. É apenas compressão por blocos. Por padrão, usa-se LZ4, mas pode-se ativar ZSTD*. Blocos variam de 64 kilobytes a 1 megabyte.
* também há suporte para codecs de compressão especializados que podem ser usados em combinação com outros algoritmos.
Os blocos contêm apenas dados crus?
Não exatamente crus. São arrays. Se você tem uma coluna numérica, os números estão organizados em um array sequencial.
Entendi.
Alexey, o exemplo que foi com uniqExact sobre endereços IP, ou seja, o que o uniqExact leva mais tempo para calcular em strings do que em números e assim por diante. E se aplicarmos um truque e fizermos o casting no momento da leitura? Ou seja, você, aparentemente, disse que no disco isso não varia muito. Se lermos strings do disco e fizermos o casting, então nossos agregados serão mais rápidos ou não? Ou acabamos ganhando algo insignificante aqui? Eu acho que você testou isso, mas não mencionou no benchmark.
Acho que será mais lento do que sem o cast. Nesse caso, o endereço IP precisa ser extraído da string. Claro que em ClickHouse a extração de endereços IP também é otimizada. Nós nos esforçamos bastante, mas os números estão registrados em forma de dez mil. Muito inconveniente. Por outro lado, a função uniqExact funcionará com strings mais lentamente, não apenas porque são strings, mas também porque é escolhida uma especialização diferente do algoritmo. Strings são processadas de forma diferente.
E se pegarmos um tipo de dado mais primitivo? Por exemplo, registramos o user id, que temos in, registramos como uma string e depois fazemos o cast, será mais divertido ou não?
Eu duvido. Acho que será até mais triste, porque, afinal, analisar números é um problema sério. Tenho a impressão de que esse colega fez até uma apresentação sobre como é difícil analisar números na forma de dez mil, ou talvez não.
Alexey, muito obrigado pela apresentação! E também muito obrigado pelo ClickHouse! Eu tenho uma pergunta sobre os planos. Existe a possibilidade de uma funcionalidade para atualizar dicionários parcialmente?
Ou seja, uma recarga parcial?
Sim, sim. Algo como a possibilidade de especificar um campo MySQL, ou seja, atualizar após para carregar apenas esses dados, se o dicionário for muito grande.
Uma funcionalidade muito interessante. E acho que alguém a sugeriu no nosso chat. Pode ser que tenha sido você.
Não acho que fui eu.
Ótimo, então agora temos dois pedidos. E podemos começar devagar. Mas quero avisá-lo imediatamente que essa funcionalidade é bastante simples de implementar. Ou seja, teoricamente, precisamos apenas escrever o número da versão na tabela e, em seguida, escrever: a versão é menor que tal. E isso significa que, provavelmente, iremos sugerir que entusiastas façam isso. Você é um entusiasta?
Sim, mas, infelizmente, não em C++.
Seus colegas conseguem programar em C++?
Vou encontrar alguém.
Perfeito.
* a funcionalidade foi adicionada dois meses após a apresentação – foi desenvolvida pelo autor da pergunta e enviada. .
Obrigado!
Olá! Obrigado pela apresentação! Você mencionou que o ClickHouse utiliza muito bem todos os recursos disponíveis. E o palestrante ao lado da Luxoft falou sobre sua solução para os Correios da Rússia. Ele disse que gostaram muito do ClickHouse, mas não o usaram em vez de seu principal concorrente devido ao fato de que ele consumia toda a CPU. E não conseguiram integrá-lo à sua arquitetura, ao seu ZooKeeper com Docker. Existe uma maneira de limitar o ClickHouse para que ele não consuma tudo o que está disponível?
Sim, é possível e muito fácil. Se você quiser que consuma menos núcleos, basta escrever set max_threads = 1. E assim, ele executará a consulta em um único núcleo. Além disso, é possível definir configurações diferentes para diferentes usuários. Portanto, não há problemas. E informe aos colegas da Luxoft que não é bom que não tenham encontrado essa configuração na documentação.
Alexei, olá! Gostaria de perguntar sobre uma questão. Não é a primeira vez que ouço que muitos começam a usar o ClickHouse como armazenamento de logs. Na apresentação você disse para não fazer isso, ou seja, não é necessário armazenar strings longas. O que você pensa sobre isso?
Em primeiro lugar, logs geralmente não são strings longas. Pode haver, é claro, exceções. Por exemplo, algum serviço escrito em Java gera uma exceção, que é registrada. E assim em um ciclo infinito, e o espaço no disco rígido acaba. A solução é muito simples. Se as strings forem muito longas, corte-as. E o que significa longo? Dezenas de quilobytes é ruim*.
* nas versões recentes do ClickHouse, está incluída a "granularidade adaptativa do índice", o que resolve em grande parte o problema do armazenamento de strings longas.
E um quilobyte é normal?
Normal.
Olá! Obrigado pela apresentação! Já perguntei isso no chat, mas não lembro se recebi resposta. Está previsto expandir a seção WITH de maneira semelhante ao CTE?
Por enquanto não. A seção WITH é um pouco séria. É uma pequena funcionalidade que temos.
Entendi. Obrigado!
Obrigado pela apresentação! Muito interessante! Uma pergunta global. Está previsto fazer, talvez, alguma modificação na exclusão de dados?
Com certeza. Essa é nossa primeira tarefa na fila. Estamos pensando ativamente em como fazer tudo corretamente. E é hora de começar a digitar*.
* pressionamos botões no teclado e tudo foi feito.
Isso afetará de alguma forma o desempenho do sistema ou não? A inserção será tão rápida quanto agora?
Talvez os próprios deletes, os próprios updates sejam muito pesados, mas isso não afetará o desempenho dos selects e o desempenho dos inserts.
E mais uma pequena pergunta. Na apresentação, você falou sobre a chave primária. Portanto, temos o particionamento, que por padrão é mensal, correto? E quando definimos um intervalo de datas que se encaixa em um mês, lemos apenas essa partição, certo?
Sim.
Tenho uma pergunta. Se não conseguimos destacar alguma chave primária, é correto fazê-la pelo campo "Data" para que, em segundo plano, haja uma menor reorganização desses dados, permitindo que eles fiquem mais organizados? Se você não tem consultas em intervalos e não consegue escolher nenhuma chave primária, vale a pena incluir a data na chave primária?
Sim.
Talvez faça sentido incluir no chave primária um campo pelo qual os dados possam ser melhor compactados, se eles forem ordenados por esse campo. Por exemplo, o identificador do usuário. O usuário, por exemplo, acessa o mesmo site. Nesse caso, você coloca o id do usuário e o tempo. Assim, seus dados serão melhor compactados. Quanto à data, se você realmente não tem e nunca terá consultas em intervalos de datas, então pode não incluir a data na chave primária.
Certo, muito obrigado!
Fonte: habr.com
