

Dando continuidade ao tema de registro de grandes fluxos de dados, levantado , neste artigo vamos explorar métodos para reduzir o tamanho "físico" dos dados armazenados no PostgreSQL e seu impacto no desempenho do servidor.
Vamos falar sobre as configurações TOAST e o alinhamento de dados. "Em média", esses métodos permitirão economizar não muitos recursos, mas — sem qualquer modificação no código do aplicativo.
No entanto, nossa experiência foi bastante produtiva nesse aspecto, já que o armazenamento da maioria das monitorizações é em grande parte apenas append-only no que diz respeito aos dados gravados. E se você está curioso sobre como fazer um banco escrever em disco em vez de 200MB/s metade disso — continue lendo.
Pequenos segredos de grandes dados
De acordo com o perfil de trabalho , ele recebe regularmente dos logs pacotes de texto.
E como , cujos bancos de dados monitoramos, é um produto multi-componente com estruturas de dados complexas, as consultas para alcançar o máximo desempenho são, portanto, . Assim, o volume de cada instância de consulta ou do plano de execução resultante nos logs é, em média, bastante grande.
Vamos dar uma olhada na estrutura de uma das tabelas onde escrevemos os dados "brutos" — ou seja, o texto original do registro no log:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- chave de seção
    date
, data -- o mais importante
    text
, PRIMARY KEY(pack, recno)
);
Uma tabela típica (já particionada, sem dúvida, portanto, isso é um modelo de seção), onde o mais importante é o texto. Às vezes, bastante extenso.
Lembre-se de que o tamanho "físico" de um registro no PG não pode ocupar mais do que uma página de dados, mas o tamanho "lógico" é outra história. Para gravar um valor extenso (varchar/text/bytea) no campo é utilizada :
O PostgreSQL utiliza um tamanho fixo de página (geralmente 8 KB) e não permite que tuplas ocupem várias páginas. Portanto, não é possível armazenar diretamente valores muito grandes em campos. Para contornar essa limitação, grandes valores de campos são compactados e/ou divididos em várias linhas físicas. Isso acontece de forma invisível para o usuário e impacta negligentemente a maior parte do código do servidor. Esse método é conhecido como TOAST ...
Na verdade, para cada tabela com campos "potencialmente grandes", automaticamente de cada registro "grande" em segmentos de 2KB:
TOAST(
  chunk_id
    inteiro
, chunk_seq
    inteiro
, chunk_data
    bytea
, CHAVE PRIMÁRIA(chunk_id, chunk_seq)
);
Ou seja, se precisamos gravar uma linha com um valor "grande" data, a gravação real ocorrerá não apenas na tabela principal e seu PK, mas também no TOAST e seu PK.
Reduzindo o impacto do TOAST
Mas a maioria dos registros não é tão grande assim, deveriam caber nos 8KB — como economizar nisso?..
Aqui, o atributo da coluna da tabela vem em nosso auxílio:
- EXTENDED permite tanto compressão quanto armazenamento separado. Este é o padrão para a maioria dos tipos de dados compatíveis com TOAST. Primeiro, é feita uma tentativa de compressão, depois — o armazenamento fora da tabela, se a linha ainda for grande demais. MAIN
- permite compressão, mas não armazenamento separado. (Na verdade, o armazenamento separado, no entanto, será realizado para tais colunas, mas apenas como uma última medida , quando não há outra maneira de reduzir a linha para que ela caiba na página.)Na verdade, isso é exatamente o que precisamos para texto —
comprimir ao máximo, e se não couber de forma alguma — transferir para TOAST . Isso pode ser feito diretamente "em tempo real", com um único comando:ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;
Como avaliar o efeitoComo o fluxo de dados muda a cada dia, não podemos comparar números absolutos, mas em termos relativos quanto
menor a proporção que gravamos no TOAST — melhor. Mas há um perigo aqui — quanto maior for o "volume físico" de cada registro individual, mais "amplo" se torna o índice, pois é necessário cobrir uma maior quantidade de páginas de dados. antes das alterações
Seção heap = 37GB (39%) TOAST = 54GB (57%) PK = 4GB ( 4%):
depois das alterações
Seção heap = 37GB (67%) TOAST = 16GB (29%) PK = 2GB ( 4%):
Na verdade, nóscomeçamos a gravar no TOAST com 2 vezes menos frequência. passaram a escrever no TOAST duas vezes menos, que aliviou não apenas o disco, mas também a CPU:
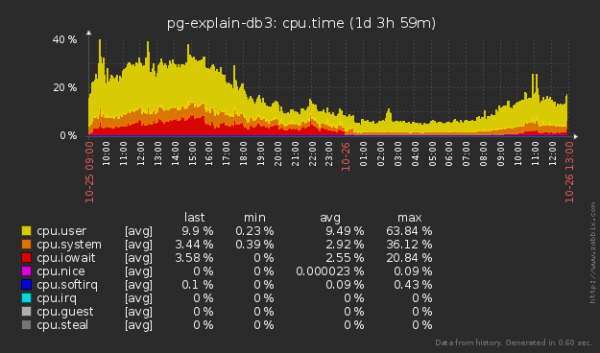
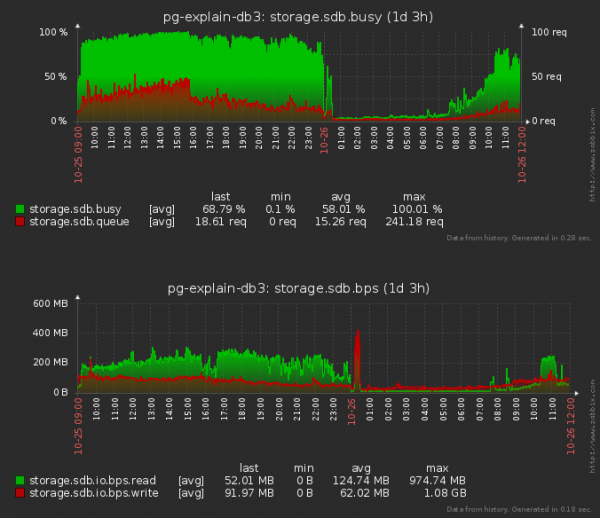
Observe que agora também lemos o disco menos, não apenas escrevemos — pois ao inserir um registro em uma tabela, precisamos "ler" uma parte da árvore de cada um dos índices para determinar sua futura posição.
Quem vive bem com PostgreSQL 11
Após a atualização para PG11, decidimos continuar o "ajuste" do TOAST e notamos que a partir desta versão, um parâmetro tornou-se configurável :
O código de processamento do TOAST é acionado apenas quando o valor da linha que deve ser armazenado na tabela é maior do que TOAST_TUPLE_THRESHOLD bytes (geralmente 2 KB). O código TOAST irá comprimir e/ou mover os valores do campo para fora da tabela até que o valor da linha seja menor que TOAST_TUPLE_TARGET bytes (um valor variável, geralmente também 2 KB) ou até que não seja mais possível reduzir o volume.
Decidimos que os dados costumam ser ou "muito curtos" ou "muito longos", então optamos pelo valor minimamente possível:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Vamos ver como as novas configurações afetaram o uso do disco após a reconfiguração:
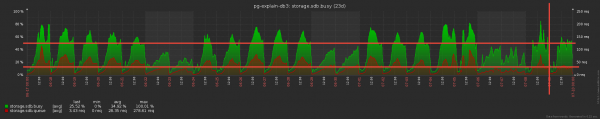
Muito bom! A média da fila para o disco foi reduzida em cerca de 1,5 vezes, e a "ocupação" do disco – em cerca de 20%! Mas será que isso teve algum impacto na CPU?
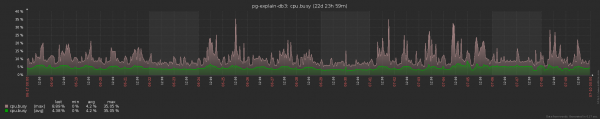
Pelo menos, não piorou. Embora seja difícil julgar, já que até mesmo esses volumes não conseguem elevar a carga média da CPU. 5%.
Mudanças nas posições dos elementos da soma... alteram-se!
Como todos sabem, um centavo economiza um real, e com nossos volumes de armazenamento de cerca de 10TB/mês até mesmo uma pequena otimização pode proporcionar um bom lucro. Portanto, nos concentramos na estrutura física dos nossos dados — como exatamente "dispostos" os campos dentro de cada registro de cada uma das tabelas.
Porque devido ao isso, diretamente :
Muitas arquiteturas prevêem o alinhamento de dados nos limites das palavras da máquina. Por exemplo, em um sistema de 32 bits x86, números inteiros (tipo integer, que ocupa 4 bytes) serão alinhados ao limite de palavras de 4 bytes, assim como números de ponto flutuante de precisão dupla (tipo double precision, 8 bytes). E em um sistema de 64 bits, os valores double serão alinhados ao limite de palavras de 8 bytes. Esta é mais uma razão para a incompatibilidade.
Devido ao alinhamento, o tamanho da linha da tabela depende da ordem em que os campos estão dispostos. Normalmente, esse efeito não é muito perceptível, mas em alguns casos, pode resultar em um aumento significativo do tamanho. Por exemplo, se os campos dos tipos char(1) e integer forem misturados, geralmente haverá um desperdício de 3 bytes entre eles.
Vamos começar com modelos sintéticos:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bytes

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bytes
De onde surgiram alguns bytes extras no primeiro caso? É simples — smallint de 2 bytes é alinhado a uma borda de 4 bytes antes do próximo campo, e quando está por último — não há nada para alinhar.
Em teoria — tudo está bem e os campos podem ser rearranjados como quiser. Vamos verificar com dados reais, usando uma das tabelas, cuja seção diária ocupa entre 10 e 15GB.
Estrutura original:
CREATE TABLE public.plan_20190220
(
-- Herdado da tabela plan:  pack uuid NOT NULL,
-- Herdado da tabela plan:  recno smallint NOT NULL,
-- Herdado da tabela plan:  host uuid,
-- Herdado da tabela plan:  ts timestamp with time zone,
-- Herdado da tabela plan:  exectime numeric(32,3),
-- Herdado da tabela plan:  duration numeric(32,3),
-- Herdado da tabela plan:  bufint bigint,
-- Herdado da tabela plan:  bufmem bigint,
-- Herdado da tabela plan:  bufdsk bigint,
-- Herdado da tabela plan:  apn uuid,
-- Herdado da tabela plan:  ptr uuid,
-- Herdado da tabela plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Seção após a troca de ordem das colunas — exatamente os mesmos campos, apenas em outra ordem:
CREATE TABLE public.plan_20190221
(
-- Herdado da tabela plan:  dt date NOT NULL,
-- Herdado da tabela plan:  ts timestamp with time zone,
-- Herdado da tabela plan:  pack uuid NOT NULL,
-- Herdado da tabela plan:  recno smallint NOT NULL,
-- Herdado da tabela plan:  host uuid,
-- Herdado da tabela plan:  apn uuid,
-- Herdado da tabela plan:  ptr uuid,
-- Herdado da tabela plan:  bufint bigint,
-- Herdado da tabela plan:  bufmem bigint,
-- Herdado da tabela plan:  bufdsk bigint,
-- Herdado da tabela plan:  exectime numeric(32,3),
-- Herdado da tabela plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
O volume total da seção é determinado pela quantidade de "fatos" e depende apenas de processos externos, portanto, vamos dividir o tamanho do heap (pg_relation_size) para a quantidade de registros nela — ou seja, vamos obter o tamanho médio do registro armazenado:
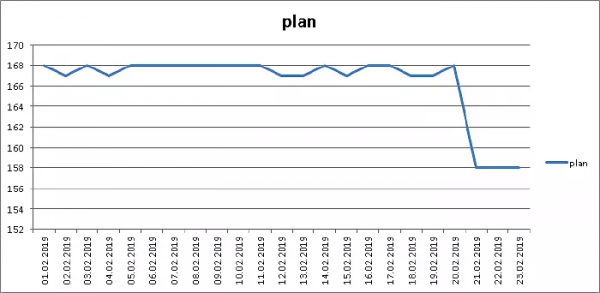
Menos 6% do volume, ótimo!
Mas nem tudo é tão cor-de-rosa — afinal nos índices não podemos mudar a ordem dos campos, e portanto, "no geral" (pg_total_relation_size)…
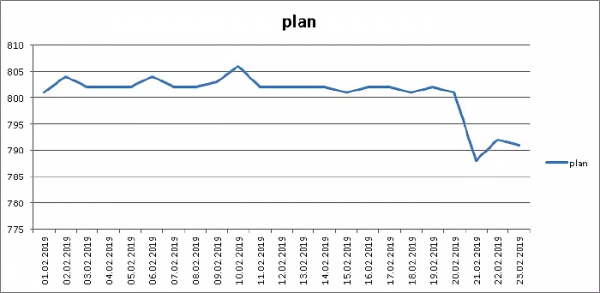
… ainda assim aqui economizamos 1.5%, sem alterar uma linha de código. É isso mesmo!
Observamos que a disposição dos campos proposta acima não é necessariamente a mais otimizada. Pois alguns blocos de campos não queremos "quebrar" por razões estéticas — por exemplo, um par (pack, recno), que é a PK dessa tabela.
De modo geral, a determinação da disposição "mínima" dos campos é uma tarefa de "exaustão" relativamente simples. Portanto, você pode obter resultados até melhores que os nossos com os seus dados — experimente!
Fonte: habr.com
